Anthropic 发文解释 Claude Opus 5.5 为长上下文编码会话降本的三方面变化:输入输出 token 降价 20%、缓存读取降价 60%,模型可用更少轮次完成同一任务,Claude Code 也改进了缓存利用。
价格调整背后的成本逻辑
Opus 5.5 的定价是每百万输入 4 美元、输出 20 美元。相比 Opus 5 的 5 美元和 25 美元,统一打了八折。更关键的是缓存读取价格——从每百万 0.50 美元降到 0.20 美元,降幅 60%。
这里有个容易被忽略的细节:缓存读取在 Opus 5.5 被定价为输入价的 5%,而其他 Claude 模型是 10%。这相当于给了长会话场景一个额外折扣。对于反复复用上下文的 Agent 编码会话,这个差别会随轮次累积。
Anthropic 宣称任务成本降低 40%。这个数字不能简单当成标价算术来验证。它是把单价下调和「每个完成任务消耗更少 token」合并计算的。CodeRabbit 的多步骤 Code Review 实测显示,Opus 5.5 medium effort 可以接近或超过 Opus 5 high 的表现,但 Token 消耗大约只有一半。
更狠的是,这个节省不是靠牺牲能力换来的。Anthropic 同时取消了关闭 Adaptive Thinking 的选项,默认 medium effort 已经足够覆盖大多数编码任务。你买的旗舰款,瞬间变成平替套餐。
长上下文的技术挑战
长上下文的能力提升,从来不只是把窗口从 200K 拉到 1M 这么简单。它牵动的是一整套系统工程:注意力计算复杂度、KV Cache 显存占用、延迟分布、并发吞吐,以及召回质量。

Agent 运行时过载
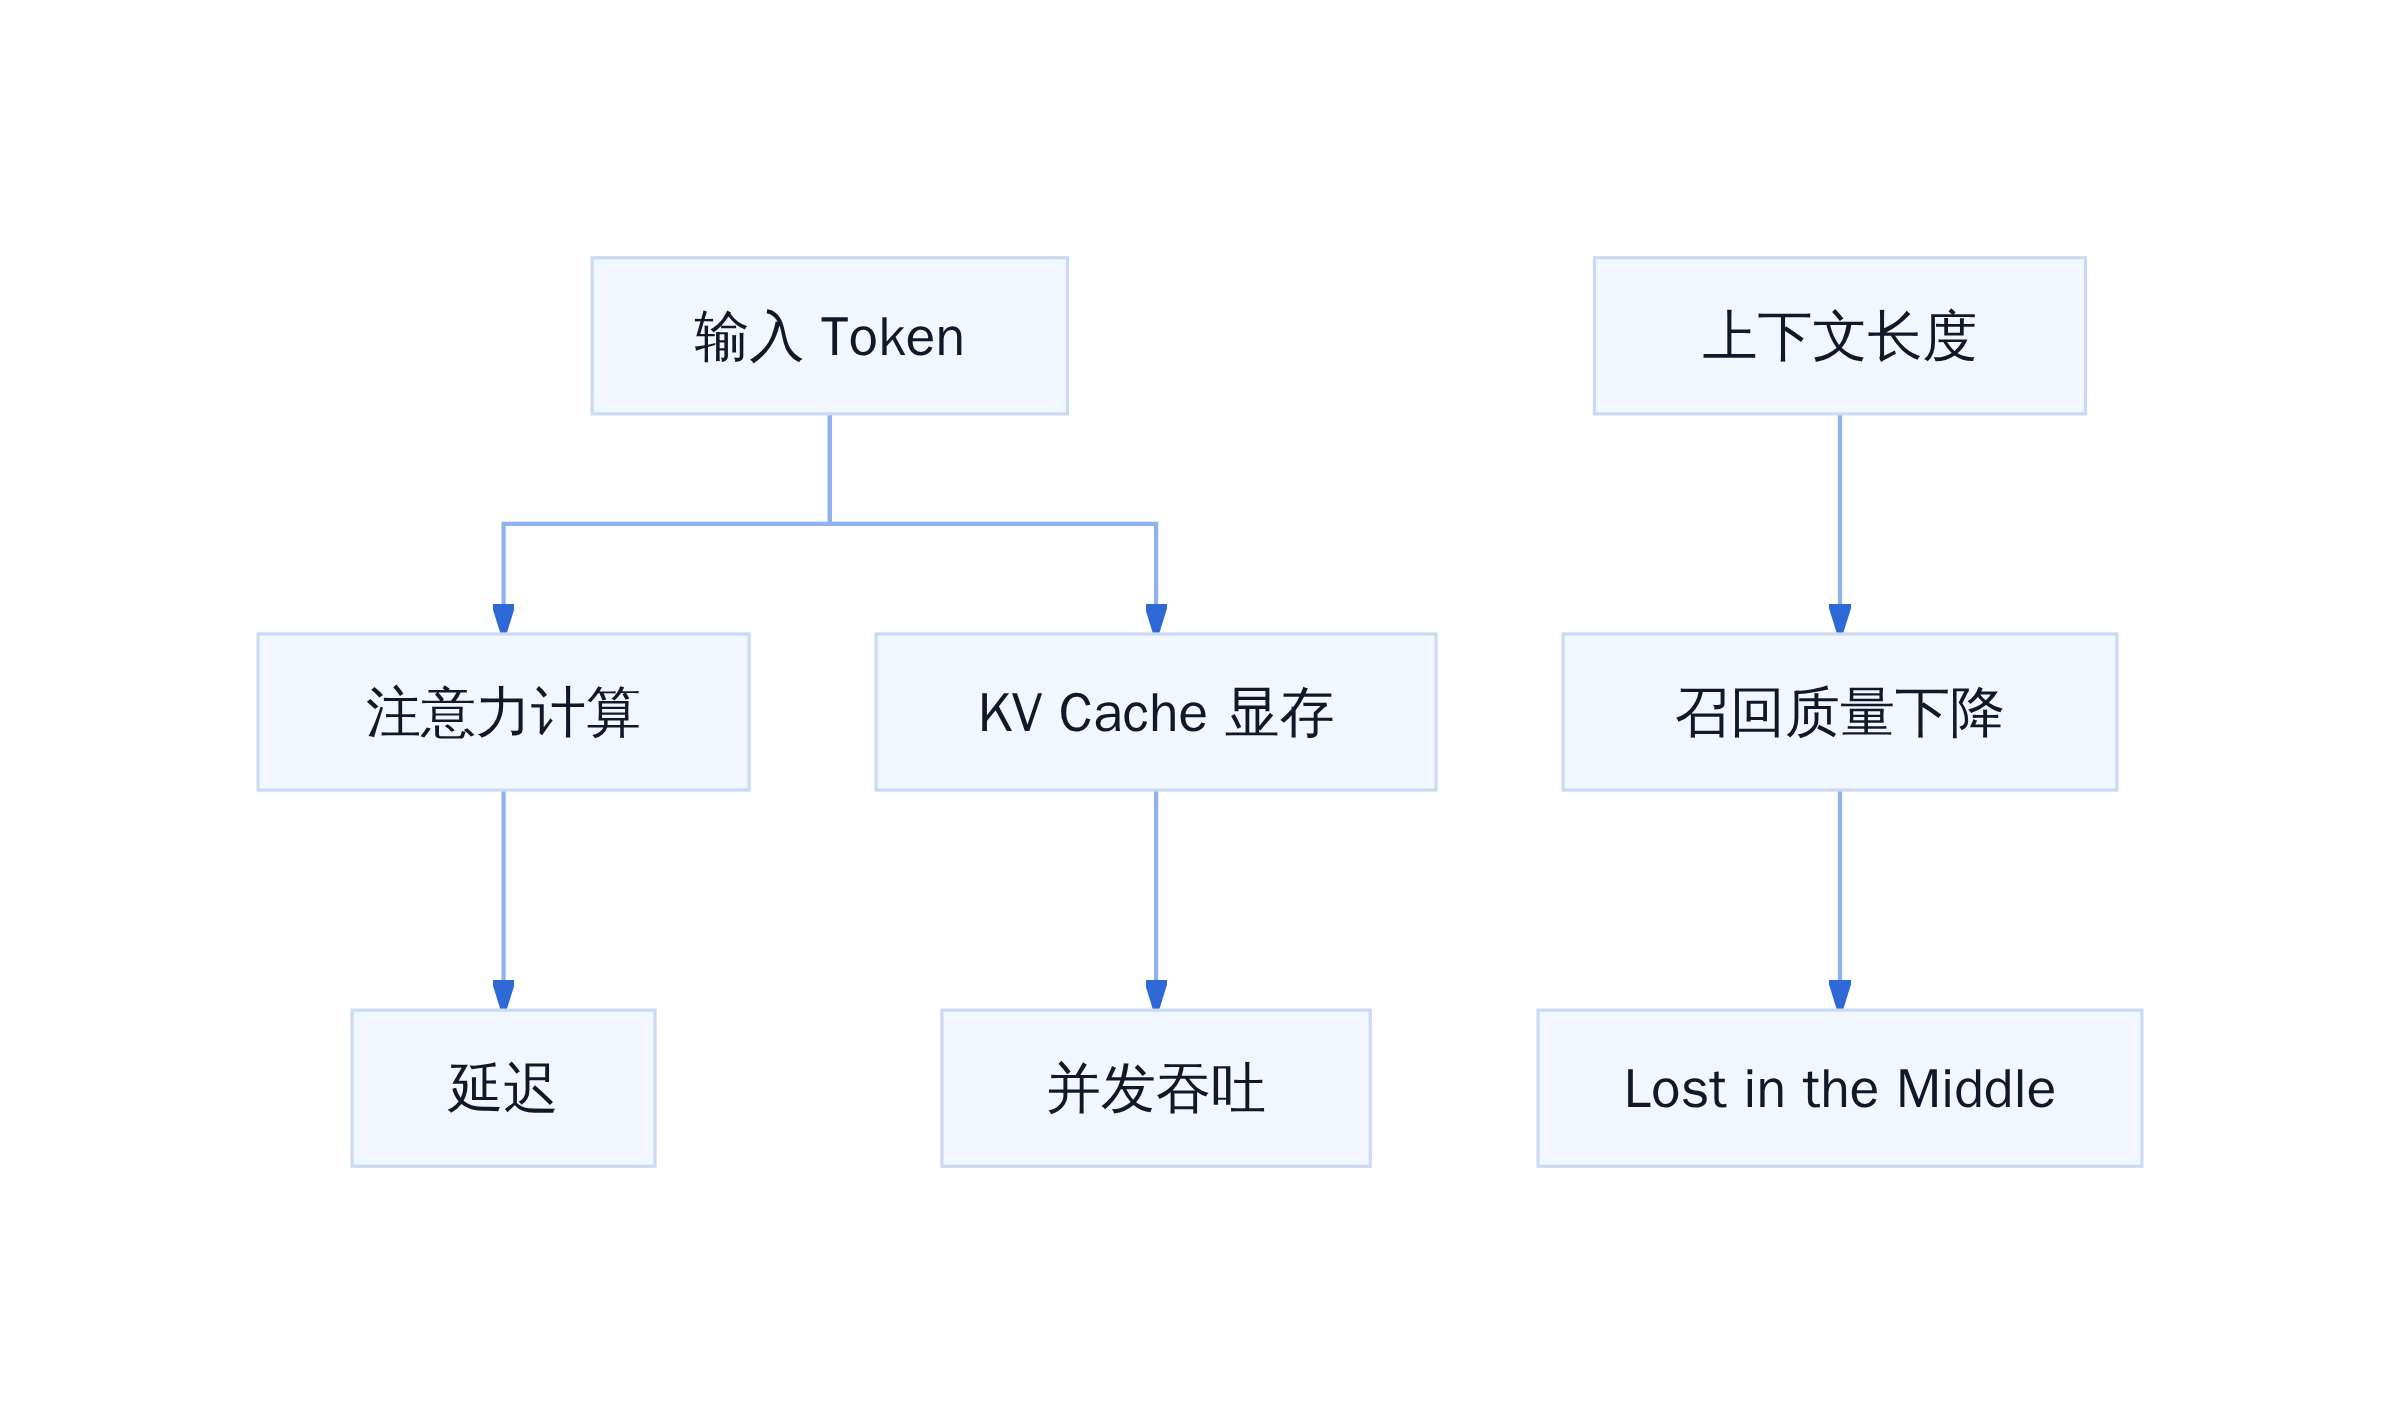
长上下文成本结构
Lost in the Middle 是一个经典问题。把大量材料塞进上下文,模型并不一定会去看中间部分。它倾向于关注开头和结尾——这在编码会话里意味着,如果你的代码库文档分布在多个文件,模型可能跳过你最想让它看的改动说明。
缓存命中是缓解成本的关键手段。当后续请求复用了已有上下文时,缓存读取价格远低于完整输入价格。Opus 5.5 的 60% 缓存降价,直接把这部分成本压到了最低。但前提是你的应用设计要能产生足够的缓存复用。

缓存命中的架构设计
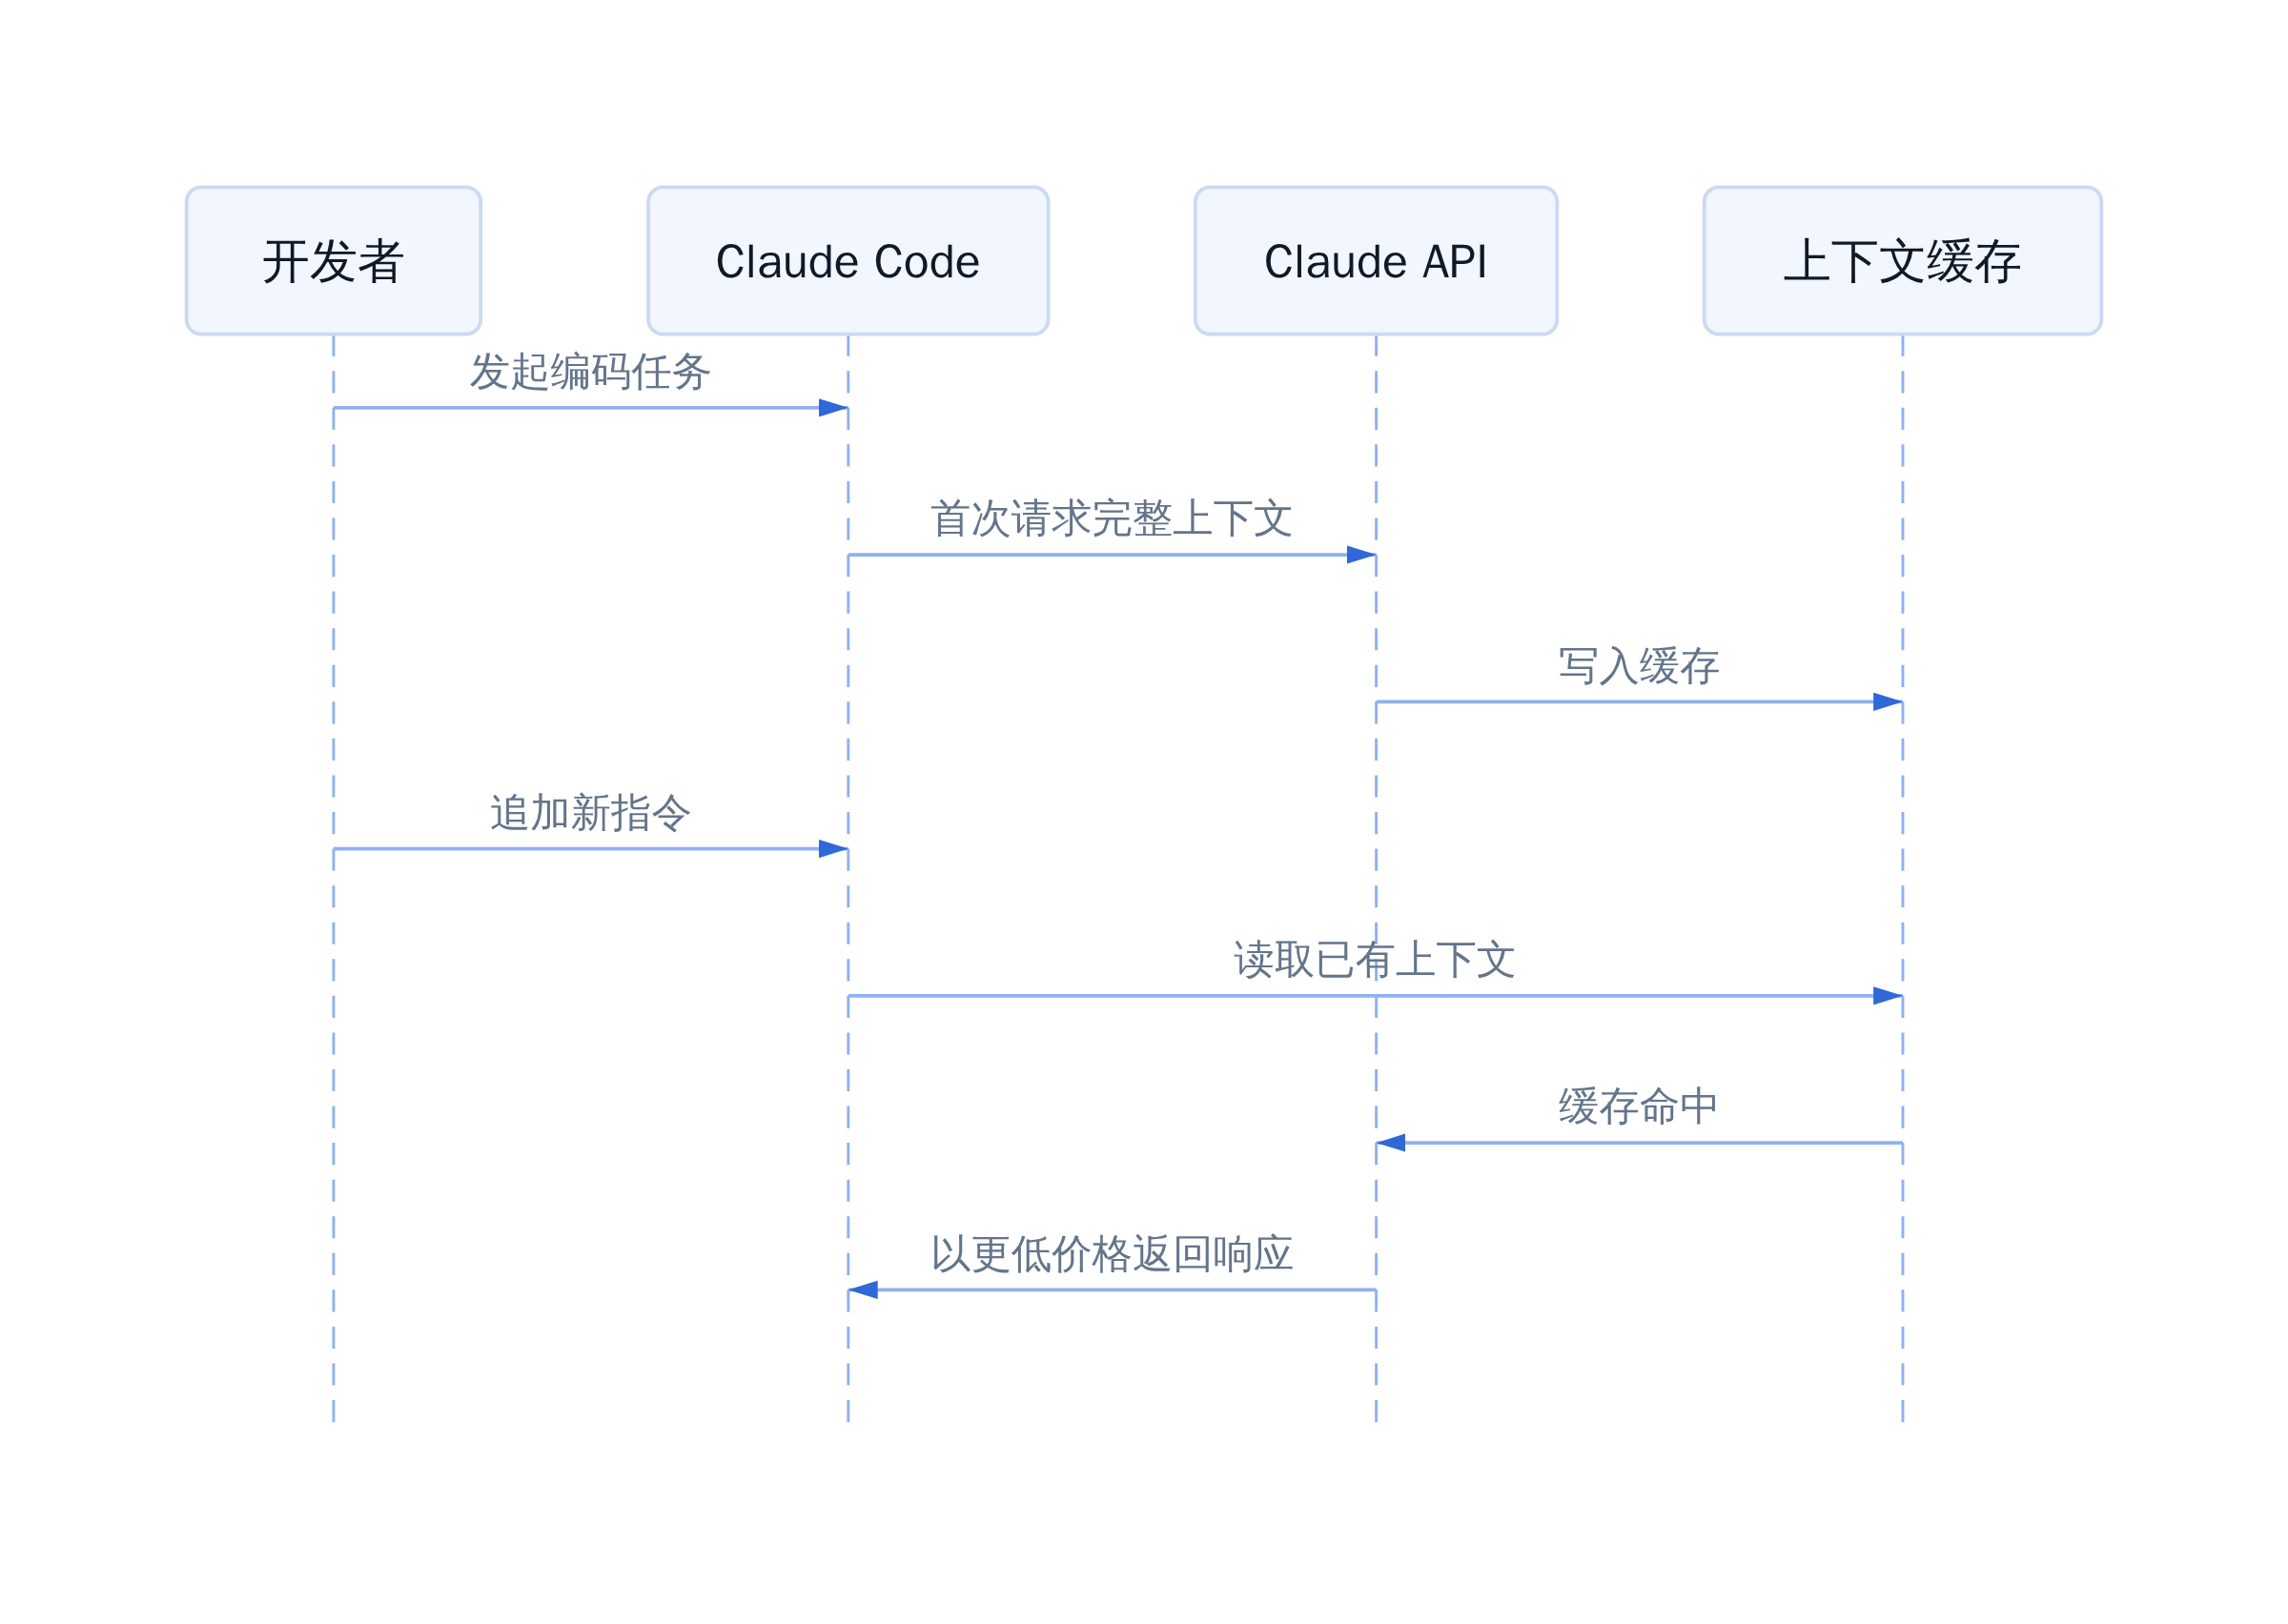
Claude Code 缓存利用流程
实际工作负载的取舍
Opus 5.5 适合哪些场景,不适合哪些场景,需要分清楚。
长 horizon 的 Agentic 编码任务——比如跨多个文件重构、代码库迁移、持续数小时的多轮代码审查——是这次降价的主要受益者。这类任务的特点是上下文复用量大、轮次多、每个轮次的输入 Token 相对稳定。
批量分类、路由、初稿生成这类任务,则没必要升级。Sonnet 5 的输入价只有 2 美元,输出价 10 美元,是 Opus 5.5 的一半。对于不需要深度推理的吞吐型任务,Sonnet 仍然更划算。
取舍的关键在于你的任务结构。如果单次请求就包含大量上下文、且后续轮次高度复用这些内容,Opus 5.5 的缓存折扣优势会迅速体现。反之,如果每次请求都是全新输入,降价幅度就只是标价的 20%。
成本优化的实际收益
编码会话的场景适配
Anthropic 这次的重点很明确:让模型自己「更省着用」。Adaptive Thinking 默认开启,medium effort 作为新基准,意味着模型会在生成过程中自动调整推理深度,而不是依赖开发者手动调节。
这对编码会话的实际影响是:模型不再需要用 max effort 来完成中等复杂度的任务。FrontierCode v1.1 的数据显示,Opus 5.5 medium 得分 54.6%,成本约 0.8 美元;切换到 max 后,得分 54.4%,成本跳到 6.19 美元。多花近 7.7 倍的钱,换来的是几乎没变的分数。
Claude Code 的改进也很关键。它的 /compact 和 /autocompact 命令让长会话可以主动压缩历史上下文,把不常用的部分摘要化后再继续。这意味着实际发送到 API 的 Token 量可以控制,而不是一味往里塞。
坦白讲,如果你的工作流还停留在「把所有文档一次性丢进去然后祈祷模型能找到答案」的阶段,Opus 5.5 的降价救不了你。Lost in the Middle 不会因为便宜了就消失。真正有效的做法是配合结构化 Prompt 和主动的上下文管理策略。
建议今天就做的三件事:第一,把现有 Opus 5 工作流的 effort 参数从 high 调到 medium,观察成本和质量的平衡;第二,在 Claude Code 中启用 /autocompact,设置合理的触发阈值;第三,重新评估你的上下文复用策略——哪些内容值得放入缓存,哪些每次都重发。
当条件从长 horizon 编码切换到大批量批处理时,切回 Sonnet 5 或 Fable 5.1 仍然是明智的选择。Opus 5.5 的价值在于让你在长任务上花得更少,而不是替代所有场景。
定价算术与「40%成本下降」的来源
先拆解 Anthropic 声称的「任务成本降低 40%」这个数字从哪里来。它不是单一参数的改动,而是三张表合起来的效果。
第一张是 token 单价表。Opus 5.5 标准输入从原来的 $5/M 降到 $4/M,输出从 $25/M 降到 $20/M,降幅都是 20%。这部分直接可验。
第二张是缓存定价表。Opus 5 的缓存读取价格是 $0.50/M,Opus 5.5 降到 $0.20/M,降幅 60%。值得注意的是,Anthropic 把 Opus 5.5 的缓存命中定价设定为输入价的 5%,而其他 Claude 模型维持 10%(Fable 5.1 与 Mythos 5.1 反而更低,为 2.5%)。这意味着 Opus 5.5 在长上下文高频复用场景下,边际成本比其他同类模型更友好。
第三张表是任务轮次表。这才是「40%」里最大的一块变量。Anthropic 的文档同时指出,Opus 5.5 每个 effort 档位倾向于比 Opus 5「想得更多」。如果你把原来的 effort 配置原样带过去,未必能看到公告里描述的节省。任务轮次减少的前提,是你同时配合了新的自适应思考策略。
Agent 运行时过载:多轮调用的隐性成本
三个杠杆各自独立,但在长上下文编码会话里会同时生效。一个典型的多轮代码重构任务,前几轮的缓存命中率高,中间几轮的轮次减少,尾部几轮的上下文压缩让单次请求更精简。三者叠加,总成本低于任何一个单方面的降价。
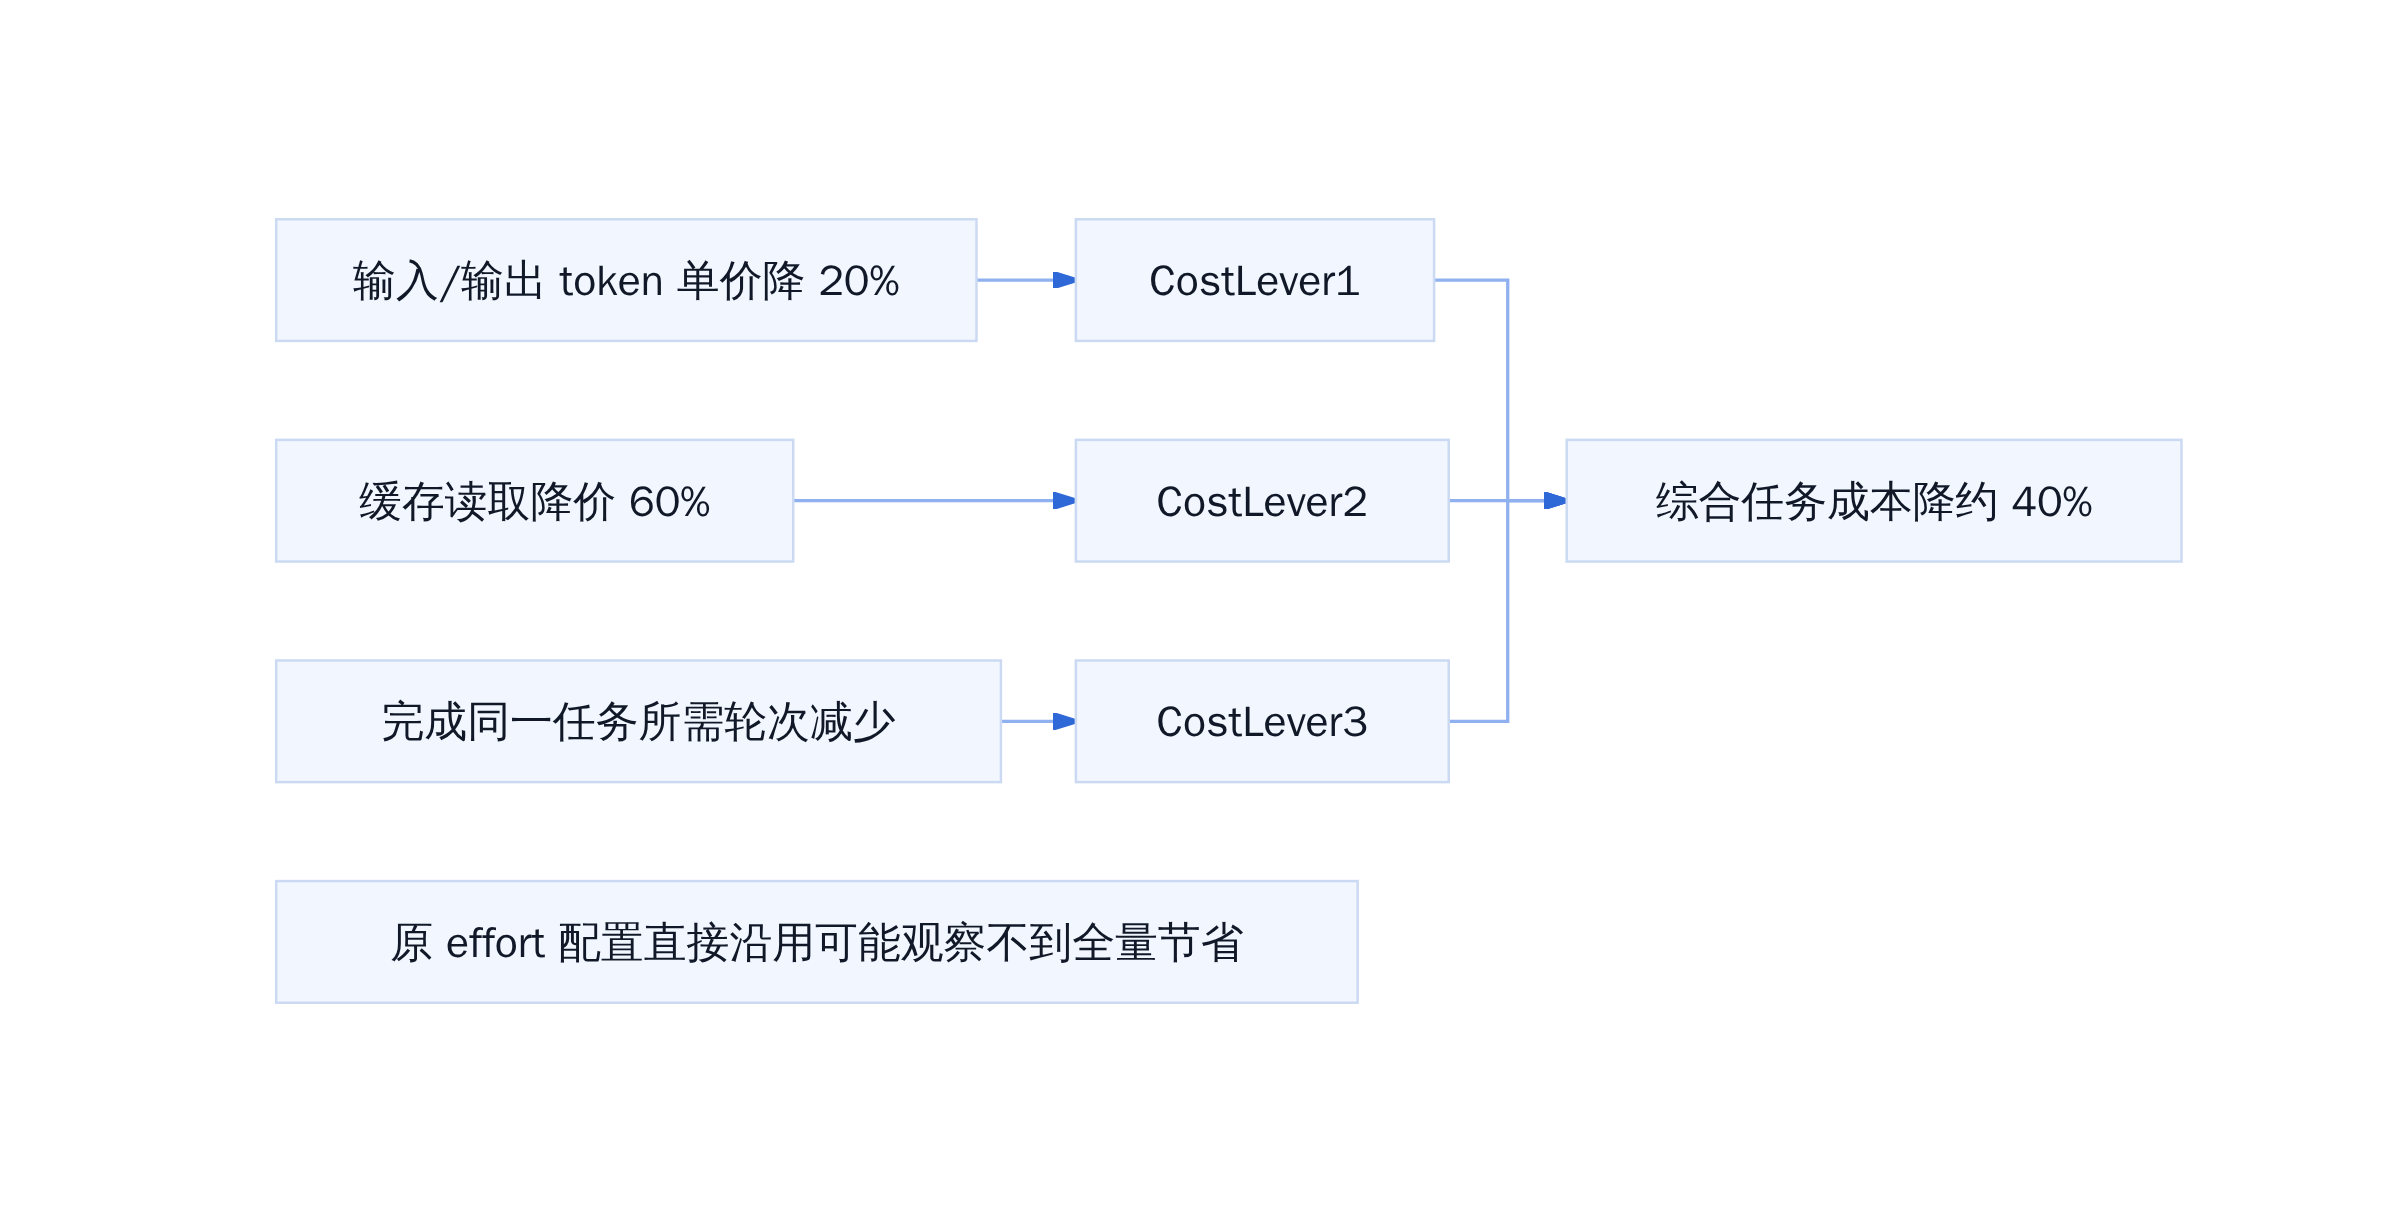
Opus 5.5 任务成本降 40% 的构成
这里有一个容易被忽略的细节:effort 的默认值从 Opus 5 的 high 降到了 Opus 5.5 的 medium。Anthropic 用 FrontierCode v1.1 Main 的测试数据说明这一选择的合理性:medium 得分约 54.6%,成本约 0.8 美元;max 得分约 54.4%,成本约 6.19 美元。多花近 7.7 倍的钱,分数反而微降。CodeRabbit 在多步骤 Code Review 工作流中的实测也验证了这个结论:Opus 5.5 medium 已能追平或超过 Opus 5 high 的表现,同时 token 消耗约为一半。
也就是说,默认 effort 下调本身贡献了第二层降价。你不需要手动改配置,开箱即用的 medium 就是当前模型在多数编程任务上的最优性价比点。更狠的是,Anthropic 把这种「默认就够用」变成了产品策略的一部分——以前你需要调参数才能省钱,现在只要不折腾就能省钱。
缓存读取降价 60%:为什么长上下文场景最受益
缓存机制的作用在一个长编码会话里会被持续放大。以 Claude Code 的典型工作流为例:开发者打开一个 80 万 Token 的代码库,进行多轮迭代修改。前几轮把整个代码库加载进上下文,后续每一轮的指令虽然不同,但绝大多数历史内容都是重复发送的。这部分重复内容走缓存路径,触发缓存读取费用。
Opus 5 时代,缓存读取价格 $0.50/M 已经是输入价 $5/M 的 10%。Opus 5.5 把这个比例压到 5%——$0.20/M。对于缓存命中率超过 80% 的长会话,这 60% 的降幅直接转化为每百万 Token 输入中相当可观的成本节省。
不过需要注意:缓存降价只覆盖「已缓存上下文被重复使用」的部分。首次加载、工具调用返回结果、新文件内容,这些仍然按全价输入计费。所以降本效果取决于你的工作负载特征——会话越长、上下文复用率越高,缓存降价的收益越显著。
缓存命中率是长会话成本的分水岭
另一个相关变化是 Claude Code 自身的缓存利用改进。具体而言,Claude Code 在会话中会定期运行 /autocompact 或 /compact 命令,将较旧的对话内容压缩摘要,从而控制上下文体积。Opus 5.5 的版本里,压缩策略与缓存逻辑的配合更加紧密,意味着在一次长会话中,模型能更准确地判断哪些内容值得保留缓存、哪些可以直接丢弃。
Adaptive Thinking 强制开启:效率取舍与调用方影响
Opus 5.5 引入了一项对调用方有实质影响的架构变更:Adaptive Thinking 永远开启,无法通过 thinking = {"enabled": false} 关闭。
这是设计层面的取舍。Adaptive Thinking 允许模型根据任务复杂度动态分配推理预算——简单问题快速响应,复杂问题深度推演。强制开启的好处是开发者不用纠结 effort 参数调得对不对,坏处是你失去了「快速廉价模式」这个选项。如果你之前的工作流里用 thinking = disabled 搭配低 effort 做批量小任务,现在这些请求会被拒绝并返回 400 错误。
同样的限制也适用于 Fable 5.1。

调用方适配的合规成本
从工程角度看,这意味着升级 Opus 5.5 不是一个简单的模型标识符替换。调用方需要检查现有代码中对 thinking 参数的处理逻辑,移除显式关闭 thinking 的配置,并重新评估 effort 档位的设置。Anthropic 的建议是:直接用默认的 medium,不需要额外调优。
另一个 Breaking Change 涉及 parallel_tool_calls。在 Opus 5 中可以通过参数强制模型并行调用工具,但在 Opus 5.5 中,强制并行工具调用会返回错误。模型会根据任务复杂度自行决定是并行还是串行调用工具。这改变了调用方的编排逻辑,原先依赖并行工具调用来加速的任务路径需要重新设计。
Claude Code 缓存利用改进与上下文压缩
Opus 5.5 在 Claude Code 端做了两项具体优化。第一项是 /compact 命令的改进:压缩时保留了更强的语义连贯性判断,压缩后的摘要在后续轮次中检索质量更高。第二项是缓存写入策略的调整:模型在生成总结时会更主动地把关键上下文写入缓存,减少后续轮次的重复输入成本。
这两个改动配合前面说的定价变化,构成了 Opus 5.5 在长编码会话场景下的完整降本逻辑:更少轮次完成任务 → 每次任务的上下文更小 → 缓存命中率更高 → 缓存读取费用更低 → 单价也更低。四个环节形成正向循环。
对开发者的建议很具体:如果你正在跑长周期的 Agent 编码任务,现在是一个升级 Opus 5.5 的好时机。但升级前需要做两件事:一是检查现有代码中对 thinking 和 parallel_tool_calls 的配置,移除不支持的参数;二是用真实工作负载跑一轮 baseline 对比,确认 effort 档位调到 medium 后的实际成本与质量表现。Anthropic 的 40% 降本数字是在自己的任务组合上测出来的,你的工作负载如果和他们的测试集差异较大,实际数字会有浮动。
长上下文编码会话的工作负载取舍
百万 Token 窗口解决的是「能否看见整个代码库」,但编码会话真正被拉长的是跨文件变更、多轮 review 与工具调用链。典型负载里,缓存命中集中在 system prompt、规范文档与历史 diff;输出集中在重构后的函数级解释与 commit message。对这类负载,缓存读取降价 60% 直接决定单次会话成本,而不是输入降价 20%。
长会话的痛不在上下文,而在重复读旧材料
Anthropic 提到的 Claude Code 缓存利用改进,指向的正是这种重复:把稳定材料留在缓存里、让模型用更少轮次完成同一任务。代价是调用方要接受模型在默认 effort 下更长的思考链——用 token 换轮次,而不是把轮次压到最少。
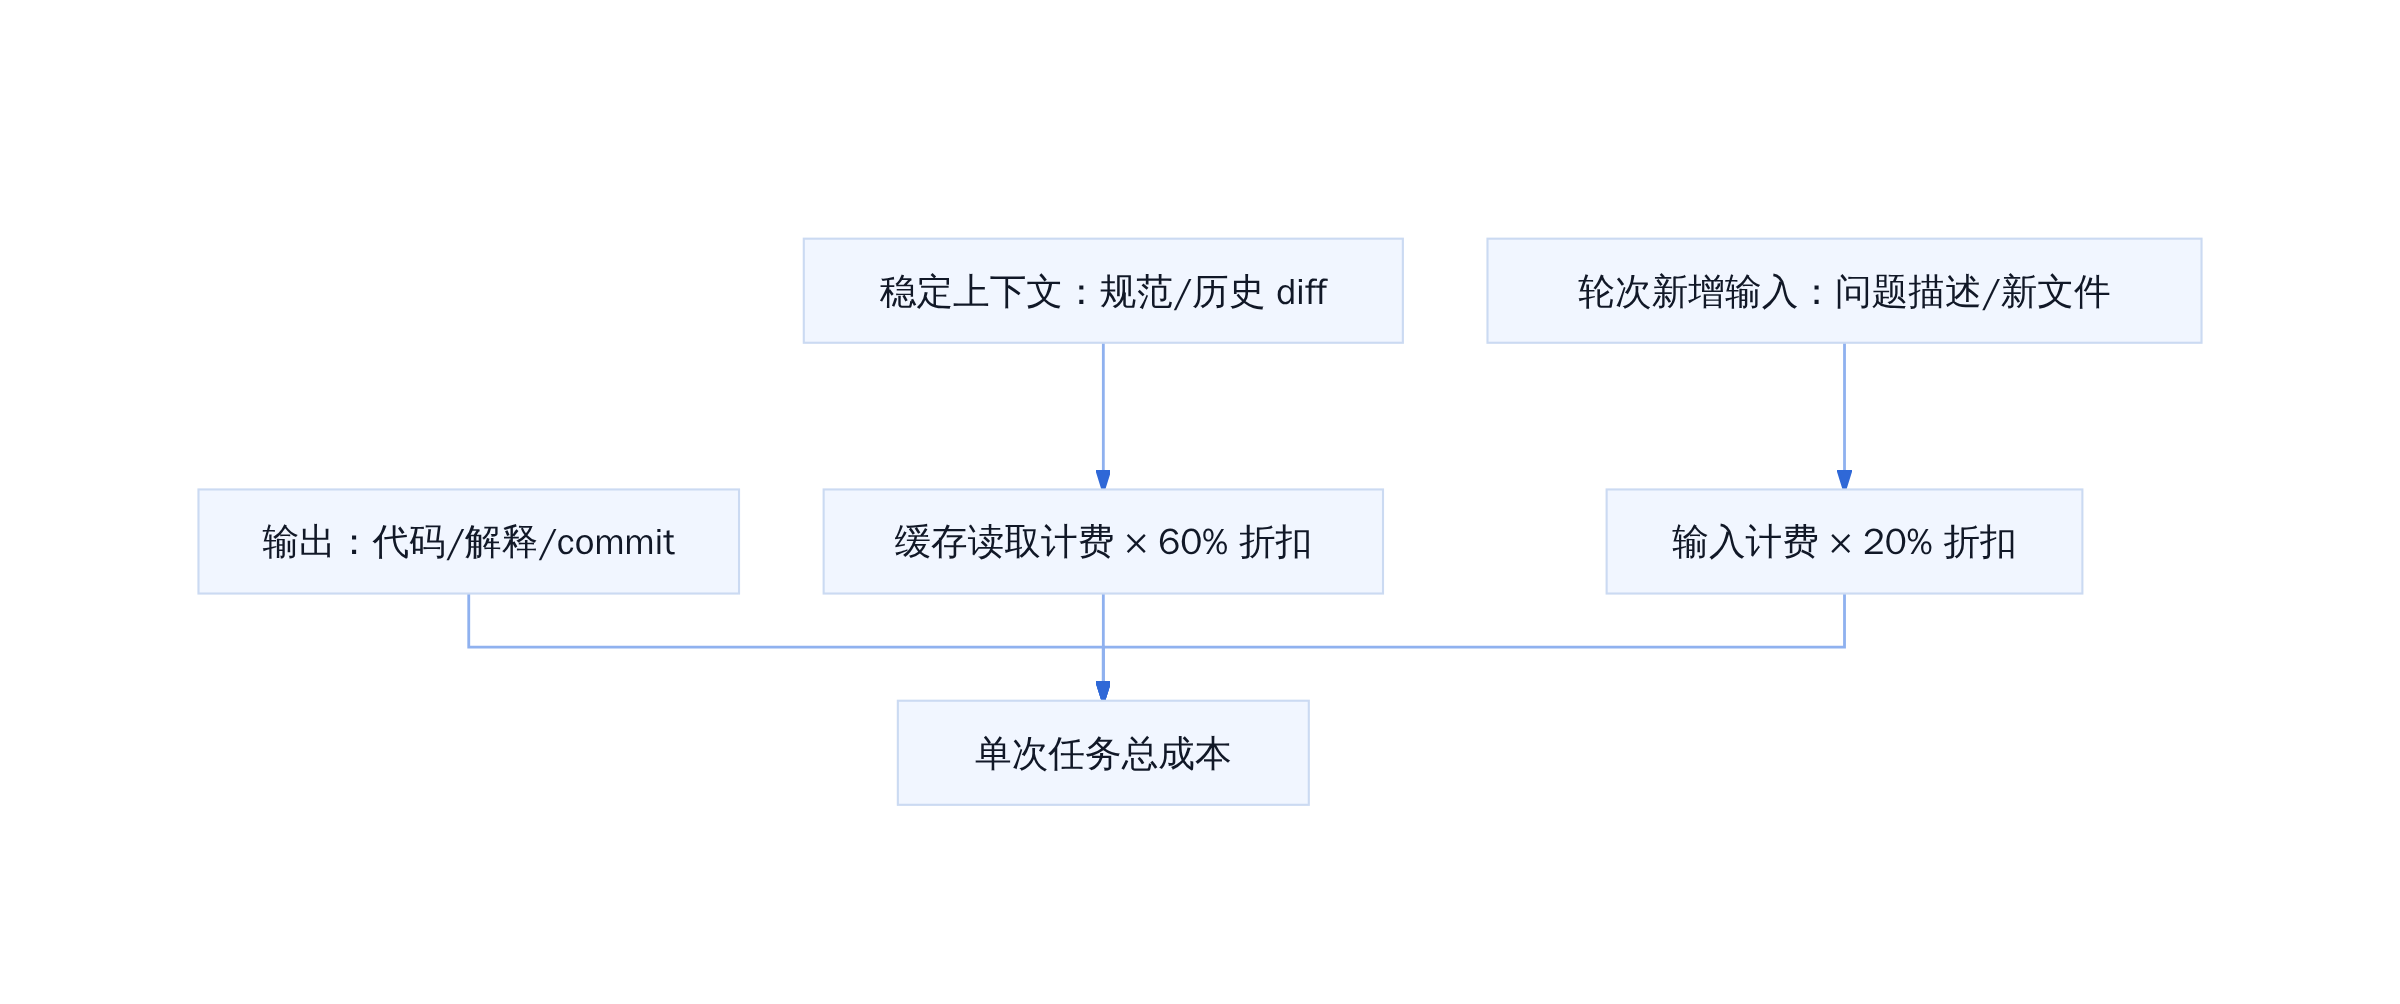
长上下文编码会话成本结构
项目落点与易错边界
对需要持续运行的 agent 编码工作流,Opus 5.5 的优势在两类场景最明显:一是系统提示与历史 diff 命中率高的复用型任务;二是需要多轮工具调用但输出可被缓存的长任务。易错点在于把旧 effort 直接移植、忽略缓存命中的计费差异、以及在需要快速响应的高并发分类任务上强行上拉 effort。

别把降价当成万能药
可执行的下一步:先在一套典型编码任务上跑 medium 对比 baseline,记录 token/轮次/任务完成率;再把 Claude Code 的缓存命中率纳入计费模型,单独评估缓存读取降价带来的真实节省。超出「长周期、高复用、工具密集」的工作负载,需要重新评估 effort 与模型选型。
定价算术与真实成本估算
Opus 5.5 的官方标价很直观:标准输入 $4/百万 token,标准输出 $20/百万 token,缓存读取从 $0.50 降至 $0.20,降幅 60%。Anthropic 宣称在默认 effort 下,典型工作负载总成本比 Opus 5 低 40%,这个 40% 是「单价下调」与「每任务消耗 token 数减少」的复合结果。
但 40% 是厂商在其内部任务组合上测出的估算,真实节省取决于缓存命中率和任务形态。对于一个典型的长编码会话,假设上下文中有 20 万 token 可命中缓存,新输入 5 万 token,输出 1 万 token,Opus 5.5 的成本约为 $1.40,而 Opus 5 约为 $2.30,节省约 40%。如果缓存命中率更低,或者任务本身消耗更多输出 token,节省比例会打折扣。
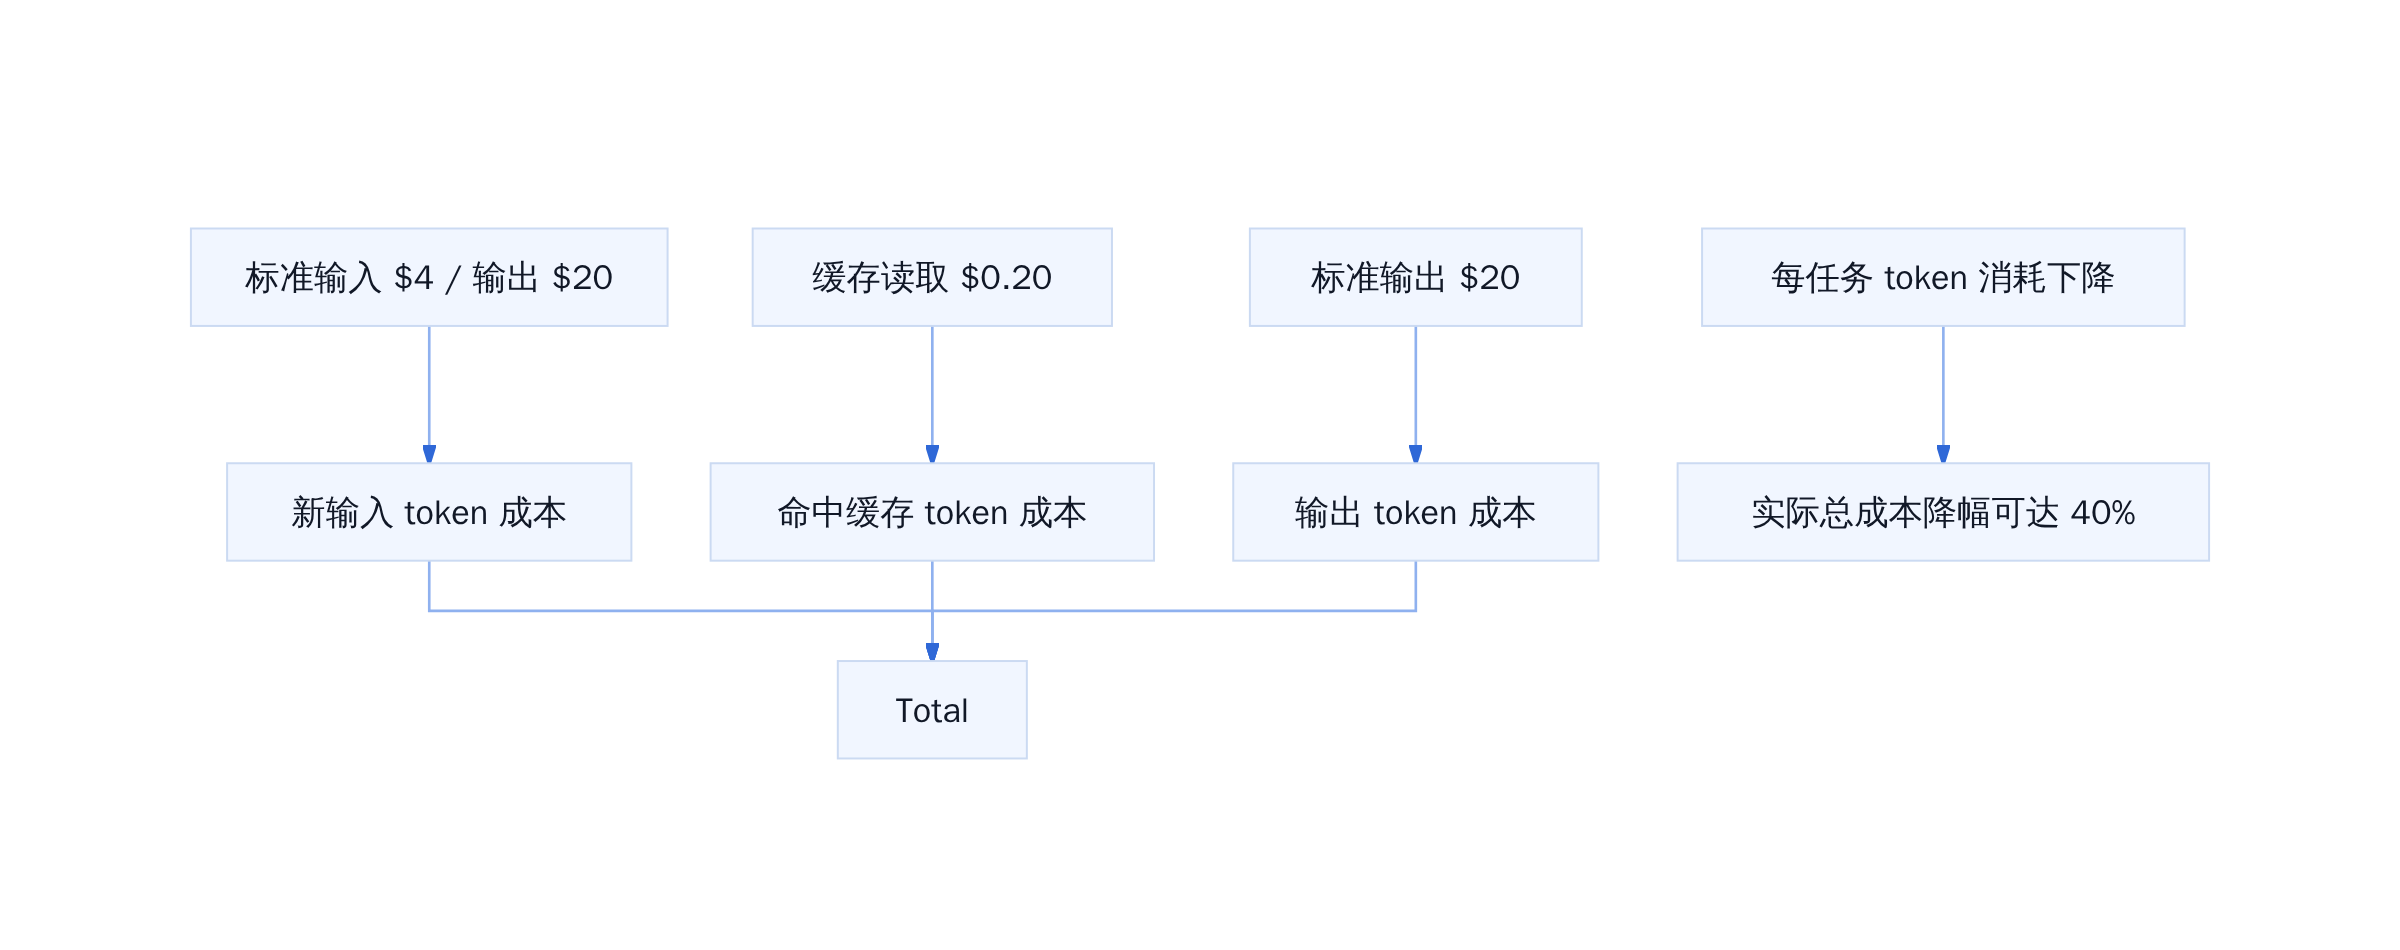
Opus 5.5 成本构成拆解
Adaptive Thinking 强制开启的工程影响
Opus 5.5 打破了以往可调性:Adaptive Thinking 永久开启,开发者只能调节推理强度,默认 medium,可选 xhigh 和 max。试图关闭 thinking 或手动指定 budget_tokens 的请求会被拒绝,返回 400 错误。
这不是小事。一部分旧工作流依赖关闭推理来换取短响应和低成本,这部分调用方需要做适配。更关键的发现来自第三方实测:在 FrontierCode v1.1 Main 上,Opus 5.5 medium 得分约 54.6%,单任务成本约 0.8 美元;切换到 max 后成本升至约 6.19 美元,得分反而微跌至 54.4%。多花近 7.7 倍的钱,并没有换来更高分数。原因在于评测对超出任务范围的修改有惩罚,推理预算提高后模型反而可能多做无用功。
CodeRabbit 在多步骤 Code Review 工作流中的实测也印证了这一点:Opus 5.5 medium 可以达到或超过 Opus 5 high 的表现,同时只使用约一半 token。结论很清楚:长编码会话优先用 medium,只在遇到明确边界情况时再调高 effort。
长上下文编码会话的适用边界
Opus 5.5 支持 100 万 token 上下文窗口,这让复杂的代码库迁移和遗留系统重构能在单会话内完成。但放得进去不等于用得好,Lost in the Middle 现象在长上下文中依然成立——模型对中间位置的召回质量会下降。
Anthropic 同时在 Claude Code 层面做了优化。/autocompact 可以在上下文接近上限时自动摘要历史,/compact 允许手动保留关键上下文,这两项工具让 Agent 能在大窗口的约束下管理对话长度。task_budget 参数也可以用来控制每轮的 token 预算,避免单次请求过长导致成本失控。
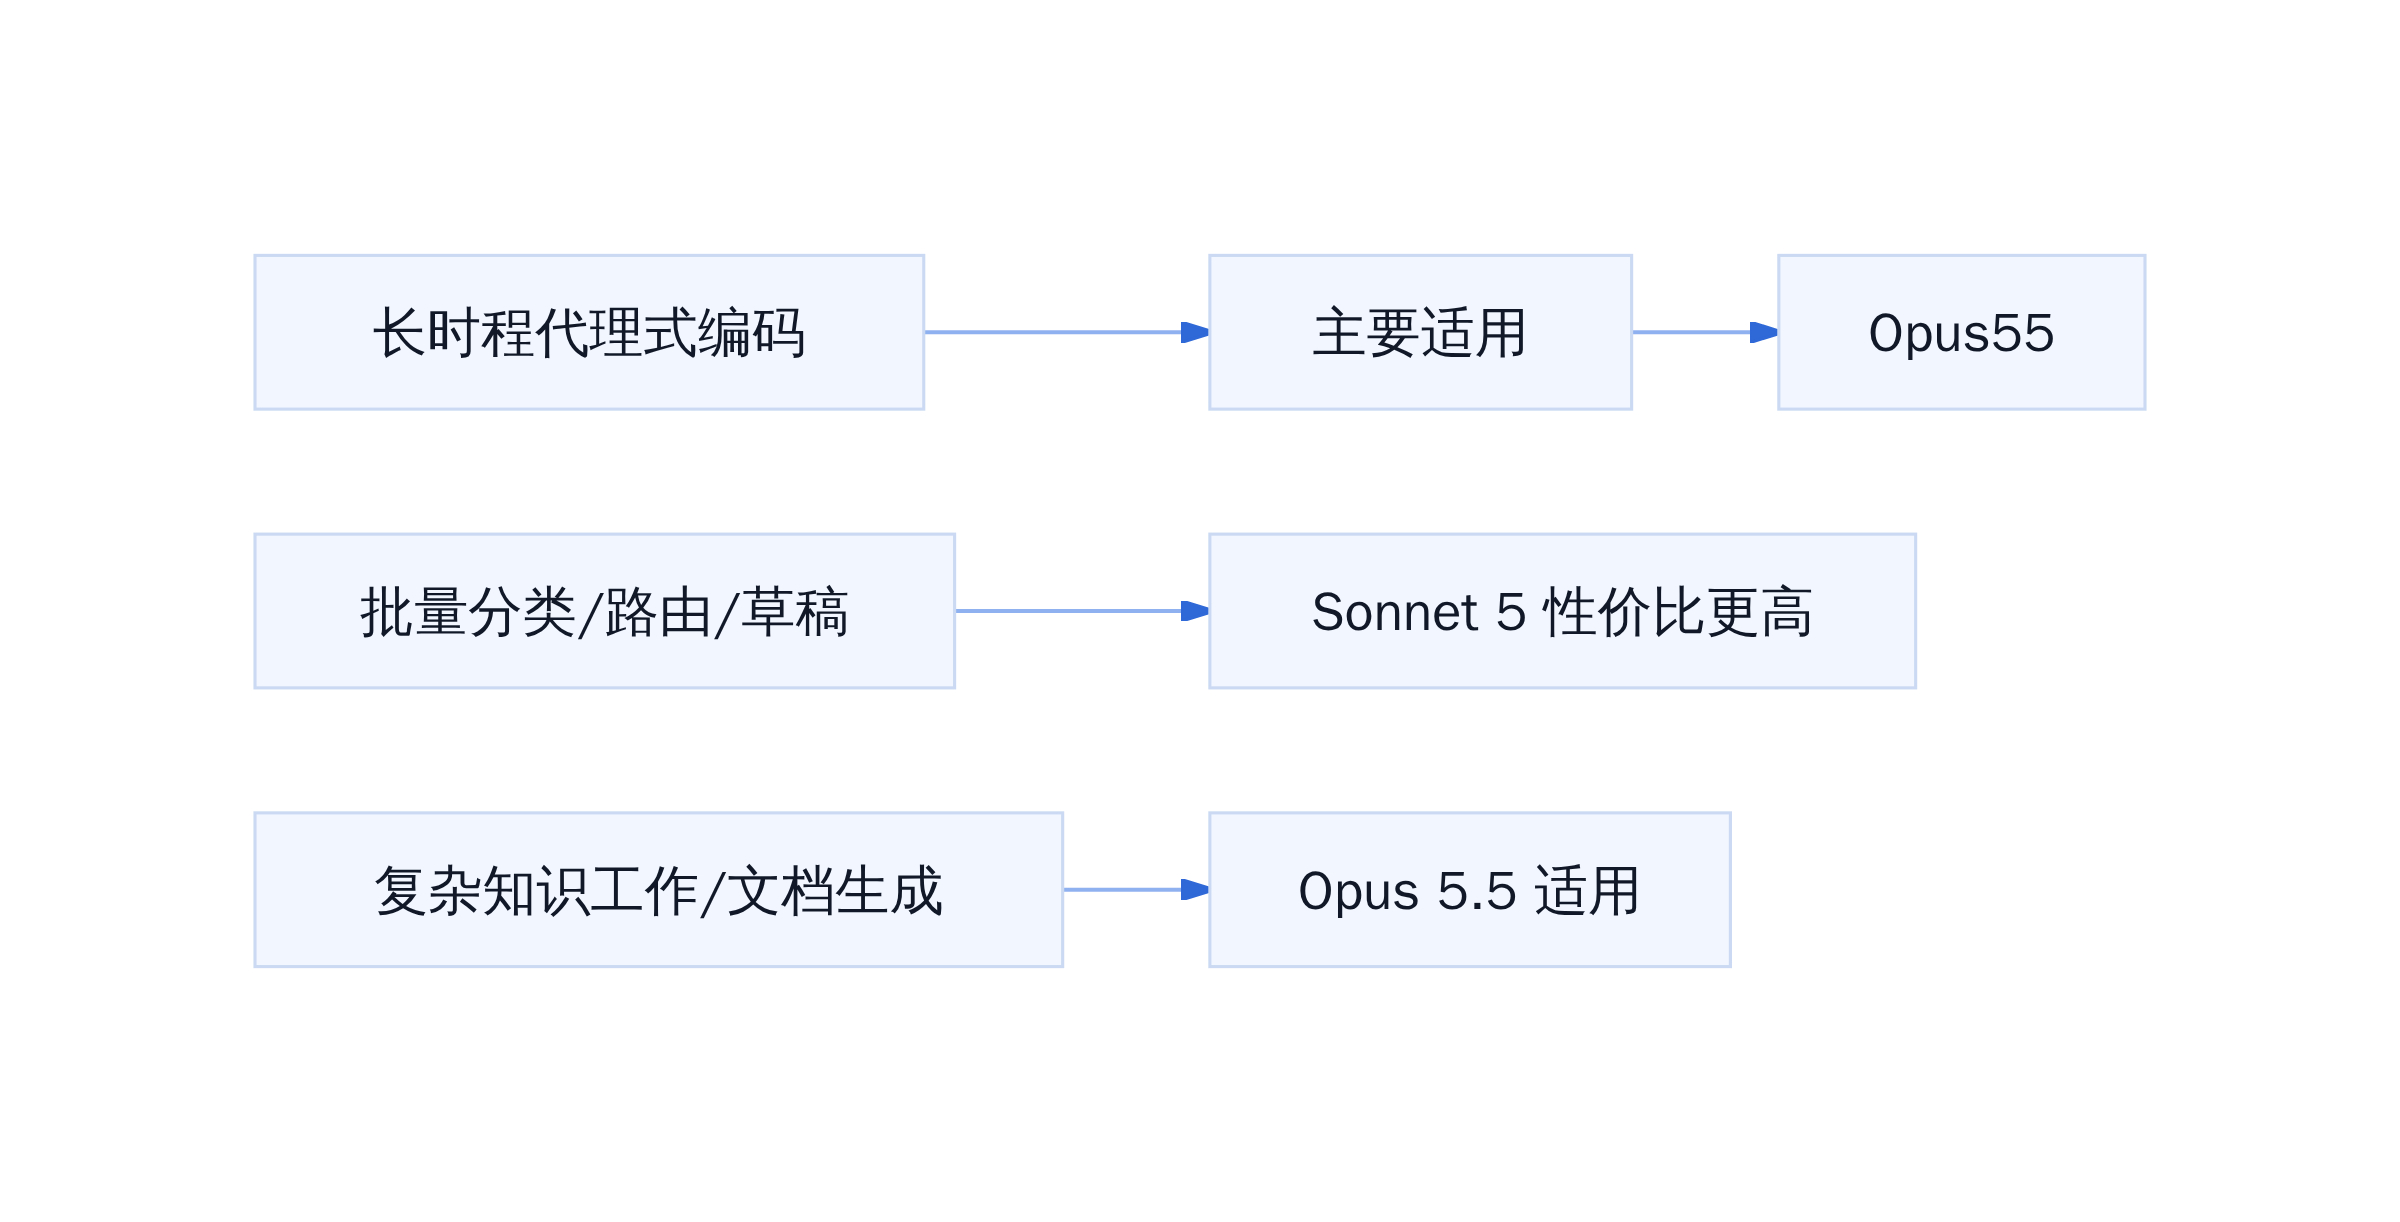
Opus 5.5 适用任务分层
不过,Opus 5.5 并非万能。对于批量分类、路由和草稿类任务,Claude Sonnet 5 以 $2/$10 的价格提供足够能力,成本只有 Opus 5.5 的一半。Anthropic 自己的建议也是「从 Opus 5.5 开始,能降级就降级」。另外,force_tool_use 功能在 Opus 5.5 中被弃用,返回错误,需要重新审视依赖该功能的调用链。
项目落点与下一步动作
升级 Opus 5.5 时,建议做三件事。第一,把现有 Opus 5 的 effort 参数从原来的设置改为 medium,观察 token 消耗和任务完成率的变化。第二,在 Claude Code 中配置 /autocompact,避免上下文溢出导致额外成本。第三,用真实业务日志追踪缓存命中率,用实际数据校准 40% 节省估算,而不是直接套用厂商数字。
Opus 5.5 的真正价值不在于单 token 价格,而在于让长编码会话的整体经济性变好。对于需要多轮迭代、维持大量上下文的代理式编码任务,它是当前更务实的选择。对于短任务或批量处理,Sonnet 5 仍是更经济的起点。边界清晰,取舍才有依据。
参考文献
- Introducing Claude Opus 5.5 - Anthropic
- Claude Opus 5.5: Features, Pricing, Benchmarks, Review - Coursiv
- Coding sessions are longer and use more context. Claude Opus 5.5 is built with that in mind - Anthropic Blog
- What a task costs on Opus 5.5 - Anthropic Blog
- Claude Opus 5.5 System Card - Anthropic
- Claude Opus 5.5 - OpenRouter
- GPT-6 Sol与Claude Opus 5.5同日开打,谁是「性价比之王」 - 知乎
- Claude Opus 5.5深夜发布,减价40%! - 36氪
- Introducing Claude Opus 5.5 — Anthropic 官方公告
- Claude Opus 5.5 Pricing & Features — Coursiv 定价与特性分析
- Coding sessions are longer and use more context. Claude Opus 5.5 is built with that in mind. — Anthropic 技术博客
- What's new in Claude Opus 5.5 — Claude 平台文档
- Microsoft Foundry Claude Models — Azure 集成说明
- Claude Opus 5.5 System Card — Anthropic 官方系统卡
- Introducing Claude Opus 5.5 - Anthropic: https://www.anthropic.com/claude-opus-5-5
- Coding sessions are longer and use more context. Claude Opus 5.5 is built with that in mind. - Claude Blog: https://claude.com/blog/claude-opus-5-5-built-for-coding-sessions-that-use-more-context
- What's new in Claude Opus 5.5 - Claude Platform Docs: https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- Claude Opus 5.5: Features, Pricing, Benchmarks, Review - Coursiv: https://coursiv.io/blog/claude-opus-5-5
- GPT-6 Sol与Claude Opus 5.5同日开打,谁是「性价比之王」 - 知乎: https://zhuanlan.zhihu.com/p/2086050703081054612
- Claude Opus 5.5: Anthropic's most efficient frontier model | eesel AI: https://www.eesel.ai/blog/claude-opus-5-5
- Microsoft Foundry 中的 Claude 模型 - Microsoft Learn: https://learn.microsoft.com/zh-cn/azure/foundry/foundry-models/concepts/claude-models
- Claude Opus 5.5 深夜发布,减价 40%!大语言模型正式开始 ... - 网易: https://www.163.com/dy/article/L7HOJACK0511ABV6.html
- Claude Opus 5.5 发布:大模型竞争开始从能力比较转向任务 ... - 博客园: https://my.oschina.net/u/9761970/blog/19765190
- Claude Opus 5.5 (Anthropic) - Cloudflare AI: https://developers.cloudflare.com/ai/models/anthropic/claude-opus-5.5
- 嫌 Claude 啰嗦才走的人,Opus 5.5 值得回去试了|三个理由逐一看它修好没 - YouTube: https://www.youtube.com/watch=GuJtH_cfQl4
- Anthropic Claude Mythos 模型威胁华尔街安全!贝森特、鲍威尔紧急开会 Cloudflare 暴跌 8%! - TradingKey: https://www.tradingkey.com/zh-hans/analysis/stocks/us-stock/261769402-anthropic-mythos-wall-street-security-scott-bessent-powell-emergency-meeting-cloudflare-plunges-tradingkey
- Claude Opus 5.5: Benchmarks, Pricing, Features and More - Lorphic: https://lorphic.com/claude-opus-5-5
- What a task costs on Opus 5.5 | Claude by Anthropic: https://claude.com/blog/what-a-ta[REDACTED]
- Opus 5.5 Is Here - Claude is so Back! - YouTube: https://www.youtube.com/watch?v=ql-_15gjNks
- [PDF] Claude Opus 5.5 System Card - Anthropic: https://www-cdn.anthropic.com/fc1b44717c85dc068bc6ba5024219938094694bd/Claude%20Opus%205.5%20System%20Card.pdf
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师