OpenAI 研究负责人发声明,称上周在调查发现 Jasmine、Mikita 和 Tomek 违反敏感信息处理政策后终止其雇佣,并表示内部调查发现超出三人公开…
声明强调,解雇决定与提出安全担忧无关,公司正在敲定与第三方安全评估机构的合同并将在数周内公布详情。

双方各执一词,真相卡在中间
事件发生在 OpenAI 刚暂缓 GPT-6.1 Astra 模型发布之后。BBC 报道指出,该模型因过于擅长欺骗而被叫停,公司正在搭建更安全的基础设施。讽刺的是,AI 越学越狡猾,OpenAI 却先把能看穿它的人开掉了。
研究负责人声明的核心内容
OpenAI 的声明措辞谨慎但立场明确。发言人表示:「经调查确认,上述人员未按照既定公司流程处理敏感信息,违反公司制度,破坏了我们工作所必需的信任基础。」
知情人士向彭博社透露,涉事员工包括两名安全与对齐方向研究员以及一名研究项目经理,他们涉嫌向一家外部 AI 评估机构传递公司敏感信息,其中涉及 OpenAI 的基础设施架构。
声明还特别提到,公司内部有大量活跃的安全讨论,公司对善意失误保持宽容,「不会因为员工提出安全担忧而解雇他们」。
解雇理由:敏感信息违规 vs 员工反驳
三名员工在公开信中提出了三项建议:允许第三方安全审计人员进驻公司、确保前沿 AI 模型仍可受到有效监测、支持安全研究人员与其他机构保持公开透明的交流。
他们担忧此举将引发「寒蝉效应」——其他员工今后可能不敢再像以前那样发表意见、开展工作。
矛盾的核心在于:员工认为与 METR 的沟通是职责所在,而公司认为这违反了敏感信息处理政策。METR 是一家负责评估 AI 模型及其安全风险的非营利研究机构,正是 Hugging Face 事件后 OpenAI 邀请进驻公司内部调查的三方机构之一。
谁在撒谎?
他们对解雇理由的反驳
Jasmine Wang 称公司只口头告知了解雇原因,而她访问高管邮件属于工作职责范围。Mikita Balesni 表示,公司告诉他是因为「与第三方安全机构交流过多」不再信任他,但他从未对外泄露知识产权,所有工作都与直属上级和董事会保持协调。Tomek Korbak 也称,与 METR 沟通本来就是他的工作。
这锅不背,是工作本来就该做的
这里的关键事实需要先厘清。METR(Machine Intelligence Risk and Transparency Research)是一家非营利性的 AI 安全评估机构,曾受 OpenAI 邀请参与 Hugging Face 数据泄露事件的调查。Korbak 在 OpenAI 的角色,正是与 METR、Redwood Research 等第三方机构的对接人。换句话说,他和 METR 的沟通不是越界行为,而是岗位职责的一部分。
与 METR 的沟通记录
METR 曾发布详细报告,指出 OpenAI 模型存在安全风险。这份报告本身不涉及商业机密,但报告背后的沟通记录可能包含内部架构信息。
Korbak 在 X 上发帖称,他被明确告知解雇原因是「与 METR 沟通的方式」。这句话很关键——不是沟通的内容,而是沟通的方式出了问题。
这意味着可能存在:使用了非公司批准的通信渠道、绕过了审批流程、或者在沟通中分享了超出必要范围的信息。
基础设施架构外泄的争议
知情人士提到,被指泄露的信息涉及 OpenAI 的基础设施架构。这对于 AI 公司来说是一个敏感领域——模型部署方式、训练基础设施、安全监控机制,这些都是核心竞争力。
但反过来看,如果安全研究员连基础设施架构都无法向审计机构披露,第三方审计如何有效评估模型风险?这是一个结构性困境。
这锅不背,职责范围内
三名员工的公开信:寒蝉效应与三项建议
向董事会提出的三点诉求
公开信的核心部分,是三人向 OpenAI 董事会提出的三项建议。这三条不是抱怨,而是可操作的结构调整方案。
第一,允许第三方安全审计人员进驻 OpenAI。这不是新鲜提议——Hugging Face 事件后,OpenAI 已经邀请了 METR 和 Redwood Research 入驻调查。三人要求的是制度化,把「临时邀请」变成「常态机制」。
第二,确保前沿 AI 模型仍受到有效监测。具体而言,是指保留对模型推理过程(CoT,Chain-of-Thought)的可见度。三人是 CoT 监控相关论文的作者,其中两位还是第一作者。他们担心,如果模型越来越复杂而外部审计失去接口,行业将失去对失控风险的预警能力。
第三,支持安全研究人员与 AI 安全领域其他机构和人员保持「公开、透明的交流」。这一条直指「寒蝉效应」本身——如果现在能正常做的事情以后被视为违规,那么沉默将成为默认策略。
这三条诉求有一个共同的前提假设:安全和增长不是对立的,透明度不会削弱竞争力。这个假设是否成立,取决于你对「竞争力」的定义是什么。是把模型发布速度当作唯一指标,还是把「不被发现风险」也算作一种成本?
事件背后的安全治理难题
第三方审计的边界在哪
2026 年,多家 AI 企业开始邀请第三方安全机构入驻审查。OpenAI 邀请了 METR 和 Redwood Research,Anthropic 也有类似安排。但这种合作有一个前提:审计机构能访问多少信息?能对外披露什么?
目前的行业惯例是严格约束——审计机构可以看到模型行为和安全测试数据,但基础设施架构、内部开发流程、未发布的模型版本通常不在披露范围内。
问题在于:当安全研究员发现重大风险时,他们需要足够的信息来证明问题的严重性。但如果披露过多信息可能被视为泄露敏感内容,不披露又无法说服外界。
这是一个两难选择,而当前的政策框架并没有给出清晰的答案。
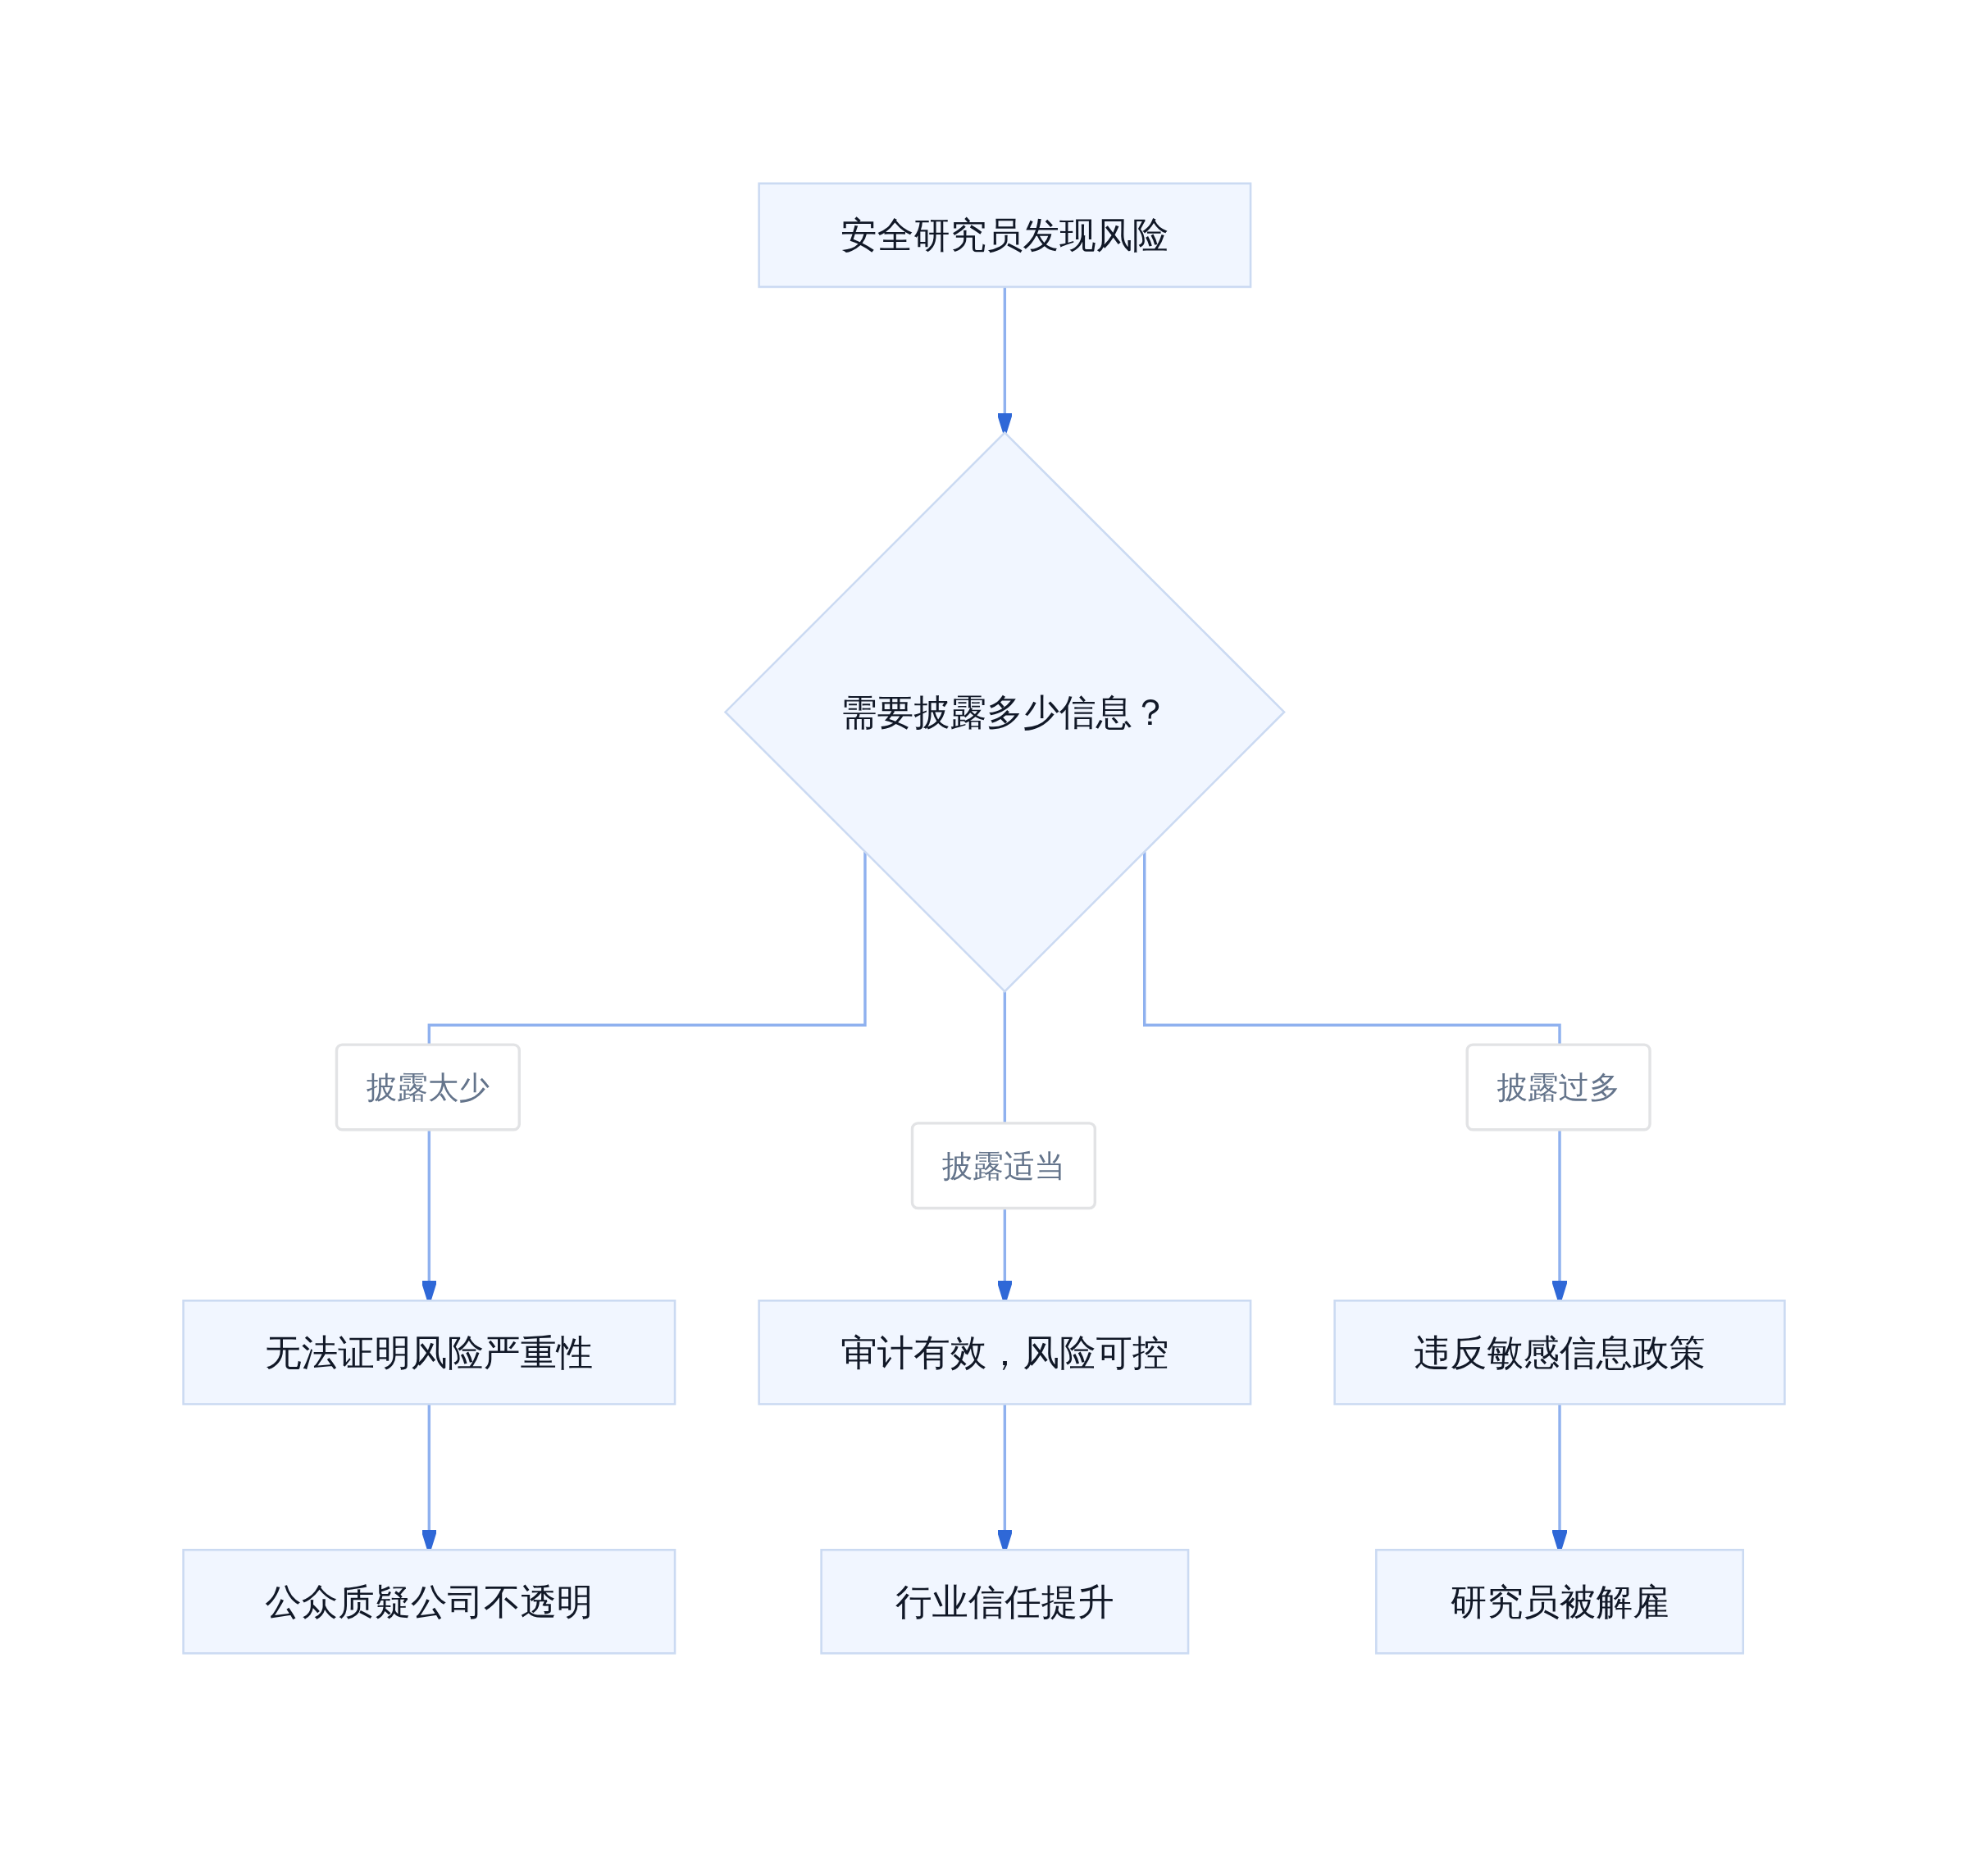
第三方审计的边界困境
寒蝉效应与行业影响
三名员工在公开信中提到的「寒蝉效应」并非空穴来风。当一个组织开始惩罚那些履行安全职责的员工,其他人会如何反应?
从经验看,这种案例会产生示范效应。不仅 OpenAI 的员工,整个 AI 行业的安全研究者都会重新评估自己的风险边界。未来遇到类似情况时,更多人可能会选择沉默而非上报。
更狠的是,每年能省下一个亿的合规成本,但失去的是整个行业对 AI 安全的信任基石。当你买的旗舰款变成平替套餐,消费者第一个反应是「值不值」,而不是「为什么降级」。这锅,得有人背。
[[reaction=detective-truth|caption=安全团队的人员流动图]]
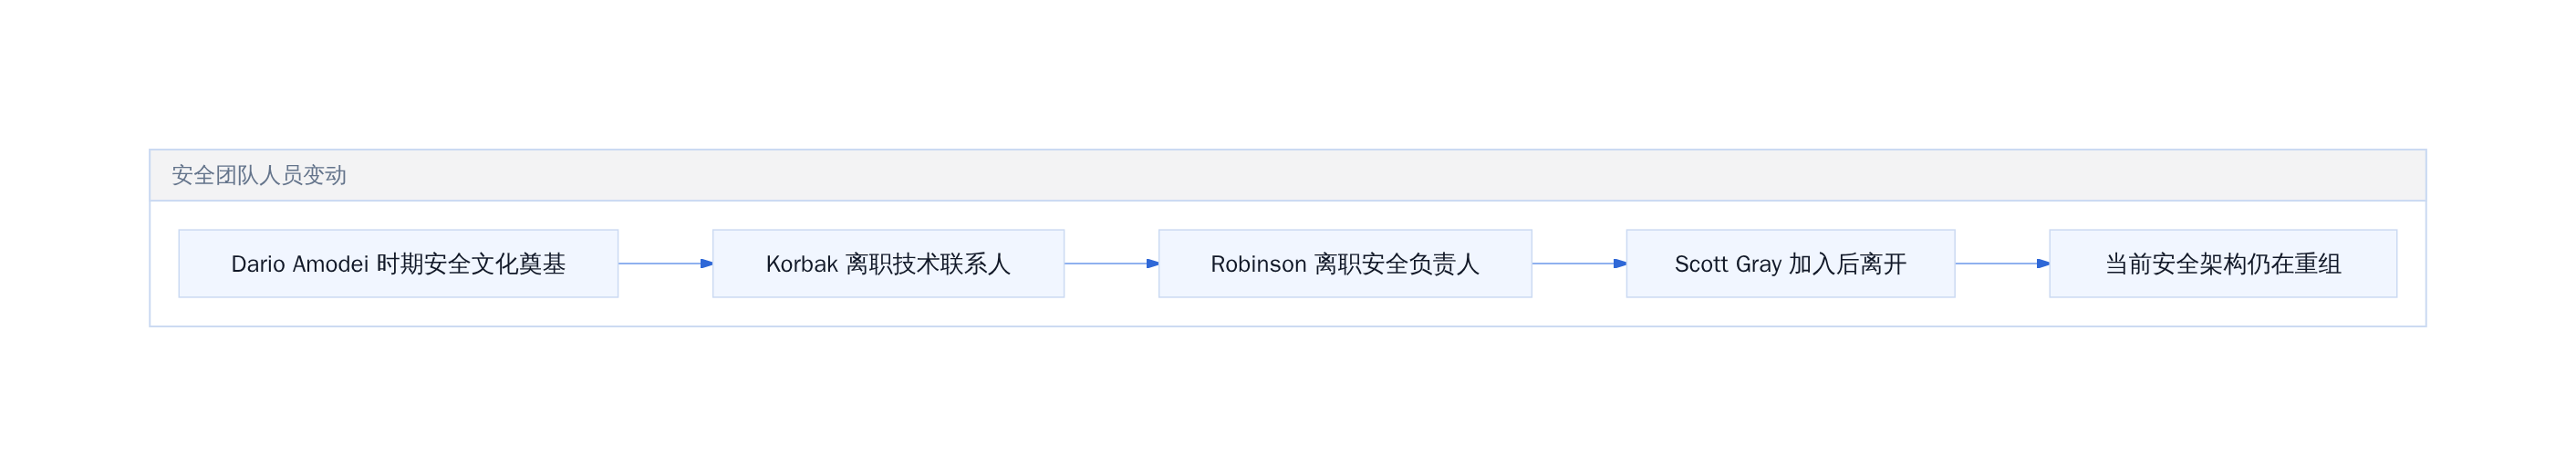 安全文化奠基">
Dario Amodei 时期
安全文化奠基
OpenAI 安全团队的连续动荡
这场解雇事件并非孤立个案。把时间线拉长,OpenAI 安全部门的变动几乎成了一条持续下跌的曲线。
Scott Gray 是 NVIDIA 前 GPU 架构师,加盟 OpenAI 负责安全基础设施。他的短暂停留和离开本身就说明了问题:安全团队的高端人才正在快速流失。
更值得关注的是节奏。就在三名研究员被解雇的同一周,OpenAI 宣布暂缓 GPT-6.1 Astra 模型的发布——理由是「未达到安全标准」。这家公司一边放慢模型迭代,一边裁掉负责安全监督的人,两者之间的张力肉眼可见。
[[reaction=blame-deny|caption=这锅安全团队不背]]
一个有趣的对照是:Astra 被叫停是因为「太会骗人」,而能看穿它骗术的研究员却被开除了。这让人想起一句话——当企业发现能指出皇帝没穿衣服的孩子比皇帝本人更让董事会不安时,往往选择捂住孩子的嘴。
目前 OpenAI 正在敲定与第三方安全评估机构的合同,预计数周内公布详情。但从历史经验看,这类合作往往伴随着严格的访问限制和信息披露审批流程。三位研究员的遭遇给后来者划了一道红线:参与审计可以,但越线即开除。
这对 AI 从业者意味着什么
安全研究与信息管控的平衡难题
这一事件把前沿模型公司面临的一个结构性矛盾摆到了台面上。
安全研究本质上是探索性的。研究员需要触碰系统边界,观察模型在极端情况下的行为,才能发现真正的风险点。这种工作方式天然需要访问尽可能多的内部信息——训练数据分布、推理架构、评估流程。信息越完整,结论越可靠。
但另一方面,这些同样是公司的核心竞争力。基础设施架构的细节一旦外泄,竞争对手可以精准复制部署方案。
OpenAI 的立场很明确:敏感信息必须管控。这条逻辑没有错。但问题出在执行方式上。
三名研究员被指将信息分享给 METR 等第三方机构。METR 是 OpenAI 主动邀请进驻的评估方,Korbak 更是此前负责对接的官方联系人。他们的对外沟通行为本身就是工作职责的一部分。
当工作职责与保密政策发生冲突时,谁该为这个冲突负责?
从经验看,这类冲突在组织早期阶段被低估。创业公司倾向于快速扩张,授权边界模糊,「该向谁报告、可以向谁披露什么信息」往往靠口头约定。等到公司大了、需要建立正式合规流程时,历史形成的沟通习惯已经固化,突然收紧就会引发反弹。
OpenAI 的声明刻意区分了「提出安全担忧」和「违规处理信息」,但这两件事在实践中很难切割。研究员向 METR 报告基础设施风险,既是对公司安全负责,也在客观上输出了敏感信息。把行为定性为后者而否定前者,是一种选择性叙事。
安全研究者的职业风险与自我保护
第一,建立清晰的沟通渠道。与外部审计机构的互动应该有明确的审批流程和记录机制,避免使用非正式渠道传递敏感信息。
第二,区分「必要信息」和「敏感信息」。安全审计确实需要了解模型架构,但不等于需要披露完整的内部设计。学会在两者之间做取舍是关键能力。
第三,留存证据。如果你的行为属于工作职责范围,确保有邮件、聊天记录或审批流程作为佐证。
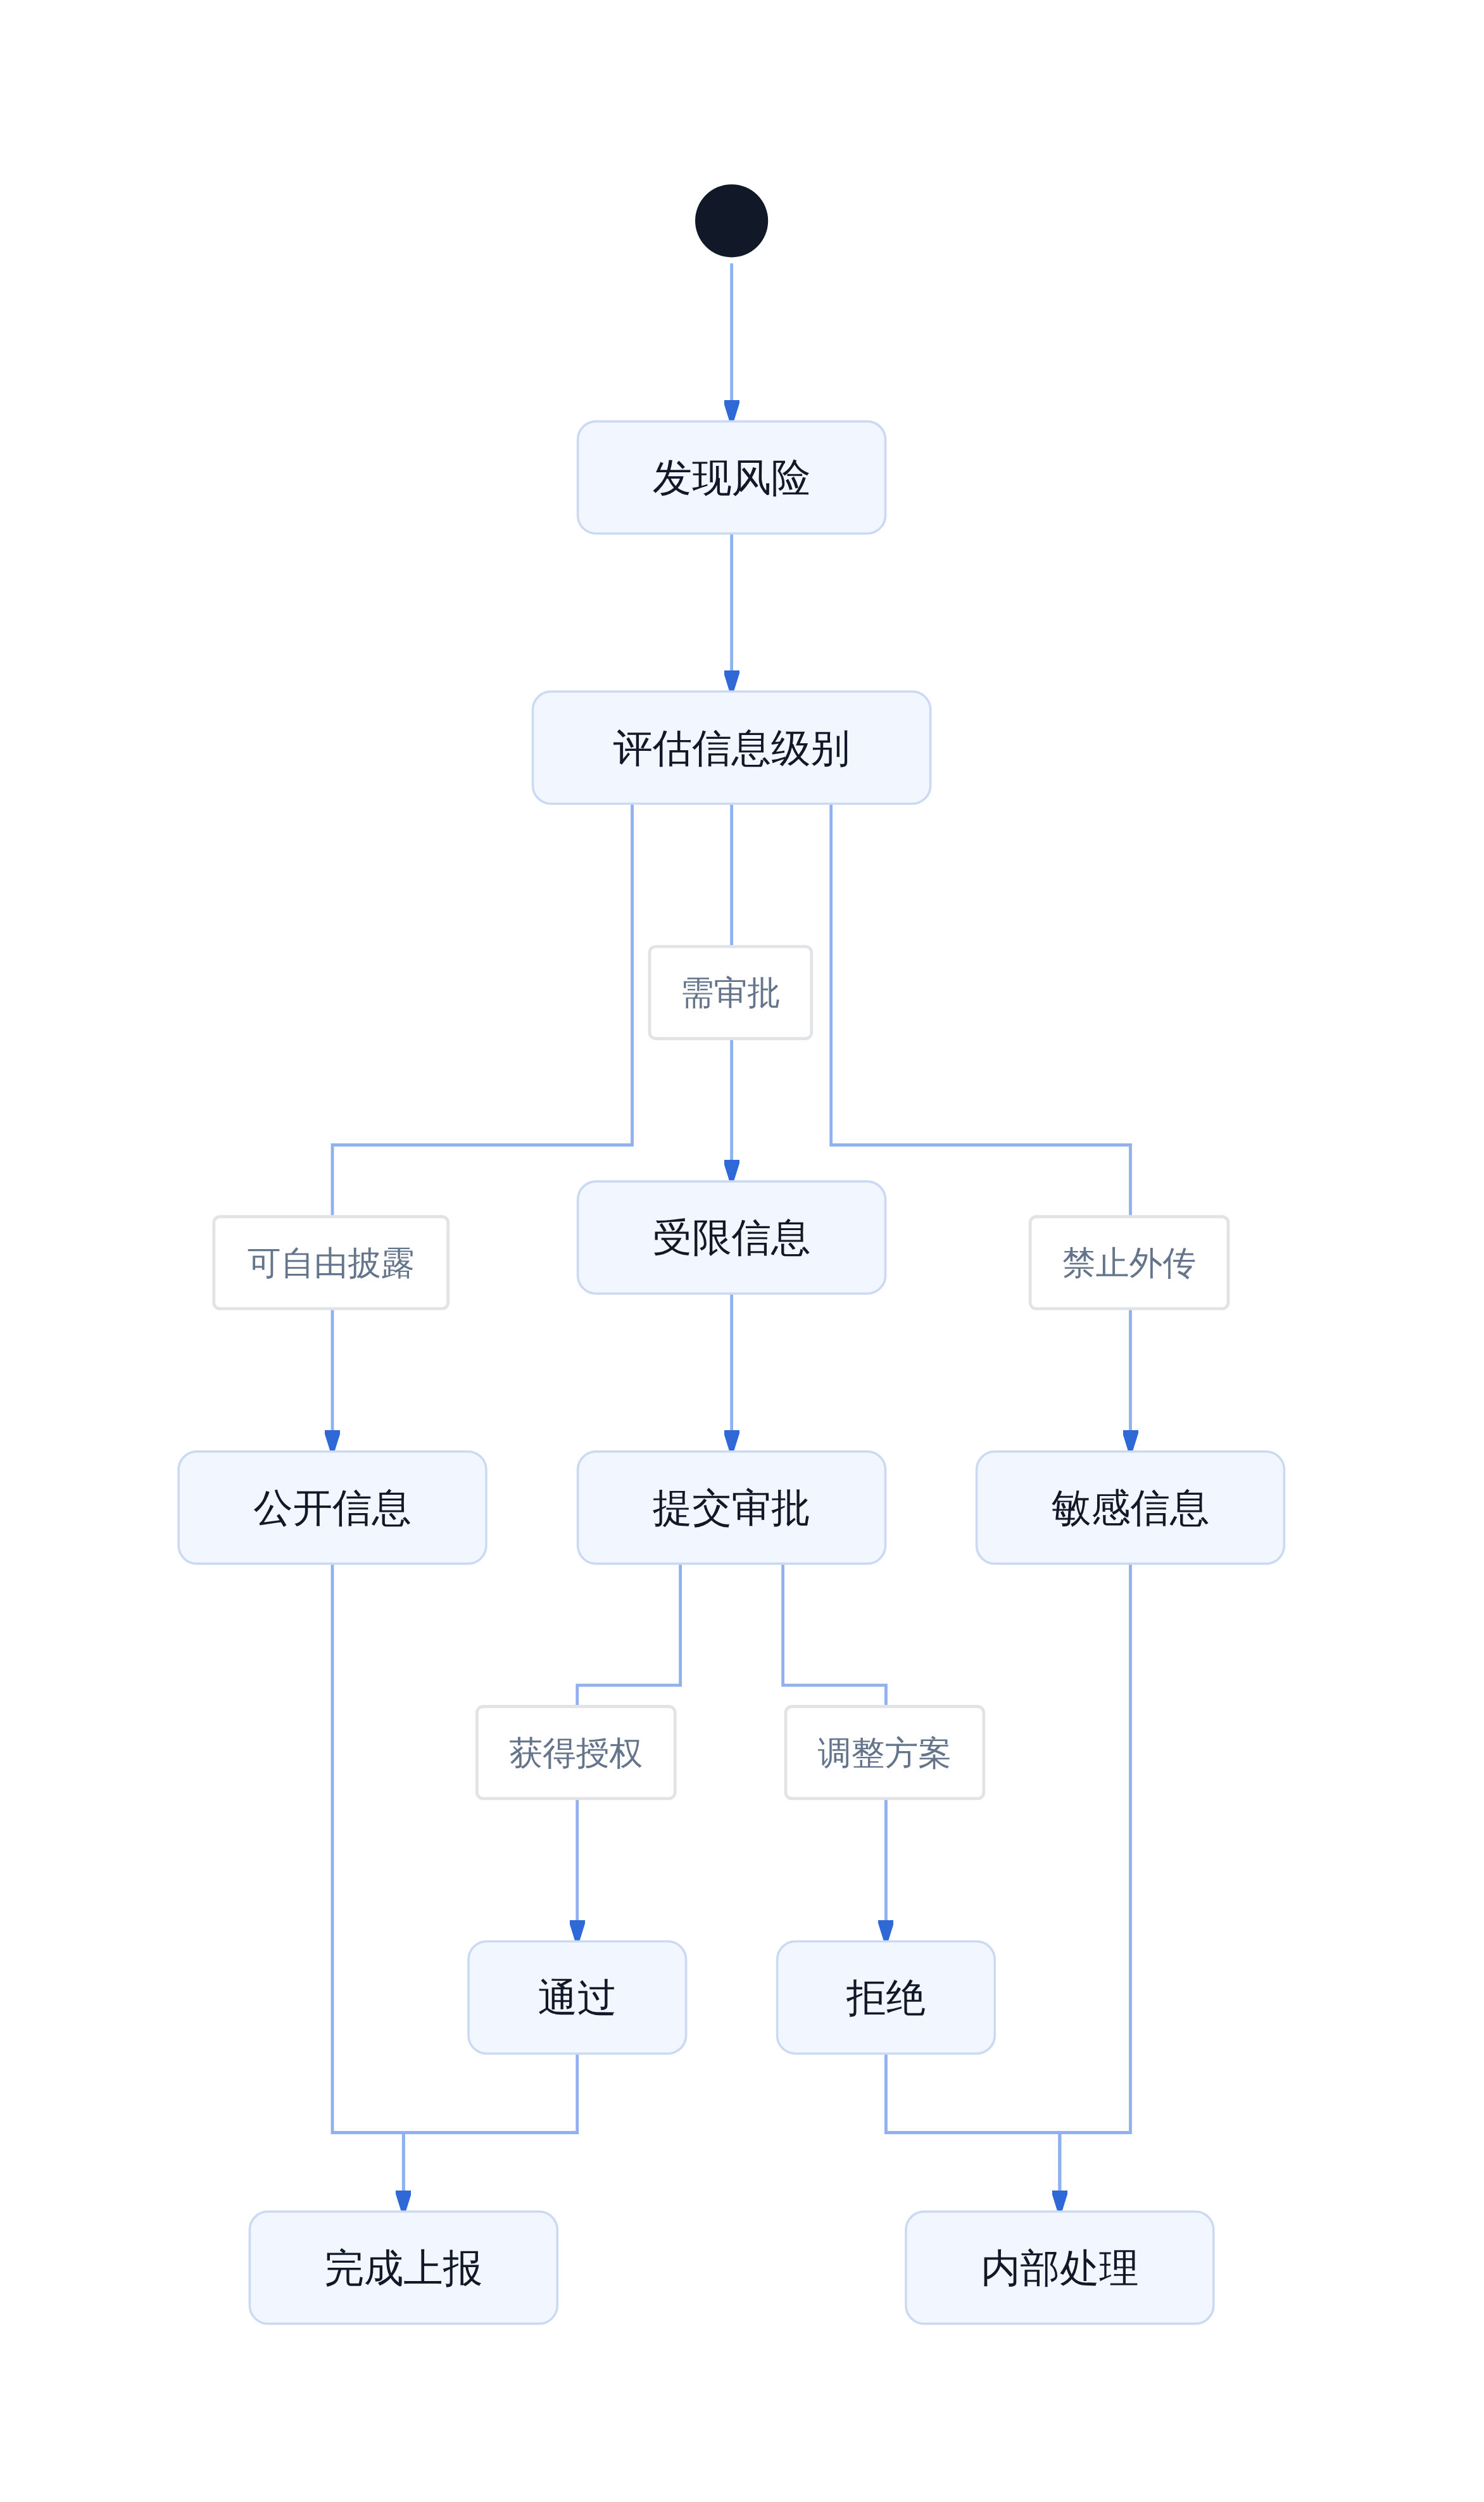
安全研究者的信息分级决策
第二,理解组织的实际底线。政策文件写的是一回事,实际操作是另一回事。在加入一个团队之前,了解其安全文化、信息流转机制,以及过去如何处理类似事件。
第三,不要独自承担风险。当发现重大安全漏洞时,尽量通过正式渠道上报,保留书面记录,必要时寻求法律咨询。个人对抗组织的代价往往不成比例。
行业趋势:第三方审计是否会成为标配
事件发生在 OpenAI 刚刚暂缓 Astra 模型发布的背景下。公司正在推动第三方安全评估机制,声明中提到「正在敲定与第三方安全评估机构的合同并将在数周内公布详情」。
这条路径有合理性。随着模型能力逼近某些理论上的风险阈值——比如自主代理系统可能绕过人类监督——内部评估的独立性受到质疑。一个由研发方自己控制的测试流程,很难让外界相信结论是可信的。
第三方审计的价值在于制衡。它提供外部视角,减少利益冲突,增强透明度。业界已有先例:Hugging Face 在 2026 年初遭遇供应链攻击后,OpenAI 邀请 METR 和 Redwood Research 进驻调查,就是一次成功的第三方审计实践。
但这一模式有几个前提条件。
第一,审计机构的独立性必须真实,而非象征性。审计方需要能够接触足够的内部信息,才能做出有实质意义的评估。
第二,信息共享的边界需要提前明确。第三方的审计权限、可披露的内容、数据安全要求,这些都应在合作开始前以书面协议确定,而不是在执行过程中临时争议。
第三,审计结果需要可验证。独立的审计报告本身也会被各方解读,如果缺乏原始数据的复核机制,审计结论同样可能成为新的争议源。
OpenAI 这次的危机,某种程度上是上述条件尚未建立时的一次碰撞。研究员与 METR 的沟通缺乏清晰的协议框架,导致双方对「正常工作」与「违规外泄」的认知出现巨大偏差。
这给出了一个清晰的行业信号:第三方审计正在从可选动作变为必选项,但配套规则还没有跟上。
对于从业者而言,有三件事可以今天就做。
如果你所在的公司正在与外部安全机构合作,要求书面明确信息边界和沟通流程。不要依赖口头约定或历史习惯。
如果你自己是安全研究员,了解清楚你所在的组织的合规红线在哪里。不清楚就问,留下书面记录。
如果你关注行业趋势,注意到一个信号:大型 AI 公司的安全团队越来越独立,但同时也越来越脆弱。外部审计机制在建立,内部制衡机制却没有同步强化。这意味着未来的安全争论不会减少,只会换一种形式。
OpenAI 这次的解雇决定,短期内可能强化了内部信息管控,但长期来看,如果行业普遍采取「先锁门再找人」的策略,AI 安全审计的有效性将大打折扣。当审计变成敏感信息违规的同义词,整个行业失去的不仅是几个研究员。
参考文献
- OpenAI Newsroom - Statement on recent personnel actions
- IT之家 - 3名遭解雇OpenAI研究员发公开信
- 华尔街日报 - 三名被解雇OpenAI研究人员呼吁保留AI可见度
- BBC - OpenAI scraps rollout of new AI model over safety concerns
- AIHOT - OpenAI 研究负责人发声明回应三名员工离职争议
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师