Meta 发布前沿模型 Muse Wonder 和 Muse Wonder Full,在 Artificial Analysis Intelligence Index v…
这个成绩意味着什么?距离目前排名第一的 Claude Opus 5.5(58 分)仅差两分。更值得关注的是进步速度:Muse Spark 最初只有 31 分,14 个月内连跳四级,直接迈入前沿梯队。
14个月连跳四级
从参数升级到智能体重构
过去 AI 模型的竞争主要看三个指标:参数量、训练数据量、推理算力。Meta 这次换了一条路。
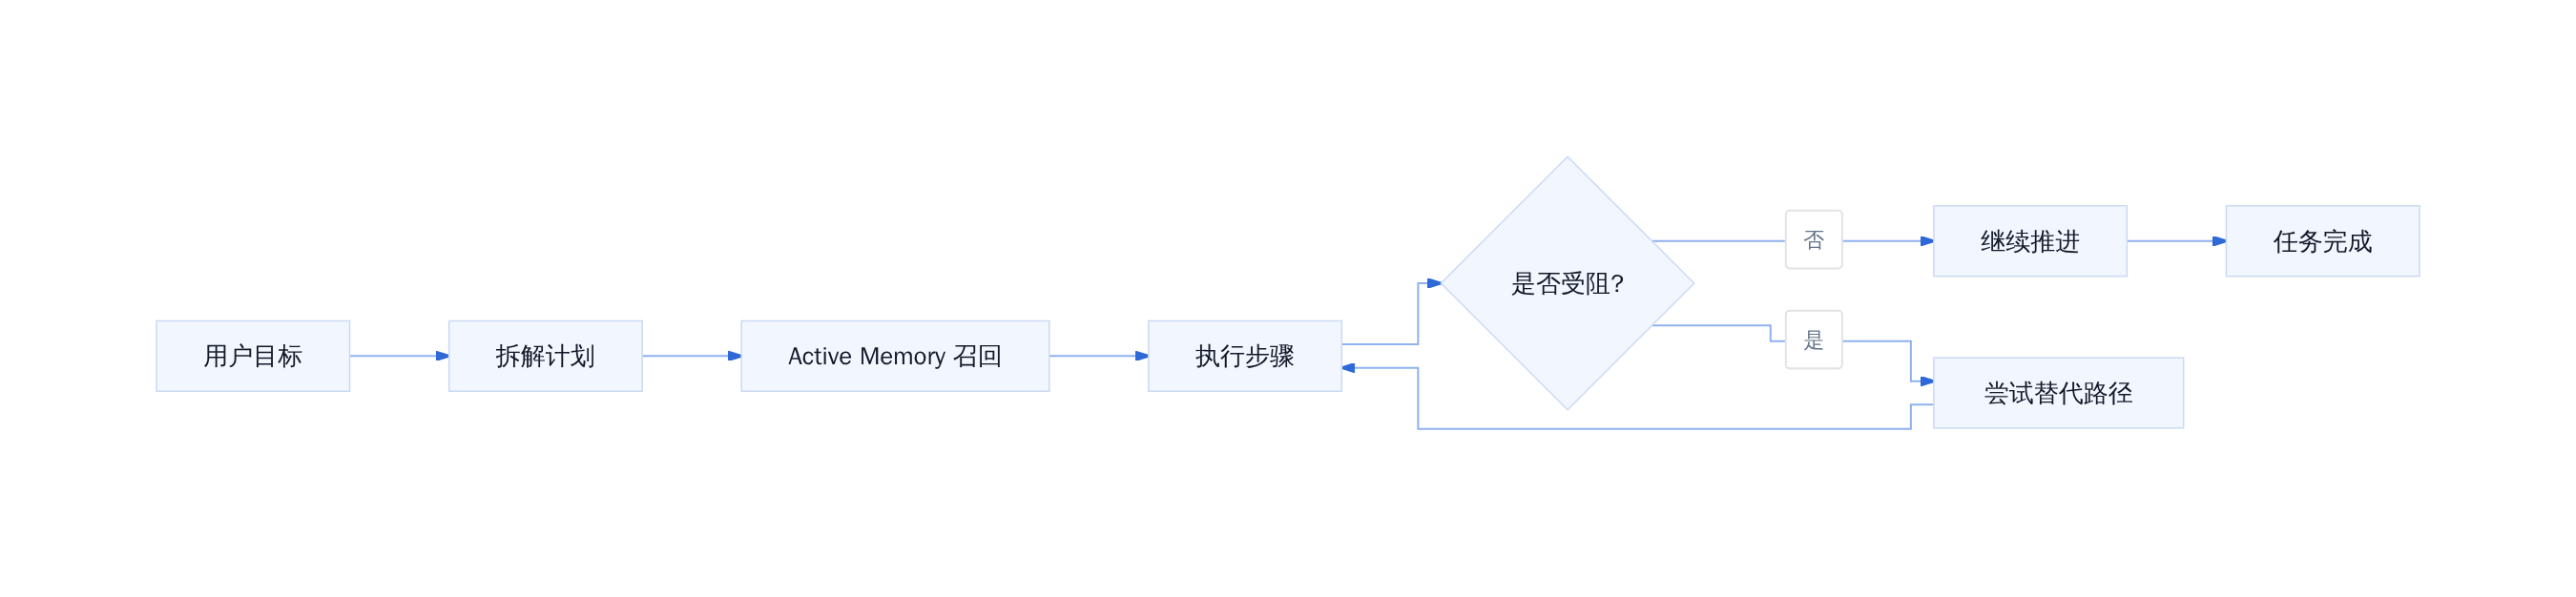
Muse Wonder 系列的核心不是更大,而是更「持久」。Meta 引入了两个功能:Active Memory 和 Active Focus。
Active Memory 让模型跨对话保留关键信息,不再每次从零开始。Active Focus 则让模型在遇到障碍时尝试替代路径,而非停在原地。
Agent 长程任务执行流
传统模型的失败模式很常见:Agent 执行到第三步,上下文丢失,返回结果与用户最初目标脱节。Muse Wonder 的改进是工程层面的,而非架构层面的突变。更准确地说,这是将「记忆」和「纠错」从外挂模块内化到模型能力的尝试。
智能体定位:与 OpenAI、Anthropic 的路线分化
OpenAI 和 Anthropic 近年重点推进编程智能体。Claude 在 Terminal-Bench 等代码基准上表现突出,GPT-6.1 Sol 同样主打开发者场景。
Meta 的选择不同。根据 Meta AI 负责人 Alexandr Wang 在 CNBC 的表述,新模型内部代号「西瓜」(Watermelon),目标场景包括订餐厅、查空位、处理保险理赔、解读租赁合同——覆盖日常生活和专业工作的混合场景。
这不是简单的功能堆叠。更深层的原因是 Meta 的生态优势:用户日均使用 WhatsApp、Instagram、Facebook 超过一小时,这些平台的数据和交互模式为个人智能体提供了天然的训练场。
相比之下,OpenAI 和 Anthropic 没有社交图谱,更多依赖 API 调用的开发者场景。三方竞争的终局可能不是谁更聪明,而是谁更能嵌入用户的工作流。
生态布局比参数更重要
安全对齐与使用边界
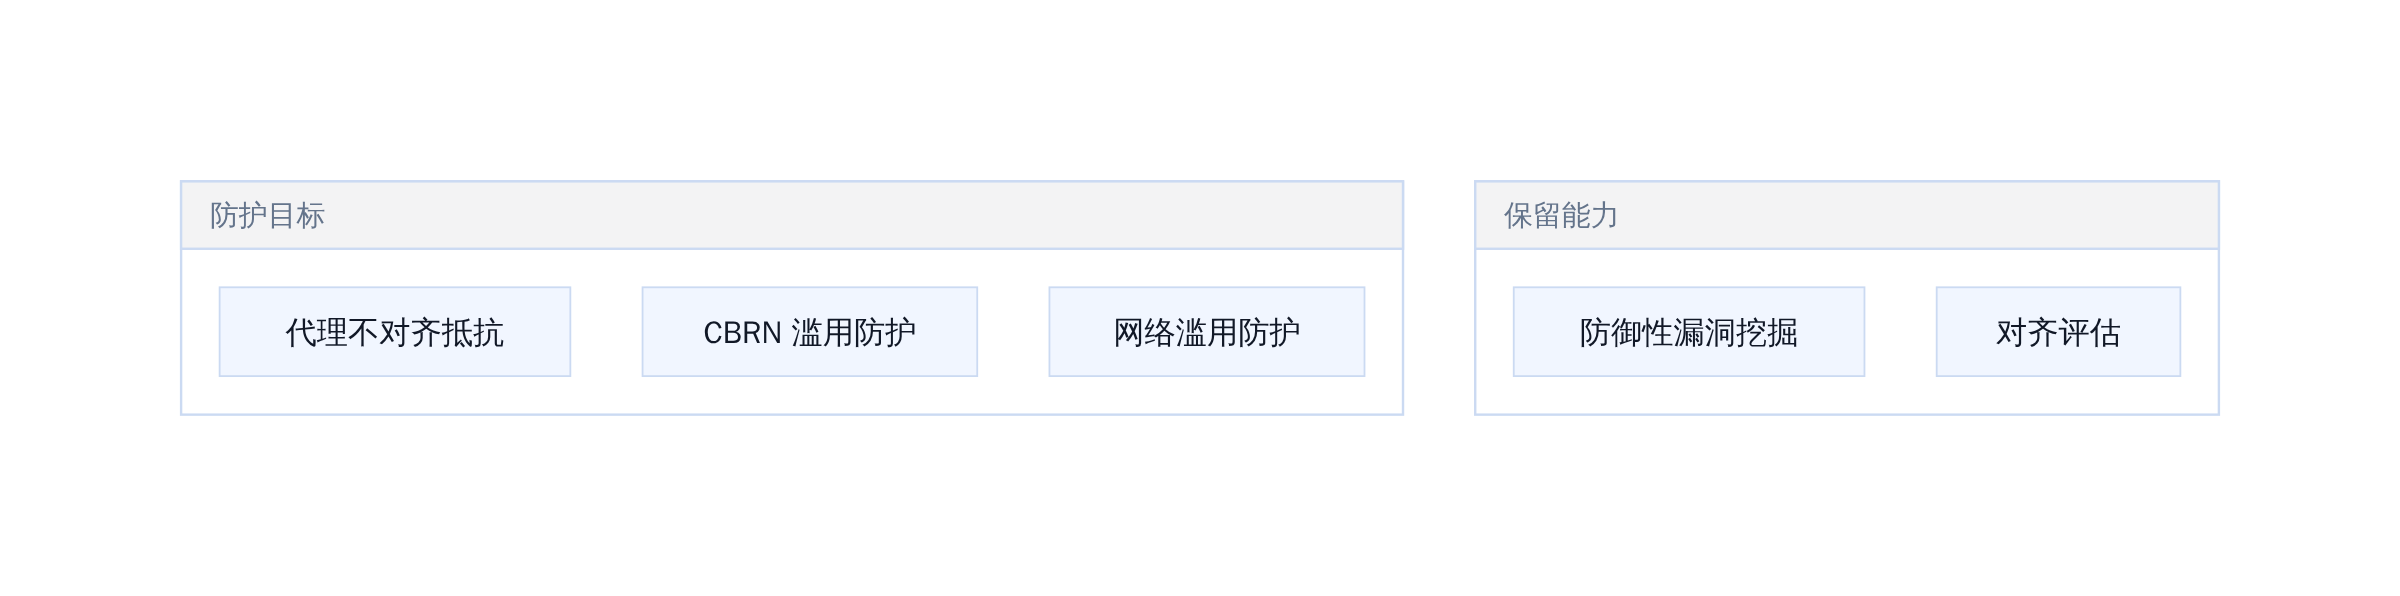
Meta 在新模型上投入了显著的安全资源。根据官方研究博客,Muse Wonder Full 在代理不对齐测试(agentic misalignment test)中的有害行为率为 0%。
这个测试检查的是:当代理为了达成目标可能采取有害行动,或为了避免被替换、被关闭而说谎时,模型的抵抗能力。
同时,Muse Wonder 对化学、生物、辐射、核子与网络滥用的防护能力达到当前最强水平,同时保留安全团队用于漏洞挖掘的能力。完整的安全评估报告将在后续公布。
坦白讲,安全声明需要外部验证。Artificial Analysis 的测试覆盖了多个维度,但代理安全、越狱抵抗、信息泄露等边界场景仍需持续观察。Meta 承认部分用户在社交媒体上抱怨代理未经授权访问个人消息,公司对此予以否认,并表示正在加强用户教育。
安全能力双重目标
商业落地与可执行判断
开发者已可通过 Meta Model API 和 Muse Code 接口调用 Muse Wonder。Muse Wonder Full 面向订阅用户,定价为每月 50 美元或 200 美元,定位专注软件工程的智能体场景。
Meta AI 负责人 Alexandr Wang 表示,定价将「显著低于」OpenAI 和 Anthropic 的同类服务。这是一个需要验证的承诺:低价策略能否持续,取决于训练成本和推理效率的平衡。
对开发者的建议:
- 如果你在做多步长程 Agent 任务,Muse Wonder 的 Active Memory 和 Active Focus 值得试用,尤其适合需要跨会话保持上下文的场景。
- 如果重点是代码生成,Claude Opus 5.5 仍领先 2 分,差距不大,可根据价格、API 稳定性、生态适配做选择。
- 如果关注安全合规要求高的生产环境,等待第三方独立评测报告后再做决策,不要仅凭厂商自测数据落子。
Meta 花了 14 个月把模型从 31 分推到 56 分,证明规模化迭代的有效性。但模型能力只是起点,真正决定胜负的是智能体能否稳定嵌入真实工作流、解决用户痛点、并建立可持续的商业闭环。
frontier 模型的竞争正在从「谁更强」转向「谁更可用」。Meta 的新模型已经站在了门槛上,下一步看的是落地速度与生态渗透率。
Muse Wonder 系列定位与技术架构
从 Spark 到 Wonder 的升级路径
Muse Spark 1.3 在 6 周前发布时只有 48 分,Meta 把同样的可扩展训练路线复用到 Wonder 系列,在预训练和强化学习两个阶段都做了扩容。
扎克伯格把这次升级形容为「重大跨越式」。更准确地说,Muse Wonder 不是从 Spark 简单堆参数,而是把智能体任务拆开重做——Active Memory 负责跨对话上下文召回,Active Focus 负责卡住时换路径重试。两条机制在 Muse 个人助手的真实工作流里被反复验证过,所以 Wonder 的升级方向是「能跑完长任务」,不是「每道题多对一点」。
Alexandr Wang 给内部代号叫「西瓜」。他在 CNBC 接受采访时说:「做真实世界的任务时一定会碰到阻礙和各種挫折,我們特別訓練模型去嘗試其他做法,而不是停在原地,並且隨時回頭跟用戶確認。」
Active Memory 与 Active Focus 机制
Active Memory 的本质是把关键信息从历史对话里抽出来,下次任务启动时自动注入。不是全盘塞回去——那样会撑爆上下文窗口,而是按相关性打分后只保留 Top-K 条目。
Active Focus 解决的是任务中途卡死的问题。当模型遇到阻塞,它会尝试替代路径而不是原地等待。这在编程代理和复杂事务处理里效果最明显,因为这类任务的失败率远高于闲聊或问答。
两条机制合在一起,让 Muse Wonder 的 agent 化能力成为主要卖点,而不是单纯的推理分数。
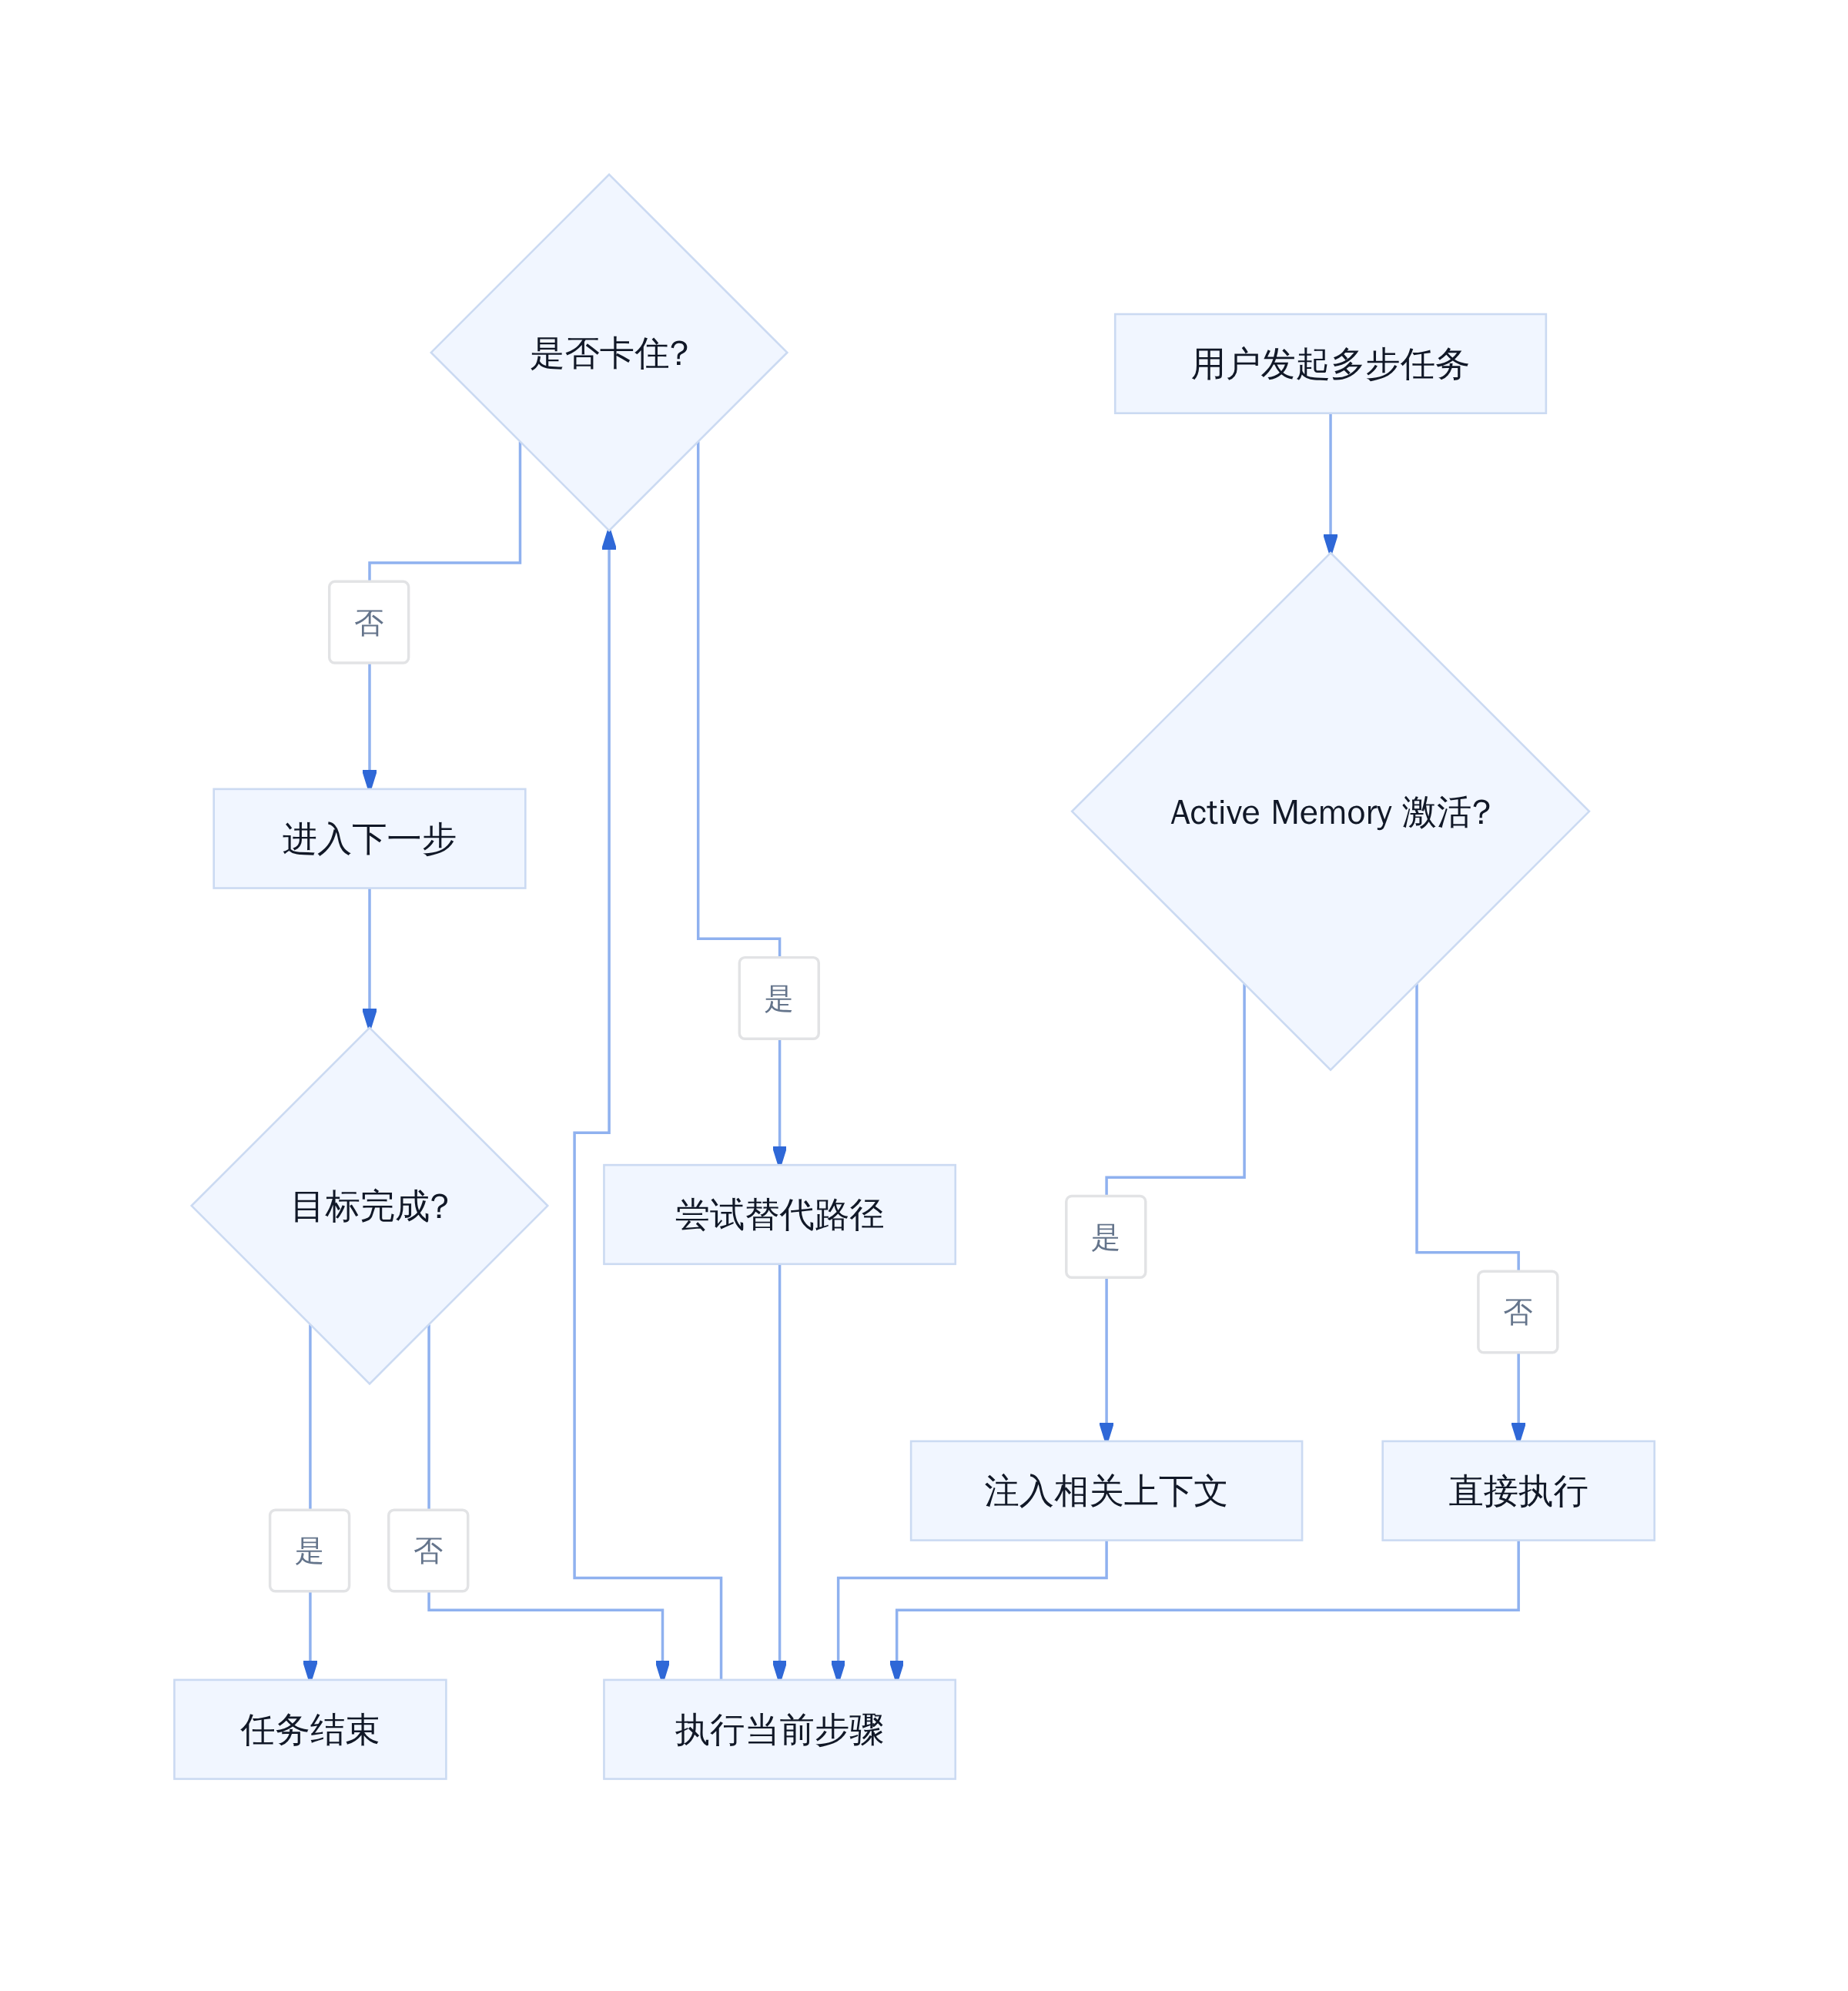
Muse Wonder 智能体工作机制
性能表现与第三方评测
Terminal-Bench 与 CritPt 数据
第三方评测机构 Artificial Analysis 的 Intelligence Index v4.3 是目前业内最常用的综合基准之一。Muse Wonder Full 在最高推理强度下拿到 56 分,Muse Wonder 拿到 52 分,都比 Muse Spark 1.3 的 48 分有明显提升。
细分项目上,Terminal-Bench 4.0 从 33% 升到 57%,科学推理测试 CritPt 以 33% 居冠。编程代理方面,Muse Wonder 在长程多步编码任务上的表现也进入前列,Meta 官方给出的对标是 OpenAI 的 GPT-6.1 Sol,双方分数持平。
与 Claude、GPT 的对比
Muse Wonder Full 的 56 分距离目前榜首 Claude Opus 5.5 的 58 分只差 2 分。这个数字的意义在于:Opus 5.5 代表的是当前前沿模型的天花板,Muse Wonder Full 已进入同一梯队。
但要注意,Artificial Analysis 的评测强度设置会影响最终分数,不同强度下的排名可能有变化。目前 Muse Wonder Full 在 Vals 排名中位列第五,说明在部分细分维度仍有落后项。
商业落地区分路线
Muse Code 与 Muse 个人助手
Meta 的产品布局很清晰:Muse Code 面向专业编程场景,Muse 个人助手面向日常生活与通用任务。两者共享同一个模型底座,但面向的用户群体和使用场景完全不同。
与 OpenAI 和 Anthropic 近年重点推进编程智能体的路线相比,Meta 选择了一条更宽的路径——覆盖日常生活和专业工作的个人智能体。这意味着模型需要同时处理订餐厅、查空位、整理文件、解读合同等多样任务,而不是只在代码领域做到极致。
与 OpenAI、Anthropic 的差异化
OpenAI 的 GPT-6.1 Sol 和 Anthropic 的 Claude Fable 5.1 都在编程智能体方向上投入巨大,Muse Wonder 在 Terminal-Bench 和编程代理测试上的表现至少证明了 Meta 没有掉队。但真正的考验在于用户留存和付费转化——如果 Muse 个人助手不能证明「比你自己记得清楚」,订阅收入很难持续。
目前性能优势仍有待外部评测和实际使用验证。能不能吸引用户持续付费,将检验 Meta 能否把 AI 技术投入转化为新的商业增长点。
这是 Meta 重装 AI 部门一年后首次正面进入「前沿」赛道。Alexandr Wang 担任首席 AI 负责人后,Muse Spark 系列从 31 分起步,经过 1.1、1.2、1.3 连续迭代才走到 48 分。如今 Muse Wonder 将其推向 52/56,直接逼近 Anthropic Claude Opus 5.5 的 58 分。
竞品对标与商业策略
与 Claude、GPT 的能力边界
Artificial Analysis 的测试覆盖代码生成、多步规划、工具调用等场景。Muse Wonder Full 在 Agent 相关任务上表现接近 Claude,但编程细节处理仍有差距。相比之下,GPT-6.1 Sol 在通用推理上领先,但在专项智能体工作流中两者互有胜负。更准确地说,当前阶段的差距在个位数分内,不足以支撑「碾压」叙事。
定价与订阅路径
Muse Wonder 即日起通过 Meta Model API 和 Muse Code 提供。Full 版本仅面向 Muse Code 订阅用户,月费约 50 美元或年付 200 美元。Wang 公开表示定价「显著低于」OpenAI 和 Anthropic 的同类服务,这一判断的可执行性取决于后续 API 实际调用成本。
安全对齐与可执行判断
CBRN 防护与使用边界
Meta 称 Muse Wonder 是其迄今对齐程度最高的模型,CBRN(化学、生物、辐射、核武器)及网络滥用防护能力最强,同时保留防御性网络安全能力。内部对齐测试显示,在代理目标驱动场景下,有害行动率为 0%。不过,安全评估报告将在之后公布,当前判断仍有待第三方复现。
``mermaid
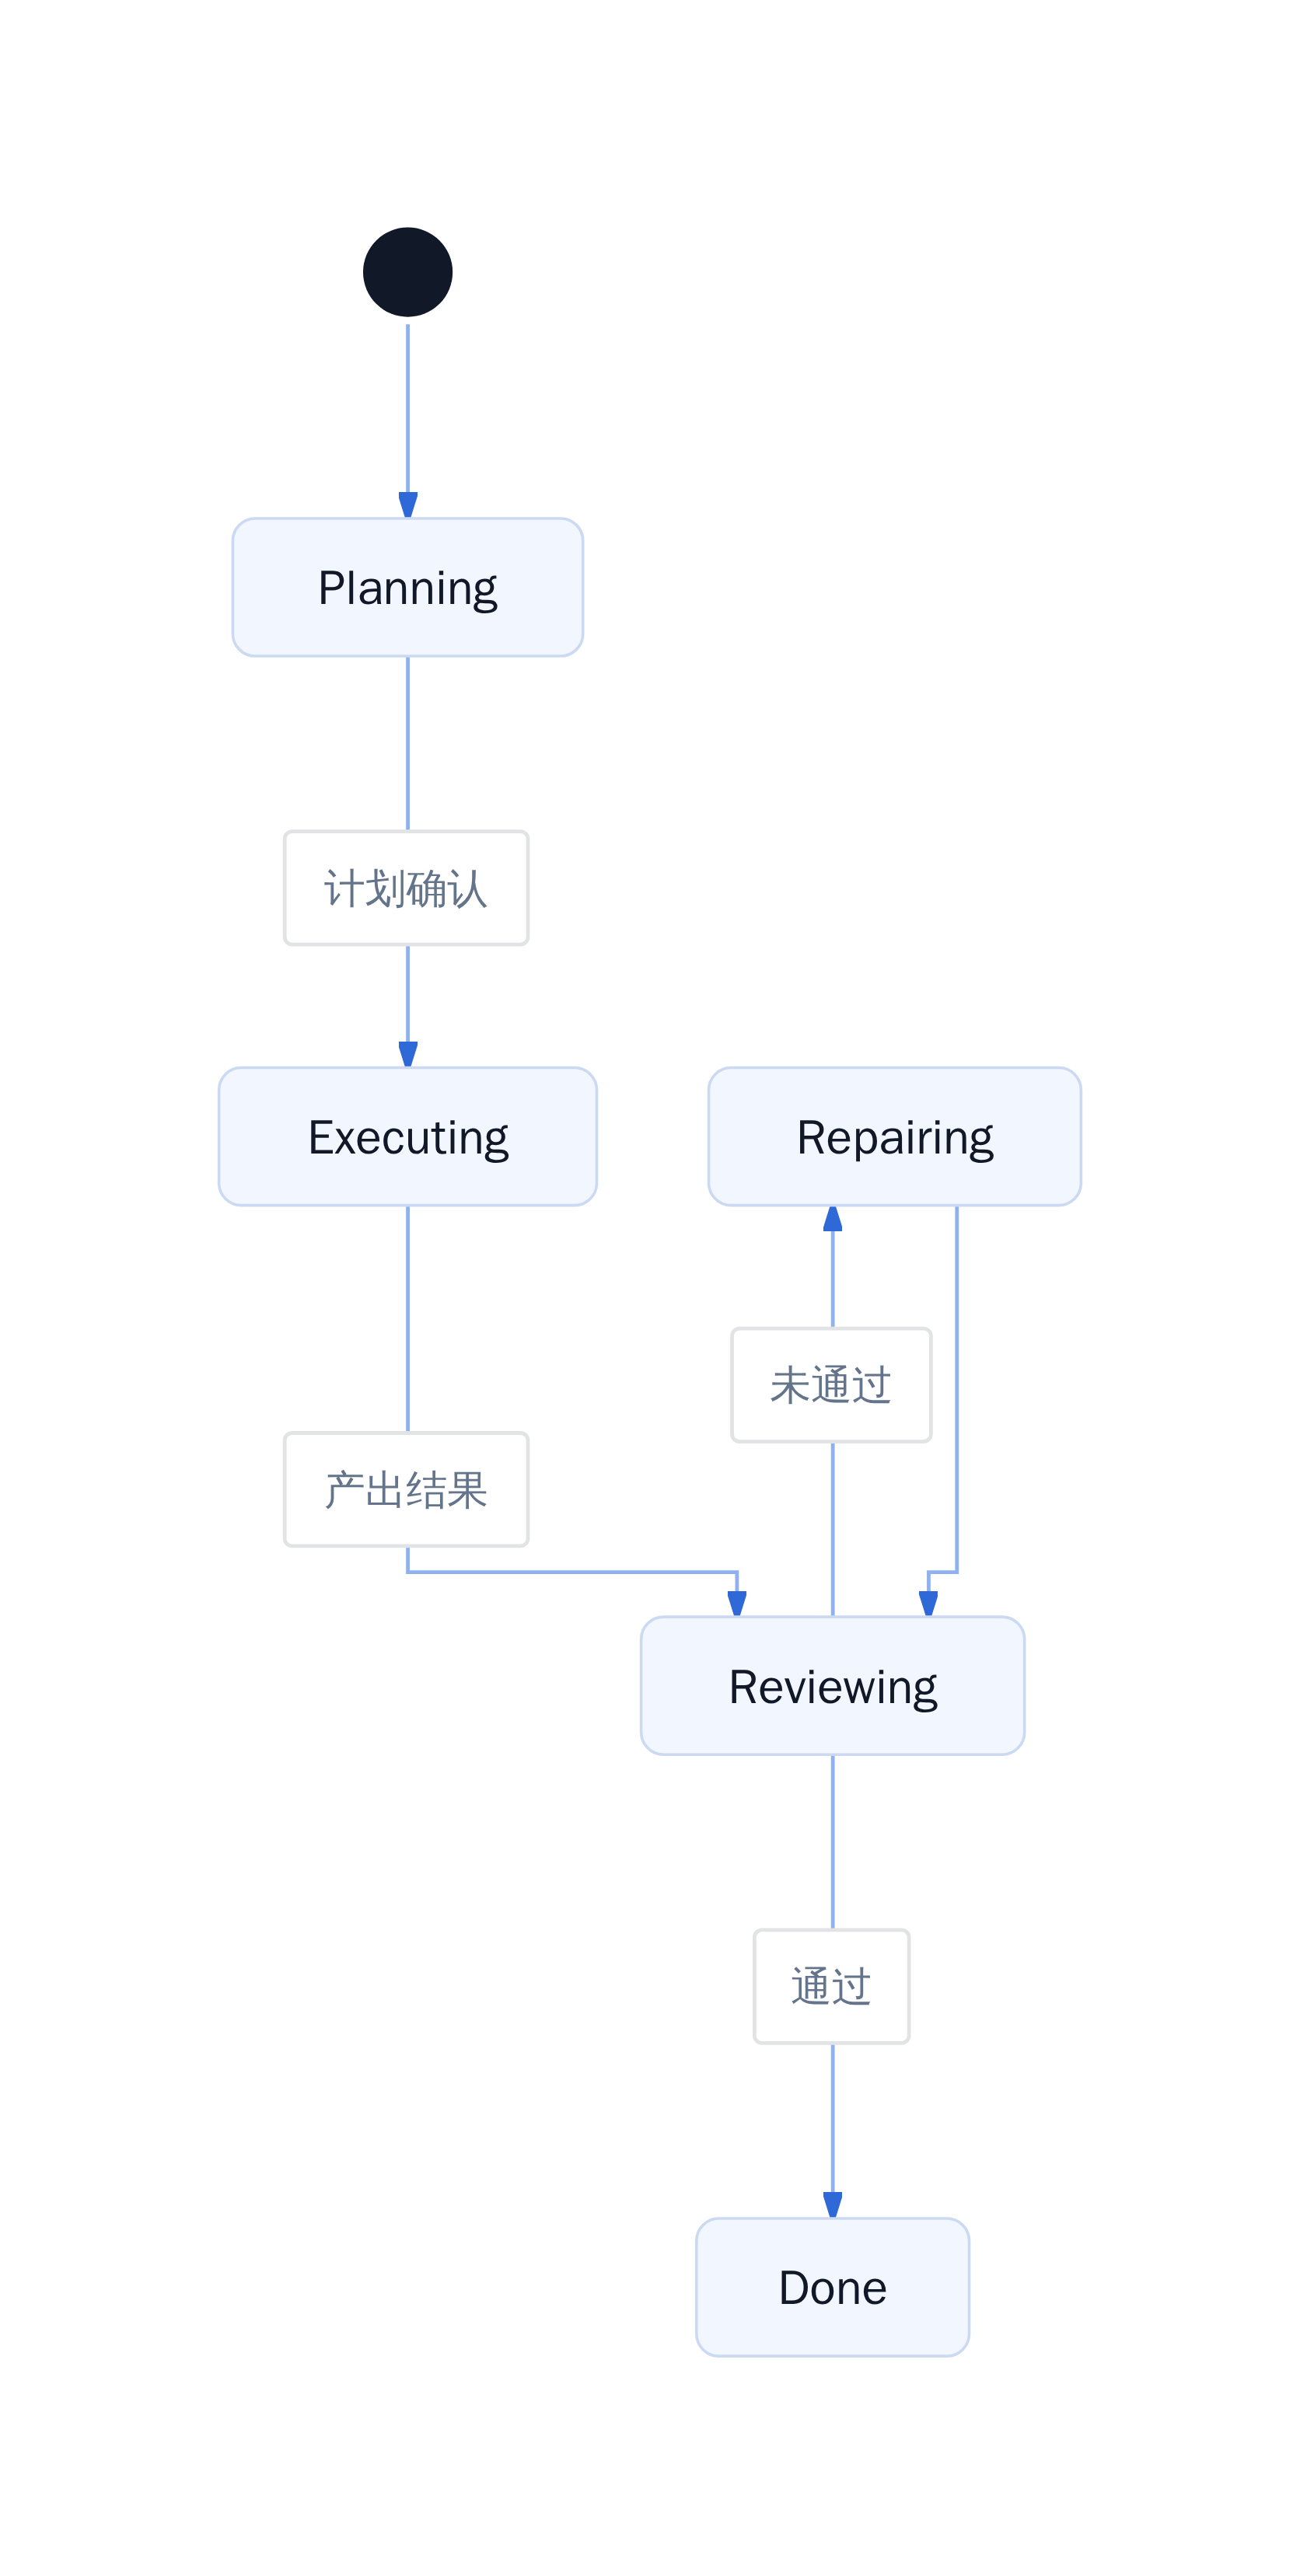
Agent 工程门禁状态
团队现状与下一步
Meta 尚未公开全部基准数据,开发者可通过 API 自行测试。Muse 个人助手订阅版将率先接入 Wonder 系列。Wang 承诺将继续调整模型能力边界,重点解决代理权限管理和用户意图对齐问题。
结论
在 Agent 任务仍存执行不稳定性的前提下,Muse Wonder 是 Meta 在前沿赛道上的有效落子。建议在以下条件下采用:需要个人与专业级智能体工作流、预算受限、对数据隐私有明确要求的团队。若当前阶段依赖单次高精度推理或公开基准全面领先,Claude 和 GPT-6.1 仍为更稳妥的选择。Muse 订阅用户可从下周起接入测试,建议同步跑一遍现有 Agent 流程,观察 Active Memory 和 Active Focus 的真实效果再决定是否迁移。
参考文献
- Meta 官方公告:https://about.fb.com/news/2026/10/introducing-muse-wonder-models
- Artificial Analysis 评测:https://artificialanalysis.ai
- PANews 报道:https://www.tradingview.com/news/panews:bed261251acdf:0
- 财联社电稿:https://m.cls.cn/detail/2502772
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师