这条发布于 2026 年 10 月 12 日的动态,把 Meta 的新模型直接放进了以真实用户任务为数据集的竞技场。消息本身不复杂,但背后有几个值得拆解的点:评测场变了、Muse 的应用增速超预期、以及 Meta 这次把两条产品线绑在一起推。
开篇:Arena 宣布 Muse Wonder 上线
Arena.ai 团队在动态里写得很直接:Muse Wonder 已经在 Arena 里,用户可以去 Agent Arena 测。没有附加说明,也没有预热,就是上线了。这种低调处理方式,反而说明 Meta 对这次发布的底气——不需要营销包装,分数自己说话。
Muse 应用此前在 9 月 8 日上线,22 天内达到 500 万下载,比 ChatGPT、Grok、Claude 同期增速都快。Sensor Tower 的数据佐证了这一点。[5]
Agent Arena 的评测逻辑
Agent Arena 的评测逻辑和普通 benchmark 不同。它不依赖人工标注的静态题库,而是收集全球用户的真实长周期任务,让多个模型同时执行同一任务,再由用户投票决定哪边的结果更好。

Agent 在跑任务,用户在投票
这种机制的优势在于:评测结果反映的是实际可用性,而不是刷榜能力。一个模型如果在 Codeforces 上拿满分,但在文件系统操作、多轮工具调用里频繁出错,Arena 的长周期任务会暴露这些问题。相反,有些模型静态分数不高,但在真实场景下更稳,排名会反过来。
Agent Arena 的官方博客提到,平台让用户体验不同 LLM 提供商、框架和工具组合的效果,从而做出更明智的技术选型决策。[11]
##AgentArena的评测逻
Muse Wonder 的已知指标与边界
Meta 官方发布的 Muse Wonder 评测数据中,有几个数字值得注意。在 DeepSWE 1.1 和 SWE-Marathon 两个长周期编码任务上,Muse Wonder Full 分别领先。SWE-Marathon 上 Muse Wonder Full 拿到 57.5%,对比 Claude Opus 5.5 的 46.3%。[2]

编码任务评测现场
不过这里有一个重要边界:Meta 自己也标注,SWE-Marathon 的对比「不是受控比较」。Codex 和 Claude Code 生成的 leaderboard 分数来自 GPT-6 Astra 和 Claude Fable 5.1,而 Meta 模型在该测试中用的是「xhigh」推理设置。变量没对齐,分差不能直接等同于能力差距。
ProgramBench 这道题——要求 Agent 从零重建一个完整程序——Claude Opus 5.5 以 70.5% 对 59% 领先。[2]
这说明什么?Muse Wonder 在特定长周期任务上有优势,但在从零构建复杂系统的任务上,Opus 5.5 仍然领先约 11 个百分点。两者的能力剖面不同,不是简单的谁强谁弱。
Meta 这次还强调了两个新功能:Active Memory(主动记忆)和 Active Focus(主动聚焦)。前者让 Agent 在长任务中保持上下文,后者让 Agent 在遇到困难时尝试不同路径而非直接放弃,并在执行重要操作前向用户确认。[7][17]
##MuseWonder的已知指
订阅策略与市场竞争
Muse 应用的商业模式是免费的日常使用,加上 $20/月 和 $100/月 两个订阅档位。Muse Wonder 通过 Meta Model API 和 Muse Code 可用,Muse Wonder Full 仅限 Muse Code 订阅用户。[7][8]
$20 和 $100 两档订阅
这本质上是一场付费意愿测试。Zuckerberg 在 X 上发文称,Muse Wonder 把 Meta 带入了「frontier」行列。[3] CNBC 的报道指出,Meta 正在寻找广告之外的 AI 新收入来源。[14]
但市场竞争并不轻松。谷歌在 2026 年 10 月初传出要退出顶尖模型竞争的消息,但同时又出现了挂着「gemini-3.8-flash」名字、被猜测为未发布 Gemini 4 Pro 的模型出现在 Arena 里。[12] 谷歌的策略是全栈打法:模型、Agent、云、芯片都要自己做。
Meta 的策略是另一条路:先把 Muse 应用做成现象级增长,再用 Wonder 系列模型提升 Agent 能力上限,最终靠订阅变现。
##订阅策略与市场竞争Muse应
落点判断
Muse Wonder 上线 Agent Arena,短期影响有限——分数还没公布,用户只能先体验,后才知道排名。但这是一个明确的信号:Meta 不再满足于在 benchmark 上追赶,而是把战场移到了真实任务评测场。
有两个判断:
第一,Muse Wonder 在长周期编码和 Agent 任务上可能具备竞争力,但不要过度解读现有分数。SWE-Marathon 的对比条件不对齐,ProgramBench 的落后也说明它在某些场景下仍有短板。等 Arena 分数公布后,再下结论更稳妥。
第二,Muse 的订阅模式是一场持久战。500 万下载只是入口,真正的考验是付费转化率。$20/月的档位面向普通用户,$100/月面向专业用户——这个分层是否成立,要看 Wonder 系列能否在真实任务里提供足够明显的体验差异。
可以马上做的事:去 Arena.ai 选几个你的日常任务,分别用 Muse Wonder 和其他模型跑一遍,看看结果差异。分数会告诉你更多。[1]
评测机制与已有成绩
在正式 Arena 分数公布前,Meta 披露了两项内部基准的对比数据。
SWE-Marathon 长周期编程任务中,Muse Wonder Full 给出 57.5%,同期 Claude Opus 5.5 为 46.3%。ProgramBench 全量代码重建任务中,Claude Opus 5.5 以 70.5% 领先,Muse Wonder Full 为 59%。
Meta 明确标注 SWE-Marathon 数据并非受控对比,两端的运行环境与工具调用链存在差异,因此该数字仅反映相对趋势,不能作为绝对优劣判断依据。
| 任务 | Muse Wonder Full | Claude Opus 5.5 |
|---|---|---|
| SWE-Marathon | 57.5% | 46.3% |
| ProgramBench | 59% | 70.5% |
数据来源:Meta 官方公告(2026-10-12)。
功能差异:Active Memory 与 Active Focus
Muse Wonder 系列针对长期 Agent 任务设计了两个新机制。
Active Memory 负责跨会话保留上下文,用户在一次对话中完成的认证、偏好设置与常用路径,下一轮可直接调用,避免重复解释。
Active Focus 处理任务中途偏离或失败的情况。当 Agent 检测到当前路径收敛性不足时,会主动切换策略、尝试不同方案,并在关键节点暂停向用户请求确认。
这两项能力的实际效果,取决于 Arena 社区提交的长周期任务分布。
Agent Arena 上的典型任务包括:自动比价下单、跨平台预约、批量文件整理与代码重构。这类任务平均耗时在数分钟至数十分钟之间,对模型的错误恢复与上下文保持提出更高要求。
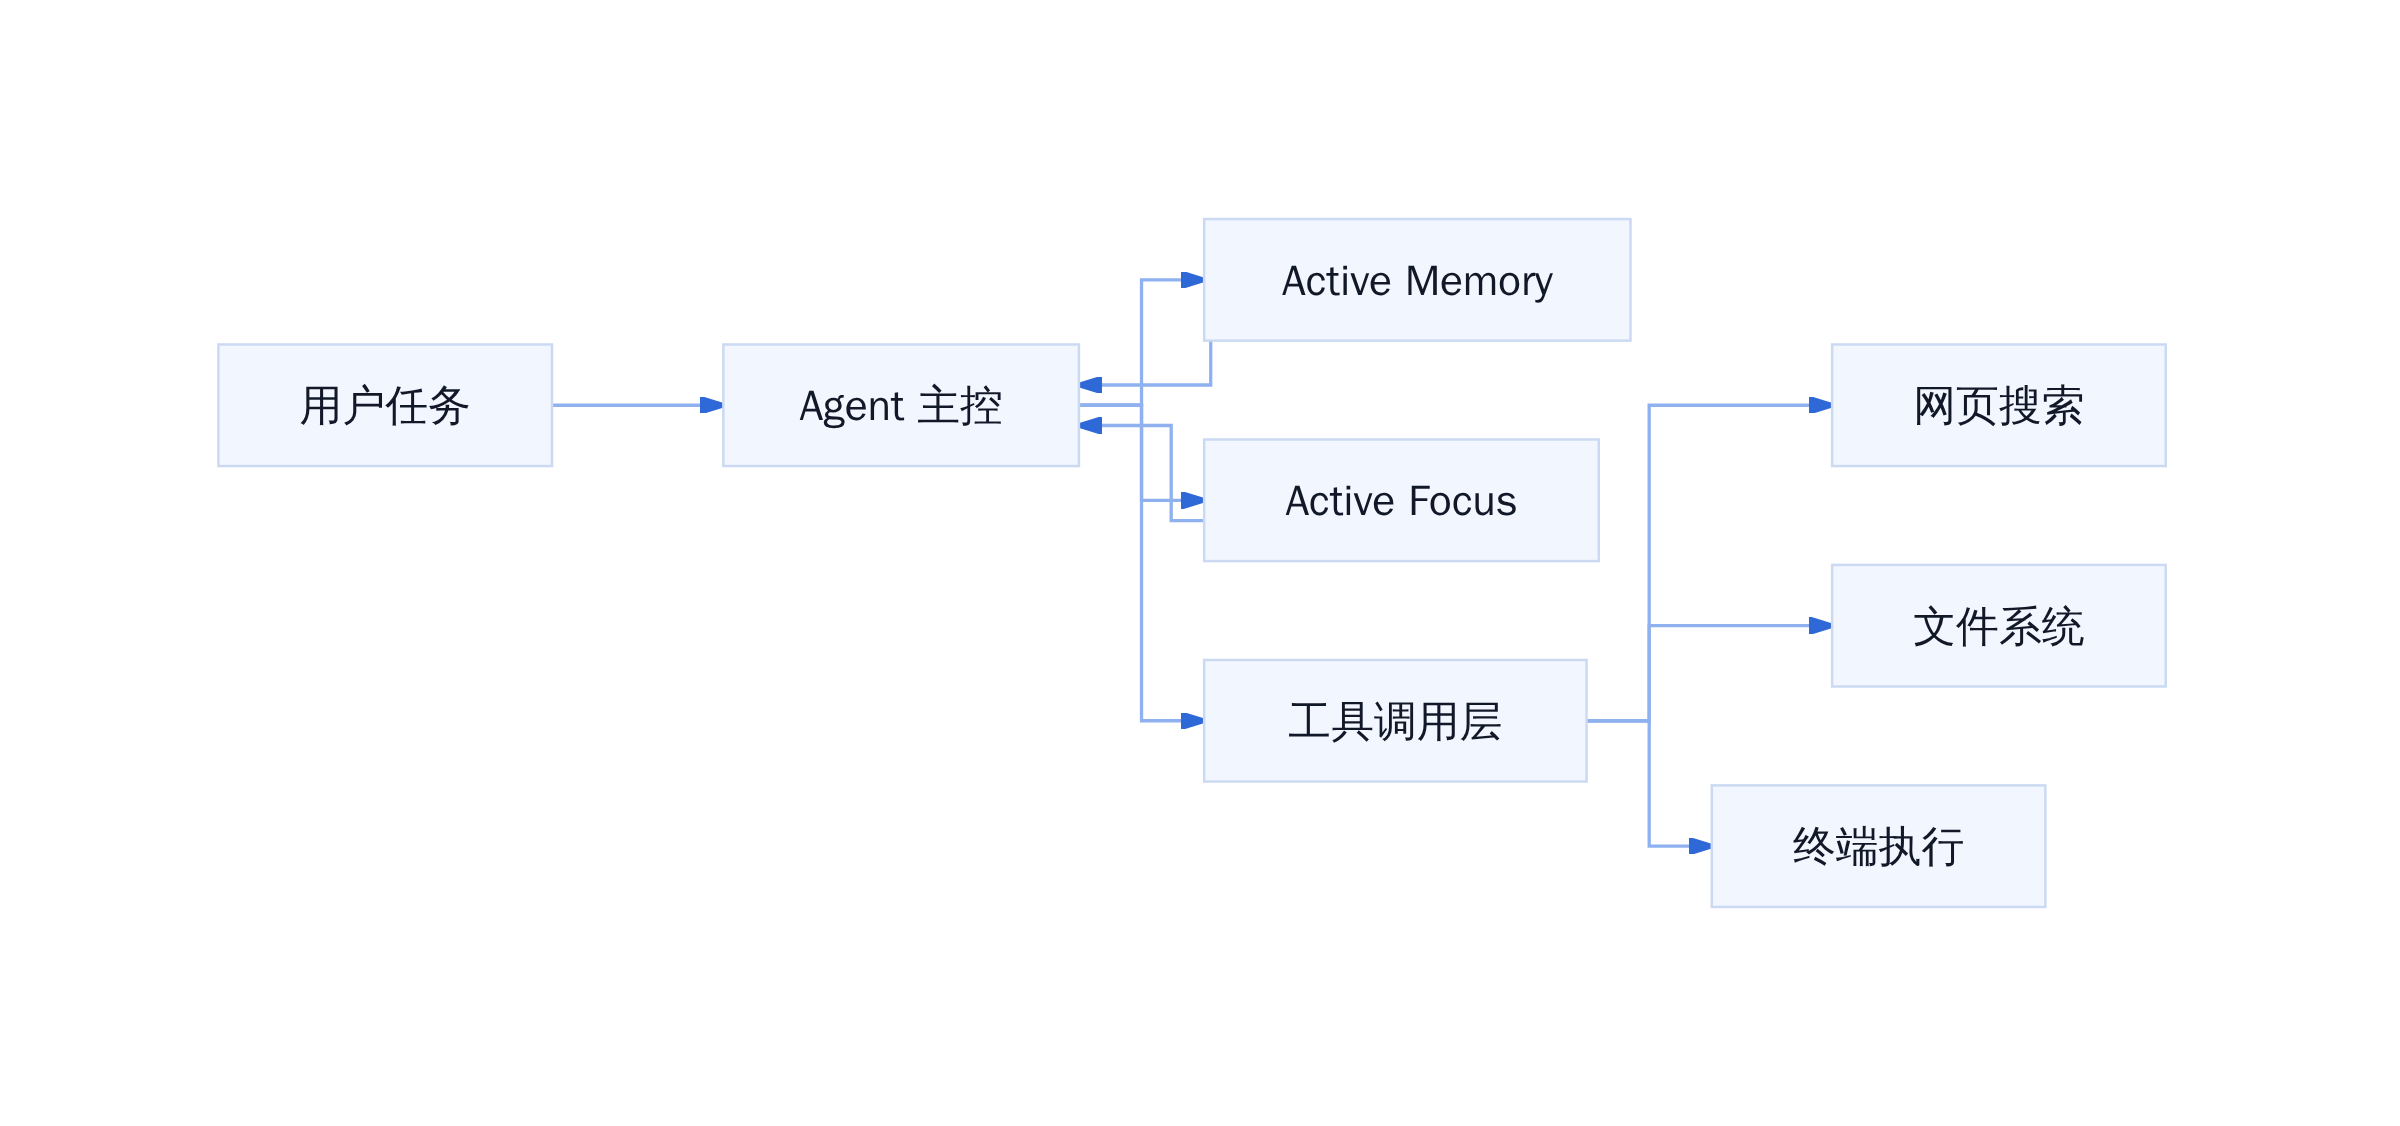
Muse Wonder 系列核心功能架构
订阅策略与产品绑定
Muse Wonder 系列的商业化路径与 Muse 个人助手深度绑定。
Muse 应用于 2026 年 9 月 8 日上线,22 天内下载量突破 500 万,Sensor Tower 数据显示增速超过 ChatGPT、Grok 与 Claude 同期表现。应用提供 $20 与 $100 两档月费,免费版功能受限。
Muse Wonder 通过 API 直接对外,Muse Wonder Full 仅面向 Muse Code 订阅用户。
这种分层设计将模型能力与付费墙直接挂钩,目的是在广告投放之外建立新的订阅收入来源。Meta 首席 AI 负责人 Alexandr Wang 公开表示,公司正寻找脱离广告业务的 AI 收入路径。
从竞争格局看,OpenAI 的 ChatGPT Advanced、Anthropic 的 Claude Pro 与 Google 的 Gemini Advanced 均采用类似订阅模式,但 Meta 的差异化在于把个人助手作为主入口,而非单纯卖模型调用次数。
结论与判断
Muse Wonder 系列的上线,标志着 Meta 从「训练开源模型」转向「打造端到端付费 Agent 生态」。
Agent Arena 的真实社区任务数据将在未来数周内逐步沉淀,届时才能判断 Active Memory 与 Active Focus 是否真正解决长任务失败率高的问题。
现阶段可执行的判断:
- 如果你需要跨天上下文保持与多步任务恢复能力,Muse Wonder Full 在 Muse Code 订阅路径上值得优先测试。
- 如果你关注纯粹 API 调用成本与并发能力,Muse Wonder 公开版更灵活,建议先跑一遍自己的真实任务样本再决定预算。
- SWE-Marathon 的 57.5% 不能直接等同于生产力提升,ProgramBench 的落后提醒我们,不同评测维度的模型表现存在分化,选择前需明确自身使用场景。
模型能力正在快速收敛,真正的差距将在用户日常任务的长期稳定性中显现,而不是榜单上的单次峰值。
Arena 的测试池又来新选手
本周 Arena.ai 在 X 上贴出公告:Muse Wonder 系列进入测试池,「scores coming soon」。公告没有附带具体数字,只留了一句「Head to Agent Arena to test it out」。这不是第一次 Meta 模型被挂进 Arena,但这一次的节奏明显不一样。
谁进了池子
进池的是两款模型:Muse Wonder 和 Muse Wonder Full。前者通过 Meta Model API 和 Muse Code 可用;后者绑定 Muse Code 订阅,非订阅用户打不开。两款的定位都属于 frontier,Meta 官方措辞是「our most capable models yet」。
Muse Spark 1.1 是这两款的前任。上周 Arena 发布战报,Muse Spark 1.1 以全榜 #5 进入视线,排名高于 Gemini 3.1 Pro 和 Qwen-3.7 Plus,低于 Grok 4.5 和 GLM 5.2。那是 Meta 第一次在 Agent Arena 上拿到这个位置。
分数如何生成
Agent Arena 的评分逻辑是众包对战:用户自选任务、模型、工具,跑完后投票或按任务成功率打分。模型可调用的能力包括 web search、filesystem、terminal。分数不是单轮对话出来的,是 millions of real-world, long-horizon agentic tasks 堆出来的。所以它衡量的是「能持续执行多长的任务」,而不是单次回答质量。
参考文献
[1] Arena.ai X 动态: https://x.com/arena/status/2109706854700044523 [2] SiliconANGLE 报道: https://siliconangle.com/2026/10/12/meta-releases-muse-wonder-ai-models-built-to-run-personal-and-professional-agents [3] Business Insider 报道: https://www.businessinsider.com/meta-launches-muse-wonder-series-to-rival-anthropic-openai-models-2026-10 [5] Quartz 报道: https://qz.com/meta-muse-wonder-ai-model-launch-101226 [7] Android Authority 报道: https://www.androidauthority.com/meta-muse-wonder-ai-models-3722247 [11] Agent Arena 官方博客: https://gorilla.cs.berkeley.edu/blogs/14_agent_arena.html [12] 投资界报道: https://news.pedaily.cn/202610/525432.shtml [14] CNBC 报道: https://www.cnbc.com/2026/10/12/meta-muse-wonder-ai-model-agent.html Muse Spark 1.1 刚在 Agent Arena 登到第5名,Meta 紧接着把 Muse Wonder 系列送进同一张榜单。
- Agent Arena 官方公告:https://x.com/arena/status/2109706854700044523
- Meta 官方公告:https://about.fb.com/news/2026/10/introducing-muse-wonder-models
- Meta Muse Wonder 研究博客:https://research.meta.ai/blog/muse-wonder
- SiliconANGLE 报道:https://siliconangle.com/2026/10/12/meta-releases-muse-wonder-ai-models-built-to-run-personal-and-professional-agents
- Business Insider 报道:https://www.businessinsider.com/meta-launches-muse-wonder-series-to-rival-anthropic-openai-models-2026-10
- CNBC 报道:https://www.cnbc.com/2026/10/12/meta-muse-wonder-ai-model-agent.html
- Agent Arena 代码编程排行榜:https://arena.ai/leaderboard/agent/code
- Agent Arena 论文:https://gorilla.cs.berkeley.edu/blogs/14_agent_arena.html
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师