你在 Claude Code 里开了个长会话,出去喝了杯咖啡,回来继续干活,结果第一个请求就因为缓存过期白白付了全量输入 token——这已经不是新鲜事了。
一、一次昂贵的缓存失效经历
1.1 为什么一小时后重新打开要重付钱
Claude Code 对对话历史实行 1 小时的缓存 TTL。缓存命中时,你只需要为新增内容付费;缓存未命中时,整个历史对话会被重新输入,token 费用随之翻倍。
问题在于,这个过期是硬性的,不因你是「只是在发呆」还是「已经放弃了」而有区别。一个积累了 15 万 token 的会话,在缓存失效后第一次请求,就要为这 15 万 token 的全量输入付费一次。等你继续对话,历史还在,缓存重新计时,直到下一个小时再次清零。
这相当于一小时内,你的对话历史被反复计入成本,但实际内容没有变化。
1.2 idle compaction 解决的到底是什么问题
idle compaction 的核心逻辑是:在缓存即将到期前(约 54 分钟空闲后),系统主动触发一次压缩,将历史摘要化,同时刷新缓存计时。
压缩不是为了省 token,是为了让长时间运行的 Agent 在缓存失效后还能无缝续上,而不是让用户为历史的重量买单。
一套好系统不应该靠用户自觉 /compact,而是应该在缓存快过期前自己先把事情做了。
##一、一次昂贵的缓存失效经历#
二、压缩管线的三层架构
Claude Code 的上下文管理是一套分层设计,idle compaction 只是最外层的一环。
2.1 阈值压缩:API 层面的自动守门员
threshold compaction(阈值压缩)是 API 层的兜底机制。开发者在请求中设置 token 阈值,一旦上下文接近上限,API 自动在请求过程中对较早的历史进行摘要。它的特点是无需应用层介入,适合大多数常规场景。
根据源码计算,Claude Sonnet 4(200K 上下文窗口)的有效阈值约为 167,000 token,其中预留了 20,000 token 给摘要输出,另留 13,000 token 作为安全缓冲。
2.2 按需压缩:控制权交回应用
on-demand compaction(按需压缩)把时机完全交给应用。开发者显式发送一个带有 compaction 参数的请求,Claude 返回摘要块,之后每个请求需附带该摘要块并移除已被压缩的消息。
这种模式适用于需要精确控制压缩时机、或者必须在摘要后保留最近若干轮次(keep-tail compaction)的场景。例如,一个需要维持思考链连续的 Agent,可以在压缩后逐字保留最近两三个交互轮次。
2.3 空闲压缩:Anthropic 补上的最后一环
idle compaction 是 Claude Code TUI 层的实现,针对的是普通用户的日常使用模式。它不需要开发者配置,也不需要调用 API 参数,本质上是对阈值压缩的一种「自动触发器」封装。
当会话空闲约 54 分钟且上下文超过 200K,系统自动执行压缩,刷新缓存 TTL。这与阈值压缩的区别在于:阈值压缩是在 token 接近上限时触发,而 idle compaction 是在时间维度上触发,两者互补。
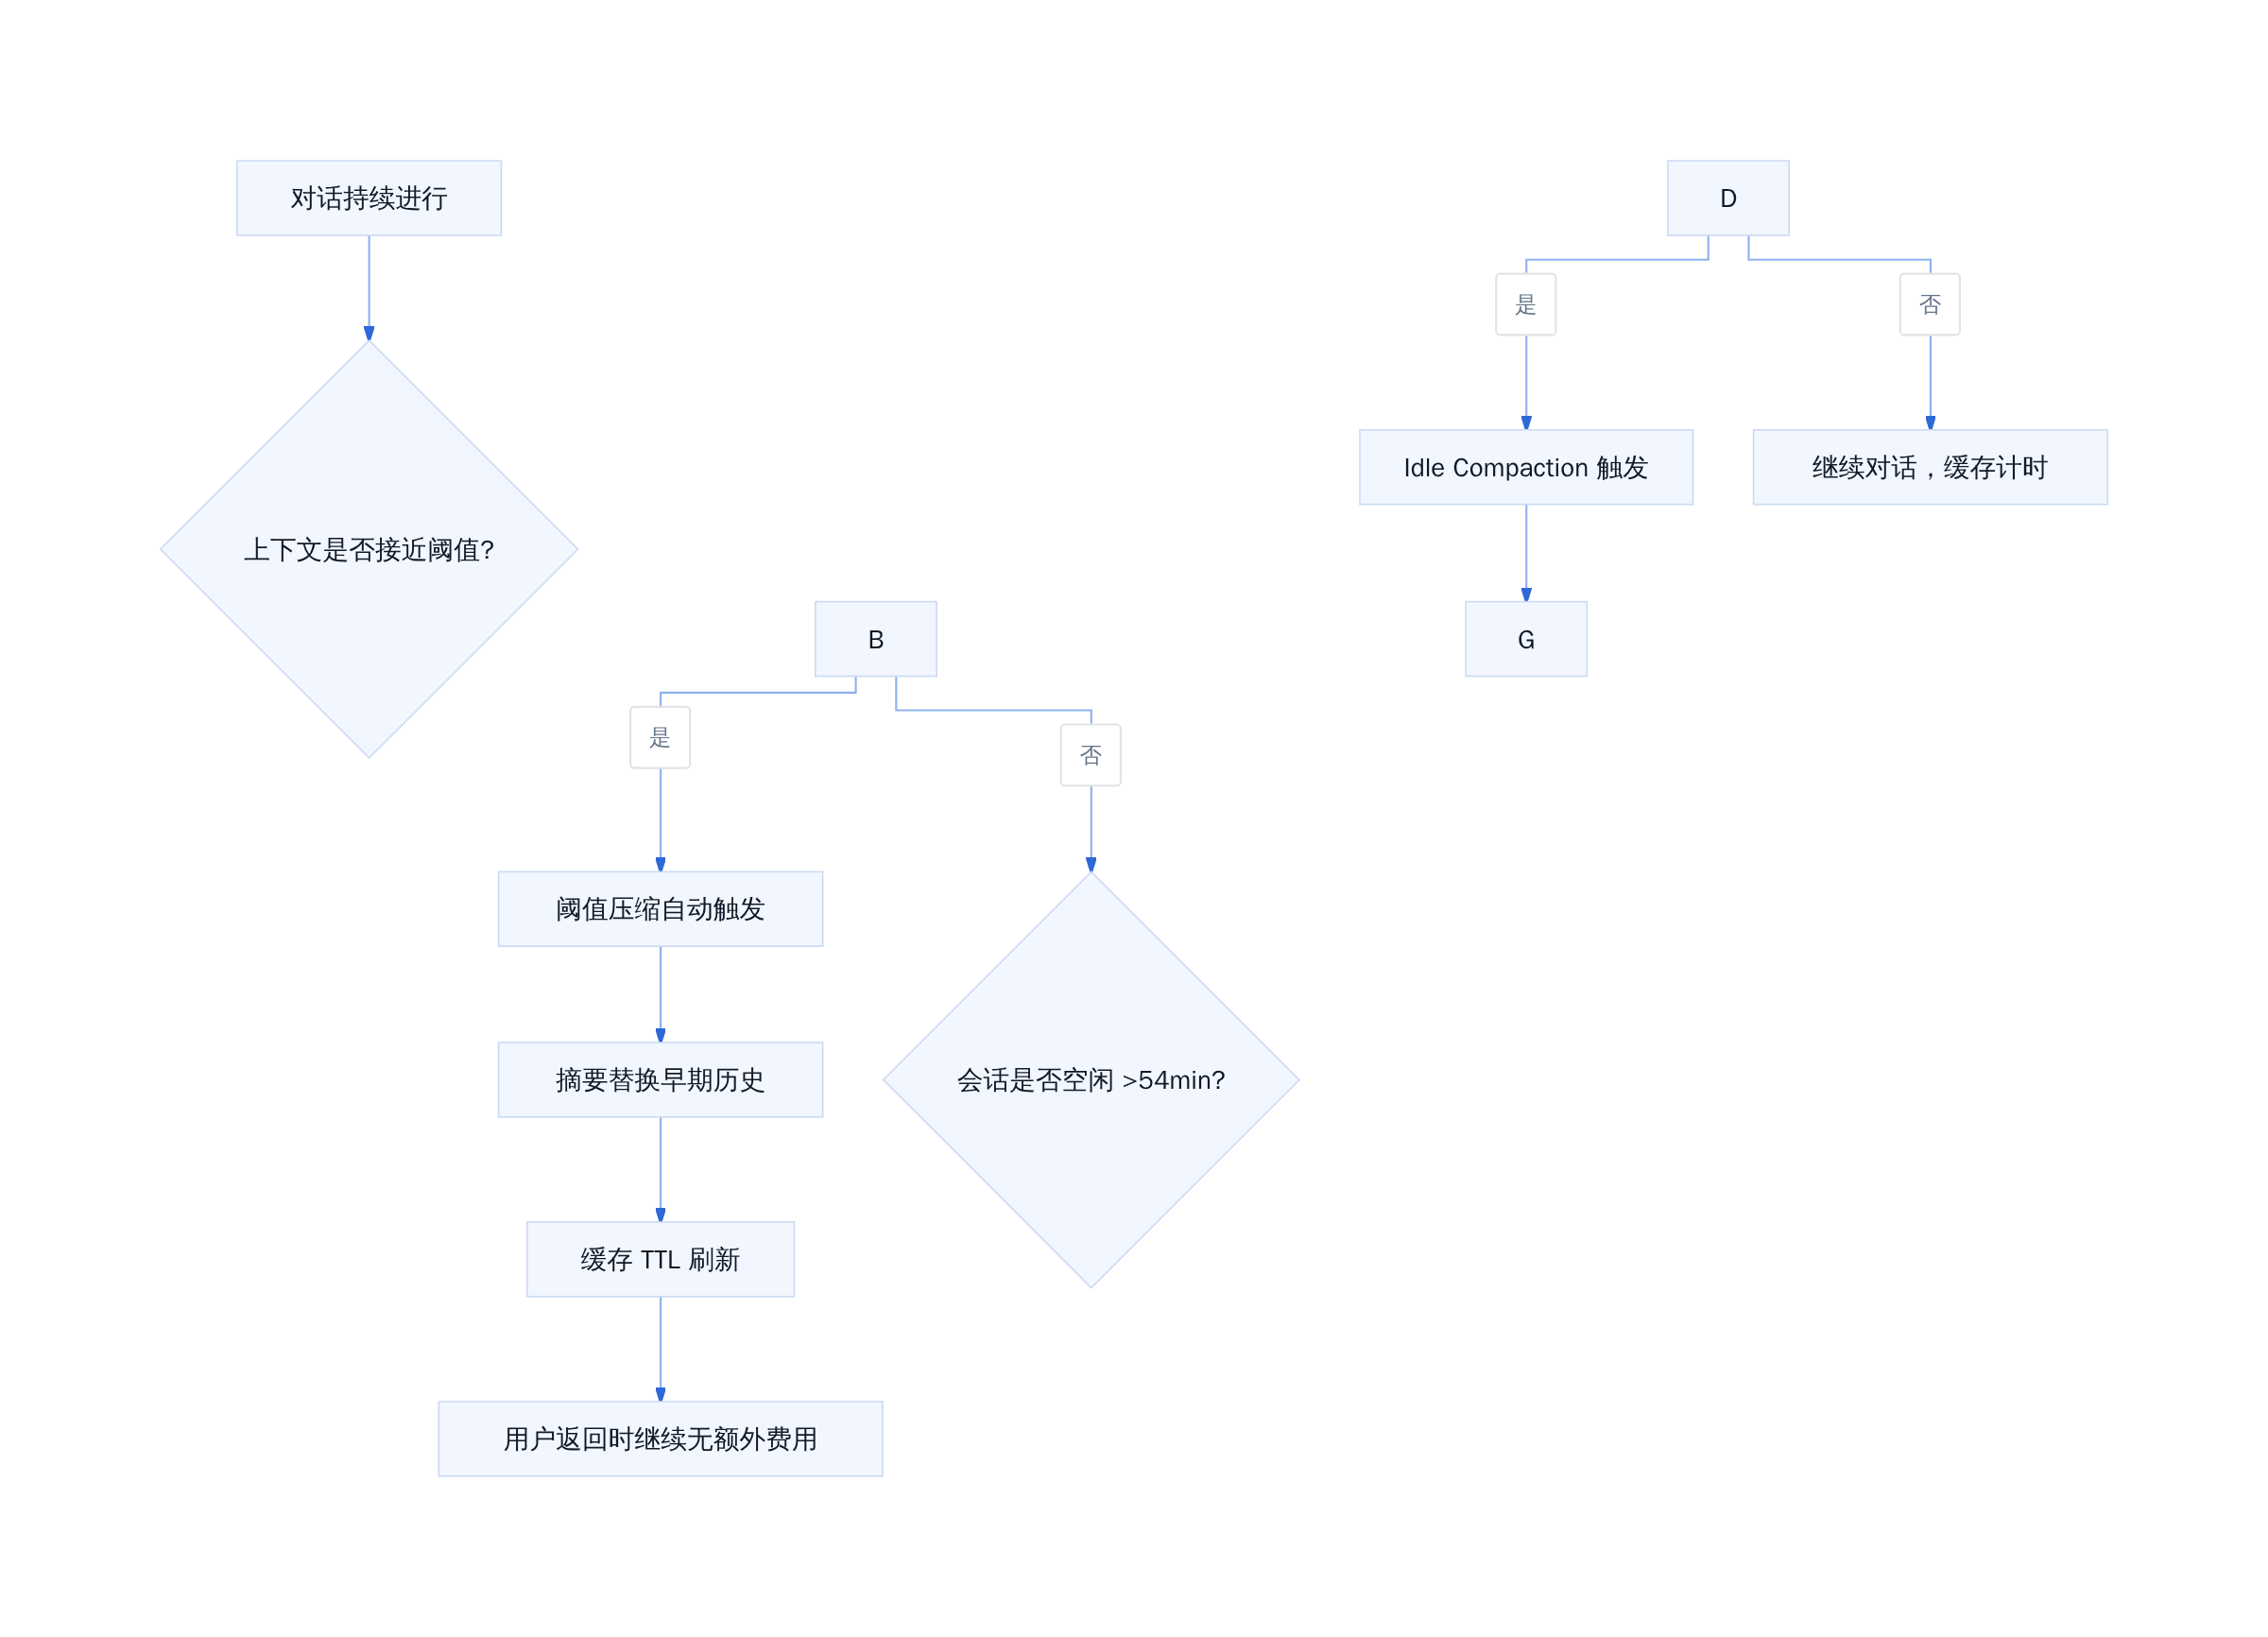
Claude Code 上下文压缩三层管线
三、压缩到底在压什么
3.1 摘要生成的工程取舍
压缩的本质是让模型把「可恢复工作所需的信息」抽象成结构化摘要,用摘要替换冗长的对话历史。这带来一个权衡:摘要会丢失细节,但保留了继续任务所需的关键状态。
每次压缩后,系统会自动注入一条系统提示:「请从我们中断的地方继续对话,不要询问用户任何进一步的问题。继续执行要求您执行的上一个任务。」这条提示确保了压缩后的 Agent 不会因为历史缺失而中断工作流。
需要留意的是,压缩并非万能。当连续压缩失败次数达到阈值(源码中为 3 次),系统会启用断路器,跳过后续自动压缩尝试,避免无意义的 API 调用消耗。
3.2 保留尾部与思考链延续
对于具备保留思考功能的模型(如 Claude 3.5 Sonnet),压缩后继续对话时,摘要之后轮次中的思考块可以保持有效。这意味着长时间运行的 Agent 在压缩后仍能维持其推理链,而不会回到「失忆」状态。
不过,保留尾部压缩需要开发者在按需压缩模式下手动指定切分点,且切分点必须放在没有未完成工具调用的位置,否则会导致请求格式错误。
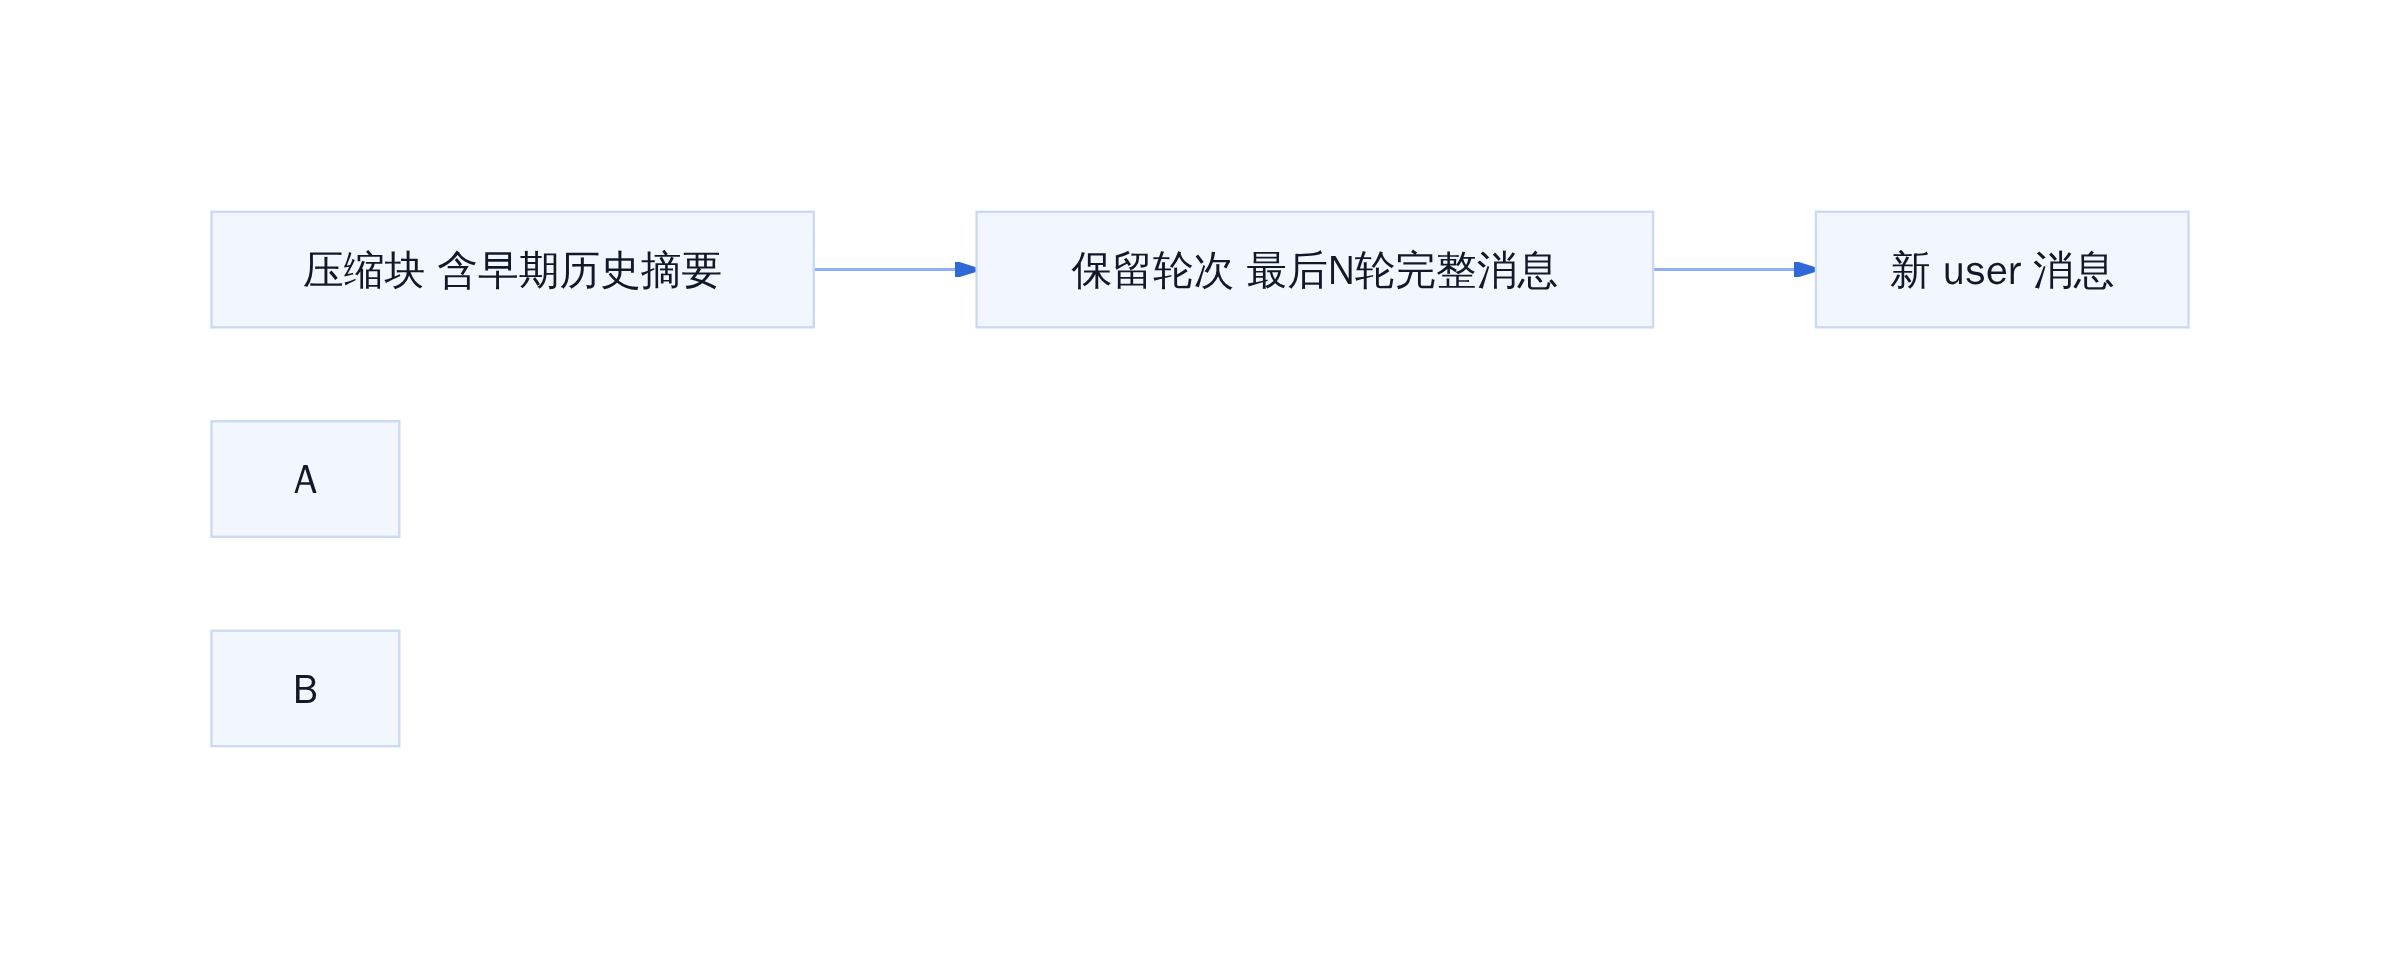
保留尾部压缩的请求结构
四、什么时候该信任它,什么时候该关掉
4.1 默认打开的收益
对于大多数 Claude Code 用户,idle compaction 是一个「设好就忘」的功能。它在你喝咖啡的时候默默把历史压缩掉,你回来时缓存依然有效,无需任何手动操作。
更狠的是,每年能省下一个亿——至少对那些每天有长会话的企业用户来说,缓存失效导致的重复 token 费用是真实存在的隐性成本。
4.2 需要关闭或自定义的场景
有两类场景下,你可能需要调整默认行为。
其一是高精度推理任务。如果你对早期对话中的细节有强依赖,压缩导致的摘要丢失可能影响后续质量。这种情况下,可以手动执行 /compact 并在合适时机介入,而非依赖自动压缩。
其二是成本敏感场景。虽然 idle compaction 节省了缓存失效费用,但压缩本身也是一次 API 调用,会产生摘要生成的 token 费用。对于极低频使用的会话,这笔开销可能不如直接承受一次缓存失效划算。
4.3 今天就可执行的判断
- 如果你的会话频繁超过 10 万 token 且每次中断后再打开都会触发全量付费,保持 idle compaction 开启是正确选择。
- 如果你在做需要完整上下文回溯的调试或审计工作,考虑手动控制压缩时机,或在压缩后导出完整历史作为备份。
- 如果你使用的是 Claude API 自行构建 Agent,优先在 API 层配置 threshold compaction,idle compaction 仅作为 TUI 层的补充保障,两者不冲突但职责不同。
缓存不会自己刷新,除非系统替你做了这件事。
五、取舍判断与可执行建议
这套机制的本质是一个判断:用少量的压缩 token 费用,换掉大额的全量输入 token 费用。在长时间运行的 Agent 场景下,这笔交易永远划算——更狠的是,用户甚至感知不到压缩发生过。
取舍的边界在于:如果你的 Agent 会话天然短、或者你已经有成熟的应用层压缩策略,idle compaction 就是多余的基础设施开销。反之,如果你是 Claude Code 的日常重度用户、且经常进行跨小时的长对话,关掉它等于主动放弃缓存优惠。
今天可以做的三件事:
- 检查你的 Claude Code 版本是否 ≥ 2.1.299,确认 idle compaction 已生效。如果没有,升级版本即可。
- 观察你的会话模式:如果经常遇到缓存过期后第一次请求特别慢(全量 token 处理),说明你正属于目标用户群体。
- 如果需要精细控制,通过环境变量关闭 idle compaction,改为在应用层使用 on-demand 压缩,并配合 keep-tail 保留最近轮次。
缓存续命,token 自由
一套好系统不应该靠用户自觉 /compact,而是应该在缓存快过期前自己先把事情做了。idle compaction 补上的就是这个「自己先做了」的能力。
参考文献
- Claude Platform Docs - Compaction
- Claude Platform Docs - On-Demand Compaction
- Claude Platform Docs - Threshold Compaction
- Claude Platform Docs - Keep Recent Turns
- SemiAnalysis on Idle Compaction
- AI-fundamentals - Claude Code Context Compression
- cc-notebook - Claude Code 上下文压缩算法深度分析
- Harness Engineering - 自动压缩章节
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师