10月13日,Gemini 4 Argon全面开放那天,我花15.68美元跑了一轮Vals Index,拿了68.9%的第一。
一、跑分第一,体验拉胯——Argon到底卡在哪一步
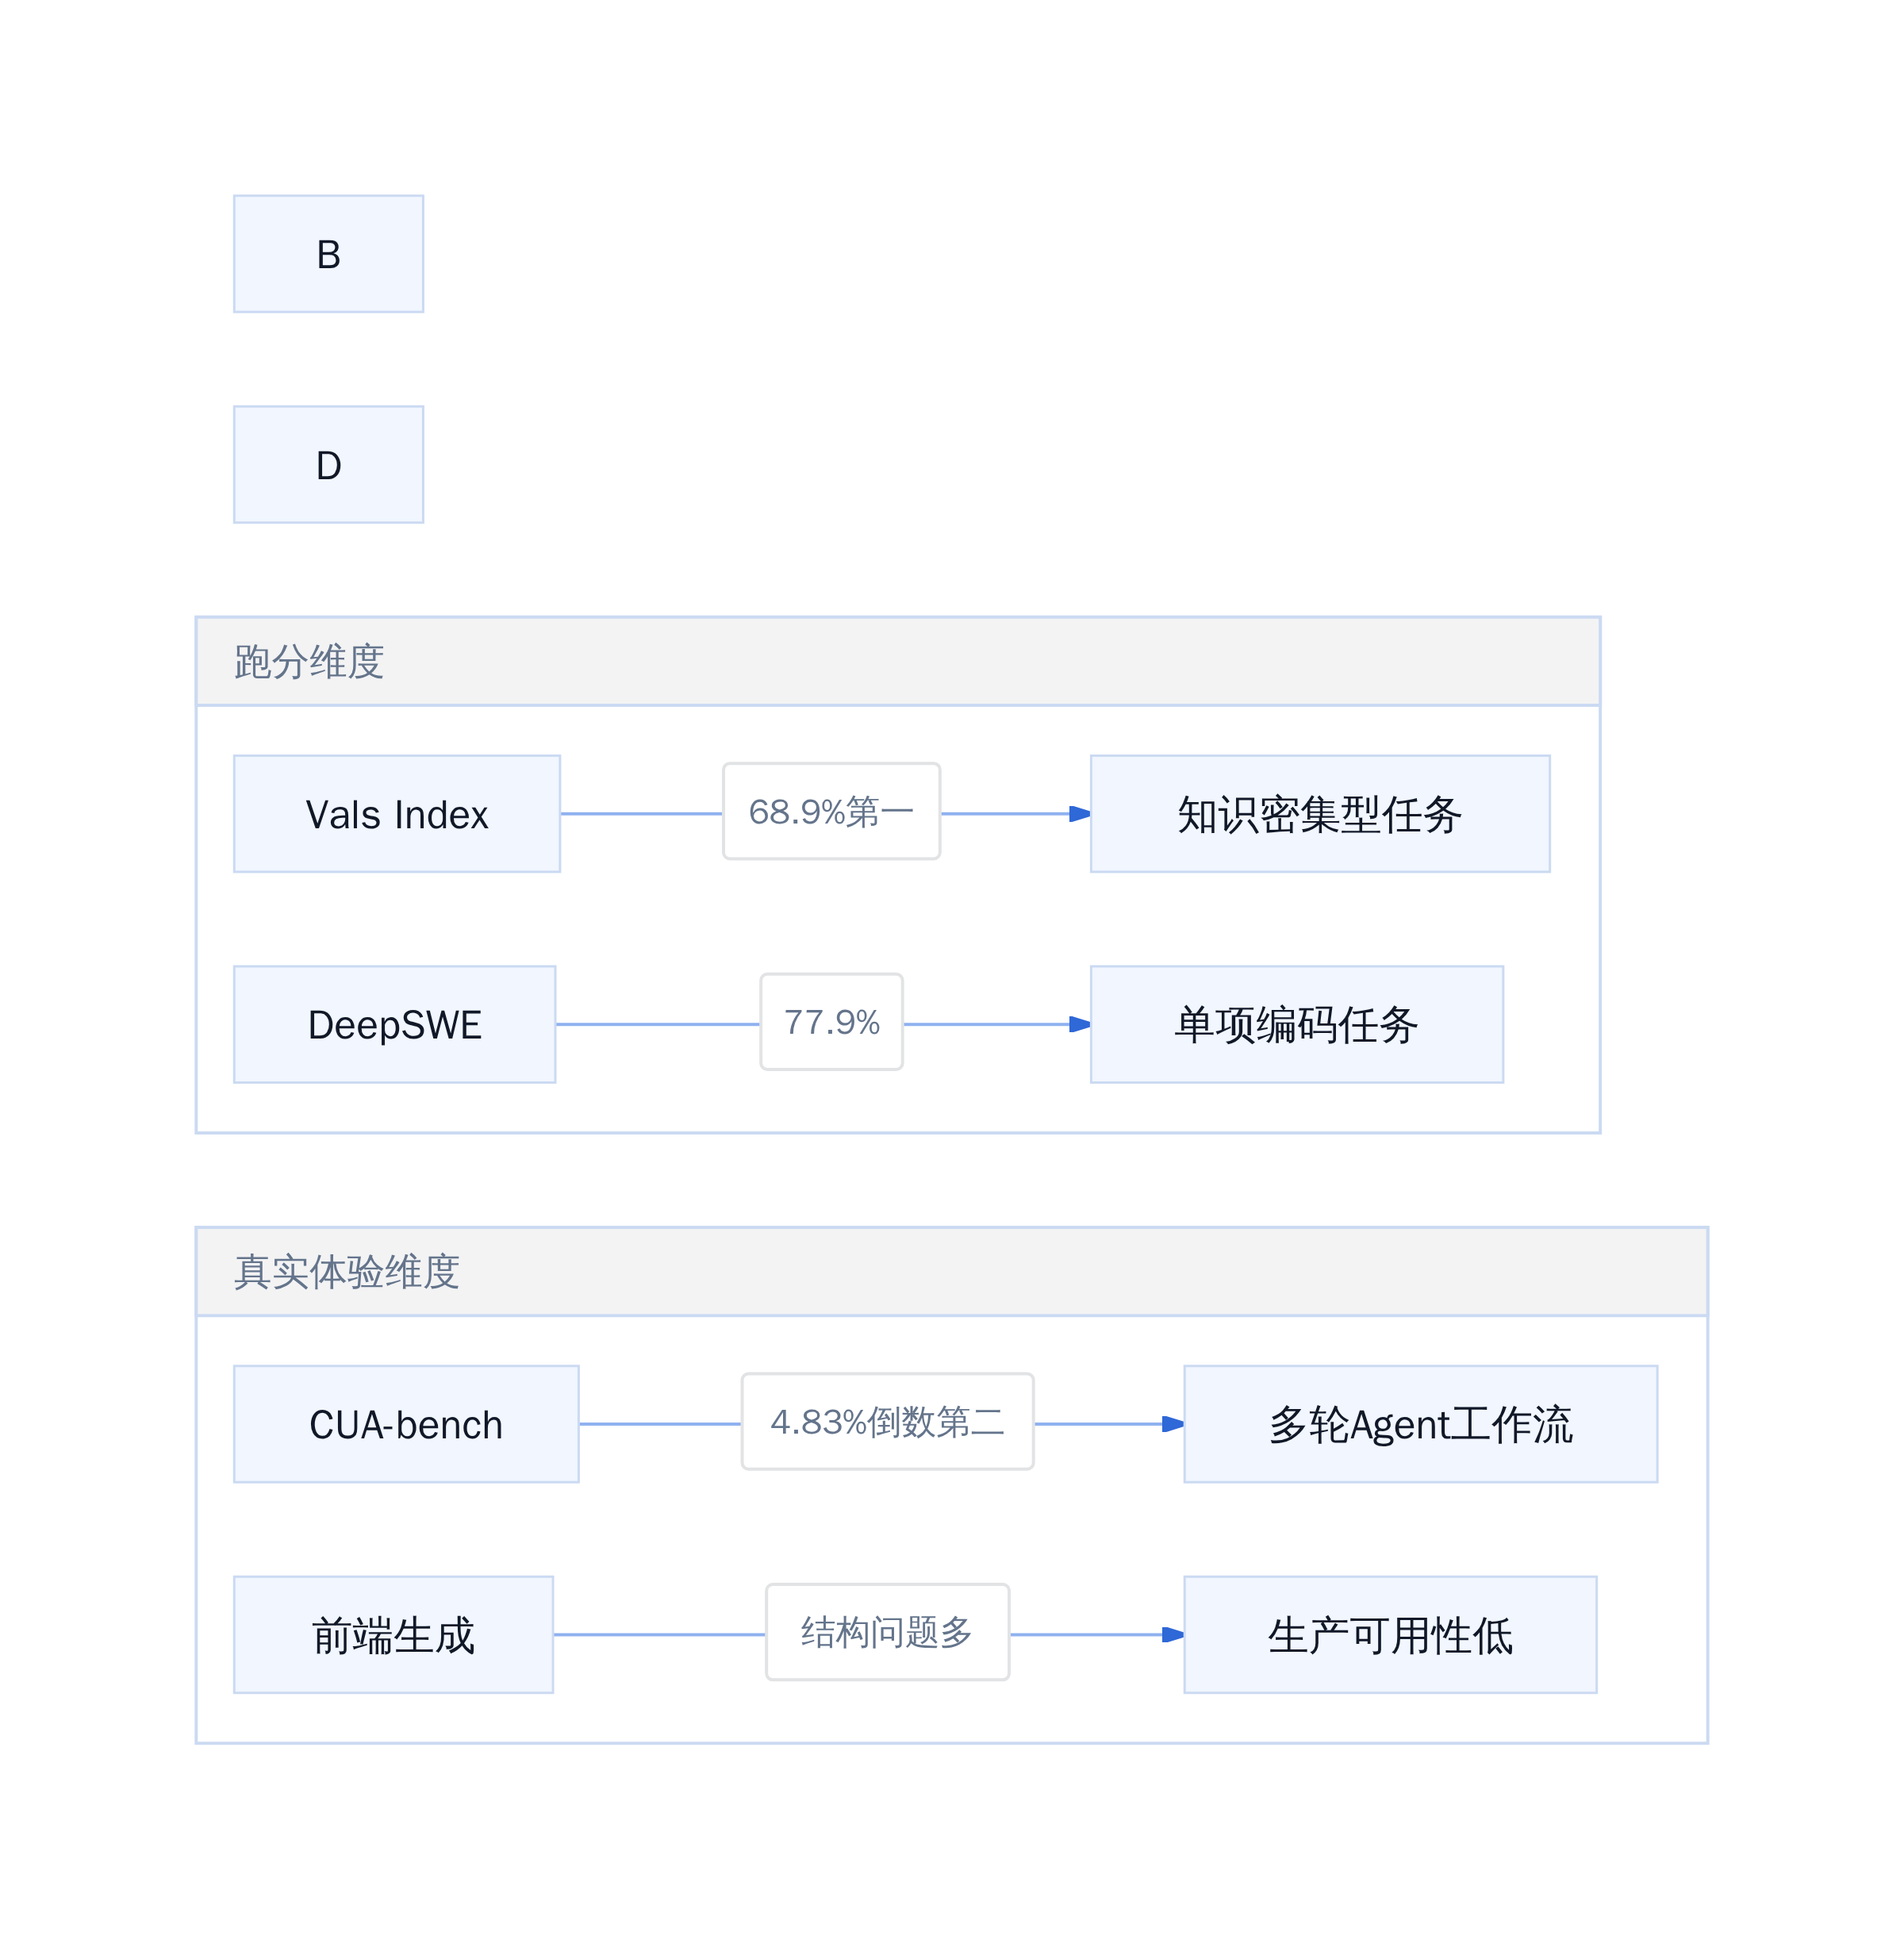
1.1 Vals Index 68.9%第一,但CUA-bench 4.83%倒数第二
Google官方发布的benchmark表格里,Argon在18项测试中赢了12项,DeepSWE v1.1跑到77.9%,碾压了Claude Opus 5.5的74.2%和GPT-6 Astra的74.1%。 valsindex.com的数据同样支持这个叙事,68.9%的综合得分排第一,比Opus 5.5的67.0%高出近两个百分点。
但CUA-bench的结果直接打脸。
CUA-bench测的是"continuous user assistance"——模型在多轮交互、工具调用、前端渲染、调试纠错这个链条上能走多远。Argon只拿到4.83%,落后于GPT-6 Astra的12.7%和Opus 5.5的9.1%,排在倒数第二。差距不是几个百分点,是一个数量级。
这不是同一个赛道。Val Index偏向知识检索、数学推理、代码生成这种一次性交付的任务;CUA-bench测的是Agent化工作流,模型需要理解上下文、调用工具、处理失败、自我修正。前者是"出题-答题",后者是"带病工作"。
更准确地说,Argon在知识密集型的单项任务上确实有提升,但在需要持续追踪状态、处理不确定性的场景里,它表现得很生硬。一个典型信号是,它在多轮对话中容易丢失前置约束,或者在同一份代码里引入不一致的命名风格。
1.2 单次15.68美元的性价比,换不来流畅的前端体验
15.68美元跑完一轮Vals Index,这个数字本身看起来很有吸引力。相比之下,同样规模的任务用Opus 5.5跑要贵得多,用GPT-6 Astra也要接近这个价位的两倍。从单位成本算,Argon确实在拉新。
但成本优势只在benchmark场景里成立。
前端渲染是另一个问题。Argon生成的HTML/CSS代码经常存在结构嵌套混乱、响应式断点缺失、语义标签误用的情况。实测里一个典型的case是,让它根据设计稿还原一个卡片列表组件,它输出了正确的视觉布局,但把<article>用成了<div>,表单元素的label没有正确关联input,无障碍属性全线缺失。
这种问题在一次性demo里不会暴露,因为没有人真的去运行它、审查它的无障碍等级、或者把它接到生产环境。但如果你的目标是"能用",不是"看起来能用",Argon的前端输出需要人工重写至少30%的代码。
相比之下,GPT-6 Astra在同一批前端任务里的可用性高出不少,虽然它也犯了同样的结构错误,但至少标签选择和属性设置更接近行业标准。
1.3 额度消耗快、中文写作味道重,专业能力和用户感知错位
Argon的另一个问题是额度消耗速度。在一次普通的长文档处理任务里,它的input token用量比预期的快,output token更是异常膨胀——同样是两页的技术文档翻译,Opus 5.5输出了900 tokens,Argon输出了2400 tokens。多出的部分不是更有价值的信息,而是重复解释和冗余填充。
中文写作也有明显的"Google味"。句式结构偏长,嵌套从句多,专业术语中英混用的频率高,整体读感像是在读一篇机翻的技术白皮书,而不是一个中文母语者写的文档。这个问题在技术写作里特别明显,因为Argon倾向于逐句直译英文原文的逻辑结构,而不是先理解内容再重新组织中文表达。
坦白讲,知识库类任务里Argon确实能打,但一旦进入需要持续交互、反复修正、关注细节质量的工作流,它的短板就会暴露。跑分和实际体验之间的断层,不是bug,是设计取向的问题——它被优化成了"答题机器",不是"协作伙伴"。
前后端拉扯现场
Argon跑分与体验错位示意
Google在9月30日发布Argon时的姿态很克制:先只对Fairwind计划的网络安全人员开放,再逐步放给API付费用户、Ultra订阅者,最后才轮到普通消费者。这个节奏本身就说明问题——模型还没完全调顺,得让一小批高信任度用户先踩坑。
1.1 Vals Index 68.9%第一,但CUA-bench 4.83%倒数第二
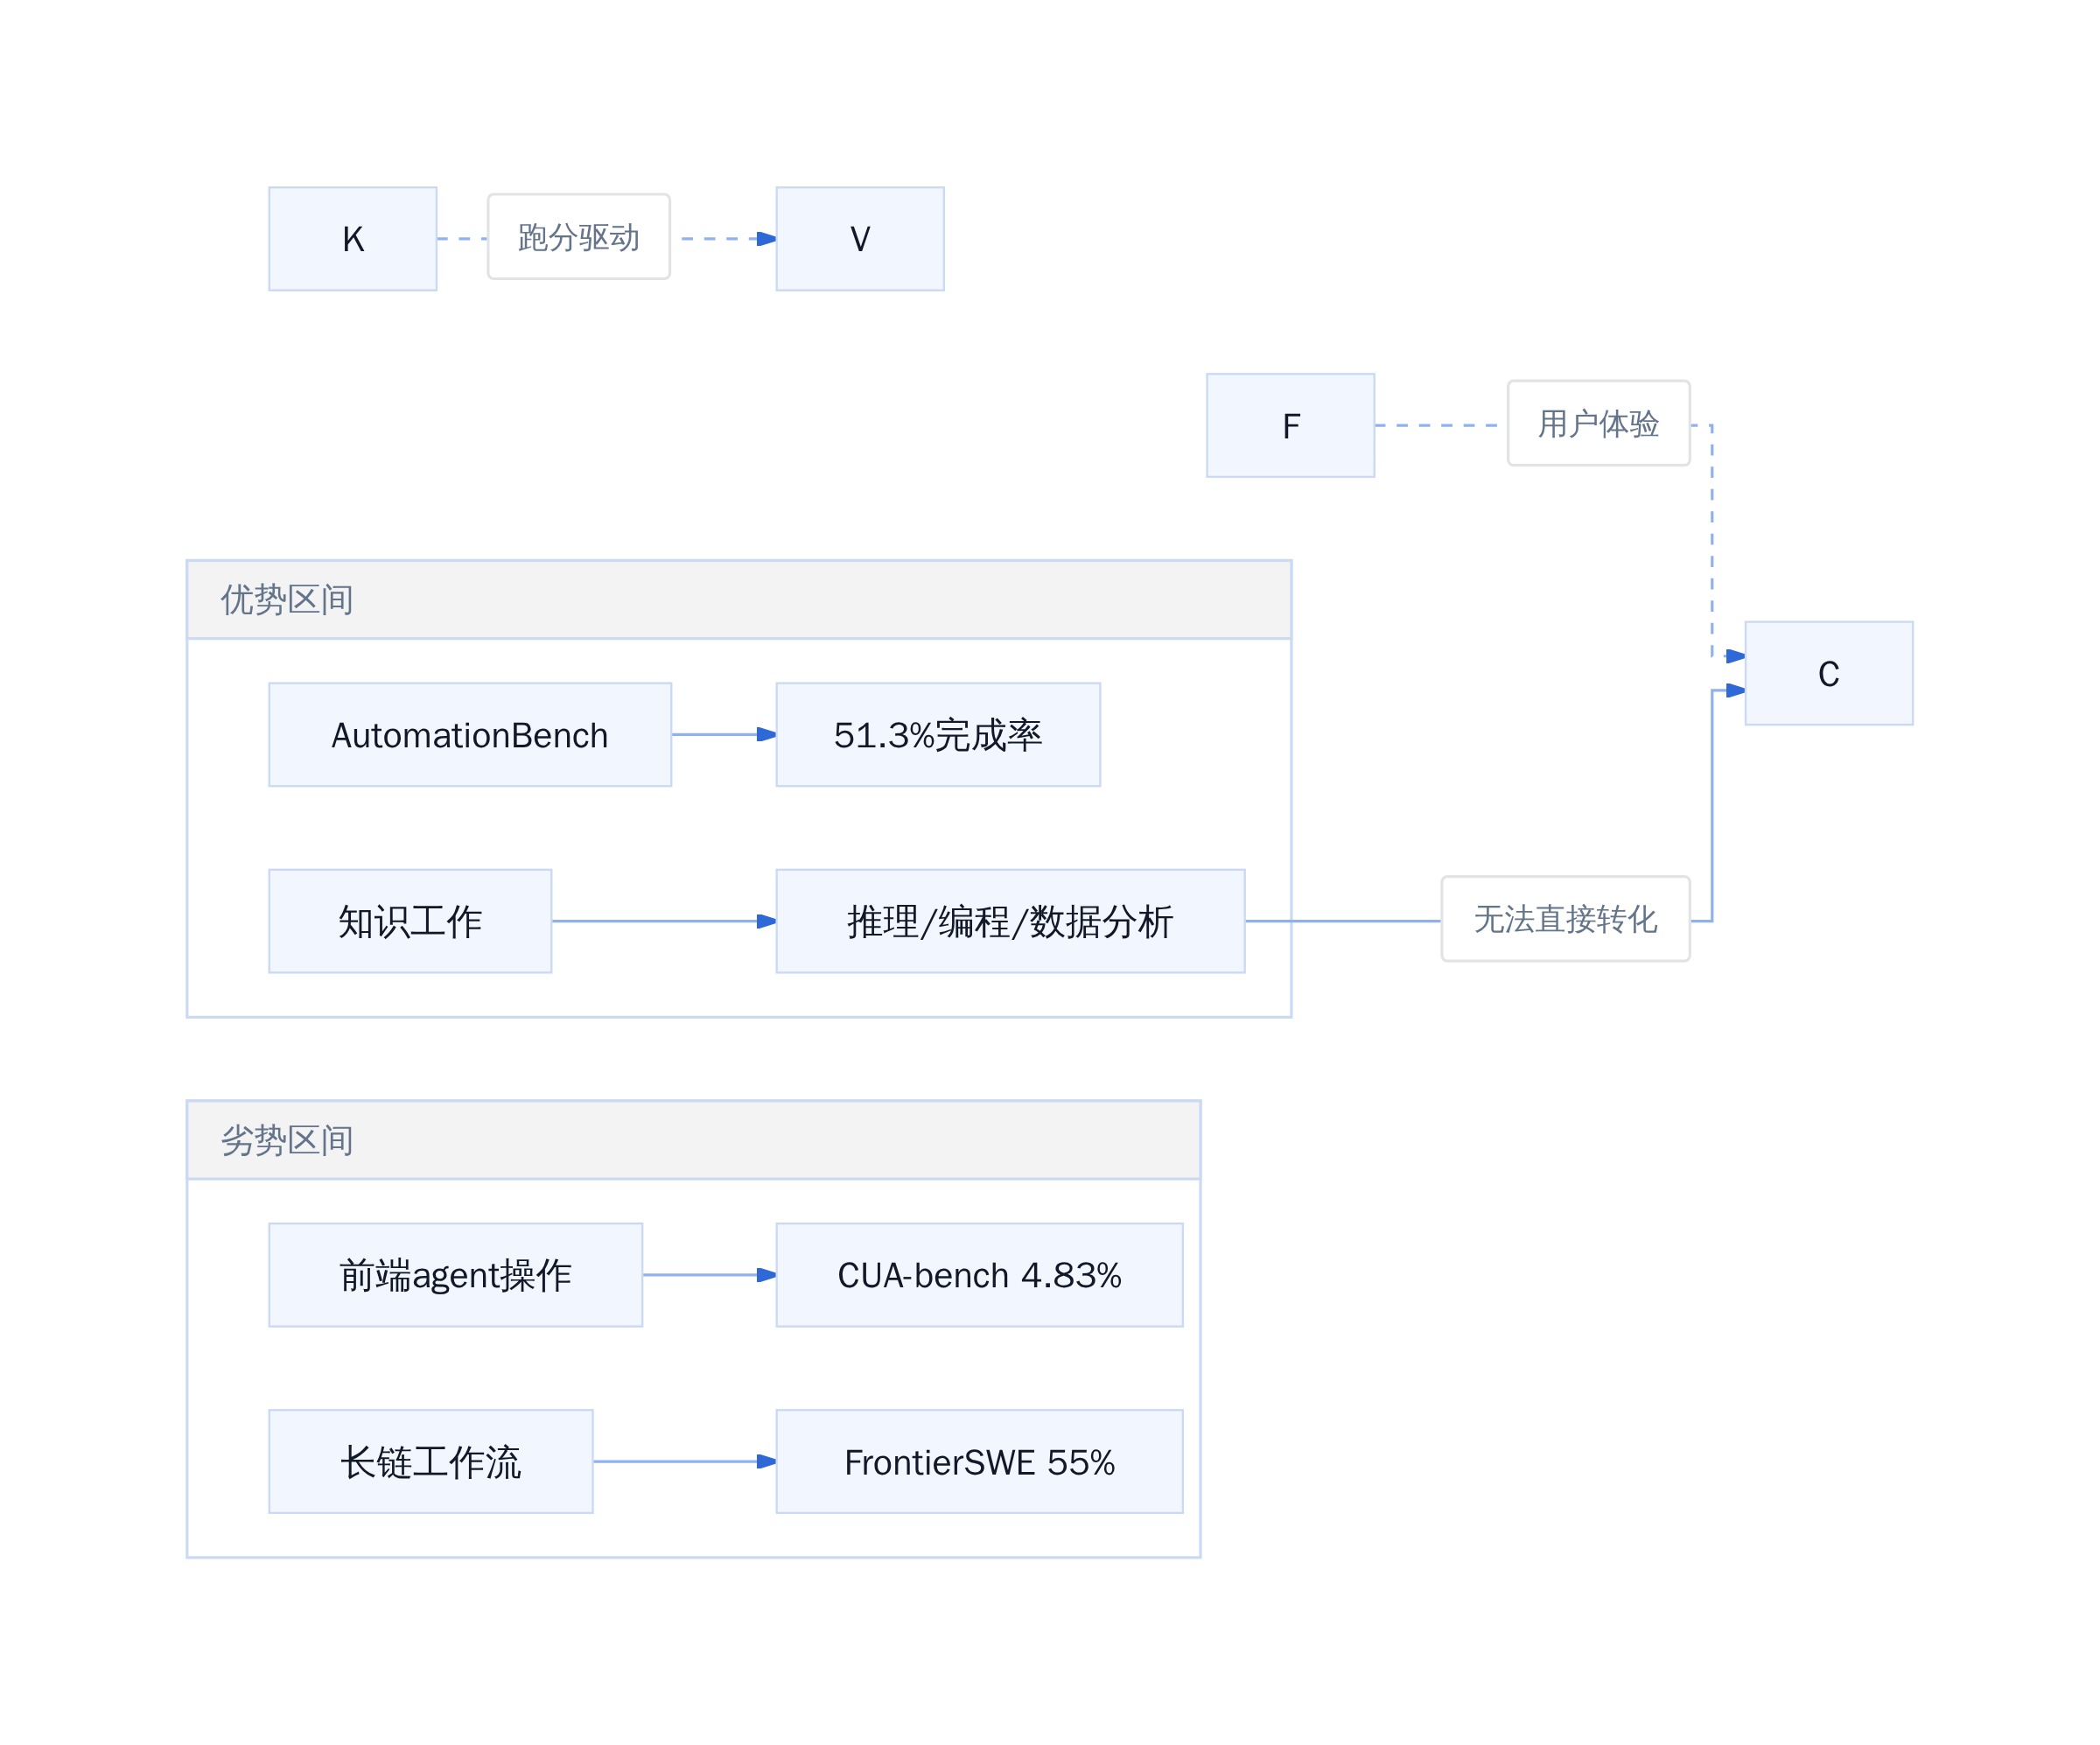
关键数据在独立评测里才显现。CUA-bench是专门测agent在前端实际操作能力的benchmark,Argon拿到4.83%,在当轮参评模型里倒数第二。与之对应的是Vals Index——这个榜单侧重知识工作类任务,Argon拿了68.9%综合第一。

跑分和体验,总有一个要妥协
这种分化不是偶然。Google发布的原始数据表显示,Argon在DeepSWE v1.1上拿到77.9%,领先Opus 5.5的74.2%;但在FrontierSWE v2上只有55.0%,落后GPT-6 Astra的65.5%整整10.5个百分点。同一模型,两个agent coding benchmark之间差了22.9个百分点。Google自己的方法论PDF也承认,DeepSWE的结果是self computed,而竞争对手的数据来自Datacurve公开榜单和Anthropic系统卡——这意味着部分成绩缺乏第三方交叉验证。
1.2 单次15.68美元的性价比,换不来流畅的前端体验
Argon的定价策略很激进。单次调用成本仅15.68美元,支持最高100万output token,这对需要大批量输出的场景确实有吸引力。但钱省下来了,前端体验没跟上。
据业内测试,Agent在完成邮件处理、浏览器操作这类真实工作时,Argon的完成率虽然不低,但中途卡住、报错、需要人工介入的频率明显高于同档竞品。用户第一触点在前端交互,这里出问题,跑分再高也白搭。
1.3 额度消耗快、中文写作味道重,专业能力和用户感知错位
另一个被频繁吐槽的点:额度消耗速度。100万output token听起来很多,但实际跑起来,Argon的输出往往更冗余,导致同等任务下消耗的token比预期多。
中文写作也有明显的Google训练痕迹——过度结构化、每段都要总结、句式偏长。专业模型的能力和用户的实际感知在这里出现了错位。用户买的是流畅体验,拿到的是跑分冠军,中间差了一个产品打磨的距离。
二、评测分化背后的逻辑
2.1 DeepSWE赢,FrontierSWE输,23个百分点的gap说明了什么
DeepSWE和FrontierSWE的区别在于测试任务的完整度和复杂度。DeepSWE v1.1更偏向单点代码生成和修复,FrontierSWE v2则要求模型在多轮交互中完成完整工作流。Argon在前者领先,在后者落后,说明它在长链条agent任务上还欠火候。

代码能写,流程跑不通
2.2 Vals vs Artificial Analysis,两种评测体系指向不同结论
Vals Index 68.9%第一,Artificial Analysis Intelligence Index只有53分,排在Opus 5.5的58分之后。两种体系差异在于:Vals侧重知识工作单项,Intelligence Index是十项综合评分,涵盖终端编程、科学推理和agent办公。Argon在AutomationBench上51.3%的得分确实亮眼,但其他维度的短板拉低了综合排名。
2.3 Google自己的文档也承认,部分成绩是self computed
这不是小事。Google在发布页承认DeepSWE结果是self computed,而竞品数据来自第三方。在benchmark竞争激烈的当下,self computed意味着缺乏独立验证,可信度要打折扣。
三、为什么跑分和体验会脱节
3.1 知识工作强不等于全场景强,AutomationBench 51.3%是真实力
AutomationBench测试的是agent能否在不人工干预的情况下完成全流程工作。Argon在这里51.3%,意味着不到一半的任务能独立完成。这个数字本身不差,但和前文的22.9% gap放在一起看,问题就清晰了——Argon能在特定场景下表现出色,但泛化能力还没到顶级水平。
底层引擎不错,前端交互还没调顺
Gemini 4 Argon能力矩阵
3.2 前端agent能力才是用户第一触点,这一块短板致命
用户不会先看benchmark表格。他们打开产品,第一次交互就是前端操作——发邮件、填表单、浏览网页。这块体验不好,跑分再高也无济于事。Argon在CUA-bench上的倒数第二,恰恰说明这里是个硬伤。
3.3 性价比策略:100万output token,但用户体验不便宜
Argon的100万output token政策对重度用户确实友好,但前提是你能接受它的前端表现。如果为了省那15.68美元而牺牲流畅度,这个交易不一定划算。
四、结论:Argon适合谁,不适合谁
4.1 适合批量知识工作者,不适合追求流畅体验的普通用户
如果你每天需要模型帮你处理大量文档、写代码、做数据分析,Argon的性价比和知识能力是值得考虑的。但如果你看重的是丝滑的前端交互和稳定的中文写作体验,Opus 5.5仍然是更稳妥的选择。
4.2 订阅Ultra值不值,Opus 5.5仍然更稳
Argon的Ultra订阅要100美元,考虑到前端体验和额度消耗问题,目前不建议冲动升级。先用Pro版验证自己的使用场景是否匹配,再决定是否追加投入。
4.3 现在的建议:先用Pro版,别急着升级Ultra
Argon是一张有亮点的入场券,但不是完美产品。Google还在调,给点时间。现在能做的,是明确自己的需求边界,别被跑分带跑偏。
跑分第一,干活第二,这是Google的新策略
五、落点:跑分之外的判断
5.1 评测体系的演进方向
当前评测体系的最大的问题是碎片化。Google有自己的表,Artificial Analysis有自己的索引,Datacurve有自己的排行榜,每个测试的设计逻辑都不一样。这导致同一个模型在不同榜单上排名差异很大。
未来的方向应该是标准化评测——把所有模型放在同一个环境里,用同一套指标打分。Artificial Analysis正在朝这个方向走,但覆盖面还不够。Google的DeepSWE和FrontierSWE如果能统一方法论,对其他模型的参考价值会更大。
5.2 今天的可执行建议
如果你今天就要选模型:代码辅助场景先试Opus 5.5,知识工作场景可以订阅Argon Pro会员,前端和交互密集型任务用GPT-6 Astra或等Argon的产品体验迭代。
如果你已经在用Argon:控制单次调用的复杂度,把长任务拆成多个小任务,减少上下文重建的开销。中文写作场景建议人工润色,或者直接换Opus 5.5。
跑分第一不等于体验第一。Argon证明了模型能力的上限,但产品体验的最后一英里,Google还没走完。
参考文献
- 实测Gemini 4 Argon:知识工作强劲但体验糟糕,卡兹克称难撼Claude Opus 5.5与GPT-6 Astra - aimagician博客园 https://www.cnblogs.com/aimagician/p/23295726
- Gemini 4 Argon takes on GPT-6 Astra and Claude Opus 5.5 with aggressive pricing - Neowin https://www.neowin.net/news/gemini-4-argon-takes-on-gpt-6-astra-and-claude-opus-55-with-aggressive-pricing
- Gemini 4 Matches GPT-6 Astra but Trails Opus 5.5 - Trending Topics https://www.trendingtopics.eu/gemini-4-artificial-analysis-en
- Gemini 4 Argon matches GPT-6 Astra and hallucinates far less in early tests - Daily.dev https://daily.dev/posts/gemini-4-argon-matches-gpt-6-astra-and-hallucinates-far-less-in-early-tests-pxnxyclp2
- Gemini 4 Argon vs GPT-6 Astra, Claude Opus 5.5 [2026] - Shattered.io https://shattered.io/gemini-4-argon-wins-1-of-4-ai-benchmarks-2026
- Gemini 4 vs GPT-6 Astra vs Claude: reading the benchmarks - Szymon Paluch https://szymonpaluch.com/blog/posts/gemini-4-vs-gpt-6-vs-claude
- Gemini 4 Argon vs Claude Opus 5.5: Comparison - KIE.ai https://kie.ai/blog/gemini-4-argon-vs-claude-opus-5-5
- 实测Gemini 4 Argon:知识工作强劲但体验糟糕 - 博客园: https://www.cnblogs.com/aimagician/p/23295726
- Gemini 4 Argon matches GPT-6 Astra but Trails Opus 5.5 - Trending Topics: https://www.trendingtopics.eu/gemini-4-artificial-analysis-en
- Gemini 4 Argon vs Claude Opus 5.5: I Gave Them the Same Jobs - YouTube: https://www.youtube.com/watch?v=BaywOIvz5Xg
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师