我团队用AI写代码三个月,代码产出翻倍了,但每周的PR审查会议却拖得更长了——原来瓶颈不在写代码,而在看完代码的那一步。
代码审查,为什么变成了新的瓶颈
AI写代码越来越快,看代码的人没变
上个月某个技术团队在内部复盘会上抛出一组数据:引入Claude Code之后,团队的人均代码产出提升了200%。这个数字在行业内不是孤例。GitHub 2024年的报告显示,Copilot 用户平均每天多提交 5-15% 的代码。
产出的增速追上了,审查的流程却还停留在原来的轨道上。
每个工程师提交的 PR 数量变多了,PR 的平均行数也在增加。但负责审查的人还是那几个,时间预算没有扩容。结果是:PR 开始积压,审查会议从每周一小时拉长到两小时,甚至有人抱怨「光看别人的代码就耗尽了一下午」。
bottleneck 转移了。代码写作的成本在下降,验证代码正确性的成本在上升。
更准确地说,问题不在于「审查不过来」,而在于审查的质量本身就在下降。人看代码是有限带宽的,连续审五个 PR 之后,注意力曲线会明显下滑。漏掉边界情况、忽略安全细节、对某段逻辑视而不见,这些都是疲劳审查的常态。
Anthropic 内部在上线 Code Review 功能前跑过一段时间的数据。他们的发现是:在没有 AI 辅助审查的情况下,只有 16% 的 PR 收到了实质性审查意见。换句话说,大部分 PR 要么没人看,要么只是匆匆扫过、打个「看起来没问题」的标签。
这个数据揭示了一个反直觉的事实:团队缺的不是审查动作,而是有效的审查质量。
审查会开到怀疑人生
一个被忽视的真相:审查质量才是交付速度的决定因素
软件工程里有一个常被简化理解的等式:交付速度 = 开发速度 + 测试速度 + 审查速度。
但这个公式的隐藏前提是三者增速相同。当 AI 把开发速度提升了2倍,而审查速度原地踏步时,整个链条的瓶颈就变成了审查。
更重要的是,审查质量直接影响后续的返工成本。
一条漏到线上的 bug,修复成本是代码评审阶段发现它的 10-100 倍。这不是危言耸听,而是软件工程领域反复被验证的结论。DRE(Defect Removal Efficiency,缺陷移除效率)这个指标在业界普遍徘徊在 60%-80%,意味着至少有 20%-40% 的缺陷会漏到生产环境。
AI 写代码的引入,实际上把这个漏检率的基数放大了。同样的审查流程,面对更多、更快的代码产出,漏检的绝对数量必然上升。
所以「谁来说这代码是对的」这个问题,正在从辅助性问题变成核心瓶颈。
这锅审查不背
##代码审查,为什么变成了新的瓶
Claude Code 的 Code Review 是什么
Anthropic 在 2026 年 3 月发布了 Code Review 功能,定位为「多 Agent 自动审查 PR 的系统」。核心设计思路是:当 PR 打开时,派出一组专门的 Agent 并行分析差异和上下文代码,每个 Agent 负责不同类别的问题(逻辑错误、安全漏洞、边界情况、回归风险),再通过验证步骤交叉过滤误报。
Anthropic 内部的测试数据是:有实质审查意见的 PR 占比从 16% 提升到 54%,超过千行的大型 PR 有 84% 会被找到问题。一个被反复引用的案例是:某工程师提交了一行看似普通的修改,Code Review 标记为 critical——因为这行会破坏整个认证系统的行为逻辑,人工审查几乎不可能发现。
审查结果以 GitHub 内联注释的形式发布在对应代码行上,并在 PR 评论中给出摘要。不会批准或阻止 PR,不改变现有审查流程。
多 Agent 并行审查的工作原理
Code Review 的本质是一个简化的 MoE(Mixture of Experts)结构:多个 Agent 各自持有独立的 context window,分别推理,然后进入验证环节。
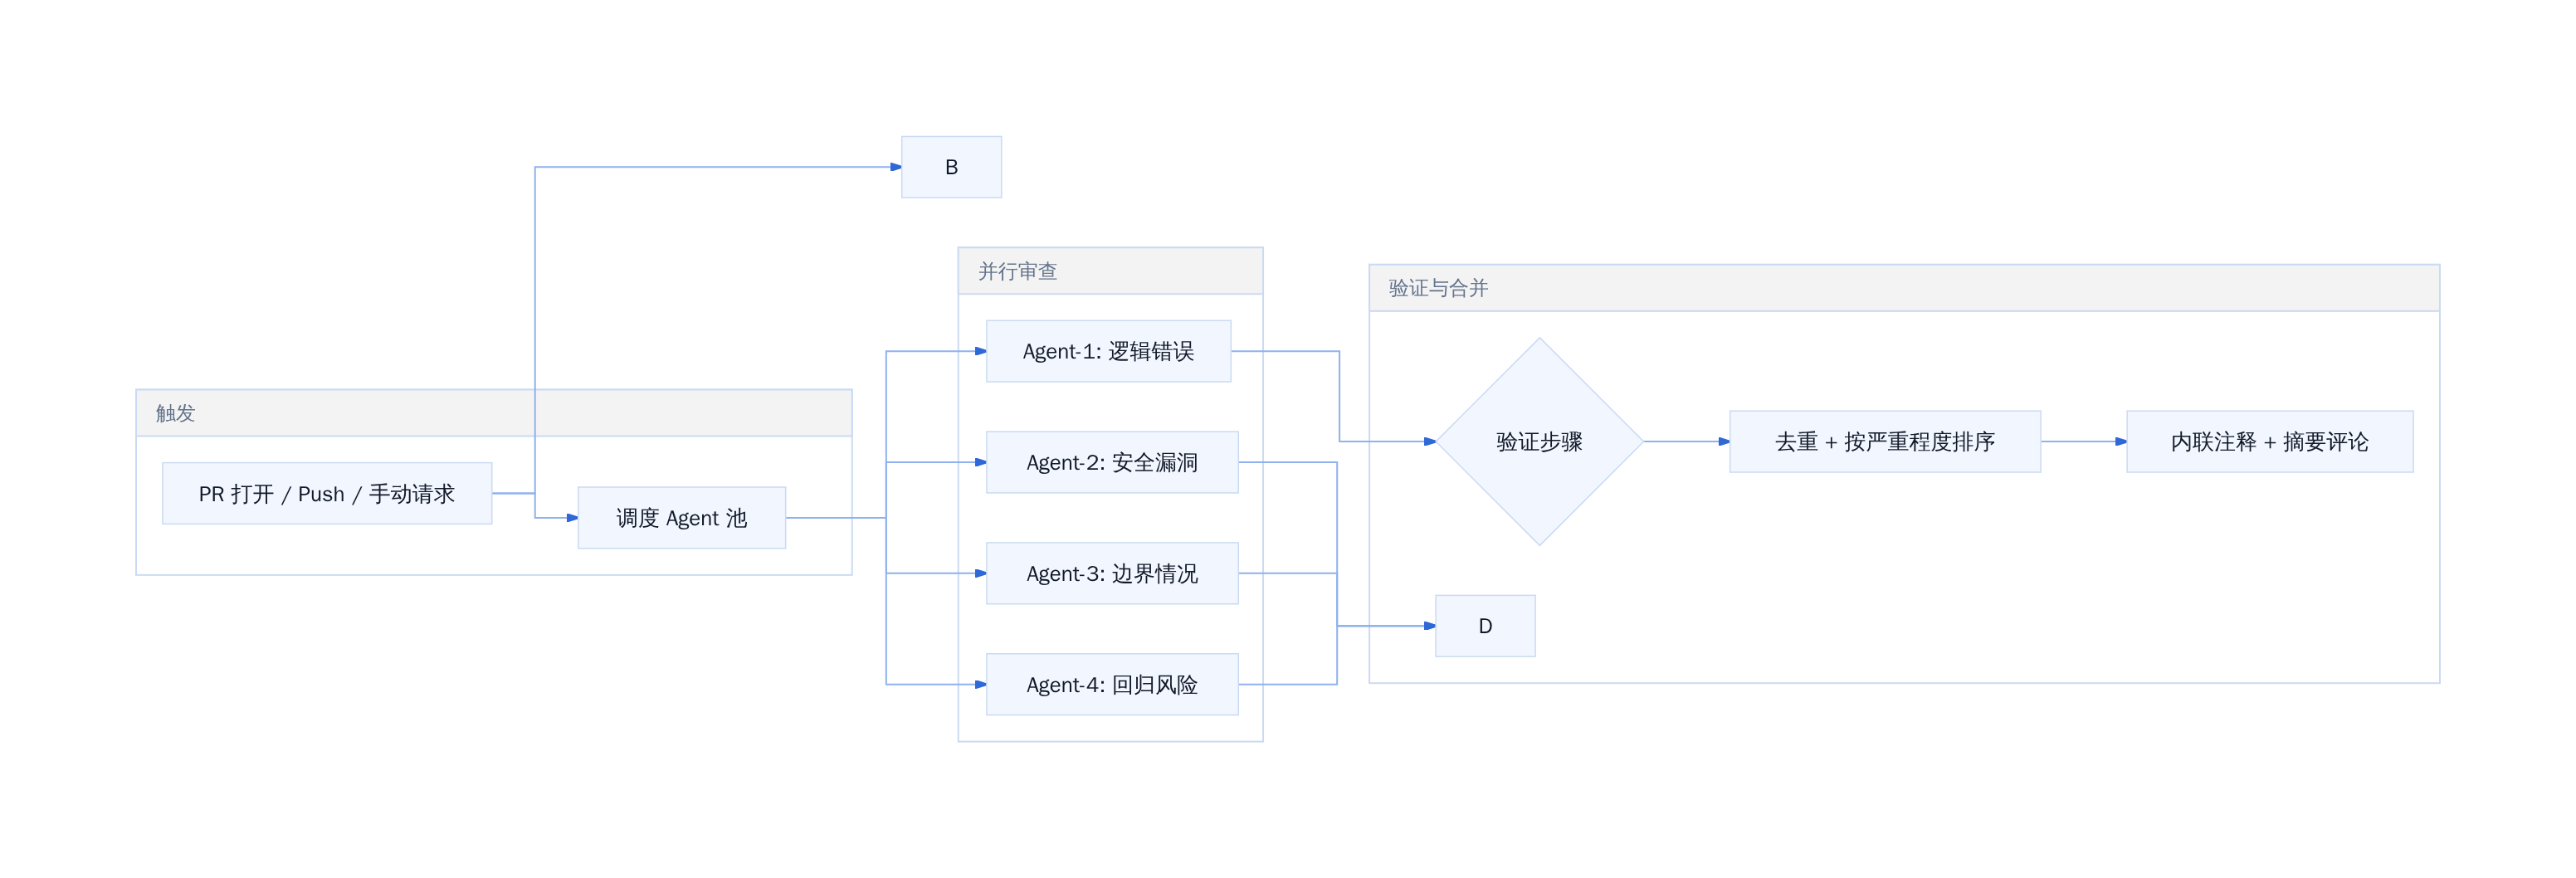
Claude Code Review 多 Agent 并行审查流程
关键机制在于「验证步骤」:每个候选问题不会被直接当作结论输出,而是会放回实际代码行为中校验,过滤掉与真实执行不符的误报。这也是为什么平均 18–20 分钟才出结果——不是模型慢,而是多轮交叉验证在拖时间。
成本模型按 token 计费,Anthropic 官方公布的是每次审查 $15–$25,价格随 PR 大小和复杂度线性扩展。对一个平均 300 行的 PR,单次审查的 token 消耗大约在 100K 上下。
三种触发方式:本地命令、GitHub App、GitHub Actions
Claude Code 提供了三种不同的集成路径,定位各不相同,不互斥。
本地命令 /code-review:在开发者机器上运行,适合提交前自检。问题是只能覆盖单人视角落差,无法形成团队层面的沉淀。
GitHub App:安装到仓库后,PR 打开或每次 push 时自动触发。这是 most common 的生产用法。配置简单,管理员在 claude.ai/admin-settings/claude-code 开启即可。
GitHub Actions:适合希望把审查嵌入 CI/CD 流水线的团队。可以在 stages 中加一个 ai_review 节点,放在 build 之前。
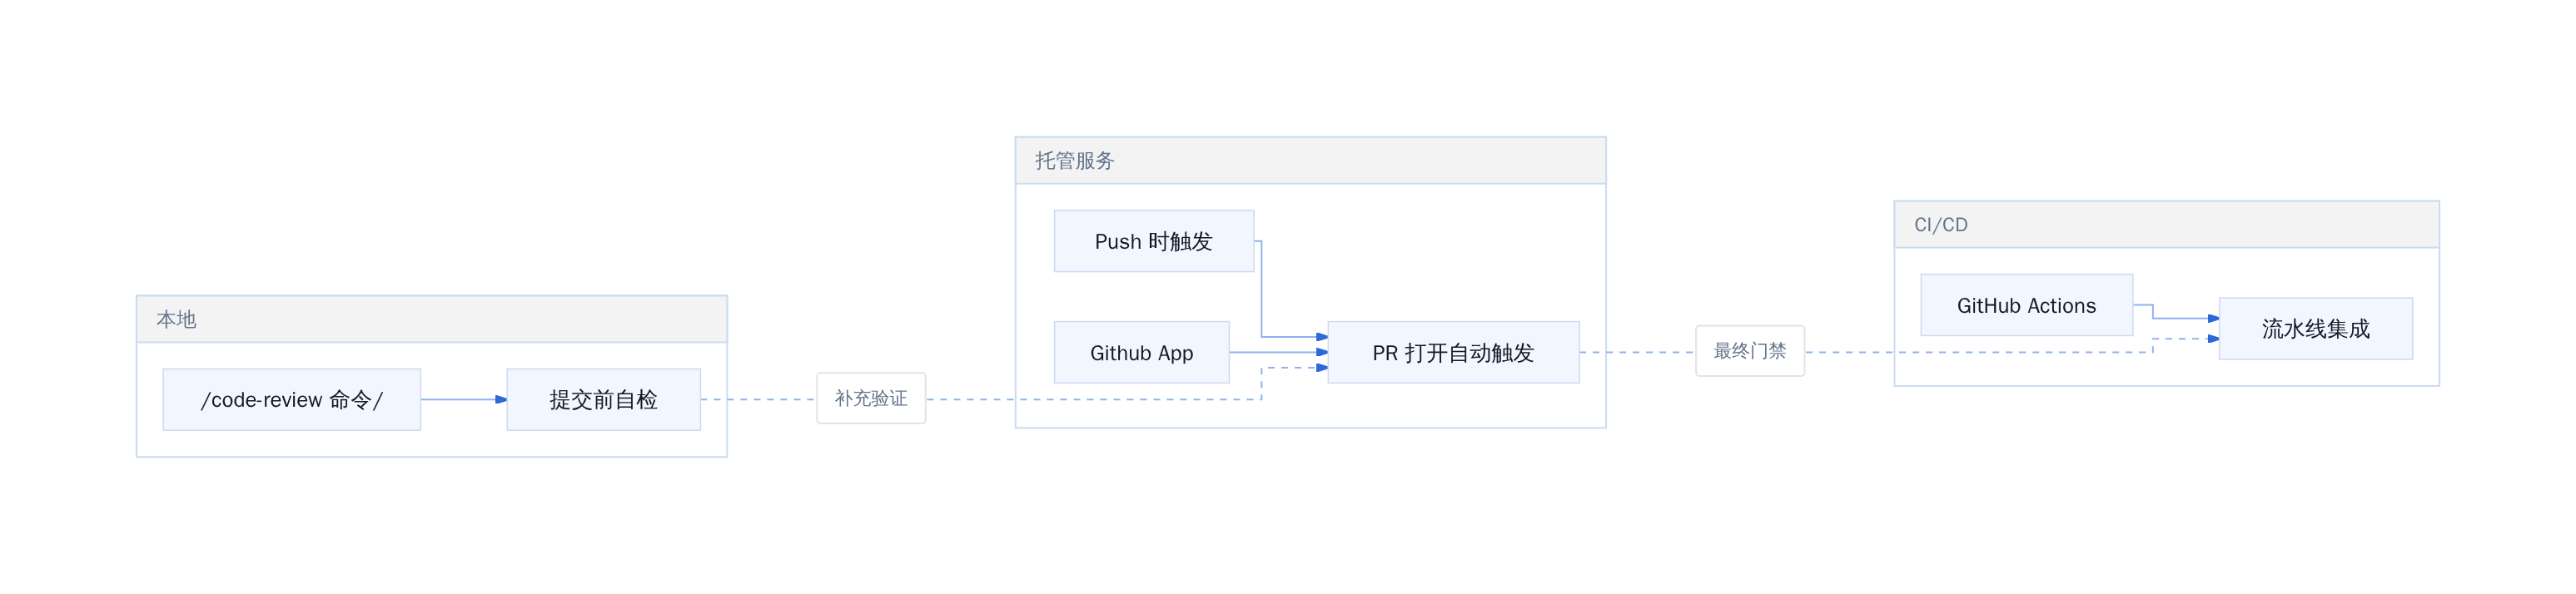
三种触发方式的定位对比
一个值得注意的实践是:有人把 GitHub App 配成「每次 push 都触发」,结果 WIP 提交、格式修正、注释改动全部被 review,comment 量暴增,团队开始忽略 Claude 的评论。这正是最糟糕的结局——把一个可能有效的工具变成了噪音源。
更稳的配置是只监控 PR 打开事件,或者配合 @claude review always 手动触发关键路径。
适用边界:Team 和 Enterprise 用户才能用
Code Review 目前处于研究预览阶段,仅对 Team 和 Enterprise 计划开放。启用零数据保留政策的组织不可用。
这意味着个人开发者、小团队暂时无法直接使用。对已付费的 Team/Enterprise 用户来说,定价是额外的按量计费,不计入计划包含的使用量。
另一个隐性边界是「审查质量不等于结论正确」。Agent 找到的问题经过了验证,但仍然可能出现「过度敏感」的情况——某些被标记为 warning 的问题,在特定业务场景下是合理的设计取舍。人工审查的核心价值恰恰在于理解这些背景,而这一点目前 AI 还做不好。
坦白讲,当前最值得做的不是等 Claude 把所有问题找出来再动手,而是把 Code Review 当作一道额外的门,和人工审查并行。两道门同时开,成本在可控范围内,误报率和漏检率都有改善空间。
数据背后的真实效果
Anthropic 公布的一组内部数字,比任何宣传文案都有说服力。
16%到54%:有实质审查意见的 PR 比例
启用 Claude Code Review 之前,只有 16% 的 PR 收到了实质性审查意见。这个数字背后是一个常见现象:大量 PR 在人工审查中要么被快速通过,要么因为时间压力而流于形式,真正被指出问题的比例很低。
启用之后,这个比例跳到了 54%。翻了超过三倍。
更准确地说,这 54% 不是指「所有 PR 都被挑出毛病」,而是指「有实质内容的审查意见」的比例——评论确实针对代码逻辑、安全或边界情况,而不是泛泛的格式提醒。这意味着 AI 把原本沉默的大多数 PR,转化成了有实际讨论价值的审查对象。
千行以上大型 PR 的 84% 问题检出率
PR 越大,人工审查越容易漏检。
Anthropic 的数据是:超过 1000 行的大型 PR,有 84% 会被找到问题。
[["reaction:agent-runtime-overload|caption=Agent 并行审查,不是一个人看代码了"]]
这个数字之所以重要,是因为大型 PR 恰恰是人工审查最薄弱的地带——变更行数多,上下文跨度大,审查者精力跟不上。多 Agent 并行分析 + 交叉验证过滤误报的设计,对这类 PR 的效果显著优于单个人类审查。
一个被忽略的关键案例:一行改动差点搞坏整个认证系统
官方分享了一个具体案例:某次 PR 里只改了一行代码,看起来普通得不能再普通,但 Code Review 把它标记为 critical 级别——这行改动会破坏整个认证系统的验证逻辑。
工程师本人承认,如果靠自己看,根本不会发现。
这种案例的价值不在于「AI 多厉害」,而在于它揭示了一个规律:AI 审查的强项不在显而易见的 bug,而在那些隐蔽的、跨模块的、需要全局上下文的判断。一行改动的破坏力,往往来自它与系统其他部分的隐性耦合。
Claude Code Review 工作原理
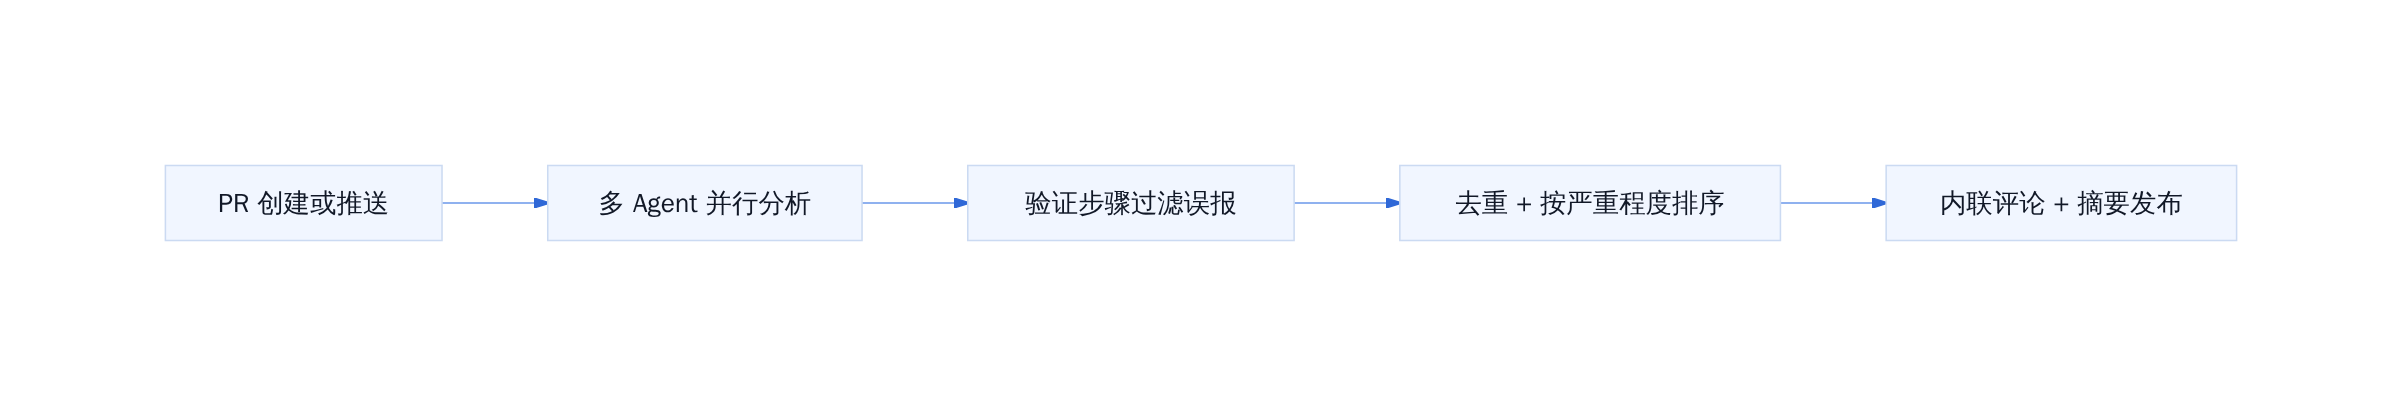
Claude Code Review 工作流程
审查在 PR 打开时、每次推送时或手动触发时运行。多个代理在 Anthropic 基础设施上并行分析差异和周围代码,每个代理负责不同类别的问题。验证步骤会检查候选问题是否与实际代码行为相符,以过滤掉误报。
触发方式对比
目前 Claude Code Review 有三种触发方式,适用于不同场景:
- 本地命令:在终端用
/code-review或@claude review手动触发,适合提交前自检 - GitHub App:管理员开启后自动审查每个新 PR,适合团队统一配置
- GitHub Actions:作为 CI 流水线的一部分,在特定 gate 触发审查
这三种不互斥。业内常见做法是本地命令做提交前自检,GitHub App 做 PR 自动审查,两道门覆盖不同粒度的问题。
团队实践中有一个常见陷阱:第一周把 GitHub App 设为「每次 push 触发」,结果 WIP 提交、格式修正、只改注释的 push 都会被审查一遍,评论量暴增,团队成员逐渐忽略所有 AI 评论——因为「反正里面很多是废话」。
最稳妥的做法是把触发时机收窄到 PR 打开和关键节点推送,而非每次 push。
成本与局限
每次审查$15-25,20分钟等待
Claude Code Review 的成本模型是典型的 token 计费,随 PR 大小和复杂度线性扩展。Anthropic 官方给出的均值区间是每次审查 $15–25,完成时间约 20 分钟。这不是固定费用,而是多 Agent 并行工作的自然结果:每个 Agent 拿着独立的 context window 扫描不同类别的问题,验证步骤再做交叉过滤,最后去重排序输出。
计算一笔账:一个中型项目每天 10 个 PR,月均 200 个审查,按 $20/次估算,月成本约 $4000。对小团队友好,对高频交付的团队来说,这个数字会直接出现在 engineering ops 报表里。
「更狠的是,每年能省下一个亿」——这句话在 Anthropic 内部成立。他们跑了几百万行代码的沉淀数据后,发现 Code Review 把实质性审查意见的 PR 比例从 16% 拉到了 54%,人工reviewer 从「看没看」变成了「看哪条」,单位人力的覆盖密度翻了近三倍。
误报问题:有团队一周反馈"噪音太多"
上线第一周,某团队把 GitHub App 配成「每次 push 触发」,结果 Claude 把 WIP 提交、格式修正、只改注释的 push 全 review 了一遍,comment 量暴增。团队成员的反应是:反正里面很多是废话,直接忽略。
这是最糟糕的开局——把一个可能有效的工具,用错误的触发频率杀死了。
问题不在于 Claude 能力不够,而在于多 Agent 并行架构的天然特性:每个 Agent 独立推理,只报告高置信度结果,不去重。重复发现的问题会出现在不同行或不同语境下,看起来像是多条独立意见。
Anthropic 的官方建议是:不要用 GitHub App 做全量自动触发,而是配合 Routines 做定时审查,或只在 merge 前手动触发。本地 /code-review 命令适合提交前自检,GitHub App 适合 PR 级别的终检。
哪些场景适合、哪些场景不值得
值得做的场景:
- 大型 PR(千行以上):Claude 内部数据显示,这类 PR 的 84% 会被检出问题,而且很多问题藏在跨模块调用的边界上,人工 review 容易漏掉。
- 安全敏感的认证/授权模块:一个看似普通的一行修改,被标记为 critical,因为它会搞坏整个认证系统。
- 团队人力紧张,reviewer 排队超过 48 小时。
不值得做的场景:
- 小型工具函数库:改动范围小,上下文有限,人工 review 成本也低,AI 介入的 ROI 不划算。
- 频繁迭代的 WIP 分支:每次 push 都 review,等于在制造噪音而非质量。
- 零数据保留要求的企业:Code Review 目前不支持零数据保留的组织,数据会经过 Anthropic 基础设施处理。
落地建议
本地自检+自动审查:两道门的实践
目前业内比较成熟的落地模式是两道门:
第一道门在本地,用 /code-review 命令做提交前自检。开发者自己在 IDE 里跑,发现问题当场修,不进入 PR 阶段。这一步过滤掉 70% 以上的风格问题和低级错误。
第二道门在 CI,用 GitHub App 或 Routines 触发 PR 级别的自动审查。这时候代码已经进入协作视野,Claude 会结合完整仓库上下文做交叉分析,重点关注跨模块影响、安全漏洞和逻辑回归。
两道门的分工逻辑是:本地管速度,云端管深度。两者不互斥,覆盖不同粒度的问题。
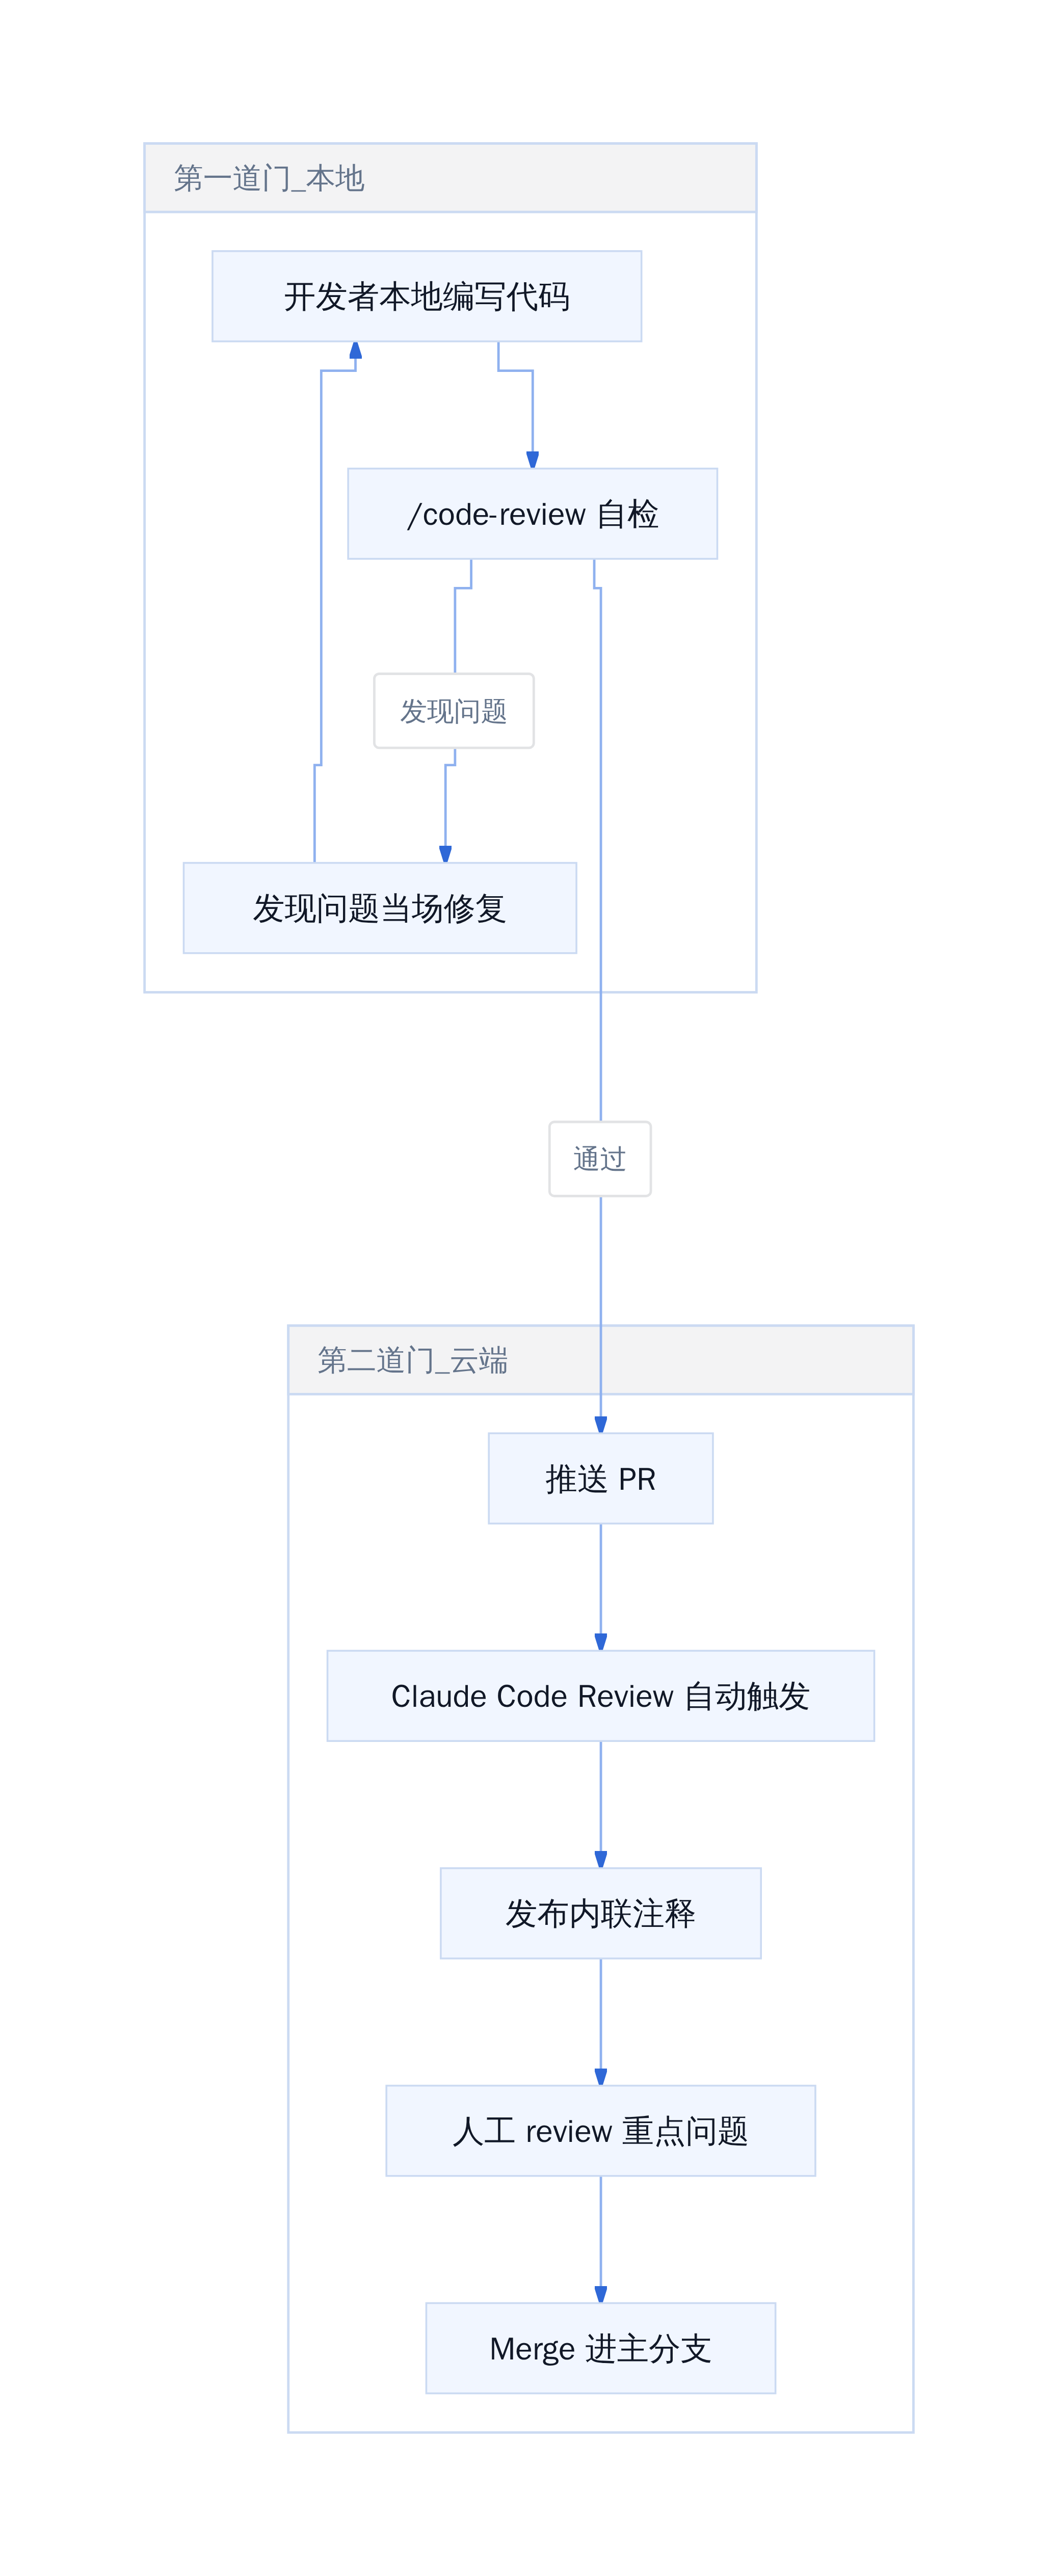
本地自检+云端审查两道门流程
不同团队应该从哪个粒度开始
从经验看,新团队建议从「最小可行配置」起步,而不是直接上全自动:
- 第一个月:只用本地
/code-review命令,让开发者习惯看到 AI 审查意见,不强制合并。 - 第二个月:在 GitHub App 里开启「仅 merge 前触发」,观察 comment 质量和团队反应。
- 第三个月:根据数据决定是否需要 Routines 定时扫存量 PR,或者调整 CLAUDE.md 自定义审查规则。
不要一上来就开「每次 push 触发」。那是制造噪音的标准路径。
未来趋势:AI写代码,AI看代码
Claude Code 年化收入已超过 25 亿美元,说明 AI coding 这个赛道正在从实验走向生产。
Code Review 的推出不是终点,而是基础设施化的一步。接下来的演进方向大致有三:
一是审查成本持续下降,token 价格下行会直接降低每次 review 的边际成本。
二是与 CI/CD 深度集成,从「事后审查」变成「事前门禁」,在 merge 前自动阻断高风险变更。
三是多 Agent 协作从平行审查进化到交叉辩论,不同 Agent 对同一问题给出不同判断,最终由人类 review 做裁决。
当 AI 写代码的速度不再是瓶颈,真正卡住团队的永远是「谁来说这代码是对的」。这个答案正在从一个人变成一组 Agent。
参考文献
- Claude Code Review 官方文档
- 为 Claude Code 设置代码审查 | Anthropic Help Center
- 不止于终端:将Claude Code 的各种集成方式 - 知乎
- Claude Code Review:多 Agent 自动审查 PR - 腾讯云开发者社区
- 我用 Claude Code 做 Code Review,Bug 漏检率从 41% 降到 11% - 腾讯云
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师