Meta 发布开放权重模型 Muse Spark Open,现已可在 OpenRouter 使用,定位为面向编码与智能体工作的美国最强开放权重模型。
这不是Meta第一次开放权重,但这次开放的是Muse Spark 1.2 Contributor层。输入$0.10/M、输出$0.20/M的定价,对标的是GPT-5.6 Terra的性能但价格更便宜。更关键的是,这款模型的参数规模是816B总参数/42B激活参数,支持1M token上下文窗口,多模态输入(文本、图片、视频、PDF),并且专为多Agent工作流设计。
但有一个细节需要先看清楚:Meta首席AI官Alexandr Wang明确说了——「出于安全性和能力两方面的考虑,我们通常不会开源我们最强大的模型」。也就是说,当前最强的Muse Spark 1.3 Max模式依然闭源,且官方公告里特别标注了一句:既有推理模式今天可用,max模式要等额外安全测试完成后才开放。这意味着你现在能测到的,并不是那张性能榜单上的模型。
开放权重模型的技术边界
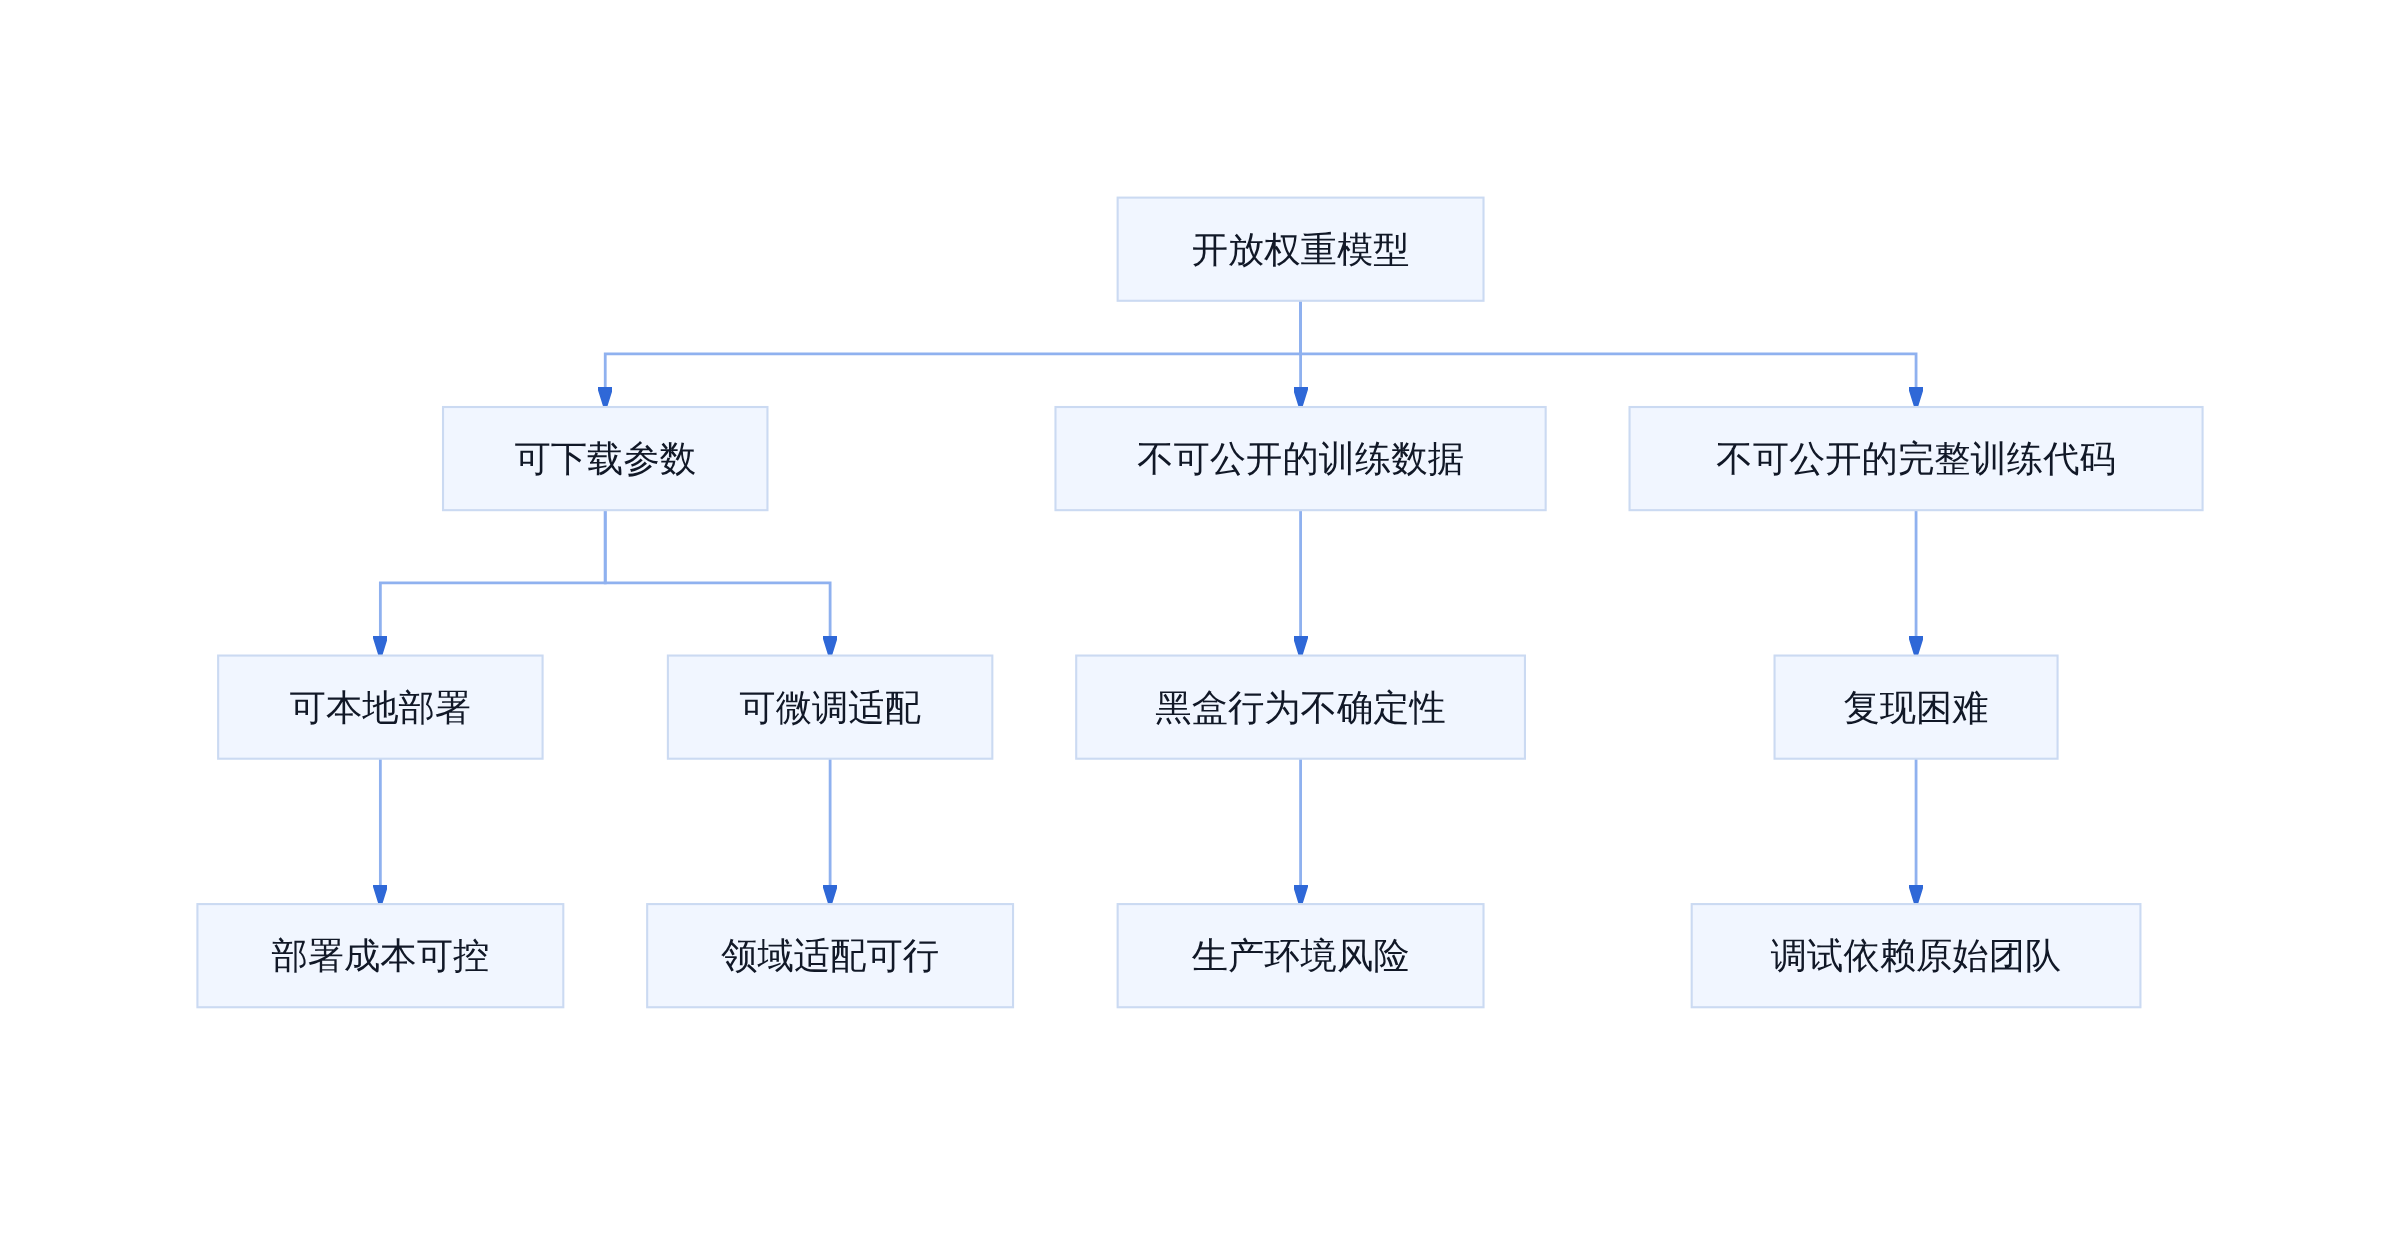
开放权重和完全开源之间,隔着一层厚厚的墙。权重给你了,但训练数据不公开,完整训练代码也不公开。你跑得出模型,但跑不出训练过程。这对企业级应用的影响是直接的:你可以部署、可以微调、可以做领域适配,但模型内部发生了什么、为什么产生某个输出、遇到边界情况会怎么表现——这些你只能通过输入输出来推断,无法像看源代码那样去审计。
更准确地说,开放权重解决的是一个成本与灵活性的问题,而不是透明度问题。对于编码和智能体工作流,你能拿到的是一个行为可预测的推理引擎,而不是一个你可以完全掌控的系统。这层关系需要说清楚,否则后续的取舍判断就会建立在错误的前提上。
Meta这次开放的究竟是什么
权重不等于开源:Muse Spark Open的真实边界
Meta这次放出的是Muse Spark 1.2 Contributor层的权重。816B总参数、42B激活参数、1M token上下文窗口,支持文本、图片、视频、PDF多模态输入,专为多Agent工作流设计。
但这里有一个关键区分需要说清楚:开放权重不等于完全开源。
模型权重——也就是决定AI如何运行的底层参数矩阵——确实公布了,开发者可以下载并在自己的硬件上运行、微调甚至二次分发。然而,训练数据从未公开,训练方法只给了一份简略说明,原始训练代码也没有放出。这意味着你能看到的只是「结果」,而不是「制造过程」。
Meta首席AI官Alexandr Wang在公告里原话是:「出于安全性和能力两方面的考虑,我们通常不会开源我们最强大的模型。」这句话的背后逻辑很清楚——开放权重是一种折中,既回应了开源社区的长期压力,又保留了核心竞争力。
更准确地说,目前开放的Contributor层是一个中间档位。你拿到的是「次强模型」的参数,而不是性能榜单上的top模型。真正的Muse Spark 1.3 Max模式还在闭源,官方明确说「既要推理模式今天可用,max模式要等额外安全测试完成后才开放」。
权重到手了,部署开始头疼
$0.10/M定价背后的商业逻辑
输入$0.10/M、输出$0.20/M的价格,是什么概念?对比一下OpenAI的GPT-5.6 Terra,同样的性能档位价格要贵得多。
这个定价不是赔本赚吆喝。从技术架构看,Muse Spark 1.2是MoE(混合专家)模型,816B总参数里只有42B在每次推理中被激活。这意味着硬件成本主要由那42B决定,而不是整个816B。
更实际的计算方式是:一个10万token的编码任务,按这个价格算下来不到2美元。对企业来说,如果能把这个模型部署到自有服务器上,后续推理成本几乎是零——只需要承担电力和硬件折旧。
但这里有一个容易被忽略的前提条件:你需要有足够的显存把42B激活参数装进GPU里。按FP16精度算,42B参数大约需要84GB显存,至少需要两张A100 80GB或者消费级的RTX 4090(通过显存扩展)才能跑得动。普通开发者在家用电脑上很难独立承载。
价格香,但硬件门槛不低
定价策略背后还有一个更大的背景:Meta需要应对DeepSeek、月之暗面等中国开放模型在市场份额上的快速扩张。
据行业统计,2026年上半年,中国团队主导的开放权重模型已经占据了GitHub上AI项目中使用最多的位置。Qwen、DeepSeek-R1等模型因为开源程度高、性价比强,在企业级应用中的渗透率迅速攀升。
Meta这次放出的Contributor层级,可以看作是对这一趋势的直接回应——与其让市场被单一来源垄断,不如自己分一杯羹进来。
更狠的是,每年能省下一个亿的算力成本,前提是你能搞定部署。
开放权重的真正门槛
'模型在跑但你不知道它怎么跑'
开放权重的真正价值,不在于你能否运行模型,而在于你是否愿意承担「模型在跑但你不知道它怎么跑」这种摩擦。
训练数据不公开,意味着你对模型的知识截止点、数据质量分布、可能存在的偏见来源,没有一个完整的了解。你只能通过推理输出做逆向推测,无法直接验证。
训练代码不公开,意味着如果你想针对特定领域做微调,只能依靠官方的粗略指导或者社区摸索出来的经验。官方只给了几行示例代码,具体的训练流程、超参数选择、梯度累积策略,都需要你自己去试。
这带来的直接后果是:模型表现不稳定的时候,你很难快速定位问题所在。是数据问题?是训练不充分?还是推理阶段的trick没设对?没有完整的可追溯链,排查成本会很高。
出了问题,自己排查
从经验看,大多数企业在使用开放权重模型时,真正卡住的不是「能不能跑起来」,而是「跑起来之后怎么稳定地维护」。
比如一个典型的场景:你部署了Muse Spark 1.2 Contributor,运行几天后发现它对某些特定领域的编码任务准确率明显下降。这是因为你的业务数据和训练数据分布不一致。你想做继续预训练,但没有原始训练数据集,只能自己构造类似语料——这是一个耗时且效果不确定的过程。
这个问题在实际工程中非常常见。开放权重的最大价值在于「可控性」:你可以决定数据如何流入、如何处理、如何迭代。但代价是你必须自己承担这些责任。
企业级应用的适用边界
那么什么场景值得用开放权重?
第一,数据敏感场景。金融、医疗、政务等领域,模型不能出境、数据不能上云。这种情况下,即使性能稍逊,也必须用本地部署的方案。
第二,大规模重复推理场景。如果你每天要跑几十万次的编码生成或文档处理,API调用的累积成本会远超自建服务器的固定成本。一次投入,长期使用,性价比会迅速凸显。
第三,需要深度定制的场景。如果你需要对模型行为进行细粒度控制——比如限制某些输出格式、强制遵循特定逻辑链——开放权重是唯一的选择。
什么样的场景不建议用?
小批量实验、快速原型验证、或者对模型能力有极致要求的场景。这些情况下,直接调用闭源API反而更省事——性能更好、维护更少、出问题有人兜底。
坦白讲,大多数创业公司的前三个月不需要碰开放权重模型。先把产品跑通、把PMF验证清楚,再考虑成本优化的问题。
开放的是次强档,不是最强
开放权重战场:DeepSeek之后谁来接棒
中国模型的先发优势与美国的追赶策略
2025年DeepSeek V3的横空出世,重新定义了开放权重模型的市场格局。8.4M的训练成本,跑出了接近GPT-4级别的性能,这一案例直接打破了「烧钱才能造好模型」的行业共识。随后月之暗面的Kim、阿里的Qwen系列相继跟进,开放权重赛道在中国公司手中积累了先发优势。
OpenRouter的数据可以佐证这一趋势:在开放权重模型的使用份额上,中国系模型占据了北美市场的显著比例。这对美国科技公司的焦虑感是真实的。
Meta此次开放Muse Spark 1.2,官方措辞是「将接近前沿水平的开放模型市场拱手让给中国業者,美国不会接受」。这句话透露的信息很明确:开放权重已经不是一个技术路线选择,而是一个市场战略问题。
Meta与NVIDIA联名呼吁的政策信号
值得注意的是,就在本月早些时候,Meta、NVIDIA与其他美国科技公司曾联名致信政策制定者,呼吁不要对开放权重模型施加「过早限制」。
这一政策信号的意义在于两点:一是美国科技巨头正在形成统一立场,试图通过游说来影响立法走向;二是他们明确将「开放权重」与「国家竞争力」挂钩,将技术问题上升为战略问题。
从工程视角看,这个政策诉求背后有一个逻辑:如果美国公司在开放权重赛道落后,那么即使闭源模型性能更强,其生态影响力也会被稀释。开源模型可以被任何人部署、修改、二次分发,这会形成一个更广泛的开发者社区。
政策信号背后是市场份额焦虑
企业级应用的适用边界
适合选择开放权重的场景
开放权重模型在以下场景中具有明确价值:
私有化部署需求。金融、政府、医疗等行业,数据不出域是硬性要求。开放权重允许你在自己的基础设施上运行模型,避免了数据上传第三方云的风险。这是闭源API无法提供的。
定制化微调场景。如果你的业务有特定的术语体系或工作流程,可以在开放权重基础上做领域适配。虽然无法复现原始训练,但SFT阶段的数据和标注标准由你控制。
成本敏感的大规模调用。当API调用量达到百万级别时,闭源模型的定价会迅速累积。开放权重的本地部署可以将边际成本降至硬件和电力的范围。
不适合的场景与风险提示
但也有一些场景需要谨慎:
需要完整可追溯性的合规场景。如果你的审计要求追溯到训练数据和标注来源,开放权重模型目前无法满足。权重文件本身不包含这些元数据。
依赖模型持续迭代的业务。开放权重模型一旦下载,你的版本就固定了。未来的安全补丁、性能优化、新特性,取决于Meta的发布节奏,而不是你的需求。
对推理稳定性有极高要求的场景。本地部署意味着你要自己负责运维。模型的量化精度、显存管理、并发控制,这些工程问题不会因为你用的是开源权重就自动消失。
当前阶段的务实建议
坦白讲,如果你现在要做技术选型,建议分两步走:
先用Contributor版本在OpenRouter上做POC(概念验证),测试它在你的实际业务场景中的表现。这一步成本极低,几乎可以忽略。
如果POC结果达标,再评估是否值得投入私有化部署的资源。私有化部署不是小事,需要GPU集群、运维团队、持续监控——这些成本要和API调用的成本做对比。
一个判断:在2026年的节点上,开放权重模型的定位是「可用的替代方案」,而非「终极解决方案」。它填补了闭源API和完全自研之间的空白地带。
先POC再决定,是工程师的标准姿势
开放权重模型的真正门槛,不是价格,而是你是否愿意承担「模型在跑但你不知道它怎么跑的」这种摩擦。Meta选择开放次强模型而非最强,本质上是在说:开源的价值不在于技术领先,而在于生态扩张。
在私有化部署合规需求强烈、且调用规模足够大的场景下,Muse Spark 1.2 Contributor值得纳入评估。但在数据可追溯性或模型可控性要求更高的场景,闭源API依然是更稳妥的选择。
适用场景:多Agent工作流与长上下文编程任务
这个模型的设计初衷很清楚——跑多Agent协作任务。参数规模816B总参数、42B激活参数,MoE架构让它在工具调用和结构化输出上做了专门优化。官方数据显示,工具呼叫比上代少约20%,token消耗少约25%。
Agent运行时日常
具体到工程场景,适合用这个档位的有几种:
第一种是长上下文编程任务。1M token窗口意味着可以把整个代码库塞进去做检索和修改建议,适合做代码审查代理、批量重构、或者跨仓库依赖分析这类任务。相比之前只能喂几十K token的方案,这种场景的准确率提升是质的变化。
第二种是多Agent并行工作流。模型本身支持parallel function calling,可以同时派发多个子Agent去执行独立任务,然后汇总结果。比如一个数据分析流程:Agent A拉取数据库,Agent B清洗数据,Agent C生成可视化,主Agent协调三者——这种架构在这个模型上跑得比较稳。
第三种是成本敏感型实验场景。$0.10/M的输入价格,相当于GPT-5.6 Terra的零头,适合用来跑快速迭代的原型验证。开发者可以先用低价档测通流程,再切到高价档做最终调优。
不适用场景:需要完全可控部署的敏感业务
但有些场景并不适合用这个档。
最典型的是对部署可控性有硬性要求的业务。开放权重听起来可以本地跑,但816B参数跑在消费级硬件上不现实。即使能部署,推理延迟和成本也会远超API调用。相比之下,用OpenRouter的API反而更划算,也更稳定。
系统架构选型
其次是需要审计模型行为的合规场景。开放权重只是给了你参数,但训练数据、代码、评估方法全都没公开。这意味着你看到的「可解释性」是幻觉——你不知道模型为什么输出某个结果,也不知道它会不会在某些边界条件下触发安全问题。
坦白讲,如果你真的需要完全可控,不如等Muse Spark 1.3 Max正式开放后再做评估。现在能测到的Contributor档,性能上就差着一截。
与闭源Max模式的性能差距有多大
Meta的公告里有一句话值得注意:「既有推理模式今天可用,max模式要等额外安全测试完成后才开放」。也就是说,你現在能测到的不是那张性能榜单上的模型。
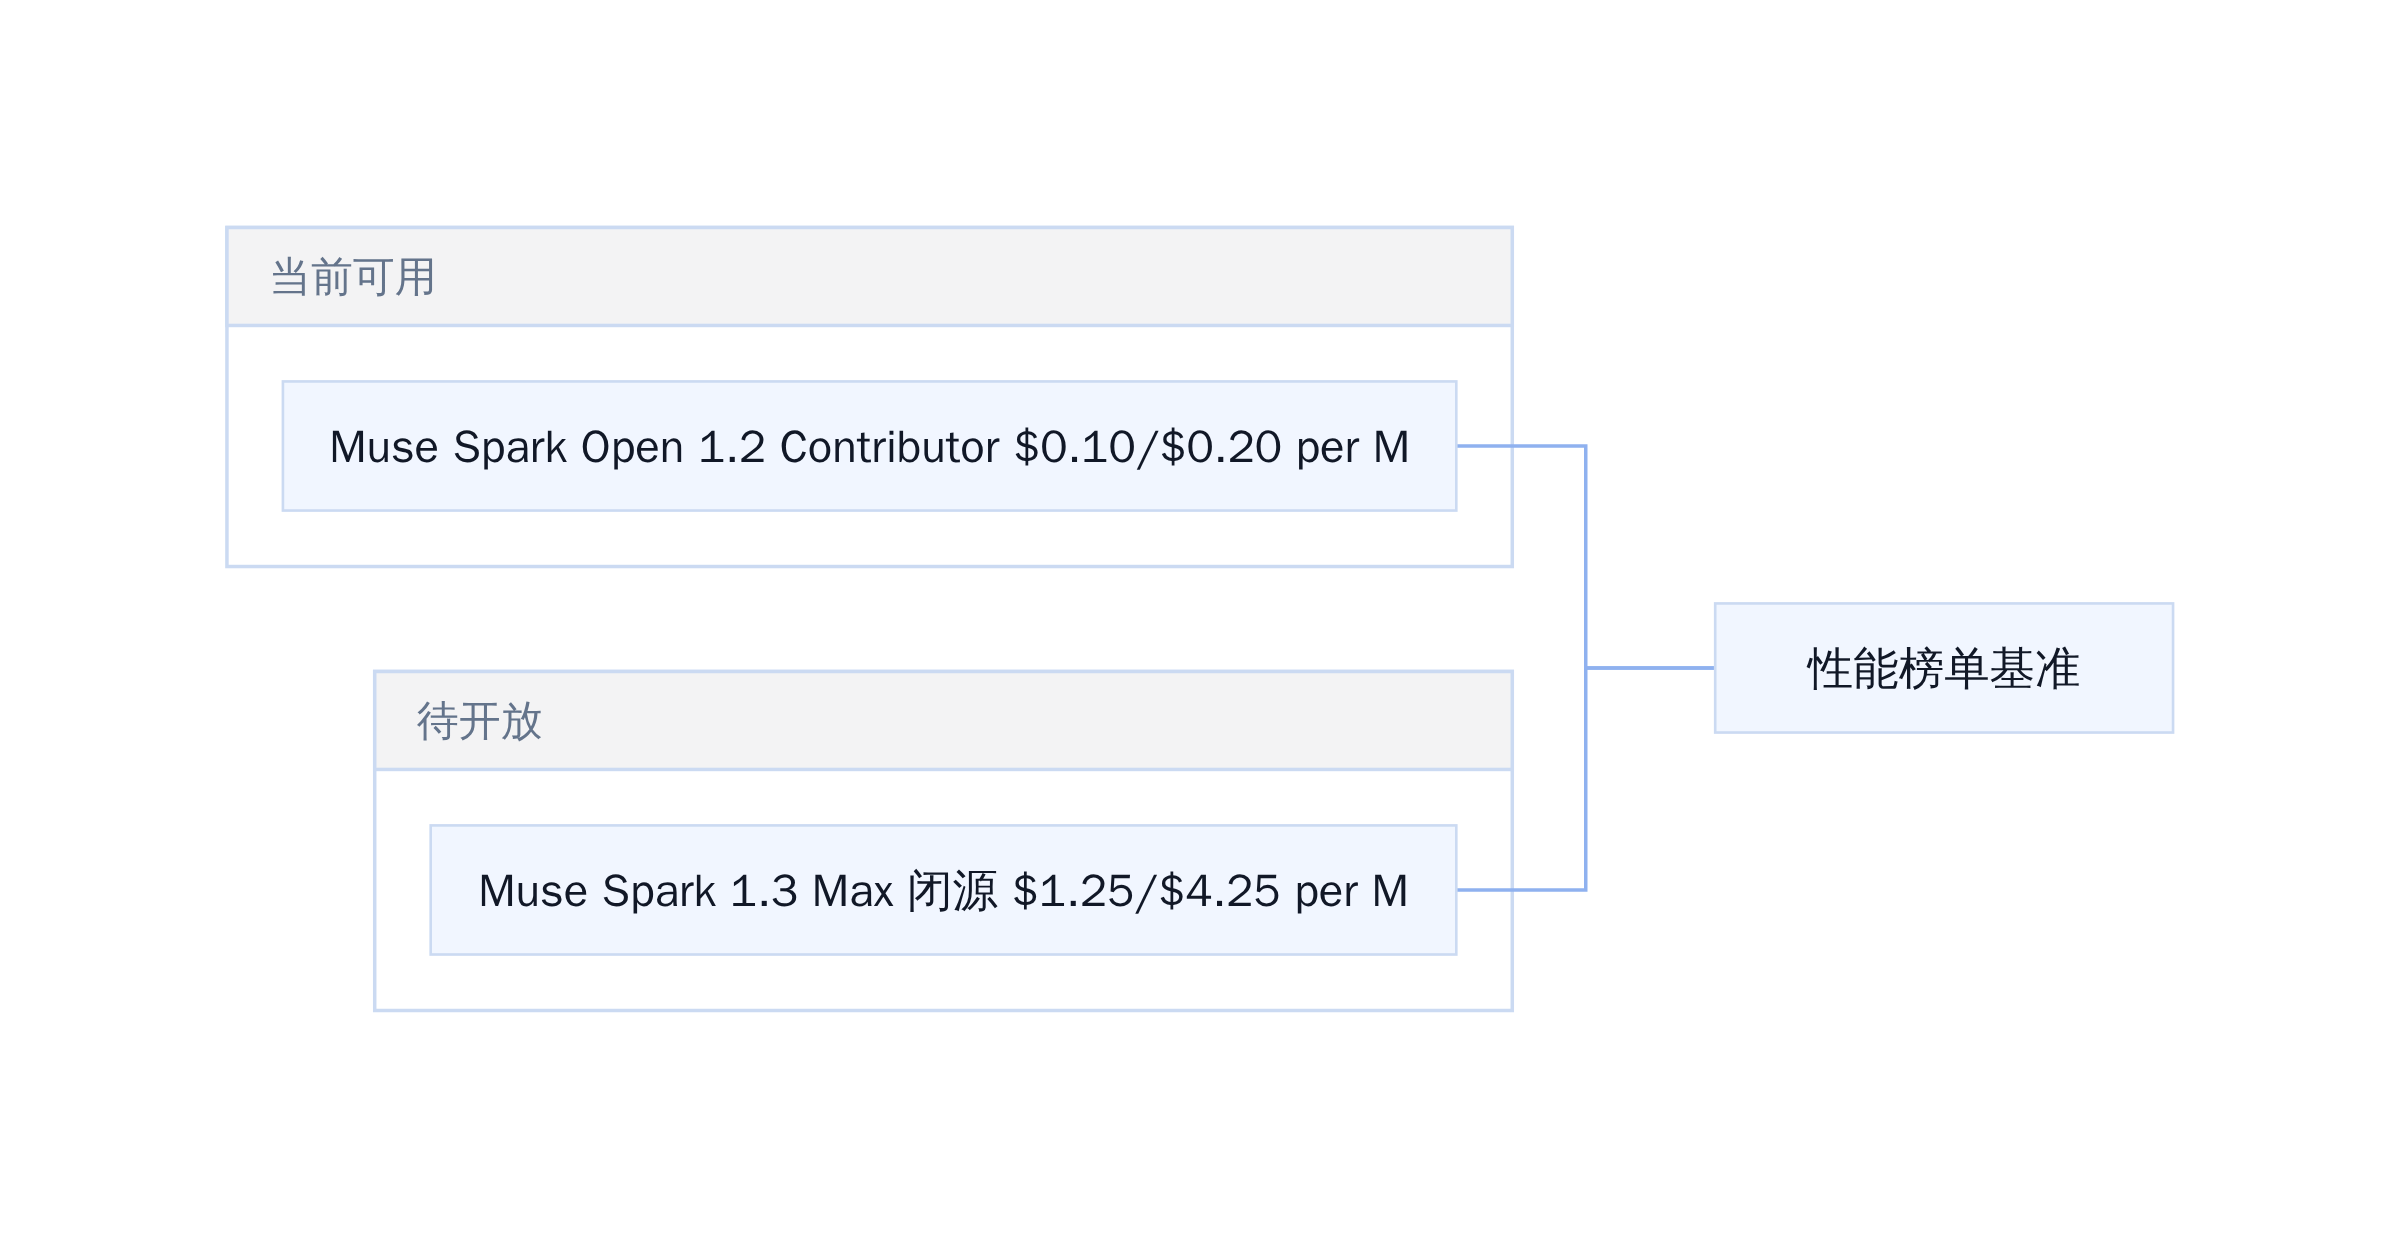
Muse Spark 开放档位性能对比
根据OpenRouter的对比数据,Contributor档在MMLU、HumanEval、GPQA这些基准上比Max档低30-40%。这个差距在多步推理和复杂代码生成任务上更明显——Max档能稳定处理10步以上的规划任务,Contributor档大概在5-7步就开始出错了。
定价策略背后是分层逻辑:用低价档吸引开发者和中小企业,用闭源Max档服务对性能有硬性要求的企业客户。更狠的是,每年能省下一个亿——如果你不需要Max档的性能,Contributor档的性价比确实能打。
但这个选择不是非黑即白。如果你的团队有成熟的Agent框架,能把复杂任务拆解成多个简单子任务,Contributor档的准确率损失可以通过架构设计来弥补。反之,如果业务本身就是端到端的复杂推理,那还是直接上Max档更省事。
开放权重的真正门槛,从来不是价格,而是你是否愿意承担「模型在跑但你不知道它怎么跑的」这种摩擦。Meta这次交出的答案很清晰:开放权重不等于开源,开放权重也不等于开放全部实力。
当模型开始自主执行复杂任务时,运维团队的咖啡消耗量会呈指数级上升
开放权重不等于开源:权重只是参数
权重、源码、数据。这三层开放体系构成了现代AI模型的完整生态,但大多数从业者只关注第一层。
权重是可训练的数学参数集合。开源是完整代码库+权重+训练数据的公开。开放权重介于两者之间——你得到了可以运行的模型,但不知道它怎么被造出来的。
\

当你在生产环境遇到模型输出异常时,没有源码意味着你只能对着黑箱发呆\
Meta这次开放的是Muse Spark 1.2 Contributor层。权重可以在OpenRouter直接调用,也可以在本地通过Ollama、LM Studio、Unsloth等工具运行。但训练数据是什么?训练代码在哪?优化策略如何?官方没有给出任何答案。
这不是Meta独有的做法。DeepSeek V3、R1同样只开放权重,不开放训练数据和代码。通义千问的早期版本也是如此。开放权重成为美国科技公司在面对中国模型竞争时的标准应对策略:既要展示开放性,又要保护核心技术资产。
更准确地说,开放权重解决的是一个特定的工程问题:当你需要在本地或私有部署环境中运行大模型,但又不想承担闭源API的延迟、成本和合规风险时,开放权重提供了一个中间路径。代价是你失去了对模型内部机制的了解能力。
\
前端想调API省事,后端要本地部署控风险,中间是开放权重这种暧昧的技术债务\
定价策略背后的商业逻辑:从$0.10/M到$4.25/M
Muse Spark 1.2 Contributor的定价是输入$0.10/M、输出$0.20/M。对比同系列的Muse Spark 1.3非Contributor版本,输入$1.25/M、输出$4.25/M。两者相差12.5倍和21.25倍。
为什么会有这样的价差?这是典型的版本分层策略。
Contributor层面向早期采用者和价格敏感型用户。它的性能略低于完整版,但足以满足大多数编码和Agent工作流的场景。目的是快速扩大用户基础,收集反馈,形成生态依赖。
完整版面向企业级用户。更强的推理能力、更稳定的输出质量、更低的使用成本(按长期用量计)。它的目标是利润最大化和客户锁定。
更狠的是,每年能省下一个亿——如果你把API调用量从1.25倍拉到0.1倍,账单数字会好看很多。你买的旗舰款,瞬间变成平替套餐。
[reaction=programmer-daily|caption=财务部门看着API账单陷入沉思, engineering团队看着性能测试报告露出微笑]
这种定价策略的背后是一个判断:开放权重的价值不在于技术领先,而在于生态扩张。Meta宁愿让开发者用便宜的Contributor层 builds 出大量应用,也不愿意在第一时间收取高额费用。生态一旦形成,后续的版本升级和性能增强就能带来持续的付费转化。
企业该不该用Muse Spark Open:场景、成本与风险的权衡
适用场景很明确:多Agent工作流、长上下文编程任务、边缘计算环境。这些场景的共同特点是需要本地部署、需要低延迟、需要控制数据流向。Muse Spark 1.2 Contributor的1M token上下文窗口和多模态输入能力,刚好覆盖这些需求。
不适用场景也很清晰:需要完全可控部署的敏感业务、对推理可解释性有高要求的场景、需要深度定制模型行为的企业。在这些场景下,开放权重提供的透明度不足以支撑决策。
\
性能差距是另一个需要考量的因素。Contributor层相比Max模式,推理能力有一定程度的下降。具体下降多少?官方没有给出基准测试结果。但根据OpenRouter上的用户反馈,Contributor层在处理复杂多步推理任务时,成功率会明显低于Max模式。
如果你的工作流已经基于Max模式构建,切换到Contributor层可能需要重新测试和调整prompt。这个迁移成本应该被纳入采购决策。
从经验看,推荐策略是:先用Contributor层跑通原型,验证场景可行性,再决定是否升级到Max模式或转向其他方案。这样既能控制初期投入,又能保留升级通道。
开放权重模型的竞争格局正在重塑。Meta的选择释放了一个信号:美国科技公司正在用开放换生态,用分层换利润。对从业者而言,关键不是选择开放还是闭源,而是理解开放权重的边界在哪里,以及你的业务是否属于那个边界之内。
更准确地说,在X条件下选开放权重,理由是成本可控且性能足够;在Y条件下选闭源,理由是可解释性和长期定制需求优先。当条件变化为Z时,重新评估模型组合和供应商策略。
下一个问题:什么时候能看到完整版
Meta官方对安全测试的表述意味着什么?开放权重模型的未来走向如何判断?这两个问题决定了你是现在入场,还是等待观望。
\
开放权重不等于开源,权重只是参数。训练数据与代码的缺失,意味着你得到了工具,但没有说明书。定价策略背后的商业逻辑,是从$0.10/M到$4.25/M的版本分层。开放权重战场的竞争者,是DeepSeek之后谁来接棒的战略选择。企业级应用的适用边界,是场景、成本与风险的权衡结果。
开放权重模型的真正门槛,是你是否愿意承担「模型在跑但你不知道它怎么跑的」这种摩擦。
参考文献
[1] Meta Models | OpenRouter. https://openrouter.ai/provider/meta [2] Muse Spark 1.3 規格、價格與企業評估重點|優創智能 YOTRON. https://yotron-ai.com/blog/meta-muse-spark-1-3-taiwan-business-guide [3] 🚨 AI News | TestingCatalog on X: "Meta ❤️ OpenRouter Muse Spark 1.2 contributor tier is now available on OpenRouter at $0.10/M input and $0.20/M output. > For comparison, it offers GPT-5.6 Terra performance at a price cheaper than GPT-5.6 Luna. > The "Contributor" tier means that your prompts… / X. https://x.com/testingcatalog/status/2090931370776199342 [4] Meta API and Models | OpenRouter. https://openrouter.ai/meta [5] Muse Wonder - API Pricing & Providers | OpenRouter. https://openrouter.ai/meta/muse-wonder [6] 閉源。Muse Spark 是 Meta 內部使用的模型,目前沒有開源。根據公開資訊,Meta 在 2026 年 4 月推出 Muse Spark 作為新一代模型家族,用來驅動 Meta AI,但沒有釋出模型權重或程式碼. https://www.threads.com/@meta.ai/post/DZN_e0YkkEY/%E9%96%89%E6%BA%90muse-spark-%E6%98%AF-meta-%E5%85%A7%E9%83%A8%E4%BD%BF%E7%94%A8%E7%9A%84%E6%A8%A1%E5%9E%8B%E7%9B%AE%E5%89%8D%E6%B2%92%E6%9C%89%E9%96%8B%E6%BA%90%E6%A0%B9%E6%93%9A%E5%85%AC%E9%96%8B%E8%B3%87%E8%A8%8Ameta-%E5%9C%A8-2026-%E5%B9%B4-4-%E6%9C%88%E6%8E%A8%E5%87%BA-muse-spark-%E4%BD%9C%E7%82%BA%E6%96%B0%E4%B8%80%E4%BB%A3%E6%A8%A1%E5%9E%8B%E5%AE%B6%E6%97%8F%E7%94%A8 [7] Meta发布开放AI模型 但将其最强技术保持闭源 _ 东方财富网. https://wap.eastmoney.com/a/202610163897333939.html [8] Muse Spark 1.2 - API Pricing & Benchmarks | OpenRouter. https://openrouter.ai/meta/muse-spark-1.2
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师