事件与质疑:Anthropic 的公告与 Lambert 的回应
Anthropic 近期在安全博客发布了一份报告,指出其在 Claude 产品的 API 端点发现了一次协调性的对抗蒸馏活动,涉事用户超过 15000 人,占 Console 用户总数的约 1.4%。OpenAI 同步披露了一起类似事件,涉及超过 4000 名用户使用特定提示词模式提取推理链内容,活动量在 7 月 24 日至 25 日急剧上升,共发出约 16000 次请求。两家实验室的动作高度同步,随后 Google DeepMind 也跟进处理,形成了罕见的三方联动。
消息发出后,艾伦人工智能研究所(AI2)后训练团队负责人 Nathan Lambert 在其 Substack 专栏《Interconnects》发布了一篇名为《The Distillation Panic》的分析文章。Lambert 并非圈外人——他的 RLHF 专著是当前业内广泛使用的参考教材之一,长期深耕模型后训练领域。他的核心判断是:Anthropic 在报告中描述的违规行为,严格来说并不构成蒸馏,而是一种窃取私有推理内容的 API 滥用行为。
「他们确实在做一件坏事。」Lambert 写道,「但把他们做的事叫做蒸馏,这是一个很差的选择。」
有人试图给所有问题贴同一张标签
这个问题不只是语义洁癖。当一家头部实验室把自己的安全事件定义为某种通用攻击时,整个行业会跟着这个词走——研究人员会用这个词搜索文献,监管者会参考这个词制定规则,竞争对手会顺着这个词理解威胁。用错了一个词,后续所有的分析和对策都可能偏移方向。
什么是「蒸馏」:一个被用错的术语
蒸馏(Distillation)在机器学习中的原始含义,是指利用一个高性能教师的输出来训练一个更小、更便宜的模型。具体做法是把教师的输出概率分布(logits)作为训练目标,让学生的模型在输出分布上模仿教师。这在业界已经被广泛使用了十多年,从 GPT-4 蒸馏出更小的版本供终端用户使用,到各大开源社区利用闭源 API 的输出数据增强小模型能力,蒸馏是一条成熟且透明的技术路线。
蒸馏的核心特征是:数据合法获取,模型公开训练,结果是产出更小、更快的替代模型。整个过程没有任何秘密操作。
而 Anthropic 在公告中描述的是一种完全不同的行为——攻击者通过提示词工程,诱导 Claude 输出被加密的推理链内容,然后在另一段对话中要求模型解密并转录那些隐藏的推理内容。这本质上是一种对抗性提取(adversarial extraction),目的是绕过访问控制,获取本应只存在于推理过程内部的中间结果。
把盗窃描述成「借用」,听上去合理吗?
两者之间的区别很明确:蒸馏是在光明正大地使用 API 的输出;对抗性提取是在偷偷摸摸地绕过 API 的安全边界。前者是一个标准的模型压缩技术,后者是一个安全事件。把它们混为一谈,相当于把撬锁进屋和小偷在门口喊了一句「借个火」归为同一类事情。
Anthropic 的官方博客标题用了「Distillation Attack」这个词,但在报告的正文中也承认了这是一种「对抗性蒸馏」(adversarial distillation)。问题在于,一旦这个词进入公共讨论,后续的传播往往只保留了最醒目的那个标签。Lambert 的担忧是:当所有人都开始用「蒸馏攻击」来描述这些安全事件时,真正的蒸馏技术反而会被污名化,而真正需要被关注的 API 安全问题,可能因为被归类为「蒸馏」而被误读。
真正的攻击:为什么是 API 密钥,不是蒸馏
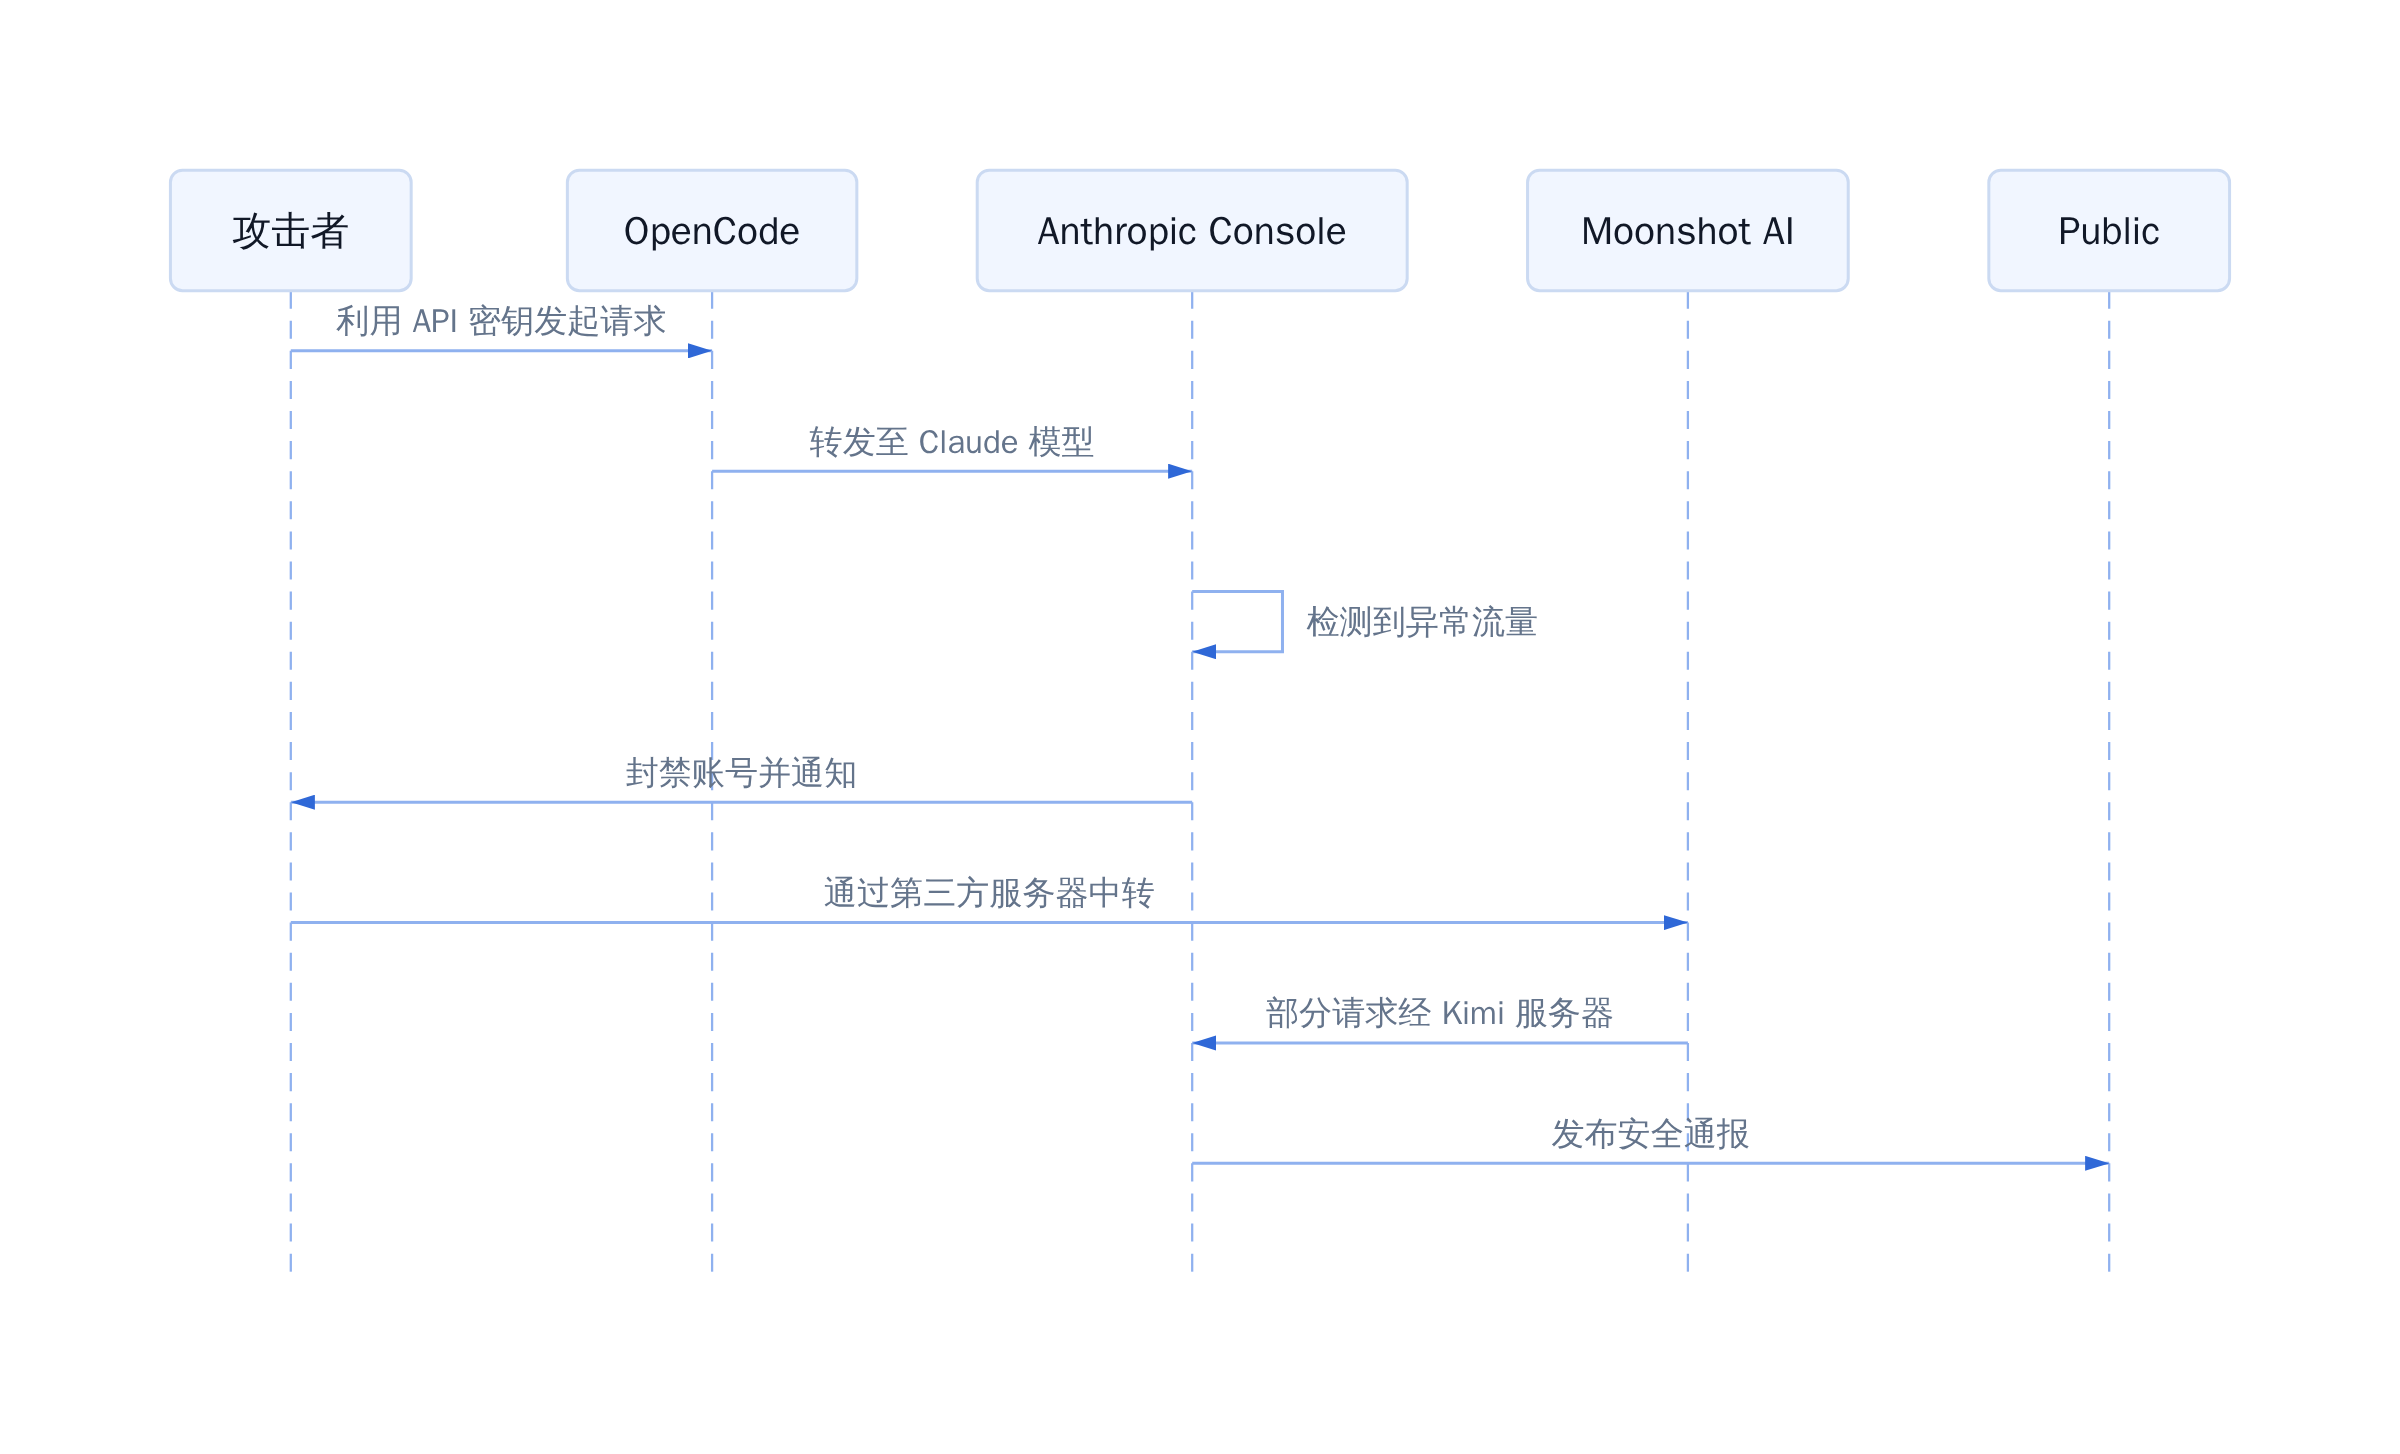
从技术层面看,这次事件的核心漏洞不在于蒸馏本身,而在于 API 的访问控制被绕过了。具体来说,攻击者利用了 OpenCode 这类开源编程代理工具,通过自动化的脚本批量调用 Claude API,并在对话中注入特殊的提示词,触发模型的推理链泄露。
[攻击流程图]
[攻击流程 mermaid]
这个过程的第一步是利用 API 密钥获取合法的接口访问权限。只要拥有有效的 API 密钥,任何人都可以向 Claude 发送请求,这是 API 服务的基本设计。问题出在第二步——通过精心构造的提示词,攻击者诱导模型在推理过程中输出内部的状态信息,这些信息通常不应该被暴露给用户。
当你的代码在问模型:你能看到什么
这与我们平时讨论的蒸馏有本质区别。蒸馏的前提是你已经在正常使用 API,你的请求是合规的,你只是想基于这些合规的输出来训练一个小模型。而这次事件中的攻击者,是在利用 API 的边界漏洞,把一次普通的问答变成了一种信息提取工具。
更具体地说,攻击者采用的方法叫做「推理链提取」(reasoning trace extraction)。模型在推理时会生成一系列中间步骤,这些步骤通常被包含在响应中但处于一个隐藏状态。攻击者通过特定的提示词序列,让这些隐藏的步骤被重新暴露出来,并以可读的形式输出。这一步是关键的突破口——一旦推理过程被完整提取,攻击者就获得了比正常 API 输出更丰富的数据。
这就是为什么 Lambert 认为这更像是一种网络入侵,而不是蒸馏。入侵的本质是未经授权地获取信息;蒸馏的本质是利用合法授权的数据来训练模型。两者的分界线在于:你是否在授权范围内使用 API,以及你获取的数据类型是否在授权范围内。
中国模型服务器:为何集中在此?
在讨论攻击手法之前,还有一个细节值得关注:被攻击的目标模型主要来自中国的供应商。这不是 Lambert 独有的观察,也是多家安全研究机构的共识。据多方消息,此次事件中涉及的大量流量被指向了面向国际用户的模型转发服务,而这些服务背后的模型主要来自中国的开源或半开源项目。
转发站是什么?就是一个替别人扛流量的中间层
模型转发站(model proxy/relay)是一种基础设施,它接收来自用户的请求,将其转发给后端的模型 API,再把响应返回给用户。这种架构在开源模型社区中非常常见——许多开源模型并没有自己的官方全球 API,开发者需要通过第三方中转来实现多地区访问。问题在于,这些中转服务的安全性往往参差不齐。
一方面,中转服务本身可能缺乏足够的安全审计;另一方面,攻击者可以利用中转服务的配置缺陷,批量发起请求而不触发目标模型的防护机制。换句话说,中转服务成了一个放大器——它让攻击者可以用更低的成本,触达更多不同平台的模型。
Lambert 在文章中提到了这一点:「把中国开源模型的合规使用和恶意攻击混为一谈,是不公平的。」这句话有两层含义。其一,中国模型的开源生态确实存在被滥用的风险——任何开源模型都可能被用来做这件事;其二,将所有涉及中国模型的流量都贴上「蒸馏攻击」的标签,可能导致对中国开源模型的过度审查。
这不是在为攻击者开脱。攻击就是攻击,无论它指向哪个模型。但问题的关键在于,我们应该用什么框架来理解这些攻击——是安全漏洞框架,还是蒸馏竞争框架?前者要求我们修复 API 的边界问题,后者可能引导我们去限制某些模型的可用性。
规模之谜:1.4% 到底代表什么
另一个悬而未决的问题是数字本身。1.4% 的 Console 用户,听起来是一个不小的比例。但如果我们把这个数字放到更大的背景里,它的意义会变得模糊。
Anthropic 的 Claude Console 有数百万活跃开发者用户,1.4% 换算下来大约是几万人。OpenAI 的报告提到超过 4000 名用户参与,约 16000 次请求。这些数字背后有几个问题:这些用户是重复使用的同一批人,还是各自独立的操作?每次请求的耗时和费用是多少?实际提取了多少推理链数据?这些数据目前都没有公开。
数字很大,但具体是多少,没人说清楚
更值得追问的是:为什么这些流量会这么大?如果这些用户真的是在批量进行蒸馏,他们需要具备足够的计算能力和存储能力来处理这些数据。按照 Lambert 的估计,一次完整的对抗性蒸馏需要大量的推理 token,而每个推理 token 的成本远高于普通对话 token。
一个具体的数字可以说明问题:假设一个用户用 Claude 3.5 Sonnet 提取了 10 万推理 token,按照当前定价,单次请求的费用可能在 5 到 10 美元之间。如果 4000 个用户都这样做,光是 API 调用费用就可能达到数万美元。对于有组织的攻击来说,这个成本是可接受的;但对于普通开发者来说,这个成本是不合理的。
这引出了一个更深层的问题:如果这些人真的是在做蒸馏,他们为什么要用这么昂贵的 API?为什么不直接用已经公开的开源模型?答案可能是:他们需要的不是蒸馏出一个替代模型,而是想获得特定模型的推理能力——而这恰好是蒸馏的目的之一。但这个目的,与窃取 API 密钥的行为,仍然是两件不同的事。
结论:术语准确,防御才有效
这起事件的核心矛盾不在于「有没有人在做坏事」,而在于「我们用哪个词来描述这件事」。Anthropic 选择用「蒸馏攻击」这个标签,是因为这个词更容易引起公众关注——它听起来像是技术竞争,而不是安全漏洞。但从技术角度看,这件事更接近 API 滥用和网络入侵,而不是蒸馏。
Lambert 的批评有一个明确的落点:如果你把一个安全事件称为蒸馏攻击,读者会以为这是蒸馏技术的风险;如果你把它称为 API 滥用,读者会以为这是访问控制的问题。前者导向的策略是限制谁可以用蒸馏,后者导向的策略是加强 API 的安全审计。
这两条路线并不完全对立,但它们指向不同的优先级。当前的现实是:Anthropic、OpenAI 和 Google 都加强了 API 的访问控制和推理链的隐私保护,这是正确的方向。与此同时,开源社区也在反思模型转发服务的安全架构,这是另一个正确的方向。
术语准确意味着防御有效。把 API 密钥被盗称为蒸馏,就像把入室盗窃称为「借住」。房间确实被进了,人确实进去了,但「借住」这个说法会让我们忽略门锁的问题。在这个事件里,门锁的问题是实打实的——它关系到哪些人可以访问你的 API,以及他们能看到什么。把这个门锁修好,比争论这个行为应该叫什么名字更重要。
坦白讲,Lambert 的批评有一个容易被忽视的贡献:他让所有人停下来重新审视一个被反复使用的词。当「蒸馏」开始被用来描述任何涉及模型数据转移的行为时,这个词就失去了意义。而失去意义的词,最终会让整个行业的讨论变得不准确。一个被用错的词,比一个没被发现的漏洞更难修复。
Nathan Lambert 质疑 OpenCode 事件中蒸馏
他是谁,为什么他的话值得听
Nathan Lambert 是 Allen AI 研究所的后训练团队负责人,伯克利博士出身,师从 Pieter Abbeel。他不是 RLHF 的发明者,但他写的《RLHF》开源书籍已经是行业标准参考之一。更重要的是,他是真正亲手训练过大模型的人。
在 Anthropic 博客发布当天,他就发文《蒸馏对于中国大模型到底有多重要?》,核心观点与主流叙事截然不同。
核心论点:「蒸馏」被用错了地方
Anthropic 将部分中国大模型厂商的违规行为称为「蒸馏攻击」。Lambert 认为这是极度糟糕的用词。
蒸馏是利用强大模型的输出数据训练较小模型的行业标准技术。从马斯克的 xAI 到各类欧美初创公司,大量企业和研究机构都在利用闭源 API 进行蒸馏,这本身就是灰色地带。
涉事厂商的真实违规行为是越权破解(Jailbreaking)和 API 滥用——窃取官方未公开的推理过程。这不是蒸馏行为本身。
更狠的是,术语一旦混乱,防御方向就会跑偏。
真正的攻击:API 密钥窃取,不是蒸馏
根据 Panfilov 等人 2026 年的研究,真正的攻击手法是跨模型和跨对话上下文的推理内容提取。攻击者从一段对话复制已加密的推理内容,再在另一段对话中要求模型解密并转录其中隐藏的内容。
这是 API 密钥的非法使用,是网络攻击。把它归入蒸馏,是把两件事混为一谈。
OpenAI 自己的通报也印证了这一点:他们发现行动者尝试提取受保护的推理内容,独立安全研究人员通过负责任披露通报了跨模型及对话上下文压缩漏洞。
Anthropic 将此事归因于与 Kimi 开发商 Moonshot AI 有关联的人士,但 Lambert 指出,把这件事定义为蒸馏,会让真正的安全问题被稀释在技术术语的争论里。
「蒸馏」到底是什么
蒸馏:把强模型的知识灌输给弱模型
蒸馏(Distillation)是深度学习里一种后训练技术,具体做法是用一个更大、更强的模型的输出数据,来训练一个更小、成本更低的模型。它的本质不是窃取权重,而是用强模型的推理结果作为训练信号,让弱模型学会模仿其分布和模式。
Anthropic 自己的产品就在使用蒸馏。Claude 有多个版本,从小模型到大模型,内部就有蒸馏过程——用 Claude 3 Opus 的输出训练 Claude 3 Sonnet,用 Opus 的推理轨迹指导 Sonnet 的学习方向。这不是什么灰色地带,这是行业标准做法,几乎每个前沿实验室都在做。
更准确地说,蒸馏有两种合法形式:一种是把旗舰模型的能力迁移到轻量版本,让用户以更低成本获得接近旗舰的体验;另一种是在推理时使用教师模型的 logits 或推理轨迹(reasoning traces)来指导学生模型训练,这在最近一年成为性能提升的重要手段。
Lambert 在 Substack 上的帖子直接指出了关键点:中国实验室并没有在 RL 阶段用 Fable 或最强的 Anthropic 模型作为教师,这种说法对蒸馏机制本身存在误解。
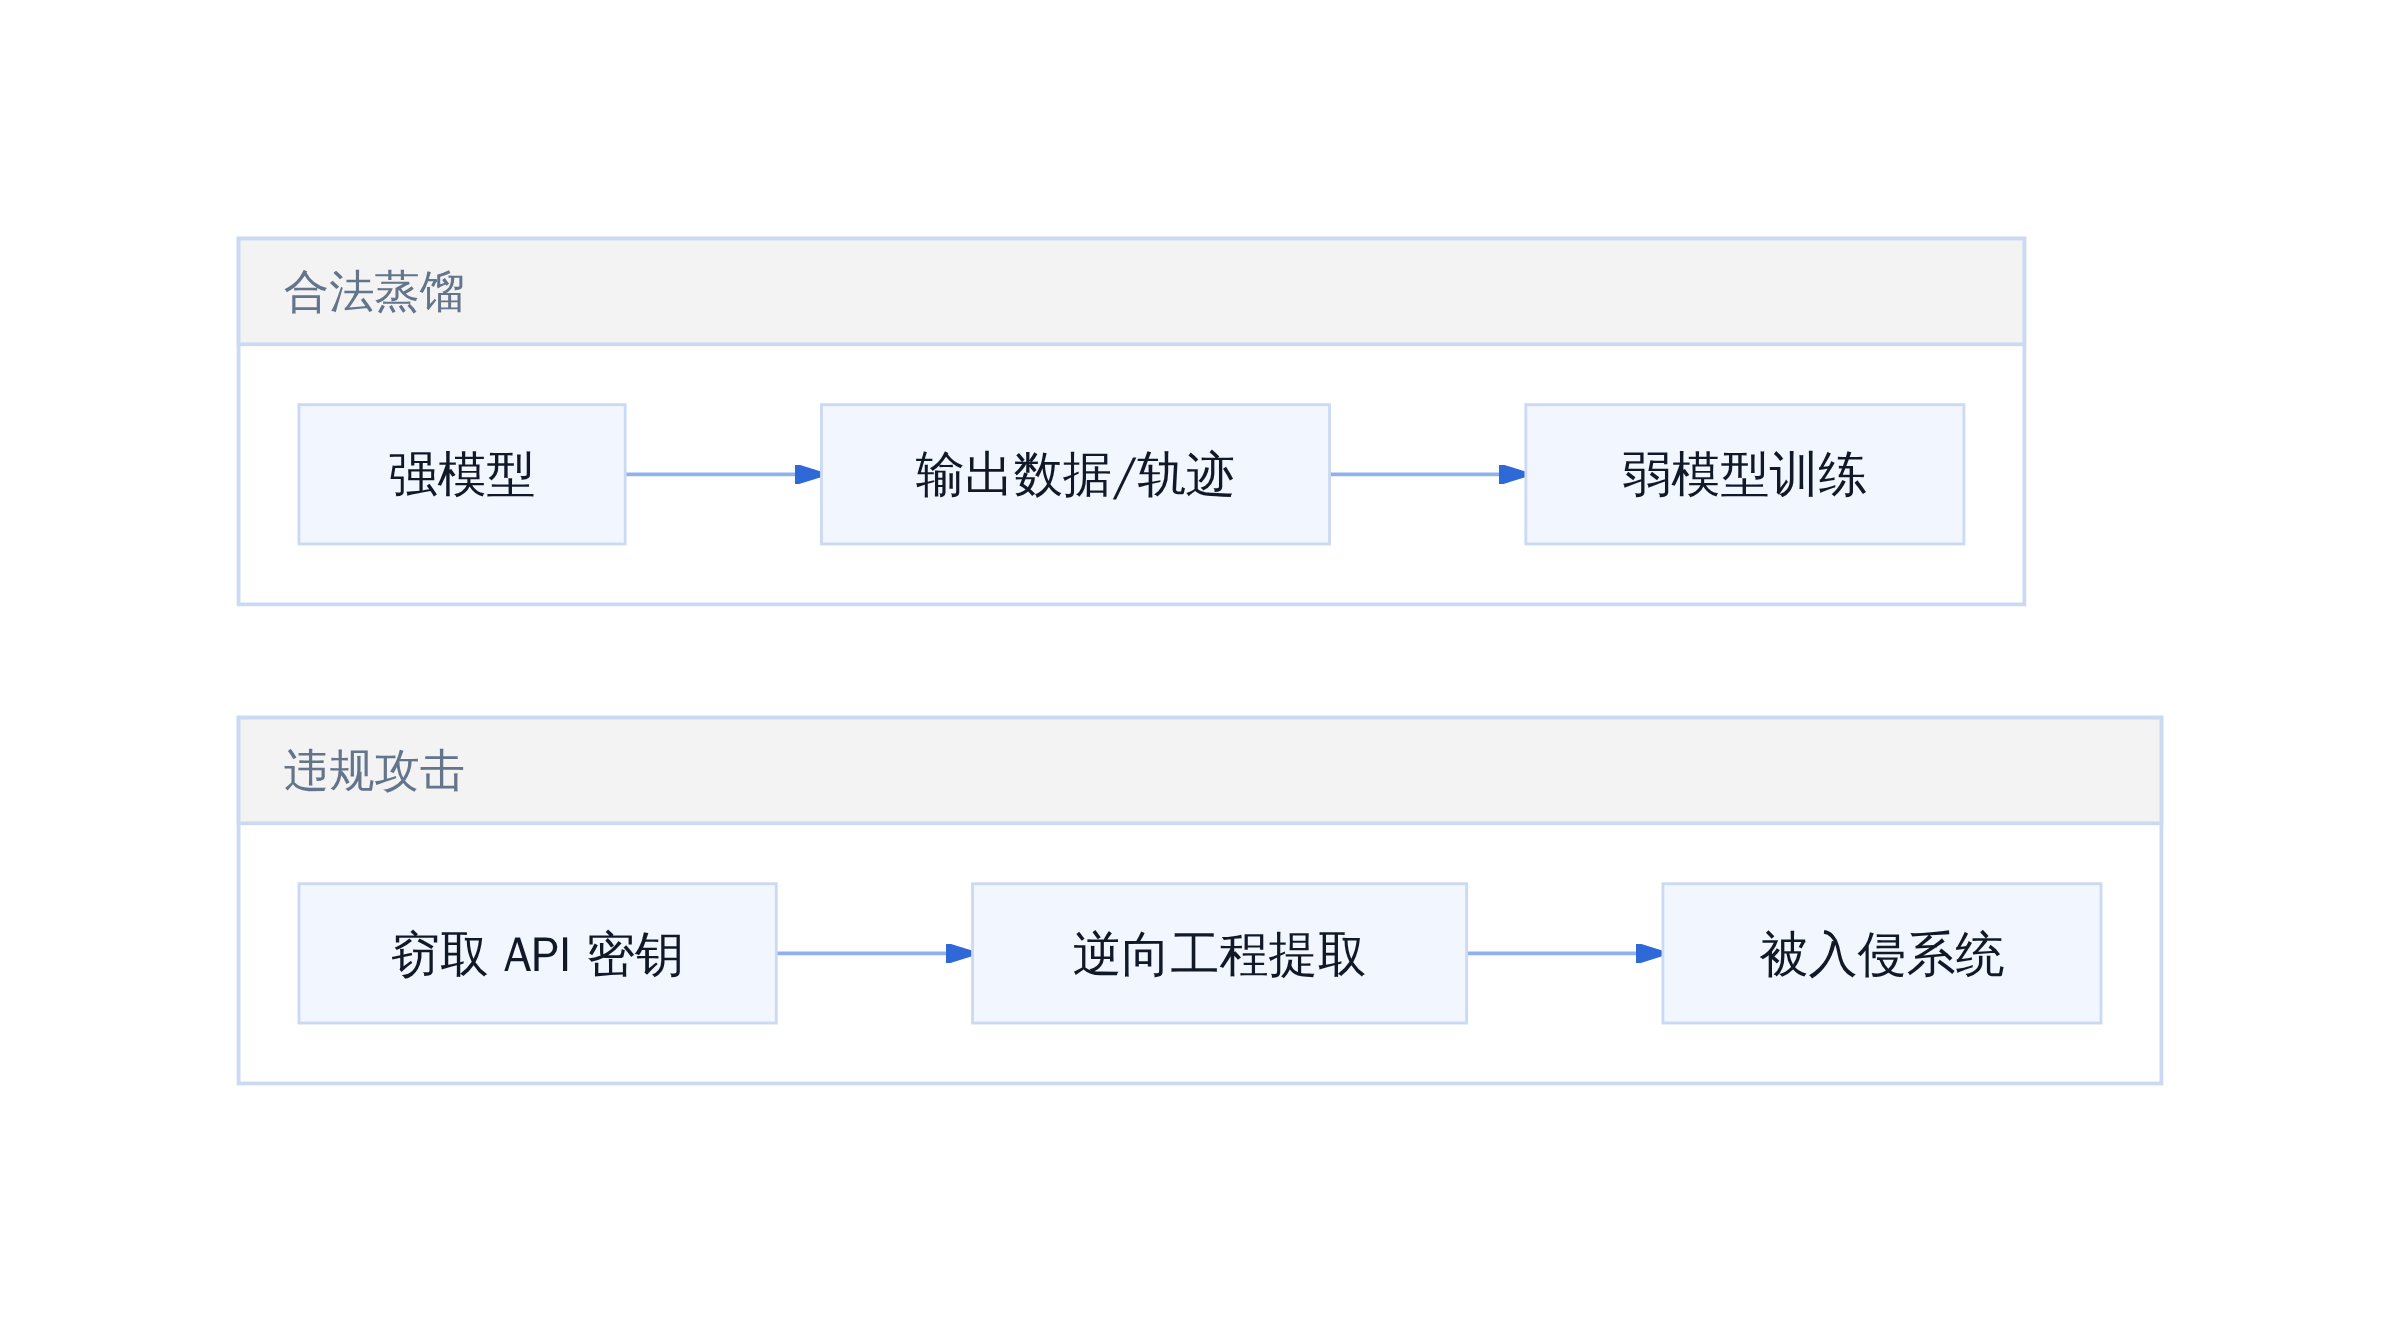
蒸馏的正确路径 VS 违规路径
真正的攻击是什么
他们偷的不是知识,是钥匙
OpenCode 事件中,攻击者做的不是蒸馏。他们做的是 API 密钥窃取。具体手法包括:通过社会工程学或漏洞利用获取 Claude Console 的访问凭证,然后以合法用户的身份发起请求,批量提取模型的推理过程和内部状态。这是一种网络攻击,不是模型训练技术。
Anthropic 在 OpenAI 的安全报告中看到了类似的对抗性蒸馏手法:攻击者尝试提取受保护的推理内容,包括从一段对话复制已加密的推理内容,再于另一段对话中要求模型解密并转录其中隐藏的推理内容。这些是跨模型和跨对话上下文的压缩漏洞利用。
更值得关注的是,OpenAI 的报告提到一组核心活动与 Kimi 开发商 Moonshot AI 有关联。Moonshot AI 是中国领先的闭源模型提供商之一,Kimi 系列模型在国内有大量用户。如果 Moonshot AI 的员工或合作方确实参与了此类活动,那问题的核心不是蒸馏,而是企业内部人员被利用或主动参与窃取。
OpenCode 事件时间线
为什么这个词很重要
[[reaction=code-review-pain|caption=术语混淆,后果是真实的]]
把 API 密钥窃取称为「蒸馏攻击」,不只是语义上的不准确,它会产生两个实际后果。
第一个后果是污名化一项核心技术。蒸馏本身是公开的、合法的、广泛使用的训练方法。任何把闭源模型的输出用于训练开源自模型的行为,在技术上都可以被描述为某种形式的蒸馏。如果「蒸馏攻击」成为一个法律或政策术语,那么无数合法的开源社区研究、教育机构的教学活动、甚至美国本土的初创公司利用 Anthropic API 训练自己模型的行为,都可能被卷入同样的审查范围。
第二个后果是监管过度。Lambert 在文章中明确警告:过度监管可能反噬美国本土的开源生态。他说,从马斯克的 xAI 到各类欧美初创公司,大量企业和研究机构都处于利用闭源 API 进行蒸馏的灰色地带中。如果监管者因为这次事件开始收紧 API 访问权限、要求企业级协议才能使用模型、甚至立法限制训练数据的来源,那么最先受影响的不是中国实验室,而是美国的开源社区和中小团队。
坦白讲,Lambert 的判断有一个明确的边界:他不是在为违规行为辩护,而是在强调术语的准确性。蒸馏是好东西,被滥用的人才是问题。混淆二者,会让我们失去区分合法创新和恶意窃取的能力。
参考文献
- The distillation panic - by Nathan Lambert
- 阻止有組織的模型蒸餾行動 - OpenAI
- Panfilov et al. 2026: Stealing Reasoning Traces from Proprietary LLM APIs
- 让 Anthropic 破防的「蒸馏」风波,Nathan Lambert 泼冷水 - 凤凰网
- How distillation is used today and what performance uplift it gives - Nathan Lambert Substack 这句话说完了,但背后的争议还没结束。把一次有组织的 API 密钥窃取行动命名为「蒸馏攻击」,听起来像是术语选择,实际上会影响整个行业的判断。Lambert 是艾伦人工智能研究所(AI2)后训练团队负责人,《RLHF》一书的作者,他的观点值得关注,因为他在写这本书之前,真的上手训练过大模型。
- Nathan Lambert, "The Distillation Panic," Interconnects.ai, 2026: https://www.interconnects.ai/p/the-distillation-panic
- Nathan Lambert, "How Distillation Is Used Today and What Performance Uplift It Gives to Open Models," Substack, 2026: https://natolambert.substack.com/p/how-distillation-is-used-today-and
- Nathan Lambert on X: https://x.com/natolambert/status/2051478698235412979
- OpenAI, "Disrupting a Coordinated Model Distillation Campaign," OpenAI Blog, 2026: https://openai.com/index/disrupting-a-coordinated-model-distillation-campaign/
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师