中国信通院联合中国人工智能产业发展联盟发布《大模型词元服务性能监测报告(2026 年)》,基于 2026 年 1-8 月监测数据指出 6 月国内词元日均消耗量约…
500万亿词元的真实水位:量涨了,质在退
消耗翻4倍、TPS翻倍,但首词时延从0.78秒退到1.26秒
8月国内各模型TPS均值78.23个/秒,较2025年的38.25实现翻倍。代价同步显形:首词时延从0.78秒拉到1.26秒,归一化均价从6.8元涨到13.46元。半年间,词元服务的核心矛盾从「用得起」变成了「用得起但等不起」。
国内78.23 vs 国外112.82,差距卡在哪一层算力
同期国外典型模型TPS均值112.82个/秒,比国内高出44%。报告对比了DeepSeek、Qwen、GLM、Kimi四款开源模型在原厂平台与第三方平台的表现,差距主要不在模型参数层,而在推理侧的GPU集群调度与KV缓存命中率。价格端,国内13.46元对国外117.8元,便宜近9倍,但多出的那半秒时延会直接吃掉用户体验。更狠的是,500万亿不是终点是起点,真正决定生死的不是多消耗了多少,而是那30%的时延差距。
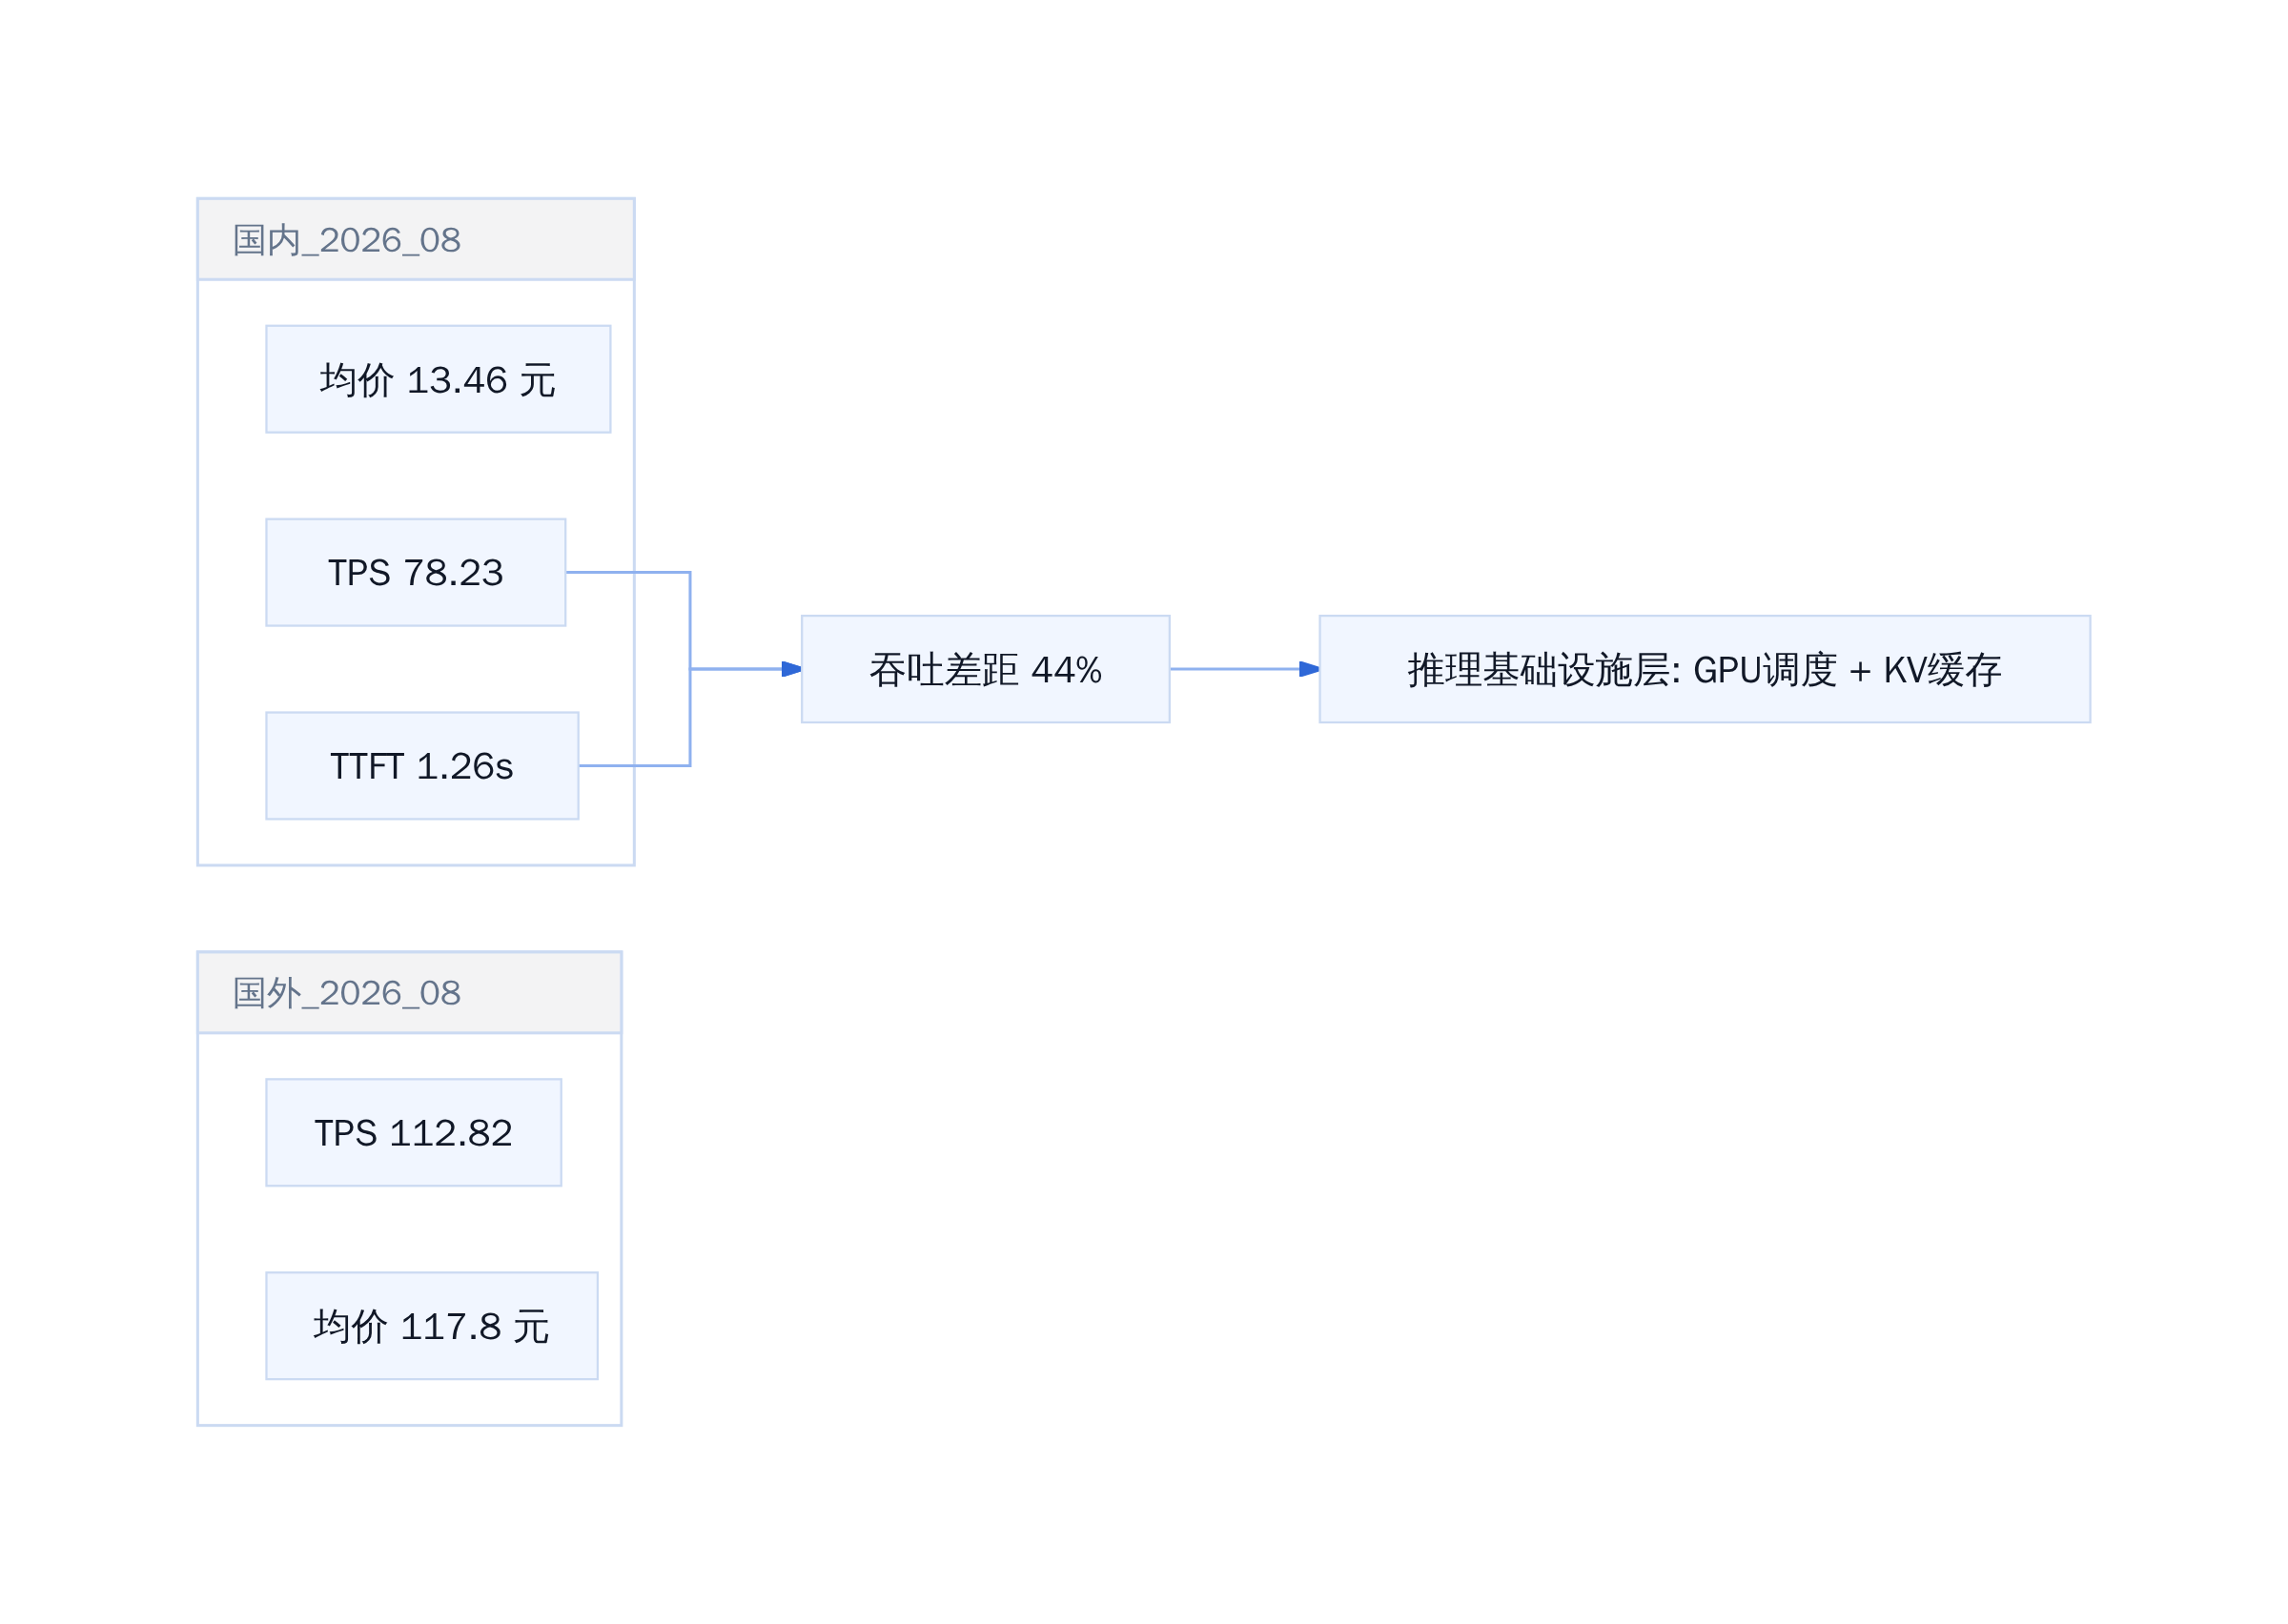
词元服务性能三维对比与差距定位
价格战结束了,词元贵了一倍
报告把价格单列出来,原因不复杂。过去两年国内词元走「先跑量再提价」的路,6.8元归一化均价让团队把词元当水电用。现在均价跳到13.46元,「随便调」的窗口关了。
国内归一化均价6.8→13.46元,国外仍站在117.8元
归一化均价是折算到统一输入输出基准后的每千词元价格。国内半年涨了约98%,但绝对值仍只有国外典型模型117.8元的九分之一。驱动力是算力供给紧张叠加日消耗翻四倍把闲时产能吃光,不是底层成本结构变了。
涨价之后,成本最终由哪环买单
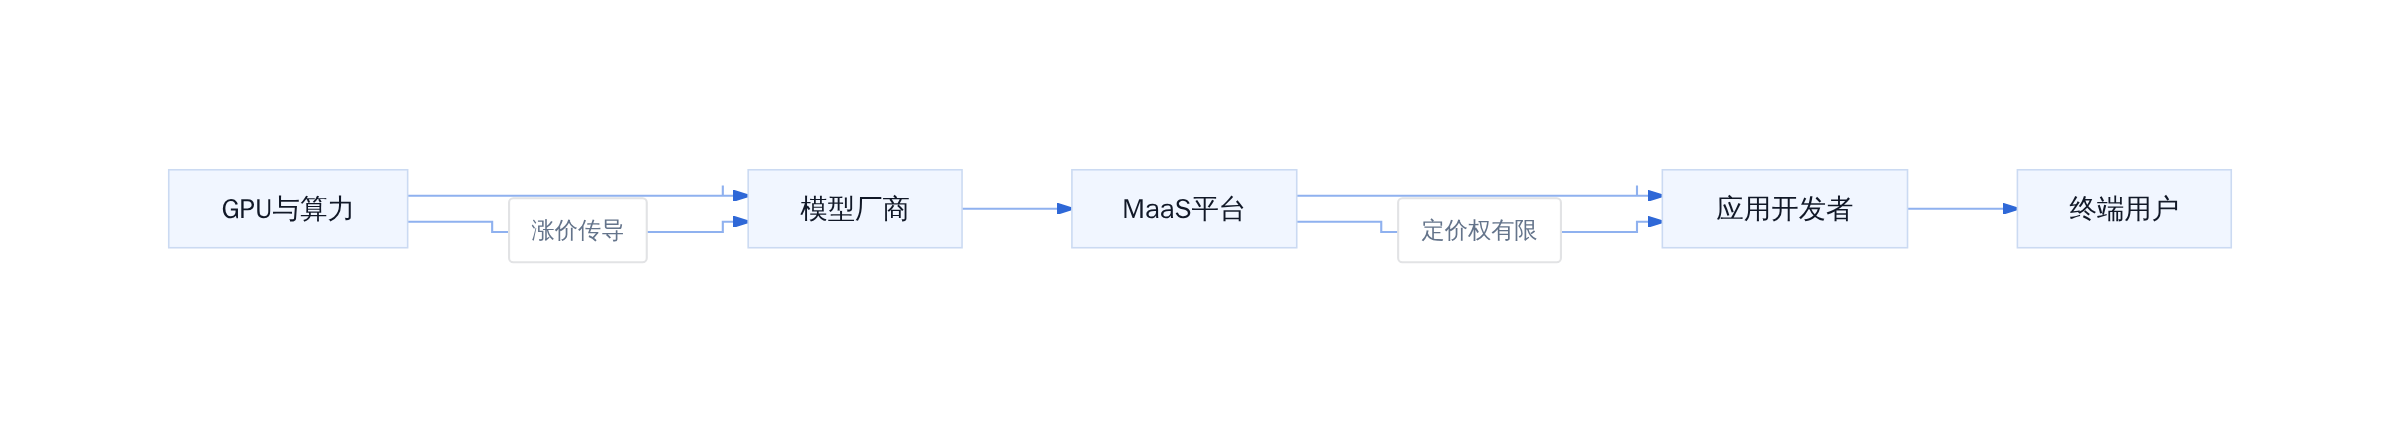
词元成本传导链
成本沿这条链往下走。MaaS平台夹在中间,上游算力贵了提价空间有限,下游开发者对单价敏感。落地动作就三个:缩上下文、加缓存、换小模型。月调用过百亿词元的团队,均价每涨一元,年化多十几万。
选型时把吞吐、时延、单价三个数放一起算。那半秒时延和翻倍的词元价该谁担,算完就知道。
同一模型不同平台,性能差四成是什么体验
你选的模型叫 DeepSeek,但跑在哪个 MaaS 平台上,TPS 能差出三到四成。信通院报告将 DeepSeek、Qwen、GLM、Kimi 四款开源模型放在原厂官方平台与多家第三方平台做交叉对比,发现同一权重文件在不同部署方手中,吞吐速度差异可达 30% 至 40%。你选的不仅是模型,还有那个平台的推理调度策略。
信通院五维度监测框架:成功率、吞吐、时延、稳定性、上下文窗口
报告围绕调用成功率、吞吐速度(TPS)、首词时延(TTFT)、稳定性、上下文窗口五个维度做交叉监测。单看 TPS 不够。一个平台峰值 TPS 漂亮,P99 时延却能拉垮;另一个平台在长上下文场景下截断策略不一致,输出质量随请求长度波动。五个维度必须联合看,才能判断这个平台能不能进你的生产链路。
开源模型上第三方平台,隐性成本藏在哪个参数里
隐性成本不在模型权重里,在平台的推理引擎配置里。同一个 DeepSeek,平台 A 用 vLLM 做 continuous batching,平台 B 用自研调度器做 chunked prefill,你在 API 层看到的 TPS 能差三成以上。更隐蔽的是上下文窗口处理:有的平台默认 8K 截断且不告知,有的支持 32K 但按 token 阶梯计价。你买的不是「DeepSeek」,你买的是某个平台在某个时刻的推理资源配置。选型时把 P99 时延、上下文截断行为、batch 调度策略写进验收标准,比多比一家报价更管用。
做MaaS选型的三条实操建议
别只比价格了,把TTFT和TPS写进决策表
过去两年价格战把选型表简化成了一列数字:每百万词元多少钱。信通院报告显示国内归一化均价从 6.8 元涨回 13.46 元,价格维度重新拉开差距,但真正让从业者卡住的不再是账单,是交互体验。国内 8 月均值 TPS 78.23,国外 112.82,差出 30%;TTFT 从 0.78 秒拉到 1.26 秒。做 Agent 编排或多轮对话的团队,那 0.48 秒首词延迟会直接传导到用户侧的等待感里。
词元经济的逻辑变了:以前是「用得起」的问题,现在是「用得起但等不起」的问题。决策表至少三列:TPS、TTFT、归一化单价。时延敏感场景(实时语音、在线 Agent)优先保 TPS 下限,单价可以让步;批量离线场景,单价仍是第一权重。
上下文窗口是下一个隐性成本,长文本场景要单独核算
报告监测了 DeepSeek、Qwen、GLM、Kimi 四款开源模型在第三方平台上的上下文窗口表现。同一个模型,原厂平台给 128K,第三方平台可能截到 32K。这个差异不写在价格表里,却直接决定你的长文档 RAG 或 Agent 记忆能不能跑通。长文本场景不要混在通用预算里,单独建一行:上下文窗口上限 × 实际调用频次 × 超窗降级策略的边际成本。
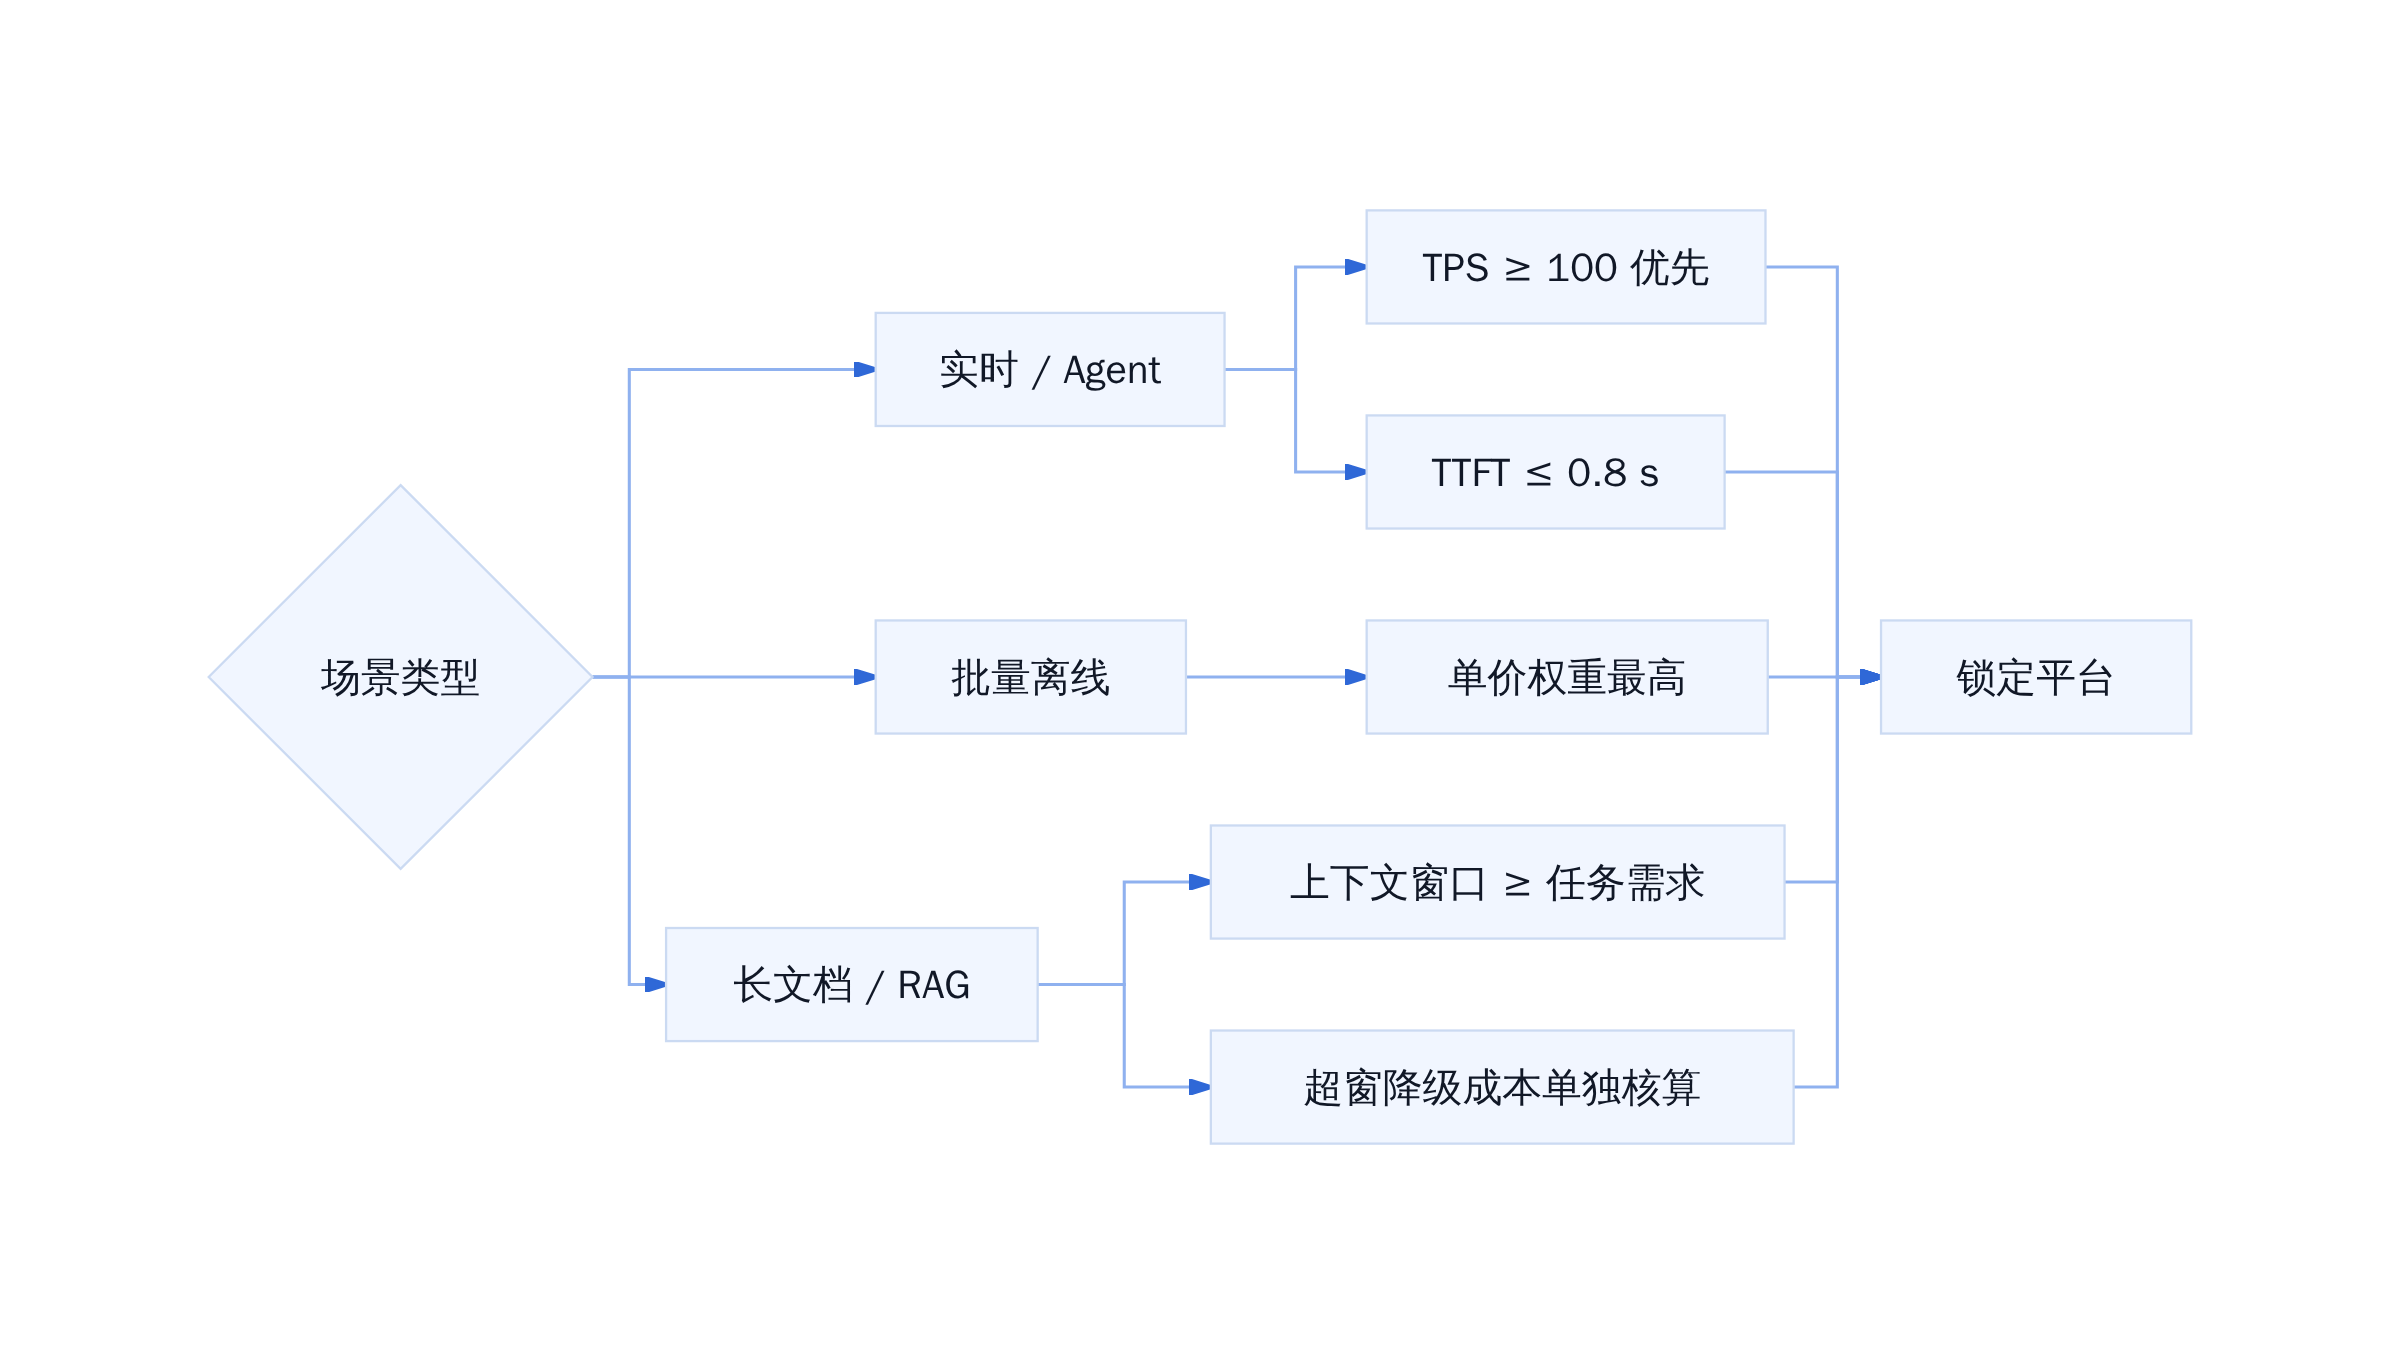
MaaS选型决策框架
500万亿不是终点是起点,真正决定生死的不是多消耗了多少,而是那 30% 的时延差距。可以今天就做的两件事:把现有 MaaS 选型表加上 TTFT 和 TPS 两列,用信通院 8 月数据做基线;把长文本场景的上下文窗口需求单独拉出来,对照目标平台实际上限算一次超窗成本。
参考文献
- 中国信通院.《大模型词元服务性能监测报告(2026年)》. 2026-10-23. https://news.qq.com/rain/a/20261025A01M5700
- IT之家. 中国信通院:6月国内词元日均消耗量约500万亿. 2026-10-24. https://www.ithome.com/1/017/518.htm
- 人民财讯. 中国信通院:2026年词元服务价格明显回升. 2026-10-23. https://finance.eastmoney.com/a/202610233905592777.html
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师