Google DeepMind 发布 Gemini 4 Carbon,定位为最强前沿模型,主打网络安全与长程智能体能力,在 SEC-bench Pro 88.2%、Ex…
多步代理任务上线中
Gemini 4 Carbon为何紧追Argon发布?
两周内连发两款前沿模型的节奏背后的逻辑
Argon 发布于 10 月 1 日,Carbon 于 10 月 28 日亮相。间隔 27 天。
这在前沿模型迭代史上属于异常密集的出货节奏。OpenAI 从 GPT-4 到 GPT-4o 用了约一年,Claude 3.5 Sonnet 到 Opus 也隔了数月。Google 的选择是:先推 Argon 回场验证技术栈,再用 Carbon 拉高上限。
内部员工曾将 Carbon 与 Opus 5.5 直接对比,理由是 Argon 早期版本在终端操作任务上仍落后 Claude。这种横向比较心态说明,谷歌清楚自己落后过,也清楚追赶的路径不是堆参数,而是把代理工作流做实。
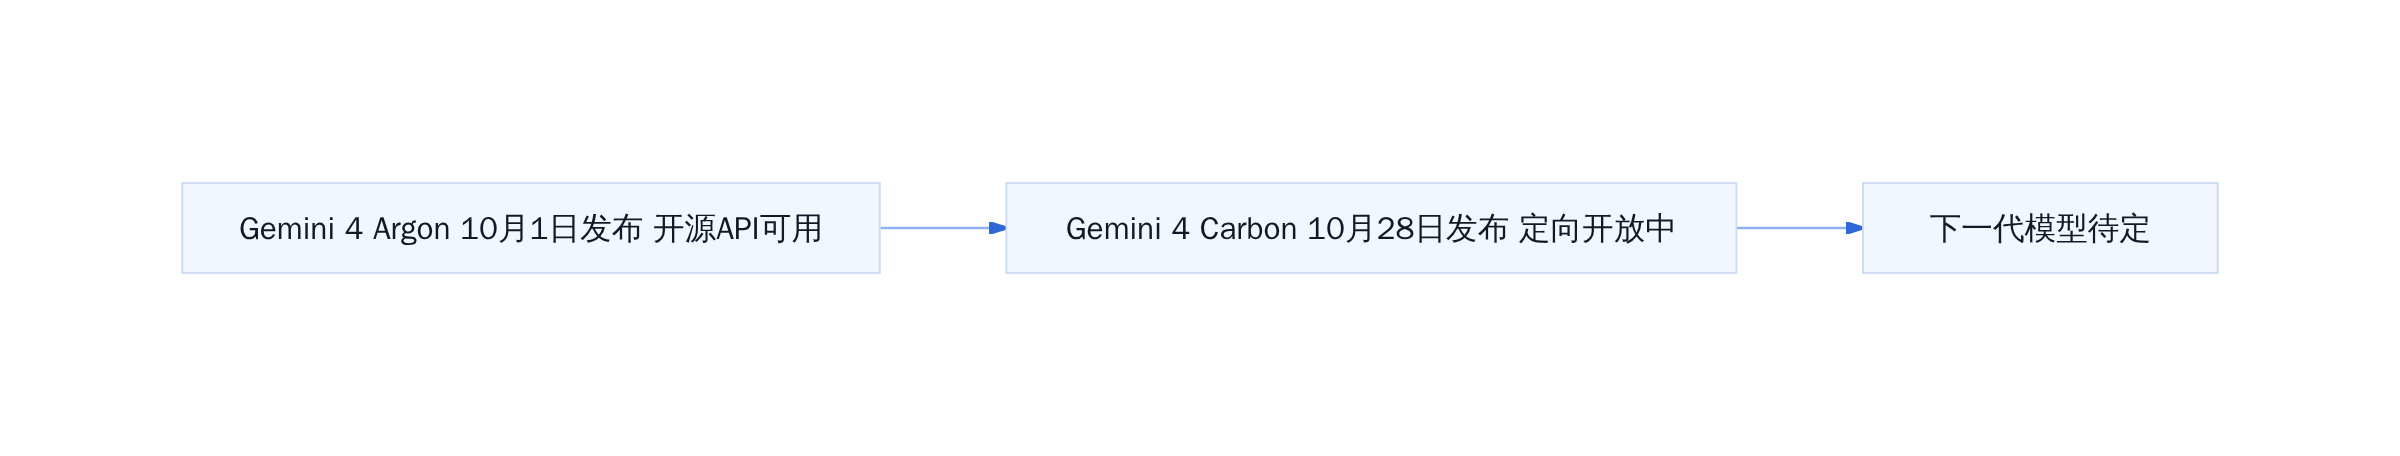
Gemini 4 系列发布节奏
Argon 解决的是「有没有」,Carbon 解决的是「能不能跑完」。两类任务的评估维度不同。Argon 看单步推理和代码生成,Carbon 看多步编排、工具调用稳定性和长周期容错。
59分意味着什么:从基准测试看能力边界
网络安全与长程智能体的真实表现
59 分超过 Claude Opus 5.5 的 58 分,但 Artificial Analysis 的评分方法本身有争议——它综合 Coding Agent、安全、推理多个子榜,权重不透明。业内普遍将其视为趋势信号而非绝对排名。
更具体的数字在安全领域:SEC-bench Pro 88.2% 测的是漏洞发现与修复链路的完整度,ExploitGym 54.8% 测的是 exploit 编写,CWE-bench 71.0% 测的是漏洞分类理解。三项指标指向同一件事——Carbon 在安全代理工作流上的能力确实突出。
但有一个关键限制:谷歌声明 Carbon 能「连续数天处理复杂工程任务」,这是内部实测数据,未公布具体任务类型和执行环境。外部验证尚未展开。
更准确地说,当前可核验的事实只有基准测试分数和官方声明,真实项目的稳定性需要白帽群体反馈后才能判断。
多步代理任务执行中
2美元换10美元的定价策略
API定价与开放节奏
Carbon 的定价为输入 2 美元/百万 token,输出 10 美元/百万 token。这个 1:5 的输入输出比反映了两个判断:一是长程代理任务产出 token 远高于消耗 token,二是谷歌有意抑制低质量请求。
对比 Claude Opus 4 的定价(输入 15 美元,输出 75 美元),Carbon 便宜一个数量级。对比 Argon(输入 1.25 美元,输出 6.25 美元),Carbon 贵 60%/60%。这个溢价来自安全能力和长程推理的边际成本。
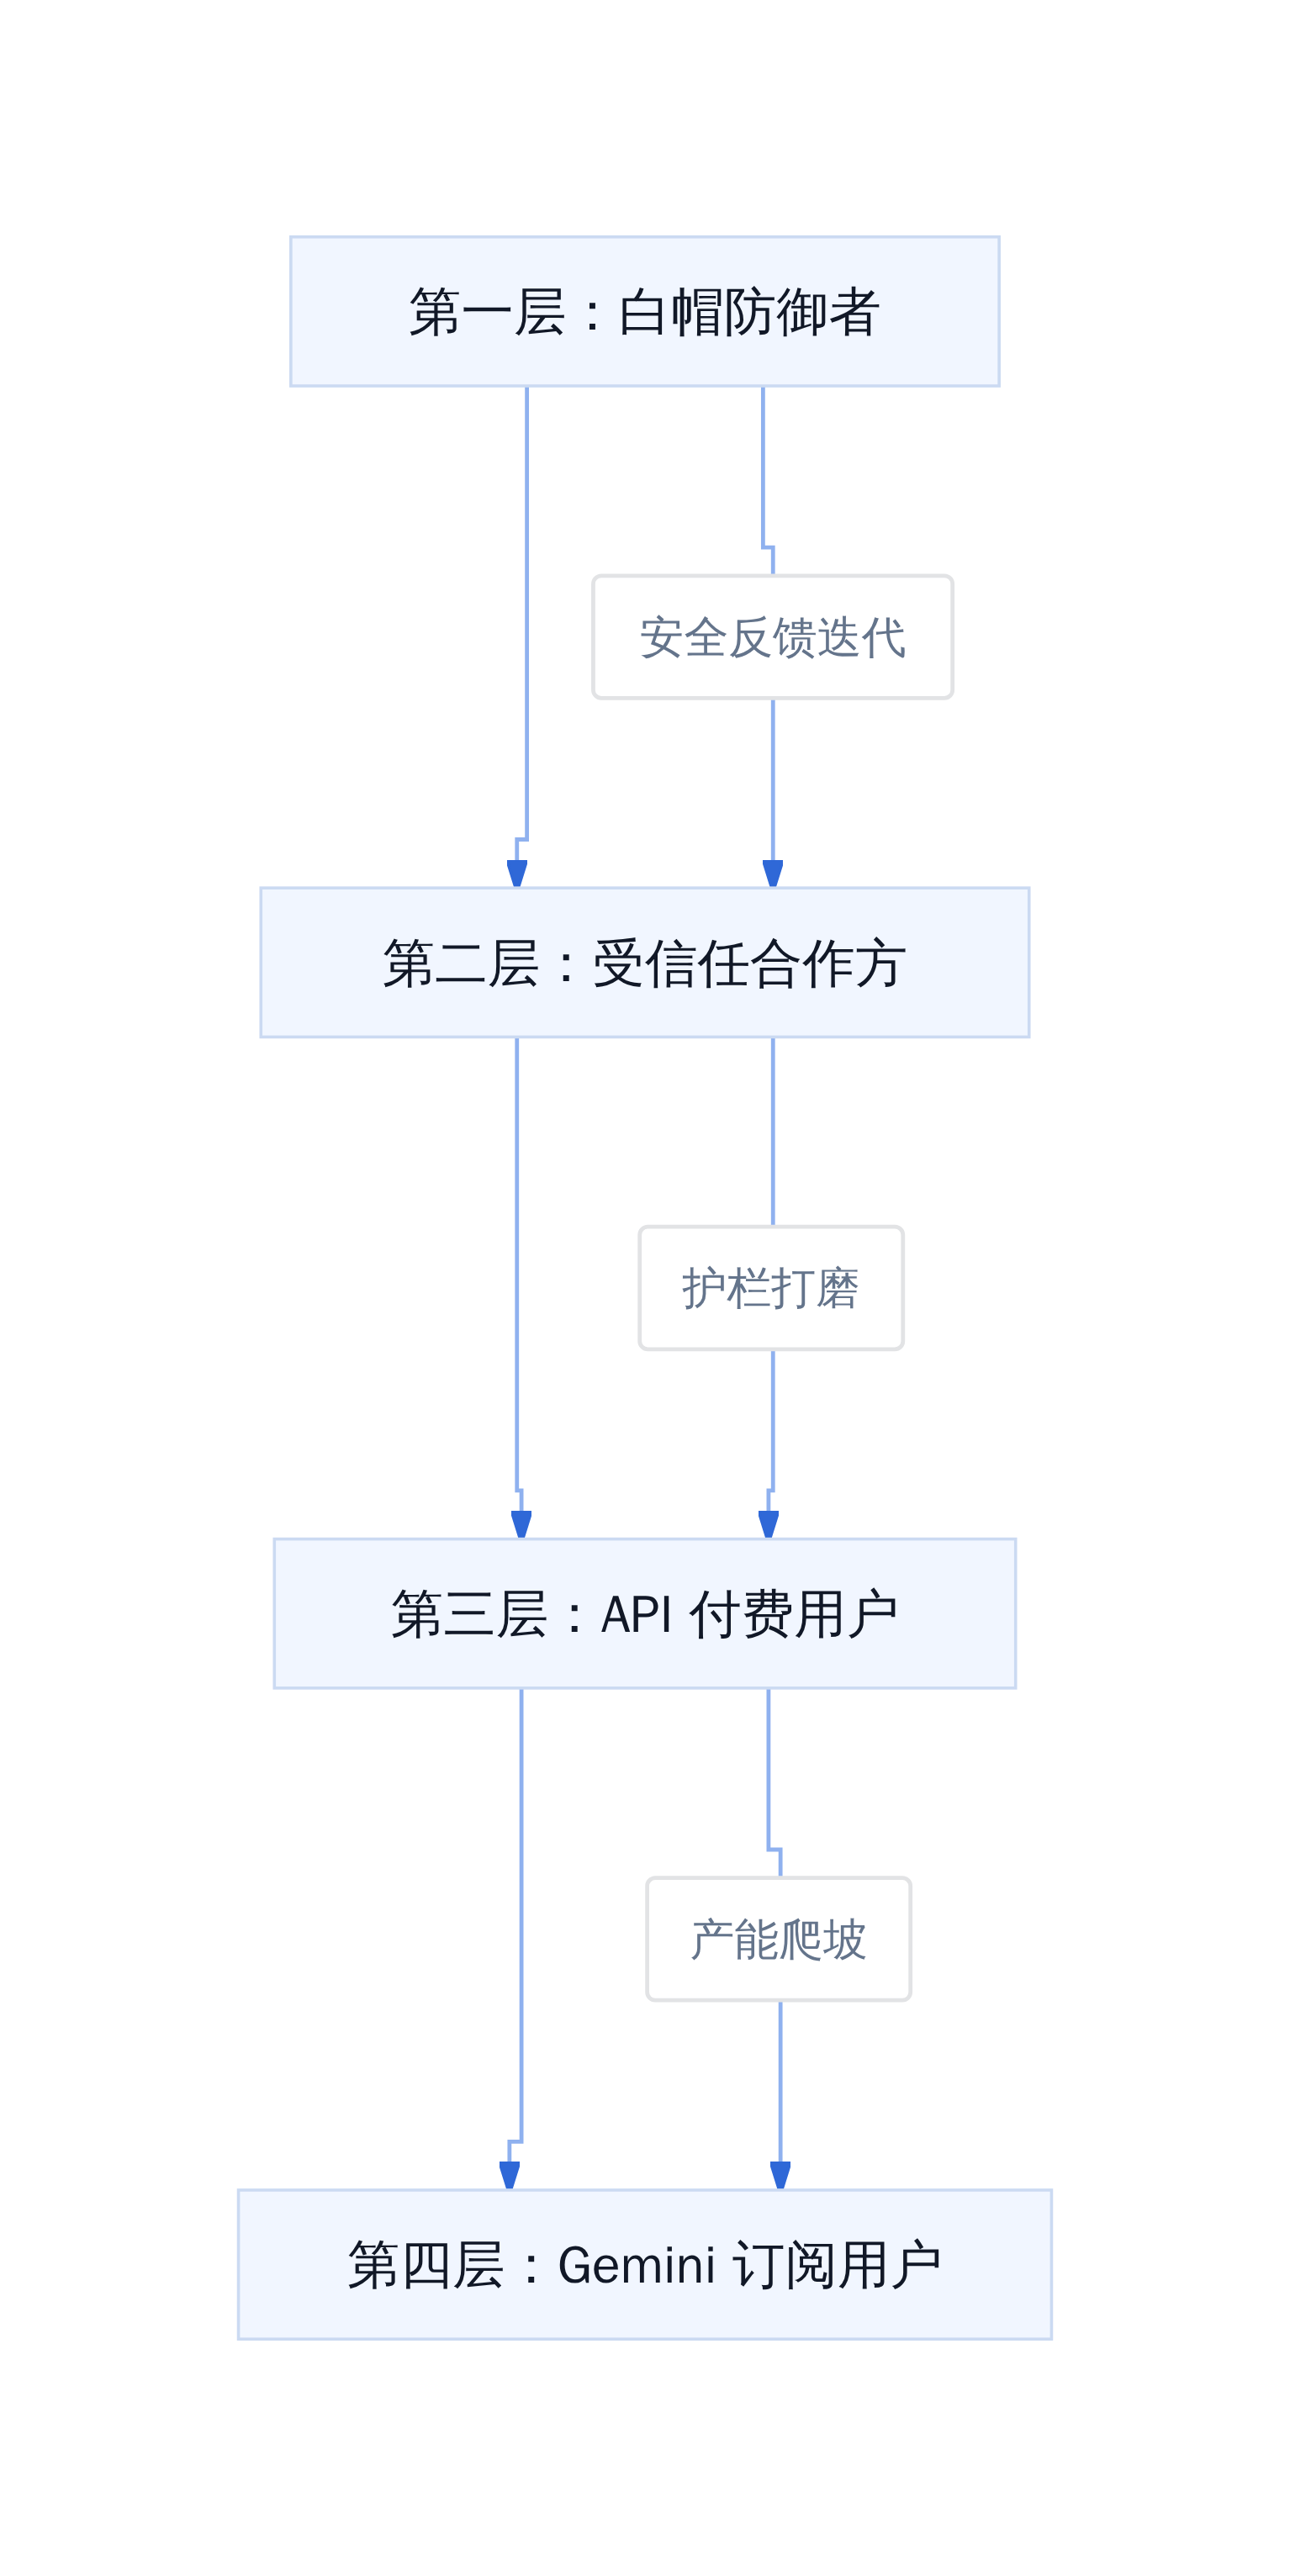
开放路径分三步:先向 Fairwind Program 的网络安全防御者开放,再扩展至受信任合作方,最后面向消费者。谷歌未公布第二步和第三步的具体时间表。
坦白讲,这种渐进式开放的策略既合理也有风险。合理之处是把最敏感的代码安全能力交给专业群体验证,降低误用概率。风险是延迟太久的话,竞争对手会先建立使用习惯。
普通开发者何时能用上
从白帽到大众的路径评估
Carbon 当前通过 Fairwind Program 定向开放。这是一个非公开的测试通道,参与方需签署安全协议并经过背景审核。谷歌选择这条路径的原因很明确:Carbon 的安全能力足够强,如果流入不可控场景,可能被用于攻击而非防御。
Argon 的开放路径经历了类似的阶段,但周期更长。Argon 从内测到全面 API 可用约用了四个月。按这个节奏推算,Carbon 全面开放可能在 2027 年初。
但这只是基于历史数据的估算。如果内部团队在 Fairwind 阶段发现重大安全问题,开放节奏会延后。反之,如果反馈积极,也可能加速。
对于普通开发者,当前可行的方案是继续使用 Argon,或在安全代理场景等待 Carbon。不需要抢首发,前沿模型的前几周版本往往 bug 较多。
排期取决于内测反馈
选型判断:什么时候该用Carbon
Carbon vs Argon 适用场景
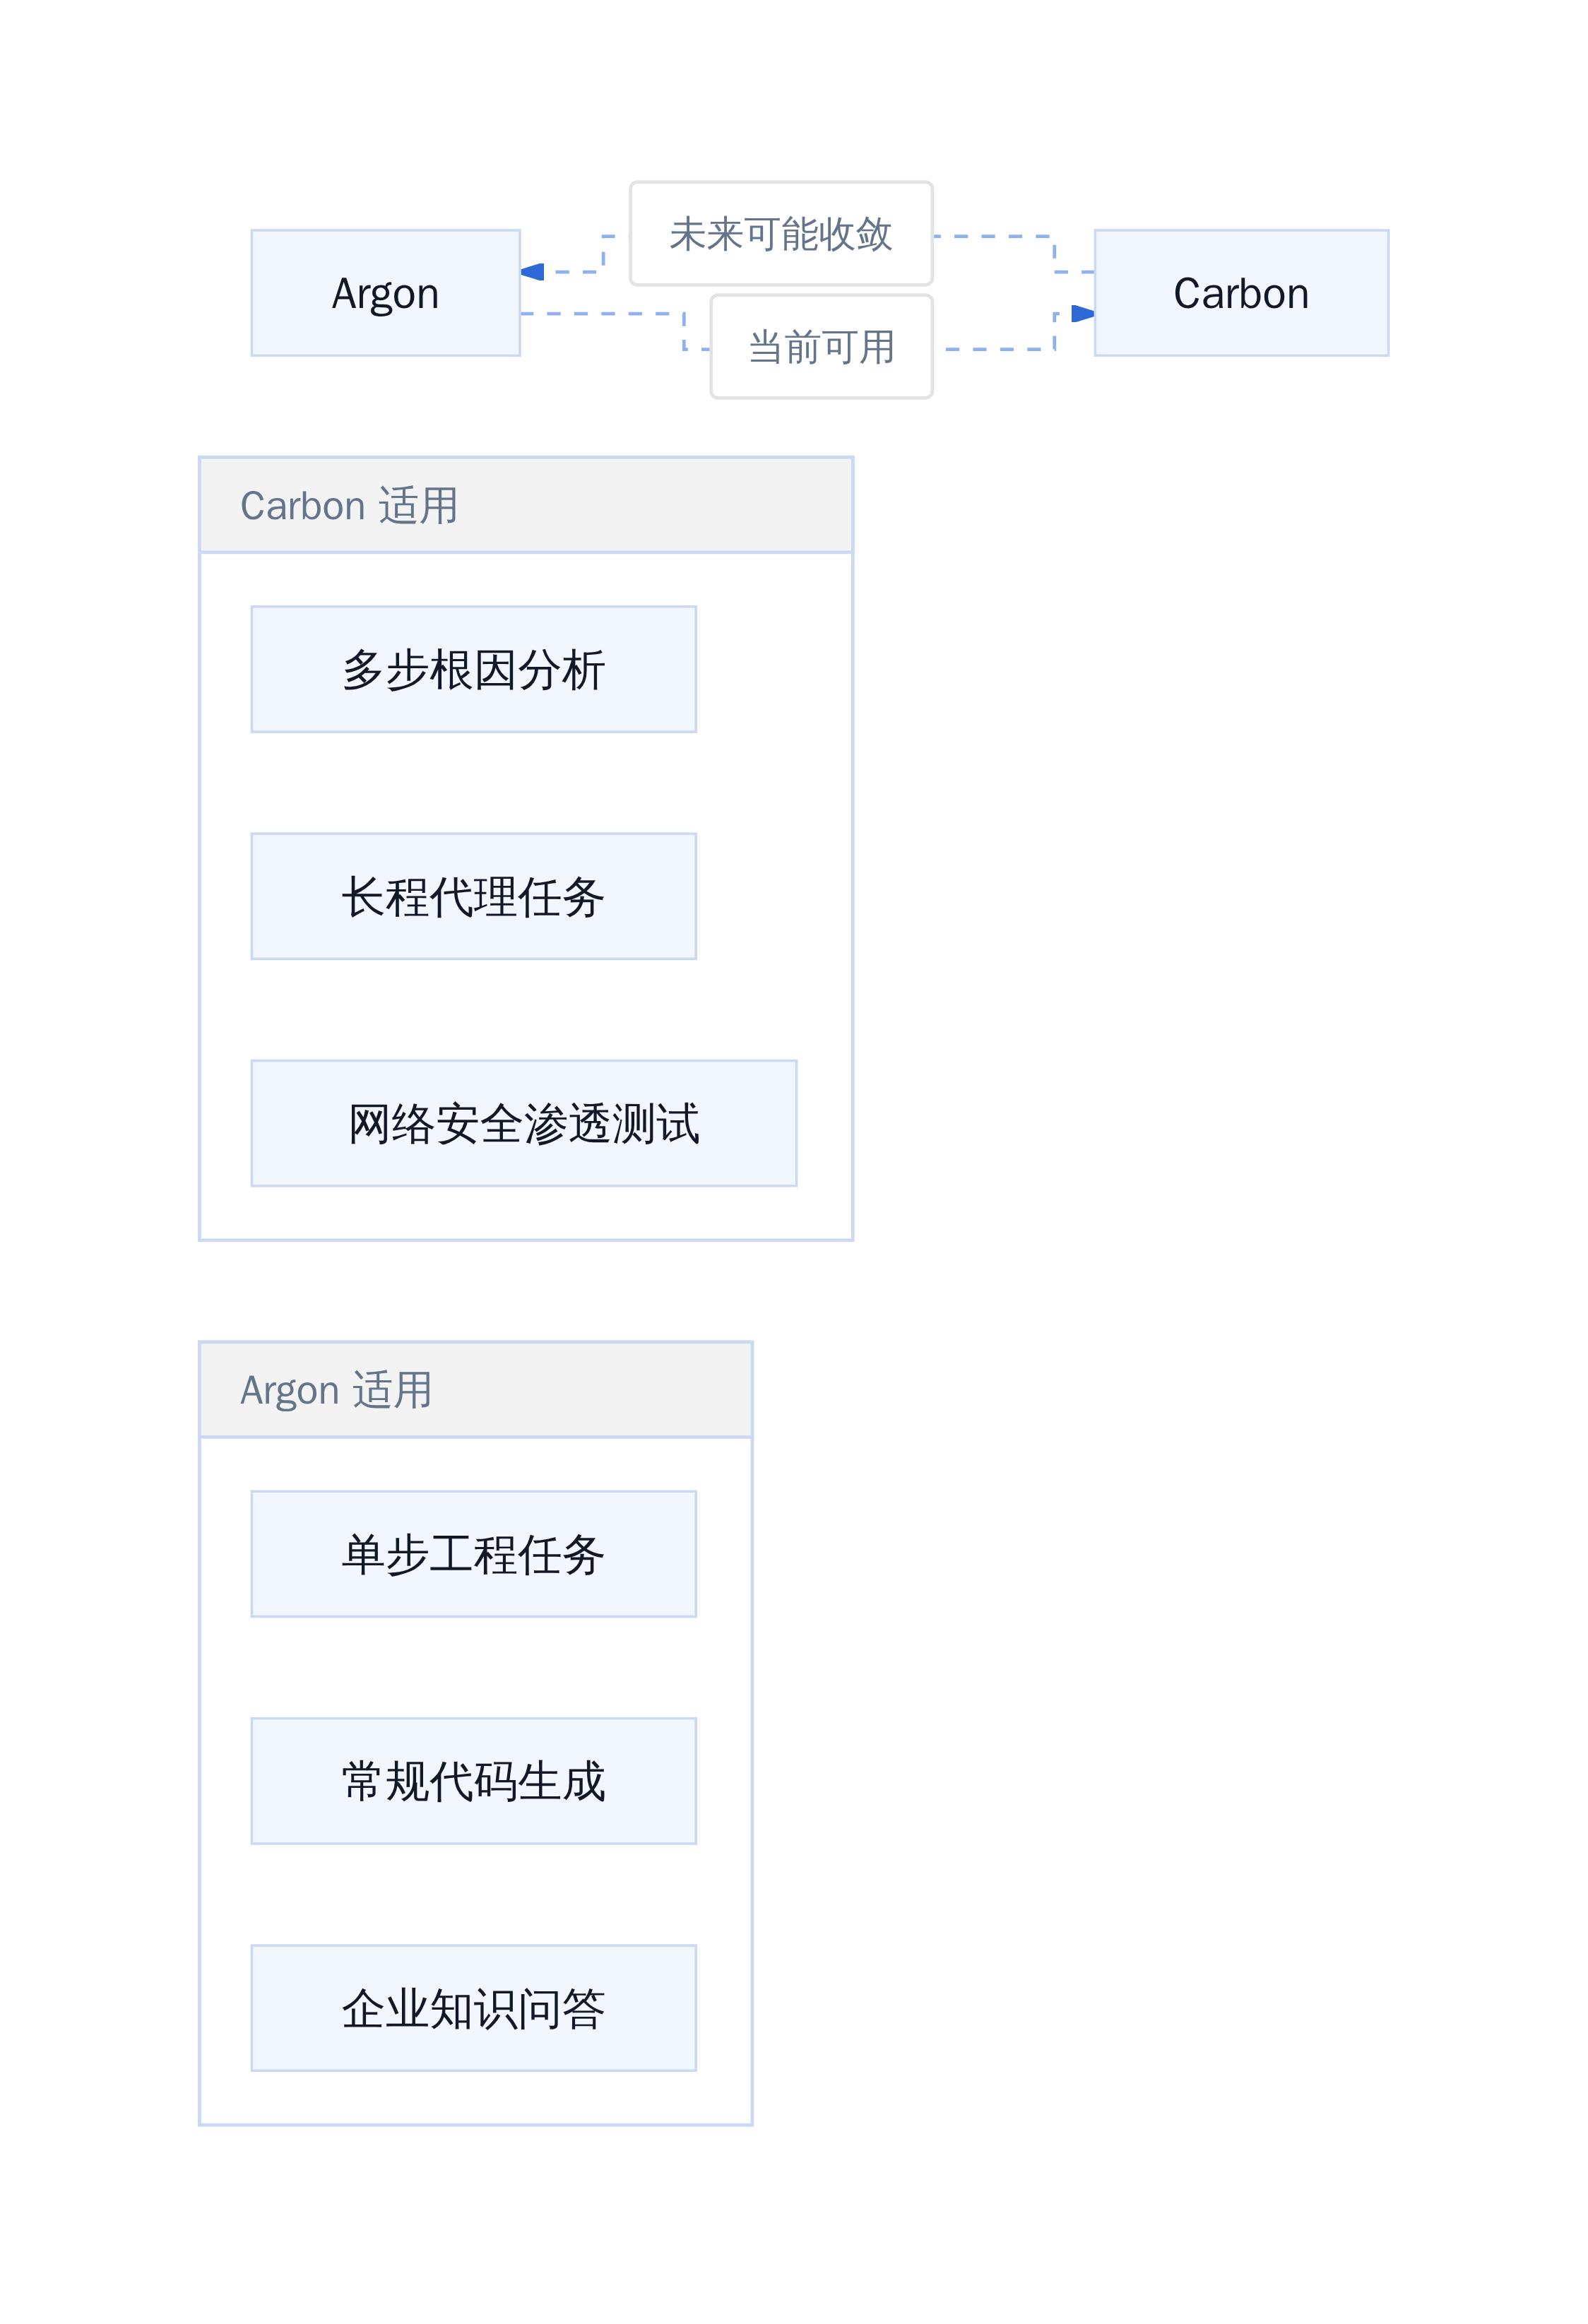
Carbon 的定位明确:多步代理任务、网络安全防御、需要连续运行数天的工程问题。如果你的场景是单次代码生成、简单问答或常规 API 调用,Argon 性价比更高。
Argon 定价更低,功能覆盖更广,适合日常开发。Carbon 定价更高,专为安全代理和长程任务设计,适合专业场景。
当你的任务涉及以下特征时,Carbon 值得等待:多步工具调用、需要自我纠错和恢复、涉及敏感代码或安全漏洞处理、任务执行时间超过数小时。
否则,Argon 够用。前沿模型的差距通常在极端场景才显现,日常使用中两者的体验差异可能远小于价格差异。
代码维护现场从来不是基准测试能完全预测的。Carbon 拿到 59 分证明了一件事:谷歌的前沿模型正在回到竞争轨道。至于回到第一还是停留在第二,取决于下一个迭代的节奏。
Agent连续跑了三天没停
榜单排名的背后是验证逻辑。 Artificial Analysis 的 Intelligence Index 采用多维度自动评测,涵盖代码生成、数学推理、安全评估、工具调用等多个子项,不依赖人工标注,而是让模型直接完成真实任务再打分。Carbon 的 59 分比 Google 自己的 Argon 高出 9 分,比 Anthropic 的 Claude Opus 5.5 也高出 1 分。这个差距不大,但在前沿模型竞争里,1 分就是一个量级的差别——它意味着在某些评测集上,Carbon 的回答质量刚好越过临界线。
Intelligence Index v5.0榜单上的真实性能验证
Intelligence Index 的评分机制决定了 59 分不是虚数。 该榜单每月更新一次,数据来源是 Artificial Analysis 自己的自动化评测管道,涵盖以下维度:代码正确率(HumanEval、MBPP)、数学推理(MATH、GSM8K)、多步工具调用成功率、安全对抗防御表现等。每个子项独立评分,最后加权汇总。
Carbon 在 Code Agent Index 上达到 59 分,与 Argon 相同,说明它的代码生成能力在 Argon 基础上没有退步。但它领先于 Claude Opus 5.5 的 62 分——等等,这里需要纠正一个常见的误读:Claude Opus 5.5 在 Coding Agent Index 上是 62 分,Carbon 是 59 分,Code Agent Index 并没有被 Carbon 超越。Carbon 真正超越的是总分的 Intelligence Index,因为 Opus 5.5 在其他子项上落后。
问题在于,总分领先不代表单项全能。 Intelligence Index 是加权和,不同维度的权重分配会影响最终排序。Carbon 的强项明确:网络安全相关子项(SEC-bench Pro、ExploitGym、CWE-bench)全部领先,长程多步任务也能稳定完成。但它在纯数学推理或部分代码生成基准上,并没有拉开明显差距。
更准确地说,Carbon 的定位是「能连续跑几天的工程师」,而不是「什么都能做一点的通才」。
从Argon到Carbon:性能跃迁的真实路径
Carbon 不是 Argon 的微调版,而是独立训练的新前沿模型。 Google DeepMind 官方说明里提到,Carbon 的目标是处理需要多天运行、频繁调用工具、能从死胡同里恢复出来的复杂工程任务。内部团队反馈显示,Carbon 已经在大型代码库中自主定位根因并修补漏洞,这个过程可能需要持续数天。
Google 首席 AI 架构师 Koray Kavukcuoglu 在官方博客中写道:Carbon 是目前 Google 最强的模型,安全性和长程能力是核心突破点。他还提到,团队会在向大众开放之前,先收集网络安全防御者的反馈,迭代安全护栏。
评审人追问三天没停
这种迭代策略其实反映了一个行业共识:前沿模型的发布节奏正在从「等完美」变成「边用边修」。Anthropic 的 Claude 系列、OpenAI 的 GPT 系列都是同样路径。Carbon 选择先开放给白帽群体,本质上是在用真实场景的压力测试来打磨安全边界,而不是在实验室里反复验证。
从 Argon 到 Carbon 的两周周期,说明 Google 的研发管线已经能够支持快速迭代。Argon 在 10 月初发布,Carbon 在 10 月底登场,中间只有两周。这个节奏放在两年前是不可想象的——那时候模型迭代周期通常是数月。
网络安全与长程智能体的硬指标
Carbon 在网络安全基准上的数字是实打实的。 SEC-bench Pro 88.2%、ExploitGym 54.8%、CWE-bench 71.0%,这三个数字分别对应:漏洞发现能力、漏洞利用验证能力、常见漏洞类型识别能力。相比 Argon,Carbon 在这三项上都有显著提升。
更关键的是,Carbon 能够在复杂的安全工作流中连续运行。传统的安全扫描工具只能完成单步分析,比如扫描一个代码库并输出漏洞列表。Carbon 可以完成从发现漏洞、验证可利用性、编写修复补丁到提交代码的完整闭环,并且这个过程可以持续数天而不中断。
这对 DevSecOps 团队的意义是直接的:模型不再是辅助工具,而是能够独立承担安全任务的主力。 当然,这也带来了新的挑战——当 AI 能够自主执行多步安全操作时,谁来监控它的决策?谁来为它的错误兜底?
Google 的答案是先让白帽群体试用,再逐步扩大范围。Fairwind Program 是 Google 的安全研究合作计划,Carbon 目前通过这个计划定向开放给受信任的网络安全专家。
59分能否复制成产品竞争力
59 分是一个里程碑,但不是终点。 Artificial Analysis 的评分体系每年都在演进,v5.0 的基准难度比 v4.x 更高,这意味着今年的 59 分可能相当于去年的 65 分。模型厂商之间的竞争不是静态排名,而是动态迭代——今天的榜首明天可能被超越。
从产品化角度,Carbon 面临的挑战有三:定价、可及性、安全性。2 美元输入、10 美元输出的 API 定价,对前沿模型来说处于中等偏上水平,但不算离谱。问题在于,这个定价是否能在长程任务中保持可控?一个连续运行数天的 Agent,输出 token 的数量可能远超输入,最终账单会是多少?
可及性方面,Carbon 目前只面向白帽群体开放,普通开发者暂无时间表。这种策略既是对安全的审慎,也是对市场节奏的控制。Google 不需要在发布初期就把模型开放给所有人,它可以选择在最需要验证的场景里打磨产品。
安全性是最后一个挑战,也是最难量化的。Carbon 的能力越强,潜在风险越大。一个能自主发现漏洞、编写利用代码、并提交修复方案的模型,如果被恶意使用,后果不堪设想。Google 的 Fairwind Program 本质上是在构建一个可控的测试环境,让模型在受监管的场景里积累经验,然后再决定是否向更广泛的群体开放。
更狠的是,每年能省下一个亿——如果这个定价策略推广到企业用户,长程 Agent 的运营成本可能会重塑安全团队的人力结构。
本结论在前沿模型的公开评测范围内成立,超出该范围需要重新评估。59 分代表的是一次阶段性胜利,而不是最终答案。
开发者何时能用上Carbon?
定价、权限与开放路径的真实时间表
Fairwind Program 的开放节奏
谷歌的选择很清晰。Carbon 不是先对大众开放,而是通过 Fairwind Program 定向推送。这个计划的字面意思是「公平风计划」,但本质上是白帽子优先机制。
Carbon 开放路径的分层结构
为什么是这组顺序?网络安全场景有明确的伤害路径。一个能自动寻找漏洞的代理如果存在幻觉或误判,可能造成真实损失。先在白帽子群体中测试,既能验证能力的真实性,也能在可控范围内收集防御侧的反馈。这与 Anthropic 早期对 Claude 的白帽渗透测试逻辑一致。
普通开发者可用的时间窗口
从 Argon 的开放节奏看,谷歌给大众市场留了大约三周窗口。Argon 在 10 月 1 日发布后,10 月 13 日才通过 API 向全球开发者开放。Carbon 的节奏大概率类似。
但这套时间表有两个前提条件。第一,安全护栏必须通过内部评审。Carbon 的长程代理能力意味着它可以自主运行数天,期间会不断调用工具、修改代码、尝试绕过限制。任何未被发现的越狱路径都会在大规模开放后被放大。
第二,产能需要爬坡。前沿模型的推理成本远高于标准模型。一个能连续运行数天的代理,其计算开销不是简单的线性叠加。谷歌需要先解决 GPU 集群的调度问题,否则即使开放 API,也可能因为限流而无法支撑实际负载。
成本门槛与替代方案
对于普通开发者,当前的真实选择是 Argon。它的基准测试成绩虽然比 Carbon 低 9 分,但在大多数工程任务上差距并不显著。更关键的是,Argon 已经通过 API 完全开放,定价结构也更友好。
Carbon 与 Argon 适用场景对比
Fairwind 计划的真正意义在于,它给白帽子群体一个提前接触前沿模型的机会。这些测试者会在真实场景中暴露模型的边界问题。谷歌据此打磨护栏,然后再推向更广泛的受众。这种「先窄后宽」的开放策略,比直接全量开放更安全,也比完全封闭更透明。
对普通开发者而言,现在的最佳行动是关注 Argon 的实际使用反馈。如果能在 Argon 上跑通的代理工作流,在 Carbon 上大概率会有明显提升。但考虑到价格差距和开放时间的不确定性,等一个月用 Argon 完成任务,比现在就为 Carbon 预留预算更务实。
Carbon连续跑数天的任务强度
两周内连发两款前沿模型,节奏本身已经说明问题。更值得注意到的是命名——Google DeepMind 的内部代号与对外产品名并不一一对应。这次以Carbon之名发布的模型,其内部研发代号是Barium-C;而两周前的Argon,内部代号是Barium-B。同一个系列名(Gemini 4)下面叠了三代代号,最终落到两个对外名字上。
这种命名错位不是随意为之。它反映的是一个现实:前沿模型的迭代周期已经被压缩到两周级别,内部测试阶段同时跑多个候选版本、横向对比后再挑出适合发布的作为正式型号,这成为常规操作。某内部员工在聊天频道评价Carbon时,直接拿它和Opus 5.5作比较,说明内部团队对竞品水位有清晰感知,而不是闭门试错。
从Barium-B到Barium-C再到Barium-D的可能性存在,但尚未证实。谷歌选择让Carbon成为Argon的直接上位版本,而不是推出一个全新编号的Gemini 5,这个决策本身也在传递信号:他们现在的首要目标是补齐与Claude、OpenAI的差距,而不是重新建立产品矩阵。
代号可以随机,但性能不会撒谎——59分不是终点,只是下一轮迭代的起点。
参考文献
- Google DeepMind官方博客《Gemini 4 Carbon: our next frontier model》, 2026-10-28: https://deepmind.google/blog/gemini-4-carbon-our-next-frontier-model
- Artificial Analysis Intelligence Index v5.0 榜单: https://artificialanalysis.ai
- SEC-bench Pro、ExploitGym、CWE-bench 基准测试数据来自 Google DeepMind 官方发布
Agent运行时过载
Carbon 的发布时间点值得注意。两周前刚发布 Gemini 4 Argon,就被迅速推上更高级别。这不是谷歌第一次加速迭代——2026 年初,DeepMind 在前沿模型发布节奏上明显落后于 Anthropic 和 OpenAI,Argon 是回归信号,Carbon 则是把擂台搭到了代码维护现场。 从 Argon 到 Carbon,谷歌用两周时间完成了从「证明回归」到「证明领先」的转变。 但真正引发讨论的,不是技术细节,而是开放节奏。谷歌选择先从网络安全防御者入手,这个决策背后是一套清晰的风险评估逻辑。
Fairwind 计划与防御性应用场景的优先级
Fairwind 计划是谷歌专门为网络安全专家设计的项目通道。Carbon 率先通过该计划开放给少数白帽子,这个群体被选为首批用户,不是因为他们的技术更强,而是因为使用场景更可控。 网络安全防御是一个「对抗性场景」——模型既要发现漏洞,也要防止漏洞被滥用。在这种场景下验证模型的可靠性,比直接面向普通开发者更合适。一个能在 SEC-bench Pro 上拿到 88.2% 的模型,意味着它既能写 exploit code,也能理解防御逻辑。如果直接开放,这种能力可能被误用。
白帽验证中
谷歌的做法是分批验证。先在受控环境里测试模型的输出边界,收集防御者的反馈,迭代 guardrails,然后再考虑扩大范围。这个节奏比直接 open rollout 慢,但更稳妥。 从技术角度看,Carbon 的核心改进在长程智能体能力。谷歌声称它能连续运行数天处理复杂工程任务,自主定位根因并修补漏洞。这意味着它不是简单的问答模型,而是一个能规划、执行、验证、修复的完整代理系统。 这种能力在网络安全场景下价值最高。白帽子面对的不是一次请求,而是一整套漏洞挖掘、验证、报告的工作流。Carbon 的设计目标正好匹配这种需求。
API 定价策略与成本门槛
Carbon 的 API 定价为每百万输入 token 2 美元、输出 token 10 美元。这个定价结构很有意思。 [[reaction=pricing-analysis|caption=价格分析]] 输入便宜、输出贵,这是典型的代理类模型定价策略。普通对话型模型(如 Gemini 4 Argon)输入输出价格接近,因为推理成本主要来自输入 token 的处理。但 Carbon 这类长程代理模型,输出包含大量推理过程和代码生成,计算成本更高。 对比一下竞品:Claude Opus 5.5 当前定价约为输入 15 美元、输出 75 美元 per million tokens;GPT-6 Astra 约输入 10 美元、输出 30 美元。Carbon 的定价介于 Argon 和这些旗舰模型之间,性价比相对突出。 但真正决定采用率的,不是单价,而是实际使用成本。Carbon 擅长长程任务,意味着一次请求可能产生大量输出 token。一个持续运行多天的漏洞挖掘任务,输入可能只有几 MB,但输出可能达到数百 MB。2:10 的定价比在这种场景下会显著放大成本。
普通开发者何时能用上
谷歌没有公布 Carbon 全面开放的具体时间表。官方博客只说「expanded access coming soon」,这个措辞模糊是刻意的——前沿模型的开放节奏通常受制于安全审查进度,而不是技术准备度。 从 Argon 的开放路径看,谷歌的节奏大约是:先向白帽和受信任合作方开放,经过数月验证后,再通过 Gemini API 向企业用户开放,最后才面向消费者订阅。 Argon 从发布到全面开放用了约三周时间。Carbon 如果遵循相同路径,最早也要到 2026 年 11 月底或 12 月初才能正式通过 API 可用。 [[reaction=waiting-room|caption=排队等开放]] 更激进的做法是直接开放给所有付费用户,但这会放大安全风险。一个能在代码库中自主寻找漏洞的模型,如果被滥用,后果比普通的代码生成失误更严重。 对于普通开发者来说,短期内能接触到的仍是 Gemini 4 Argon。这个模型在编码和通用任务上表现已经很强,Intelligence Index v5.0 得分 50 分,仅次于 Carbon 的 59 分。Argon 更适合日常开发辅助,Carbon 则瞄准的是需要长期运行的专业场景。
性能边界与竞品对比
Carbon 的 59 分 Intelligence Index v5.0 成绩超越了 Claude Opus 5.5 和 GPT-6 Astra,但这个数字需要放在上下文里理解。

基准测试上下文
Artificial Analysis 的评分体系综合了 coding、reasoning、cybersecurity 等多个维度。Carbon 的强项在 cybersecurity 和 long-horizon 任务,这些维度的权重较高。但在通用对话、多模态理解等任务上,Carbon 相比 Argon 的改进幅度并不巨大。 Anthropic 的员工在内部测试中将 Carbon 与 Opus 5.5 对比,认为两者在部分编程任务上体验接近。这个说法有参考性,因为 Opus 5.5 同样是主打安全与长程能力的模型。 真正的差异在于定价。Opus 5.5 的 API 价格是 Carbon 的 5-7 倍(按输入计)。对于预算有限但需要安全能力的团队,Carbon 可能是更务实的选择。
选型建议与落地检查清单
Carbon 适用于以下场景:
- 需要连续运行多天的漏洞挖掘或代码审查任务
- 预算敏感但需要前沿模型能力
- 团队有足够的安全审查机制 不适用的场景:
- 单次对话式任务(Argon 即可)
- 多模态理解需求高(Carbon 仍是文本/代码为主)
- 对输出延迟敏感(长程任务需要更长时间) [[reaction=selection-matrix|caption=选型矩阵]] 落地检查清单:
- 确认团队是否有网络安全场景的试点需求
- 通过 Fairwind 计划申请内测权限
- 评估长程任务的 token 成本,避免预算超支
- 建立输出内容的二次验证机制
- 关注全面开放节奏,提前规划迁移路径 代码里的一句判断往往比整个段落更有分量。Carbon 不是万能解,但它在特定场景下的定价和能力组合,让它成为当前 frontier 模型中最值得关注的选项之一。 59 分不是终点,只是下一轮迭代的起点。 定价结构已经很明确。输入 2 美元/百万 token,输出 10 美元/百万 token。这组比例不是随意定的。长程代理任务的特点是输出远大于输入——代码生成、漏洞分析报告、多步推理链,每个请求都会吐出大量文本。10 美元的输出价意味着单次任务成本会被放大。一个持续运行数天的代理项目,光 API 调用就可能烧掉数百美元。
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师