Anthropic 在更新的 IPO 文件中首次披露第三季度业绩,算力与基础设施合同承诺总额约 $895.4B,其中 $447.5B 须在 2031 年前支付,仅 $2…
这个数字意味着什么。季度营收 $17B,承诺支出 $895B,两者相差 50 倍。更直观地看,公司账面现金 $131.8B,仅能覆盖未来 12 个月到期承诺($69.8B)的不到两倍。这意味着算力不是买得起就能用,而是需要提前三年锁定、绑定供应商,甚至自己下场建数据中心。
算力架构从资源采购变成了长期资产配置
业务目标:获取足够且稳定的训练算力
大模型训练算力需求的增长是指数级的。GPT-4 训练集群峰值功率超过 200MW,Anthropic 的目标是在 2026 年底前将总算力提升到 3.5GW。这已经不是单纯租几台服务器的事情,而是需要建设 GW 级数据中心、签订 GW 级电力合同。
核心矛盾在于:训练一个顶级模型需要 18–24 个月的准备期,但 GPU 从下单到交付的排队时间已经达到 12–18 个月。更复杂的是,高端 GPU 产能被 NVIDIA、AMD、Broadcom 三家高度集中,云厂商手中的现货库存有限。等你签了云合同,交付可能要等到两年后。等你拿到芯片,项目可能已经错过了最佳窗口。
Anthropic Q3 的实际数据把这个矛盾量化了。营收 $17B 同比增长 12 倍,但运营成本 $17.5B,净亏损 $23B。其中 $5B 的单季短期算力成本,占营收比重接近 30%。这意味着每赚一块钱,就要花五毛钱买算力。而这还是建立在现有产能充足的前提下的假设——一旦供应链进一步收紧,这个数字会更快恶化。
抢算力本质上是在和时间赛跑
这个问题在架构设计上可以类比为典型的「长期基础设施 vs 短期弹性」冲突。传统 IT 架构中,公司通过云厂商获得按需弹性;但在 LLM 时代,弹性本身成为了稀缺资源。谁能提前锁定算力供给,谁就有资格参与这场竞争。这个逻辑转变,正是 8950 亿承诺背后的根本原因。
这组数字的核心问题不在「能不能付得起」,而在「为什么需要预付这么多」。要回答这个问题,必须回到大模型训练的架构本质。
方案A:纯云采购模式
模式逻辑与合同结构
纯云采购是最直观的方案。云厂商拥有现成的 GPU 集群,客户按需租赁即可。AWS、GCP、Azure 都在提供这类服务。
Anthropic 的云合同结构显示:Google Cloud 承诺 $121B,Amazon 承诺 $110B,SpaceX 的星链基础设施计划最高 $120B。这三家构成云侧主力。
这种模式的逻辑是轻资产。Anthropic 不需要自己买芯片、建机房,把资本支出转化为运营支出。短期来看,团队可以专注于模型研发。
架构缺陷与适用边界
但云采购有三个结构性缺陷。
第一,供应链排队。NVIDIA H100、B100 的交付周期长达 12-18 个月。云厂商的 GPU 库存有限,大客户之间竞争激烈。Anthropic 与 Amazon 和 Microsoft 签订长期协议时,这些厂商同样在排队等芯片。
第二,议价权弱。云厂商拥有定价权。随着规模扩大,Anthropic 的算力成本不会线性下降,反而可能因供需紧张而上涨。更准确地说,云采购的成本结构是「按需付费」,但这恰恰是预算最不可控的形态。
第三,长期成本锁定困难。纯云模式适合短期快速验证、团队规模小、技术路线未定型的阶段。一旦进入大规模训练阶段,云采购的单位算力成本会显著高于自建方案。你签的每一个云合同,本质上都是在为云厂商的资本支出买单。
##方案A:纯云采购模式###模
方案B:直接绑定芯片厂+自建数据中心
Broadcom设备租赁模式
Anthropic 选择绕过云厂商,直接与芯片厂合作。招股书披露了 $161B 的 Broadcom 设备租赁承诺。这不是购买,而是租赁——Anthropic 获得硬件使用权,Broadcom 保留所有权并承担折旧。
这种模式的逻辑是锁定长期算力供给。Broadcom 提供定制芯片方案,Anthropic 获得比通用 GPU 更具性价比的算力单元。
更重要的是,这种模式解决了供应链问题。芯片厂直接交付设备,跳过云厂商的中间环节,交付周期可控。
电力与机房资源获取
光有芯片还不够。训练集群需要数据中心和电力支持。
Anthropic 向前加密货币矿企 TeraWulf 购买电力和机房资源。这些矿企在能源转型过程中积累了大量电力基础设施,但业务萎缩后留下闲置产能。Anthropic 以较低成本接手这些资源,相当于「捡漏」。
此外,Anthropic 还在购买 NVIDIA、AMD、Broadcom 的芯片和冷却系统,自建数据中心。这不是简单的设备采购,而是需要工程团队具备数据中心运营能力。
工程挑战与能力要求
自建数据中心的挑战不在硬件,而在运营。
训练集群的可用性要求极高。GPU 故障率、网络延迟、冷却效率,任何一个环节出问题都会导致训练中断。Anthropic 需要建立专门的运维团队,或者依赖合作伙伴的工程能力。
坦白讲,这不是一个 LLM 研究团队擅长的事。但算力已成为基础设施,不做这道题就不可能继续训练更大规模的模型。
更狠的是,每年能省下一个亿——如果你能谈下长期电力协议的话。

##方案B:直接绑定芯片厂+自建
方案C:混合架构
三种路径的组合策略
Anthropic 的实际路径是混合的。云采购用于弹性扩展和短期需求,芯片直租用于长期主力训练,自建数据中心用于核心基础设施。
这种组合的逻辑是风险分散。纯云模式弹性好但成本高,自建模式成本可控但灵活性差。混合架构在两者之间取平衡。
具体来看:Google Cloud 和 Amazon 的合同提供弹性算力,Broadcom 设备租赁锁定核心训练芯片,TeraWulf 的电力资源保障数据中心运营,SpaceX 的星链基础设施用于边缘部署。
成本与风险的权衡
混合架构不是万能解。它要求团队具备多套系统的整合能力,也意味着管理复杂度的上升。
决策的关键在于:什么时候该切哪种方案?
在验证阶段,纯云模式是合理选择。团队规模小,算力需求不确定,快速试错比成本控制更重要。
在规模化阶段,芯片直租+自建是更优选择。训练需求稳定,长期成本成为核心约束,锁定供给比灵活调配更重要。
选型决策框架
关键决策维度
选型可以从三个维度评估:算力需求的确定性、资本支出的容忍度、工程能力的完备性。
算力需求确定性强、资本支出可承受、工程团队完备的组织,适合芯片直租+自建模式。 Anthropic 正处于这个阶段。
算力需求不确定、团队规模小、工程能力有限的组织,适合纯云采购。这在创业早期是理性选择。
大多数组织处于中间状态,混合架构是务实方案。
不同阶段的方案选择
架构选型不是一次决策,而是随阶段演进的动态过程。
验证期选云,规模化选自建,成熟期混合。这不是最优解的追逐,而是约束条件下的妥协。
当算力从「可选项」变成「必选项」,架构设计的重心就从「技术先进性」转向「供给稳定性」。Anthropic 的 8950 亿美元赌局,本质上是这场转移的极端案例。
下一步,你可以今天就做的具体动作是:盘点当前算力需求的确定性程度,评估团队是否具备数据中心运营能力,然后选择一个主路径并预留切换空间。
方案B(AI原生):直接绑定芯片厂+自建数据中心
传统云采购的瓶颈,在训练规模达到一定量级后会急剧放大。Anthropic的做法是把链条往前推——直接与Broadcom建立约161亿美元的设备租赁协议,相当于绕过了云厂商的中间层,直接控制底层硬件。与此同时,Anthropic还向前加密货币矿企和新型云服务商购买电力与机房资源,比如TeraWulf这类已经掌控土地和电力的公司。目的是什么?把长期成本锁定,避免被云厂商的排队时间和价格波动夹击。
更狠的是,Anthropic甚至开始自己采购Nvidia、AMD和Broadcom的芯片以及冷却系统,向数据中心建设领域延伸。这意味着公司的工程能力边界正在从"调用API"扩展到"自建基础设施"。坦白讲,这不是每个AI创业公司都能走的路——需要极强的电力基础设施谈判能力、场地选址能力和长期运维团队。
算力期货化时代,谁先锁定谁能抢到入场券
方案C(混合架构):云+芯片直采+自建协同
大多数处于成长期的公司,其实会选择第三条路:混合架构。在训练初期或技术路线未定型时,用Amazon、Google等云厂商快速验证;当模型架构稳定、训练规模明确后,逐步将核心负载迁移到自建的专线和芯片租赁上;边缘推理和临时需求则留在云上保持弹性。
Anthropic的实际动作印证了这个思路。除了Google(121亿美元)、Amazon(110亿美元)和SpaceX AI部门(最高120亿美元)的云协议外,还通过Lambda Computing和TeraWulf等第三方补充GPU产能,同时与Broadcom签了161亿美元的设备租赁。这个组合的本质是:既保留了云的弹性,又通过直采锁定了部分长期供给。
混合架构的代价是调度复杂度——不同来源的算力在硬件型号、网络拓扑、软件栈上各有差异,需要一套能统一调度的基础设施平台。对绝大多数公司来说,这要求一个成熟的SRE和MLOps团队。

混合架构选择决策流程
选型决策表
三种方案的核心差异,可以归结为四个维度:预算约束、时间窗口、技术路线稳定性、工程能力。下面是一张简化的决策矩阵:
| 场景 | 推荐方案 | 关键理由 |
|---|---|---|
| 早期验证、路线未定型 | 方案A(纯云) | 零CapEx,按小时付费,随时可停 |
| 中等规模、成本敏感 | 方案C(混合) | 核心训练走租赁/专线,边缘推理走云 |
| 超大集群、长期稳定 | 方案B(自建) | 锁定长期成本,掌握供应链主导权 |
| 预算有限、无法自建 | 方案C(混合) | 用第三方租赁商作为弹性缓冲 |
行业趋势也指向混合架构。头部玩家无一例外都在做同样的事:与云厂商签长约的同时,直接绑定芯片供应商,并逐步建立自己的数据中心运营能力。纯粹依赖单一云厂商的模式,正在暴露出明显的供应链风险。

算力的坑,比代码的坑难填得多
Anthropic的8950亿算力赌局,暴露了大模型架构设计的核心矛盾
Anthropic的案例揭示了一个越来越清晰的现实:在大模型时代,算力架构选型不再只是一个技术决策,而是一个战略层面的供应链布局问题。
训练一个顶级大模型,需要数万张GPU连续运行数月甚至数年。而全球GPU产能的交付周期目前仍以年计,云厂商的排队时间同样漫长。这意味着,如果你等到训练需求明确了再去找算力,基本上等于没有算力可用。提前锁定,几乎是唯一选择。但提前锁定意味着提前付费,意味着在公司还没有稳定收入的情况下签下巨额承诺——这正是Anthropic8954亿美元合同背后的逻辑困境。
核心矛盾可以一句话概括:算力不是买得起就能用,而是需要提前锁定、绑定供应商、甚至自己下场建数据中心。这个结论对行业的影响,在于重新定义了"基础设施架构"的边界——它不再只是CTO办公室里的技术选型,而是贯穿融资、供应链、工程能力建设的全局战略。
对于正在考虑算力架构的公司,可以今天就做的三件事:第一,盘点现有和未来12个月的训练需求,量化到GPU小时数;第二,梳理你的工程团队是否具备自建或管理数据中心的能力,如不具备,优先考虑混合模式中的设备租赁部分;第三,与至少两家云厂商和一家芯片租赁商建立早期接触,不要等到需求明确才启动谈判。更狠的是,每年能省下一个亿,前提是你在对的时间签对了合同。
这个数字意味着什么。简单换算一下:以 Q3 营收 170 亿美元计算,公司需要不吃不喝约 53 个季度才能偿还这些承诺。即使计入 $1318 亿美元的现金储备,账面流动性也只覆盖 15% 左右的到期压力。
这不是财务炫技,而是架构选择的必然结果。
业务目标:如何获取足够且稳定的训练算力?
大模型训练的基础设施规模正在经历指数级跃迁。三年前,一个前沿模型训练集群还在百兆瓦级;到 2026 年,头部玩家的设施目标已经指向吉瓦级。
Anthropic 的计划是到 2026 年底算力规模超过 3.5GW。这个数字接近一个中型国家的总用电负荷。数据中心从「租用服务器」变成「控制电站」,基础设施的边界在重新定义。
核心矛盾在于时间维度上的错配:模型训练周期是 12 到 24 个月,而供应链交付周期往往更长。NVIDIA 的 GPU 交期、Broadcom 定制芯片的流片周期、数据中心的电力审批和建設周期,每一条链都没有缩短空间。训练需求提前锁定,采购承诺提前下注,这是架构设计的刚性约束。
| 指标 | Q3 数值 | 同比变化 |
|---|---|---|
| 营收 | $17B | 12x |
| 运营亏损 | $5.0B | 逆转 |
| 算力承诺(累计) | $895.4B | — |
| 2031年前到期承诺 | $447.5B | — |
| 可取消/附带条件部分 | $213.8B | 24% |
数据背后是一个取舍:公司选择用长期确定性对抗短期波动。$698 亿的 12 个月内到期承诺意味着 Q4 和明年上半年就要兑现大量付款义务,而营收曲线还在爬坡。
被安排上算力KPI了
方案A(传统):纯云采购模式——Amazon、Google、Azure
纯云采购的逻辑最直接:按需租赁,即用即付。这个模式在模型探索期非常合理,技术路线未定型时,锁定长期固定资产是风险暴露。
Anthropic 在方案A上的布局:$121B Google、$110B Amazon,以及通过 SpaceX AI 单元高达 $120B 的潜力承诺。这三家云厂商构成基础设施的底座。
但方案A的架构缺陷在规模放大后显现:
第一,供应链排队。Amazon 和 Microsoft 的队列已经排到两年后。Anthropic 被迫转向 Lambda、TeraWulf 等中小云服务商,后者本身是前加密货币矿企转型,手里有现成的土地和电力资源,但运维成熟度不如头部云厂商。
第二,议价权弱。云厂商掌握定价权,长期来看成本不可控。当算力从「按需」变成「长期绑定」,供应商的位置会翻转。
第三,定制化受限。GPU 规格、网络拓扑、冷却方案,标准云服务的可调空间有限。前沿模型训练需要高度定制化,通用云架构成为瓶颈。
方案A的适用边界清晰:技术路线未定型阶段、团队规模有限、快速验证优先于成本优化。一旦进入规模化训练,这个方案的边际成本会显著上升。
方案B(AI原生):直接绑定芯片厂+自建数据中心
方案B的逻辑是绕过中间层,直接控制供应链上游。Anthropic 的核心动作是 $161B 的 Broadcom 设备租赁协议,加上向前矿工购买电力和机房资源。
这个模式的架构优势在三个维度:
长期成本锁定。芯片厂和设备租赁商的价格稳定性高于云厂商的动态定价。$161B 的框架协议把核心硬件成本固定在签约时点。
定制化能力。Broadcom 为 Anthropic 定制的训练芯片可以直接匹配模型架构需求,不需要适配通用 GPU 的软件栈。
供应链安全。在云厂商排队两年、芯片交期延长的背景下,直接绑定上游是绕过 bottlenecks 的有效路径。
工程挑战同样明确:数据中心运营需要不同的人才结构和组织形态,电力基础设施谈判是全新能力域。Anthropic 为此收购了相关团队,从前矿工手里买来现成的土地和电力容量,本质是购买时间。
这个方案的适用条件是:技术路线相对明确、长期稳定训练需求可预期、公司有资金实力承担前期重资产投入。
算力架构的本质是供应链管理
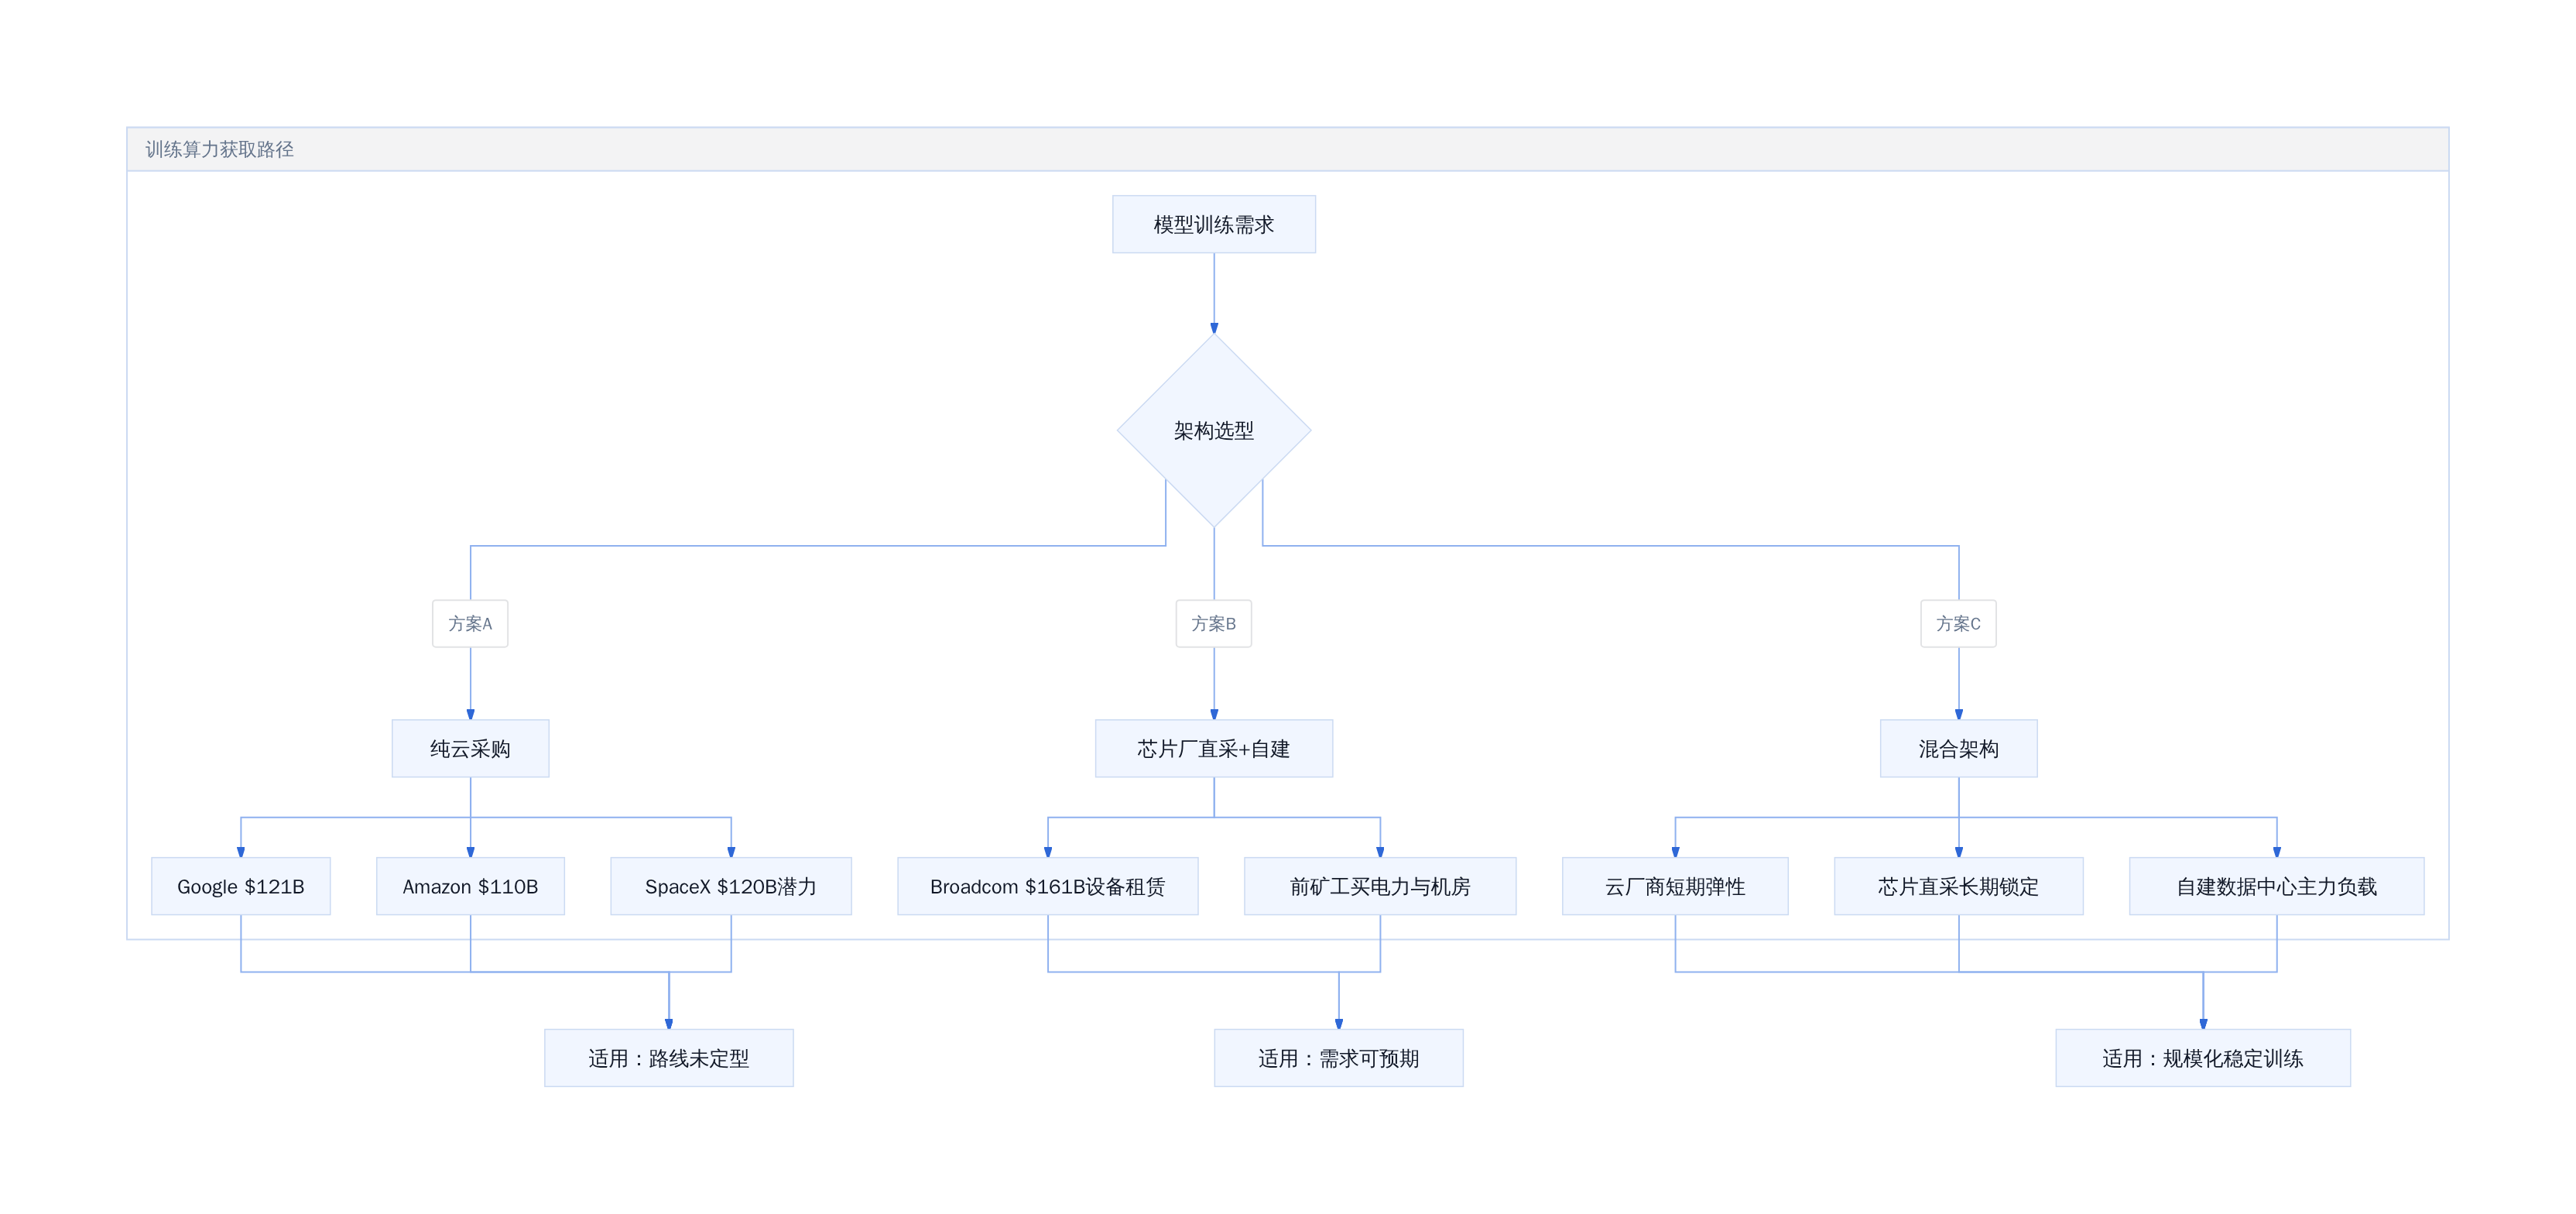
模型训练需求
方案C(混合架构):云+芯片直采+自建协同
Anthropic 实际走的是方案C——混合架构。三种模式的组合不是简单叠加,而是按负载类型和时序分层:
短期弹性需求走云。模型调试、小规模实验、突发训练任务用云厂商的即时算力。
主力负载走自建。核心模型训练绑定 Broadcom 定制芯片和直采设备,避开供应链排队。
电力和机房资源通过并购获取。TeraWulf 等前矿工手里有现成的电力容量和土地,比新建更快。
这种架构的决策逻辑可以用一张矩阵表达:
| 维度 | 方案A(云) | 方案B(自建) | 方案C(混合) |
|---|---|---|---|
| 初期投入 | 低 | 极高 | 中高 |
| 长期成本可控性 | 弱 | 强 | 强 |
| 供应链风险 | 高(排队) | 低(直采) | 中 |
| 灵活性 | 高 | 低 | 高 |
| 适用阶段 | 探索期 | 规模化期 | 过渡+稳定期 |
混合架构的关键决策点在于分层比例。云的比例决定了灵活性和短期成本,自建的比例决定了长期成本结构。Anthropic 的选择是把主力负载交给自建,保留云作为弹性补充。
选型结论很直接:如果技术路线明确、训练规模可预期,混合架构是当前阶段的理性选择。纯云在规模化后会失控成本,纯自建需要漫长的能力建设周期。混合模式在两者之间找到了平衡点,代价是架构复杂度上升。
更狠的是,这个平衡点本身会随时间移动——当云厂商的队列缩短、芯片供应增加,方案A的吸引力会回升。架构选择不是静态的,需要持续评估。
Anthropic 的 8950 亿赌局暴露的底层逻辑是:大模型训练的基础设施架构已经从「算力采购」变成「算力供应链控制」。谁能更早锁定芯片、电力、土地的组合,谁就有资格参与下一轮模型竞赛。
参考文献
[1] 全球科技与金融 on X: "Cronjob Response: ☕ Kopi AI 热点日报 (job_id: 8d38408efbe1) ------------- ☕ Kopi AI 早报 | 2026年11月03日 1. Anthropic 算力与基础设施合同承诺达 $895.4B,其中 $447.5B 须在 2031 年前支付 Anthropic 在更新的 IPO 文件中首次披露第三季度业绩,算力与基础设施合同承诺总额约 $895.4B,其中 $447.5B 须在 2031 年前支付,仅 $213.8B 可取消或附带条件。... 2. OpenAI 训练并部署激活分类器… / X. https://x.com/linyiq/status/2117409225622397300 [2] 实时. https://newsnow.busiyi.world/c/realtime [3] AI 快报 · 2026年11月3日(周二). https://www.cozvint.com/ai-news/2026-11-03.html [4] AI 简报· 2026-11-03. https://www.asdfoffice.com/2026/11/03/ai-%E7%AE%80%E6%8A%A5-%C2%B7-2026-11-03 [5] 2026-11-02 更新雷达 | sagasu 新闻雷达. https://news.sagasu.art [6] AI 热点最新资讯- 最新榜单与往期内容. https://aitools.piclab.top/hot/aihot [7] Rohan Paul on X: "Anthropic has committed $895.4B to computing and infrastructure, with $447.5B due before 2031. $161 B in Broadcom equipment leases, $121 B with Google, up to $120B with SpaceX and $110B with Amazon. With Amazon and Microsoft backlogged, Anthropic signed up GPU renters like Lambd… / X. https://x.com/rohanpaul_ai/status/2117368258571784296 [8] Anthropic还在疯狂抢算力:8954亿美元承诺,连旧煤电厂都不放过-36氪. https://www.36kr.com/p/4053431139128451
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师