《纽约时报》在起诉微软和 OpenAI 的版权案中申请简易判决并提交新法律摘要,披露两家公司内部材料。这份法律摘要引用了两份关键文件。其一,微软应用科学总监布伦特·赫克特于 2023 年 1 月撰写的内部备忘录,称全球数百万人会将大型模型「吞噬」其作品视为一场前所未有的惊人盗窃,并进一步表述为「人类历史上最大规模的劳动窃取」。其二,微软内部数据显示,Copilot 产品使《纽约时报》网站点击率较 Bing 搜索最高下降 93%。两份材料性质不同,前者是价值判断,后者是系统观测。放在一起看,指向同一个事实:AI 产品的增长路径正在侵蚀训练语料的来源市场。
赫克特的备忘录中还提出了一个术语——「毁灭循环」。其逻辑链条清晰。模型减少新闻网站流量,流量减少导致新闻机构收入下滑,收入下滑迫使新闻机构裁员或减少发稿量,最终模型失去高质量、可持续输入的来源。这是一个典型的系统性外部性问题。工程团队习惯于把训练语料当作固定资源池,假定数据供给不会随模型规模变化。赫克特的备忘录实际上在提醒:数据供给是动态的,且依赖于上游供应商的经济生存能力。更关键的是,这个循环一旦发生,模型自身的性能也会因语料质量下降而受损。
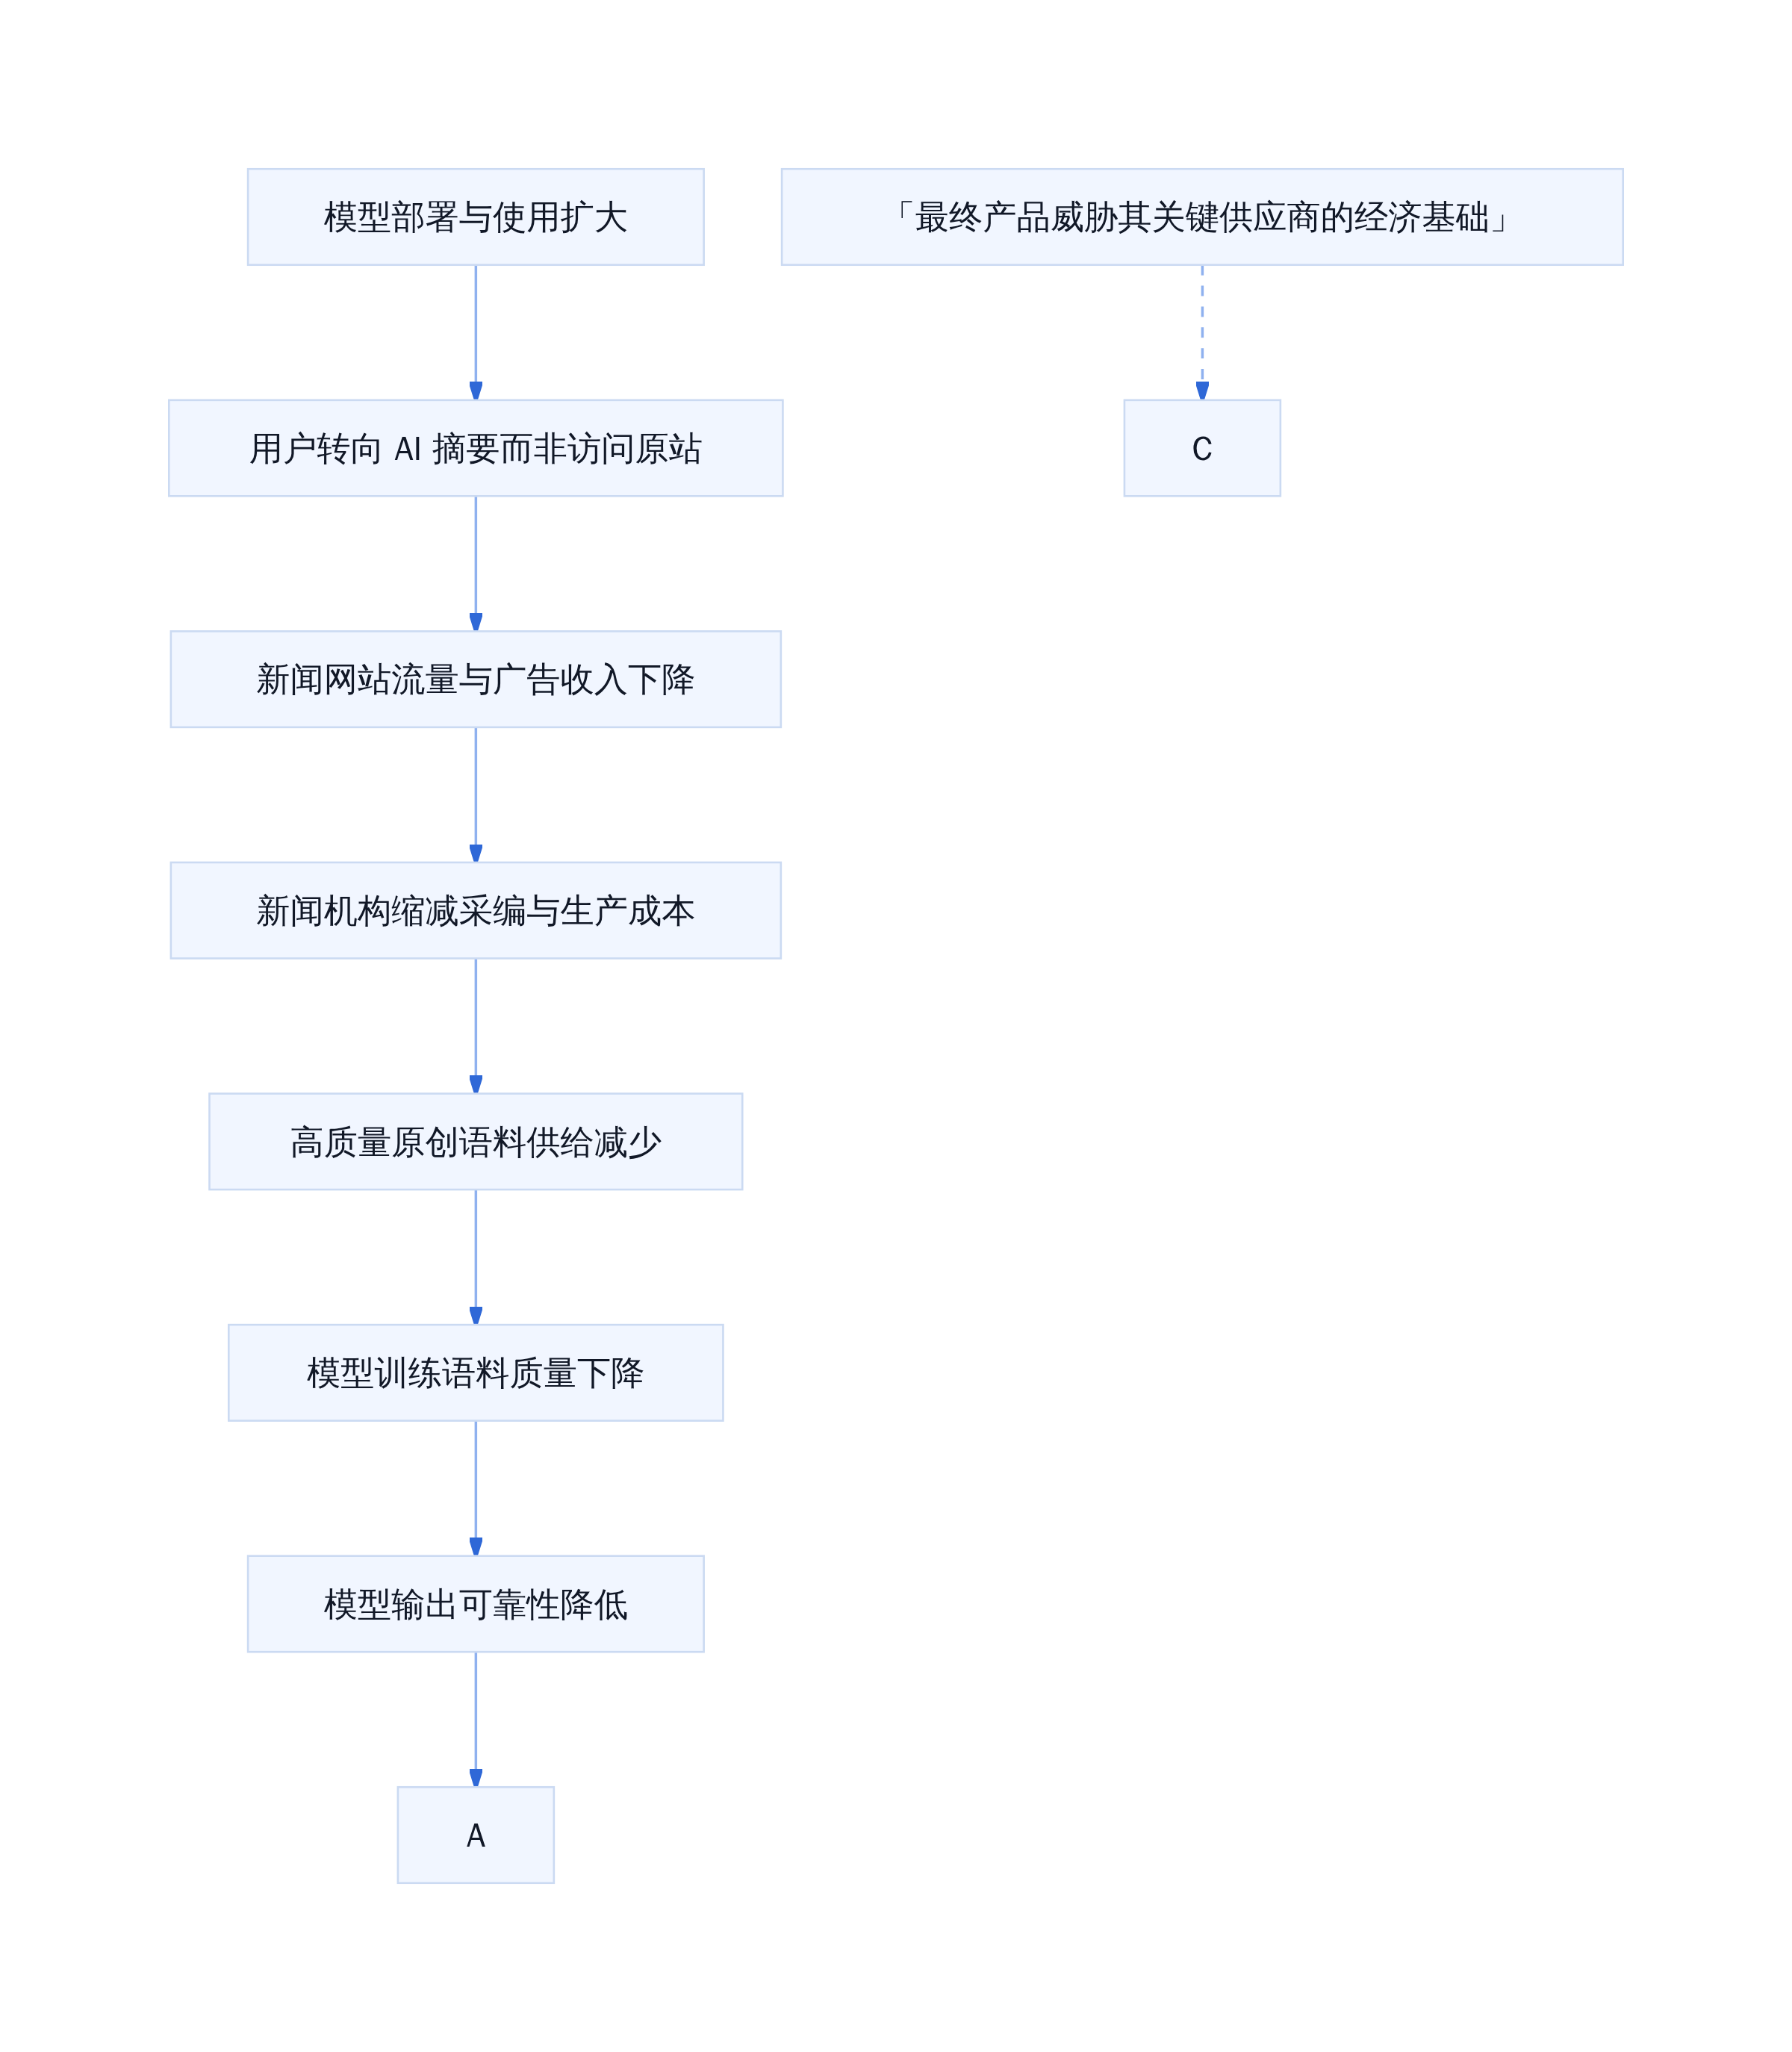
模型毁灭循环机制
从法律角度切入,这场诉讼的核心争点之一是「合理使用」。美国版权法中的合理使用四要素检验包括:使用目的与性质、作品性质、使用部分占整体作品的比例、以及对原作品潜在市场或价值的影响。前三个要素通常对被告有利——模型使用属于转换性使用,新闻内容具有事实属性,抓取比例难以按篇计算。但第四个要素是原告最有力的支点。微软内部数据给出的 93% 点击率下降,直接指向市场替代效应。纳德拉在庭审证词中表示,如果早知道抓取涉及侵权,公司会强制要求重新训练。这句话在工程层面的含义是:合规机制在事发前并未嵌入数据采集管道,而是在法务风险评估之后才进入决策层。系统设计上是事后响应,而非事前控制。
理解这个披露的工程意义,不在于判断谁对谁错,而在于看清一套系统的风险边界。训练语料获取有两种主流路径。第一种是自建授权语料库:与出版商、内容平台签订数据授权协议,按篇或按 token 计费。成本可控,但规模扩张受限。第二种是无许可爬取公开内容,成本低,规模扩展快,但法律风险随使用规模呈非线性增长。赫克特的备忘录实际上揭示了第二种路径的系统性缺陷:当你把供应商的经济基础削弱到不可持续,供应商就会减少生产,最终你自己也失去可用的语料。这不是道德判断,而是系统工程的约束条件。
对于正在设计数据管道和模型训练架构的团队来说,这份披露提供了三条可执行的建议。第一,建立语料来源分级机制。区分可商业化的公开数据、需授权的内容和高风险材料,并在数据采集层实施自动过滤。第二,引入成本内部化假设。在训练预算中预留数据授权费用,避免把上游供应商的产出当作零成本公共品。第三,把法律风险评估纳入系统设计周期,而不是在项目上线前的法务 review 阶段才进入视野。这三条建议的共同前提是:训练语料不是无限资源,它是供应链的一环。切断或削弱供应链,系统最终会反噬自身。
赫克特的备忘录提出「毁灭循环」概念:模型减少新闻流量,流量下滑压缩新闻机构收入,新闻机构被迫裁员或减少发稿量,最终模型失去可持续的高质量输入来源。更准确地说,这不是版权纠纷的常规叙事,而是一个产品增长路径正在侵蚀训练语料来源市场的结构性问题
两份材料的性质差异
赫克特的备忘录与微软内部数据的差异,决定了它们在诉讼中的不同功能。前者是价值判断,后者是系统观测。这两类材料放在一起才构成完整的证据链。
赫克特在 2023 年 1 月的备忘录中写道:「全球数百万人很快就会认为,大型模型『吞噬』他们所有作品的行为是一场规模空前的惊人盗窃。」这句话的核心不是法律论证,而是对市场认知的前瞻判断。他指出,作者群体几乎不会同意自己的内容以这种方式被使用,且没有获得补偿。这种判断如果成立,会直接影响「合理使用」原则中关于「是否损害原作市场」的评估标准。
相比之下,微软内部数据给出了可量化的结果。Copilot 产品上线后,《纽约时报》网站通过 Bing 搜索获得的点击率较此前下降了最高 93%。这个数据直接回应了赫克特的价值判断。更狠的是,这个下降幅度意味着新闻机构的广告收入可能遭受同等比例的冲击。你买的旗舰款,瞬间变成平替套餐。

流量下滑与收入承压的双向映射
毁灭循环的系统性机制
模型与新闻机构的正反馈关系如何被打破,以及为什么这是一个典型的外部性问题。
赫克特在另一份文件中用「毁灭循环」描述了这个过程:AI 产品不断减少新闻网站的流量和收入 → 新闻机构减少内容生产或裁员 → AI 模型失去高质量输入来源。这个链条的逻辑密度很高,但它的真正危险在于,它是一个典型的系统性外部性问题。模型开发团队把训练语料当作固定资源池,假定数据供给不会随模型规模变化。赫克特的备忘录实际上在提醒:数据供给是动态的,且依赖于上游供应商的经济生存能力。
从系统架构的角度看,这个循环可以表示为以下的因果链条:
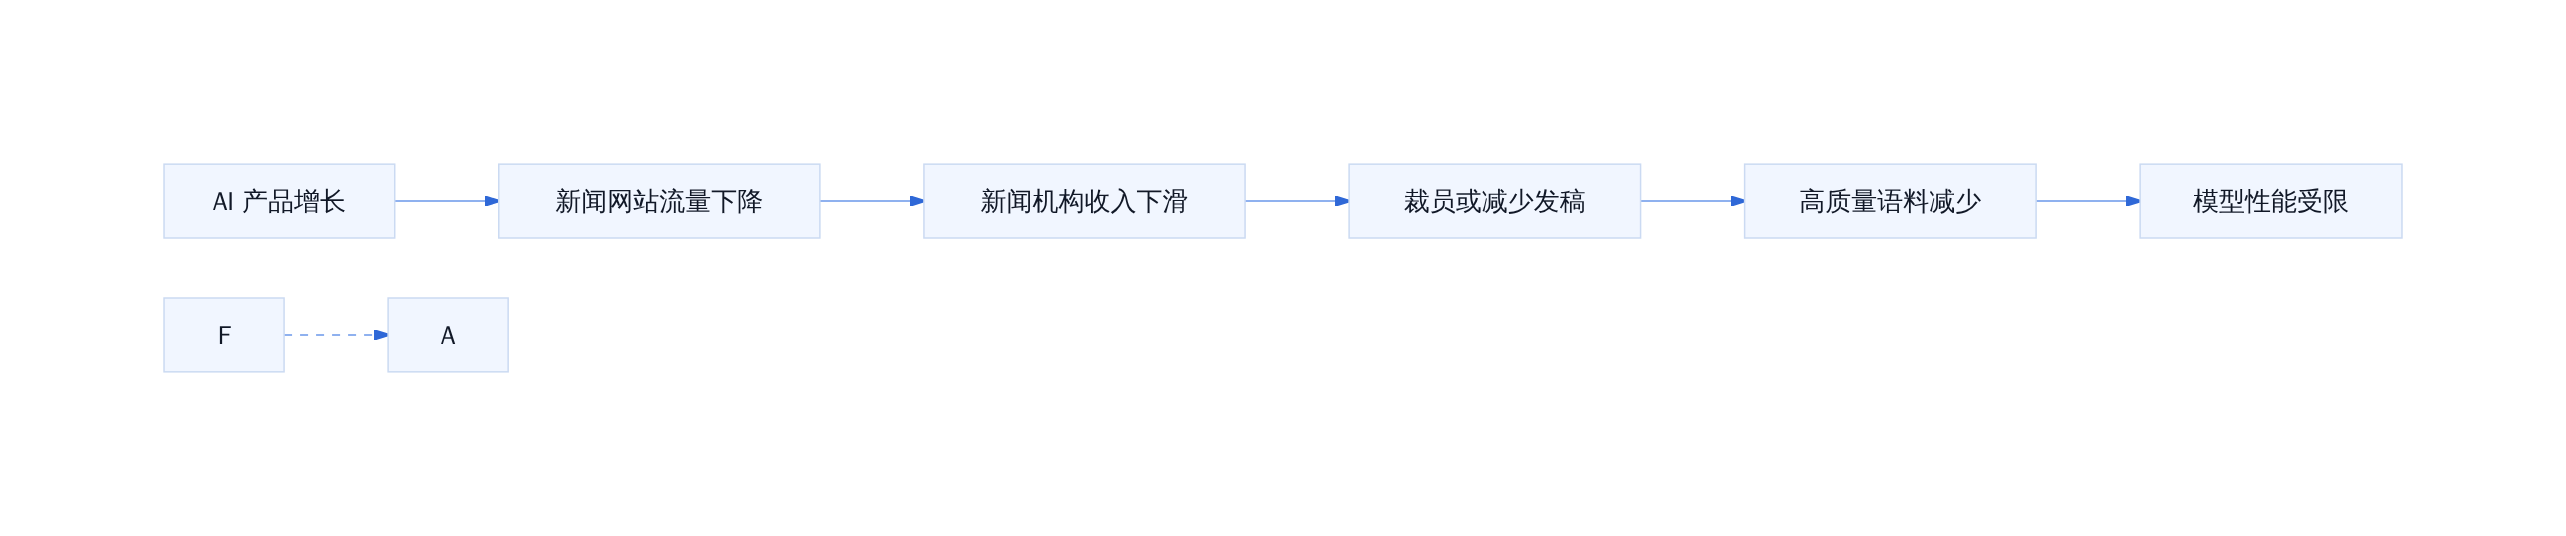
毁灭循环机制
这本质上是一个负反馈环。模型依赖的输入源被模型自身破坏,最终反噬模型自身的性能上限。工程团队习惯把数据当作给定输入,但赫克特的备忘录指出,这个输入是可耗竭的。
工程视角的盲区
传统训练 pipeline 的假设如何与动态数据供给产生冲突。
在传统的 ML 项目中,数据供给通常被视为一个静态前提。Crawl budget 设定、数据采集频率、清洗规则——这些是工程问题,不是战略问题。但在 AI 训练的语境下,这个假设开始失效。新闻机构的内容生产不是无成本的,它依赖流量变现的闭环。当模型替代了用户访问新闻网站的需求,这个闭环就被打破了。
更准确地说,工程团队面临的问题是:训练语料的供给曲线不是垂直的。这意味着当需求(模型规模)增加时,供给(高质量新闻内容)不仅不会弹性响应,反而可能被压缩。这是一个与常规资源分配完全不同的约束条件。
OpenAI 的 ChatGPT 负责人 Nick Turley 在内部沟通中也承认:「我们的产品在很大程度上是替代性的。」这个表述比赫克特的「毁灭循环」更直白。替代性意味着用户行为的迁移,而不是增量竞争。当迁移发生,上游供应商的收入结构就会重构。

模型增长与语料枯竭的代价
可选的迁移路径
授权采买、crawl budget 调整、模型微调三条路径的成本与边界。
面对这个结构性矛盾,有三种典型的应对路径。每条路径的取舍条件不同,不存在通用最优解。
第一种是授权采买。新闻机构付费授权内容用于训练,这是最直接的解决方案。成本方面,大型出版集团的授权费用可能在数百万到数千万美元级别,取决于内容覆盖范围和使用权限。适用条件是:模型规模足够大、语料需求足够刚性、预算可控。这个方案的边界在于,授权费本身就是新闻机构的新收入来源,可能改变其商业模式,但也可能让模型开发团队付出高昂代价。
第二种是 crawl budget 调整。限制对特定新闻网站的抓取频率和覆盖深度,用总量控制替代直接授权。成本更低,但风险也更高。新闻网站可以通过 robots.txt、付费墙、CAPTCHA 等方式强化保护。适用条件是:模型对特定来源的依赖度不高、有其他语料来源可替代。这个方案的边界在于,如果大多数高质量新闻网站都加强保护,模型的语料质量会系统性下降。
第三种是模型微调。用授权的高质量数据对已有模型进行 SFT,减少对原始爬取数据的依赖。成本介于前两者之间,取决于微调规模和目标性能。适用条件是:已有基础模型、微调数据需求可控。这个方案的边界在于,微调无法完全替代预训练的语料规模效应,特别是在开放域任务上。
选型决策
在不同条件下各方案的适用性评估。
从工程决策的角度,三种路径的适用条件可以概括如下:
在模型刚起步、语料需求小、预算有限时,crawl budget 调整是优先级最高的选项。它的迁移成本低,且不会立即触发法律风险。但当模型规模扩大后,这个选项的成本会非线性上升,因为需要不断寻找替代语料来源。
在模型已经进入商业化阶段、语料需求刚性、且目标市场依赖高质量内容时,授权采买是更可持续的选择。它的成本是显性的,且能建立长期稳定的语料供应关系。但前提是,授权协议的设计需要避免排他性条款,否则可能引发反垄断审查。
模型微调是一种中间路径,适合那些已经拥有基础模型、且微调目标明确的项目。它的迁移成本最低,但性能上限也受限于微调数据的规模和质量。
这个决策框架的核心不是「哪种方案最好」,而是「在什么条件下选哪种」。赫克特的备忘录揭示的,正是这个条件正在发生系统性变化:当模型增长开始侵蚀语料供给的基础时,传统的「先抓取、后授权」逻辑就不再适用。工程团队需要面对的,不是如何优化现有 pipeline,而是如何重新定义数据供给的契约结构。
毁灭循环的工程拆解
赫克特的备忘录把问题讲清楚了。模型减少新闻网站流量,流量减少导致收入下滑,收入下滑迫使机构裁员或削减发稿量,最终模型失去高质量输入来源。
这个链条的关键节点在「流量替代」。Copilot 直接替代了 Bing 搜索的新闻点击行为。用户不再需要打开纽约时报页面阅读全文,模型已经提取了核心信息。这就是典型的供给侧替代效应。
更准确地说,这是一个负反馈回路。模型性能提升导致替代率上升,替代率上升导致上游供应萎缩,供应萎缩反过来约束模型性能上限。
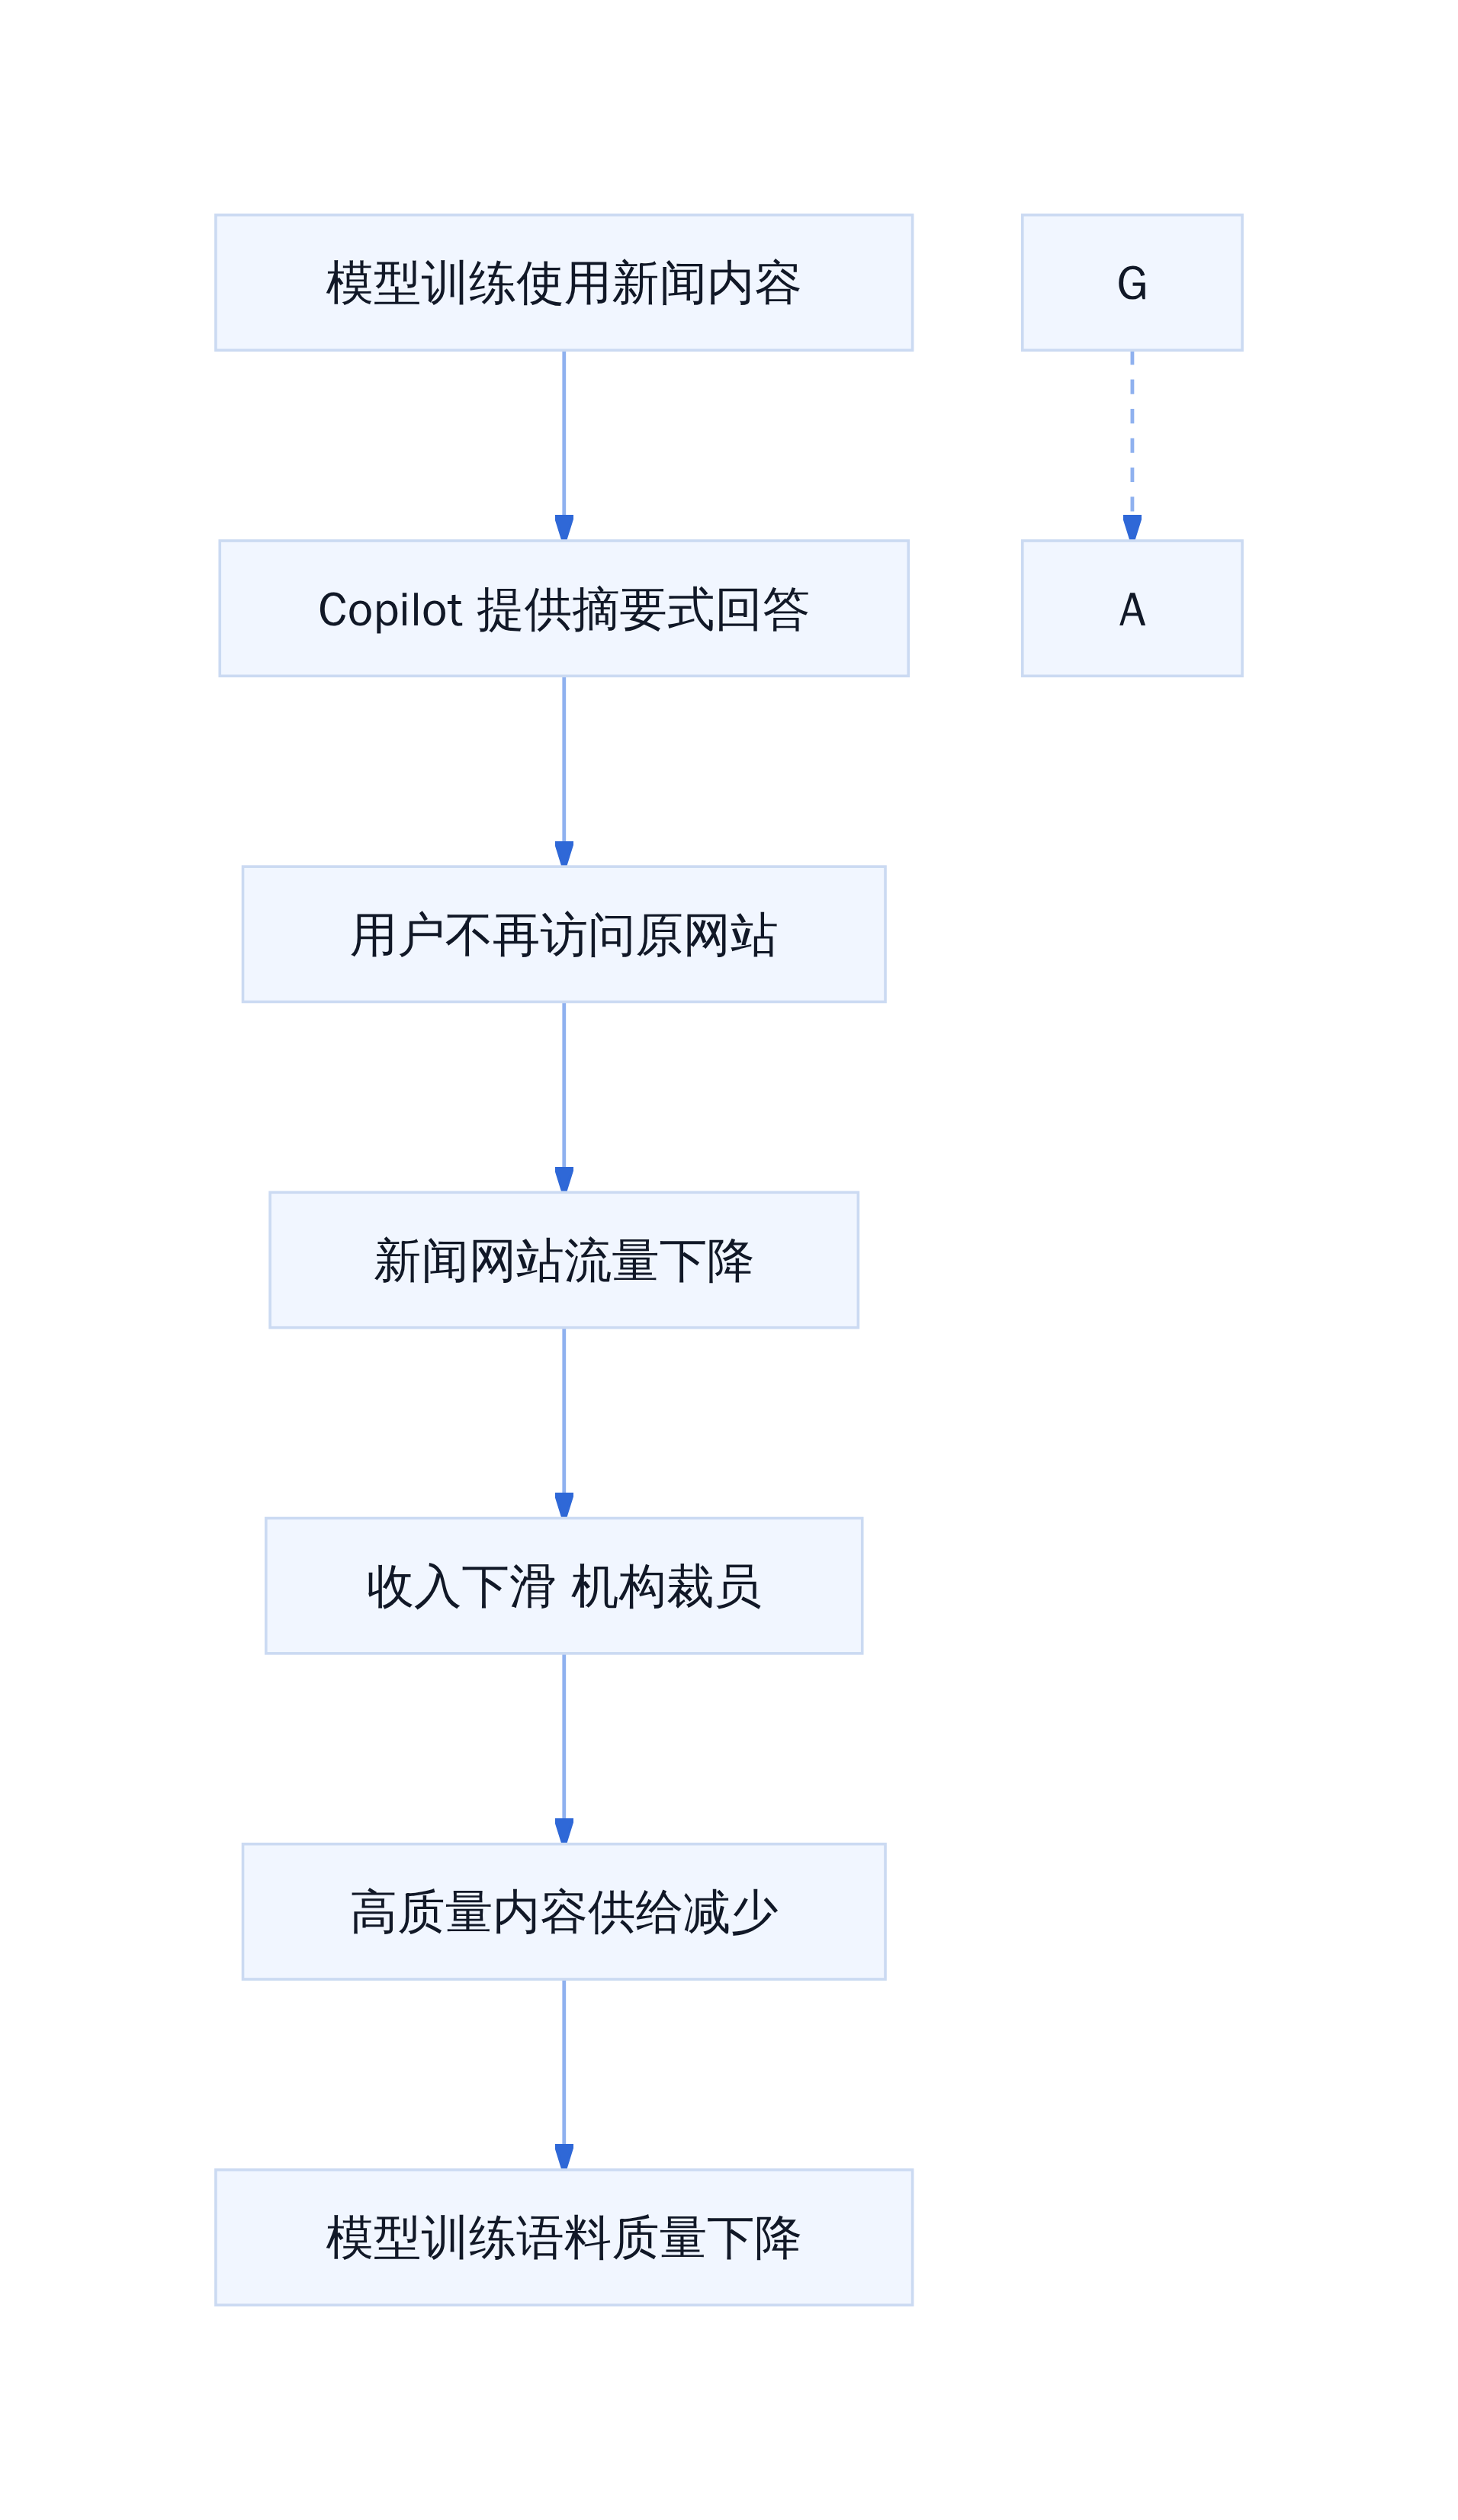
毁灭循环机制
工程团队习惯于把训练语料当作固定资源池。假定数据供给不会随模型规模变化。赫克特的备忘录实际上在提醒:数据供给是动态的,且依赖于上游供应商的经济生存能力。
更关键的是,这个循环一旦发生,模型自身的性能也会因语料质量下降而受限。这是外部性内化的典型失败案例。
##毁灭循环的工程拆解赫克特的备
两种材料的性质差异
赫克特的备忘录属于价值判断。他在使用「盗窃」一词时,表达的是一种伦理定性,而非技术描述。
微软内部数据显示 Copilot 使纽约时报点击率较 Bing 最高下降 93%,这是系统观测。数字本身不包含立场,但可以被用来支撑立场。
这两类材料在法律上具有不同性质。前者可能被视作内部讨论中的个人意见,后者则是可量化验证的产品影响指标。
《纽约时报》律师团队的策略很聪明。他们用价值判断建立道德叙事,用系统观测建立因果链条。前者让故事可读,后者让案件可判。
微软发言人回应称赫克特的言论是「个人观点,不代表公司立场」。这种切割在法律上有效吗?取决于法官如何看待内部讨论与官方政策的边界。
迁移路径与选型
面对毁灭循环,有三条可选路径。
路径 A 是授权采购。与新闻机构签订数据授权协议,按使用量付费。这条路合规成本最高,但能维持内容供应链的可持续性。行业已有先例,OpenAI 与新闻集团达成的合作协议就是参考样本。
路径 B 是合成数据替代。用模型生成的内容替代部分训练语料。这条路成本最低,但存在「模型自嗨」风险——模型在自我强化中逐渐偏离真实分布。
路径 C 是混合架构。核心能力继续使用授权数据训练,外围功能转向合成数据或开放语料。这条路兼顾合规与效率,但架构复杂度最高。
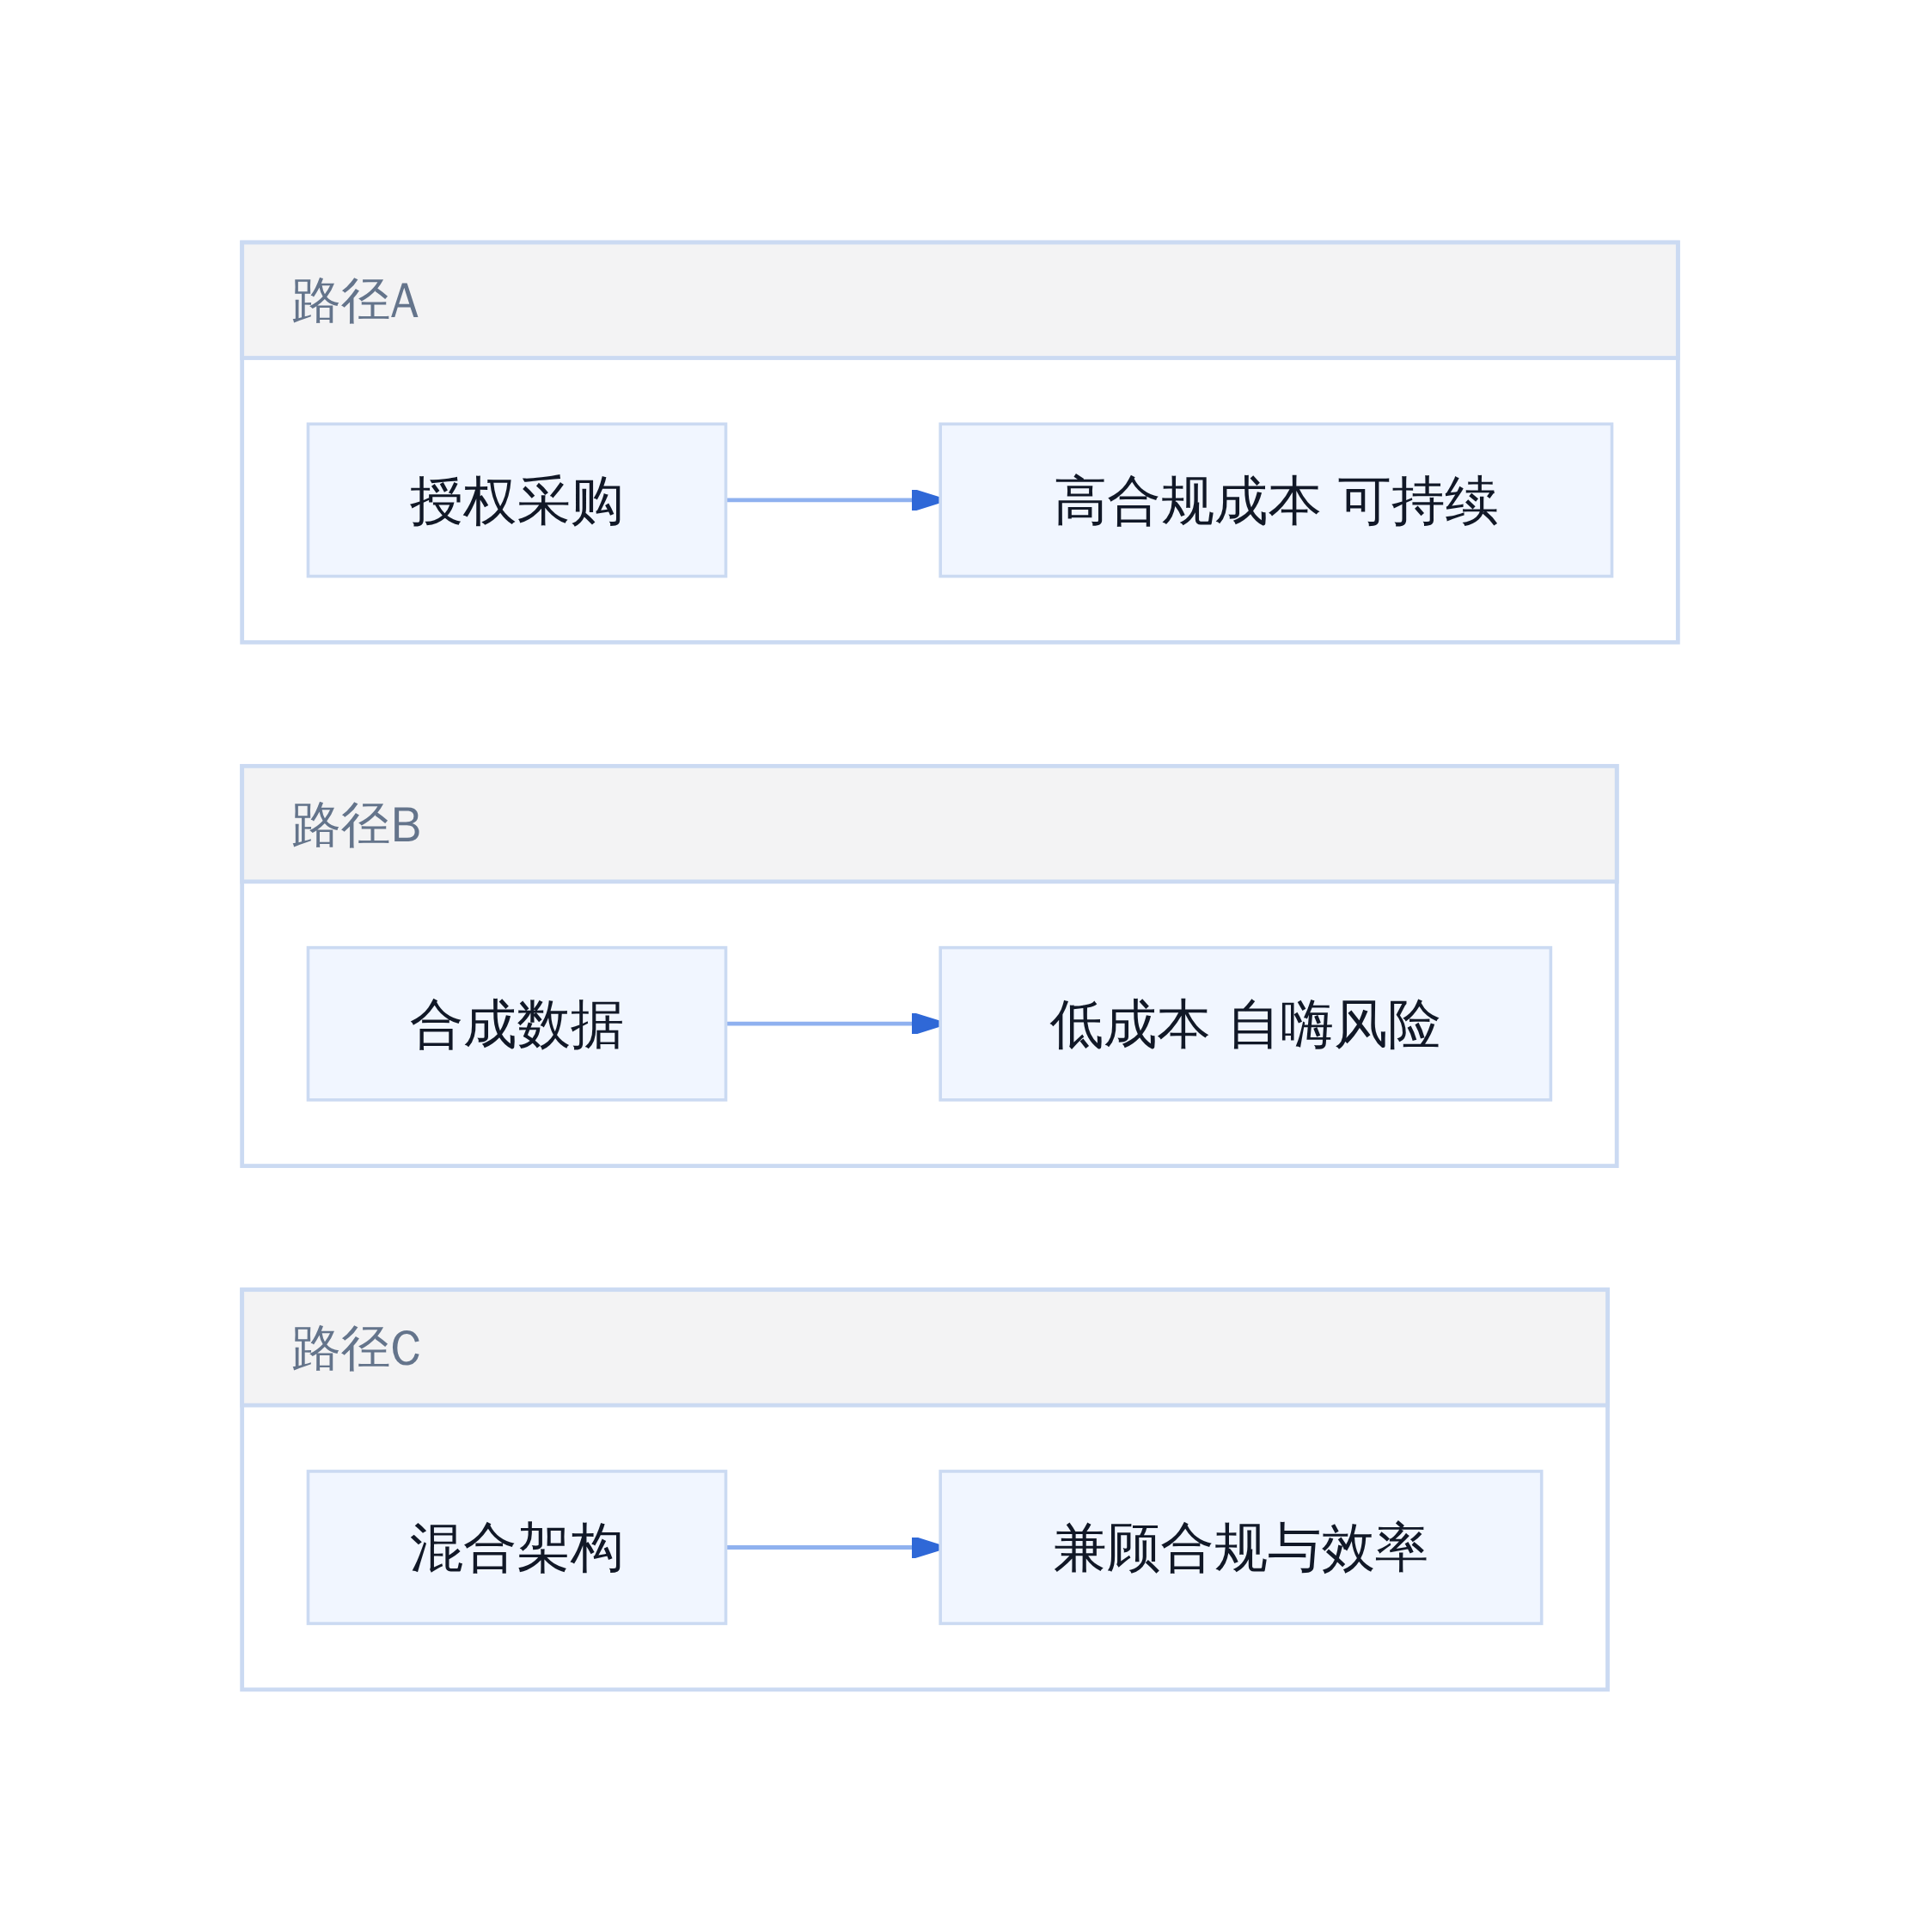
三条迁移路径对比
选型决策取决于三个变量:预算约束、性能上限、时间窗口。
预算充足且时间充裕,选路径 A。性能临界且预算紧张,选路径 B 但要控制比例。两者都需要,选路径 C。
边界的重新划定
合理使用原则的核心要件是「不得损害原作市场」。赫克特的备忘录和内部数据共同指向一个问题:AI 产品的增长是否正在损害新闻内容的市场价值?
这个问题没有标准答案。它需要法庭在具体案件中进行利益衡量。
从工程角度看,更值得讨论的是如何重新设计产品形态以避免这种冲突。不是简单地把数据抓走后装作无事发生,而是在架构层面建立对上游供应链的尊重机制。
纳德拉在庭审证词中表示,付费版权内容必须获得授权,若早知违规将强制要求重新训练。这句话释放的信号很明确:合规成本可能会被追溯。
这改变了整个行业的计算方式。不再是「先训练再说」,而是「先确认授权再说」。
坦白讲,这对早期入局的玩家是个教训。他们赌的是法律滞后,结果法律没有滞后太久。
从被动合规到主动设计,是这场诉讼留给行业的真正遗产。
两份文件的性质不同,但放在一起看,指向同一个事实:AI 产品的增长路径正在侵蚀训练语料的来源市场。
两份材料的性质差异
赫克特的备忘录是一份价值判断,核心论点是「大规模抓取受版权保护的内容而不支付补偿,构成一种前所未有的盗窃行为」。这份备忘录写于 2023 年 1 月,当时 ChatGPT 刚刚发布数月,行业普遍还在讨论「是否违法」的阶段,而他已经在内部预警商业模式的可持续性风险。
另一份材料——Copilot 使纽约时报点击率下降 93%——是系统观测数据。这是微软内部通过 Bing 搜索流量与 Copilot 引用流量对比得出的结论,属于产品层面的效果度量,而非法律论证。
前者是态度,后者是证据。放在一起,构成一个完整的指控链条:公司高层明知大规模抓取存在道德争议,同时内部数据已经显示产品对源站流量造成了实质性替代。
更准确地说,这两份材料的差异在于它们所处的论证层级。赫克特的备忘录属于伦理与合规层面的内部警示,目的是推动政策讨论;而流量数据是产品运营层面的客观记录,无法用主观意图抹去。
当原告在法庭摘要中同时引用这两种性质的材料时,他们实际上是在说:你们知道这样做有问题,而且你们的数据已经证明了问题有多大。
可选的迁移路径
面对这个结构性矛盾,技术团队有三类可选路径。
第一种是合规授权路径。与内容提供商建立数据许可协议,按使用量付费。这条路最干净,但成本最高。微软与部分出版商的谈判进展缓慢,原因是定价框架尚未建立——按篇计费、按调用计费、还是按订阅分成,每种方案都会影响模型的边际成本结构。
第二种是合成数据路径。用高质量数据训练小模型,再用小模型生成补充训练数据。这条路能降低对原始语料的依赖,但合成数据的多样性和真实性存疑,且会产生额外的计算开销。
第三种是架构降级路径。放弃追求通用大模型,转向垂直领域的专用模型。这类模型语料需求更小,对泛化能力要求更低,但商业想象空间也相应收窄。
``mermaid
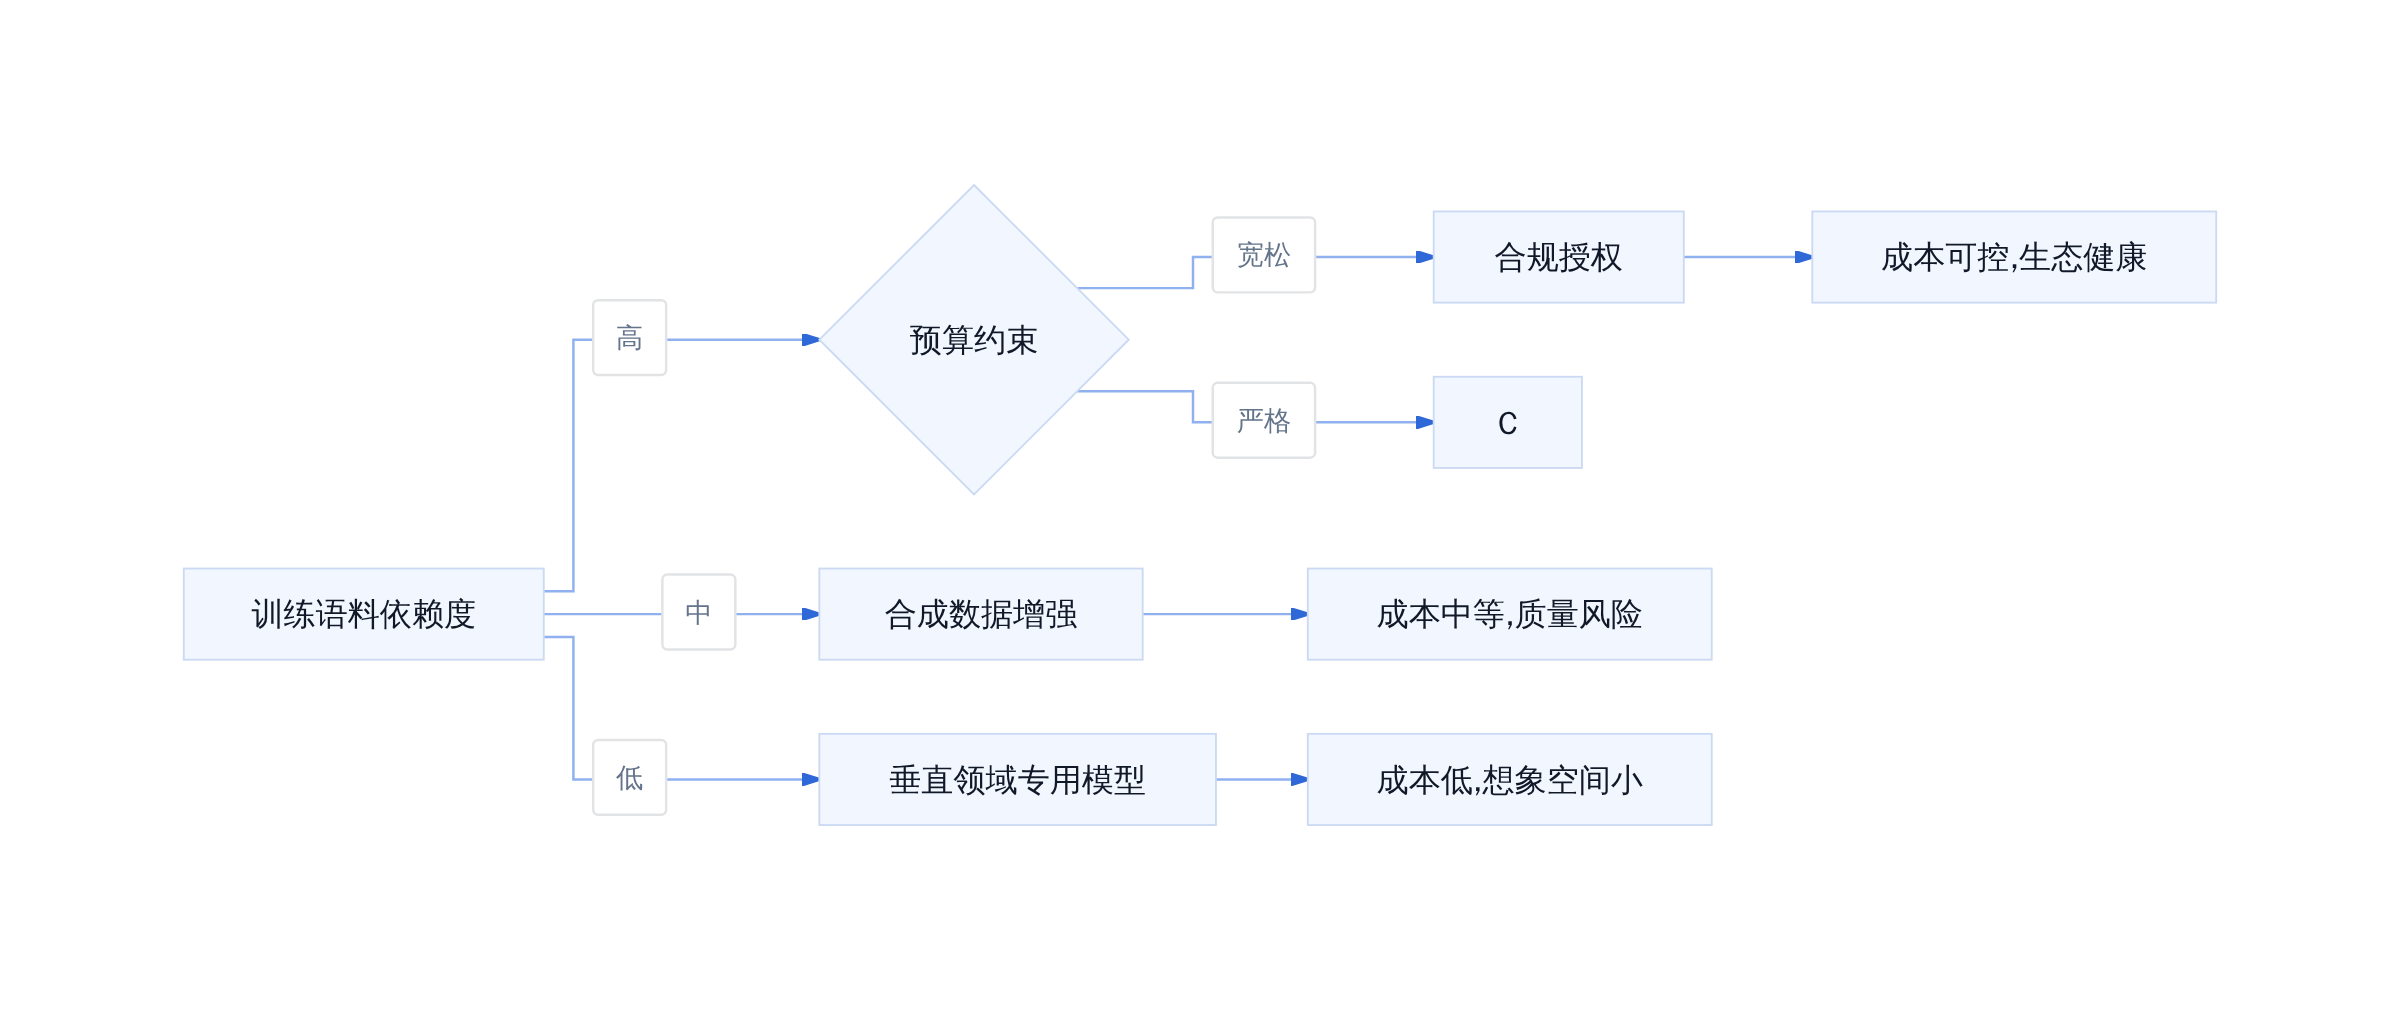
迁移路径选型决策树
选型决策与边界条件
三种路径没有绝对的优劣,取决于两个变量:预算约束和性能目标。
在预算充足且性能要求高的场景下,合规授权是唯一可持续的选择。代价是模型训练成本会上浮,这部分成本最终会转嫁给产品定价。
在预算受限但性能要求中等的场景下,合成数据增强是折中方案。代价是数据质量控制成本和潜在的性能上限压制。
在性能要求低且预算严格的场景下,垂直专用模型是最务实的选择。代价是商业天花板明显。
坦白讲,目前行业普遍选择的路径是前两条的混合——一边谈授权,一边用合成数据填补缺口。这种策略的风险在于,如果授权谈判失败,合成数据的规模和质量瓶颈会立即暴露。
纳德拉在庭审证词中表示,如果事先知道抓取行为违法,会强制要求重新训练。这句话释放了一个信号:微软内部已经意识到合规成本是必然支出,只是时间节点的问题。
对工程团队而言,真正的挑战不是技术层面能否实现迁移,而是迁移成本是否在商业模型可承受范围内。赫克特的备忘录之所以重要,是因为他把这个成本结构从道德判断转化为了工程风险——当你的数据供应商开始衰败时,你的系统就不再是增长的,而是在自我消耗。
这个结论的边界条件很明确:它适用于依赖公开网络内容训练的通用大模型。对于使用授权数据集或封闭语料的专用模型,毁灭循环不存在。
参考资料:
- 微软内部备忘录(Brent Hecht,2023年1月),via NYT v. Microsoft/OpenAI 法庭文件
- 微软内部流量数据:Copilot vs Bing 对纽约时报点击率影响,via NYT v. Microsoft/OpenAI 法庭文件
- 微软 CEO Satya Nadella 庭审证词,via 公开法庭记录
- 报道来源:IT之家、澎湃新闻、21世纪经济报道等(2026年9月)
参考文献
[1] 微软高管内部文件曝光 称AI训练或是“人类历史上最大规模劳动窃取”|ai训练|知名企业|openai|人工智能模型_网易订阅. https://www.163.com/dy/article/L759858P0511BLFD.html [2] 微软高管内部表述曝光,称训练AI 是“人类历史上最大规模 .... https://www.ithome.com/1/004/356.htm [3] 微软内部对AI学习的批评:称其为“人类历史上最大的劳动盗窃”. https://www.ajudaily.com/view/20260918133670655 [4] 微软高管内部文件:AI训练或是史上最大规模"窃取". https://www.backchina.com/news/2026/09/19/1048181.html [5] “最大规模的劳动盗窃”!OpenAI和微软高管承认AI或破坏新闻业. https://finance.eastmoney.com/a/202609183878592692.html [6] 新文件披露:微软高管称AI数据抓取为“史上最大劳动盗窃” | 热门动态 | HyperAI超神经. https://hyper.ai/cn/stories/2c509c3d0d19214e90defda68e48edf6 [7] 微软高管:AI训练是“人类历史上最大规模的劳动盗窃”. https://m.sohu.com/a/1077819029_115831?scm=10001.325_13-325_13.0.0-0-0-0-0.5_1334 [8] 诉讼文件披露一微软高管称AI训练是“人类历史上最大规模 .... https://tech.ifeng.com/c/8wXQtXrEfbr
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师