据 CNN 报道,美国特种作战司令部一名分析人员用聊天机器人分析中国船只舱单,生成的情报报告误报船上载有核武器项目部件,美军一度准备在空中支援下拦截登船,随后才发现聊天机器人错误识别了船上货物。
AI 幻觉导致的错误情报险些引发美军拦截中国船只
事件发生在今年美伊战争期间。一名太平洋特种作战司令部的分析员拿到一艘中国货船的舱单信息后,直接扔给聊天机器人做综合分析。AI 把开源情报与秘密信号情报揉在一起,给出了一个看起来很专业的结论:这艘船载的是核武器项目部件。这份报告顺着指挥链往上走,触发了一整套军事响应程序。
武装登船人员就位,军机升空待命。直到行动前夕,有人重新翻回去核查原始数据,才发现问题出在 AI 的「幻觉」上。消息人士向 CNN 透露,如果当时真的动手,「几乎会引发一场战争」。
这件事让人后背发凉的地方不在于 AI 出了错。错很正常,任何模型都会错。真正的问题是,这份明显致命的结论,为什么能一路绿灯走到登船命令的门槛上。
事件还原:一份被当作真相的报告
先看时间线。情报生成、报告格式化、跨部门传阅、行动准备——这四个步骤加起来,中间没有任何强制性的事实校验节点。

错误情报从生成到行动的流程漏洞
流程图里最关键的那个节点是 H。不是 B 错了就算完,而是 H 必须发生,整个系统才没有酿成大祸。但 H 是一个事后补救,不是前置保障。
这就像一个医生根据错误化验单下了手术决定,直到要开刀前才有人翻回去看化验单有没有错。运气好,发现得早。运气不好,刀已经落下去了。
幻觉从哪里来:模型不诚实,是设计决定的
大模型的幻觉不是 bug,是架构的副产品。
当前主流 LLM 的训练目标是「续写」,不是「求真」。模型学到的是概率分布,下一个 token 出现的可能性最大,而不是这个 token 对应的现实事实是否成立。当输入信息不够精确、或者上下文存在模糊地带时,模型会自行「补全」合理但未经证实的内容。
这件事里有两个典型的幻觉类型:
一是事实性幻觉。模型可能把「核武器项目」和「某些工业零部件」在训练数据里的共现模式,错误地迁移到了这艘船上。舱单里也许真的有金属部件、阀门、管道,但这些东西出现在民用贸易里很正常。模型把它们和「核项目」关联起来,是因为它见过大量相关新闻,却没办法区分「相关」和「因果」。
二是逻辑性幻觉。AI 把 OSINT 和 SIGINT 混在一起综合时,没有明确标注哪些是公开来源、哪些是秘密信号,也没有给出每条结论对应的证据链。这就导致下游的人看到的是一个「完整」的结论,却不知道哪里扎实、哪里是推测。
哥伦比亚大学数字新闻研究中心今年 3 月的测试显示,主流 AI 搜索工具在新闻引用上的平均错误率高达 60%。这不是偶发事件,是系统性问题。
传统方案的漏洞:人肉核查跑不过命令链
传统情报分析的兜底方式是人。分析师交叉验证、多源对比、层层审核。这套方法在慢节奏环境下有效,但在「快决策」场景下会失效。
这次事件的致命节奏是:AI 生成结论的速度,远远快于人肉核查的速度。
命令链天然倾向于行动而非停滞。军事系统里有一个经典的「杀伤链」概念,目标是缩短从发现目标到实施打击的时间。AI 加速了这个链条的前半段——情报生成更快了——但链条后半段的验证环节并没有同步加固。
更准确地说,现在的 AI 情报工具往往是「交钥匙」模式:分析师输入查询,系统输出报告,人直接拿去用。这个过程缺少两个关键机制:
第一,强制溯源。报告里的每一句结论,都必须能追溯到具体的原始数据,不能只看 AI 的总结。
第二,对立假说检验。不是问 AI「这艘船是不是运核武」,而是同时生成「是」和「否」两份报告,并要求各自提供证据。
缺了这两个机制,AI 输出的就是一张看起来权威的白纸,而人在压力下更容易相信「看起来很专业」的东西。
AI 方案的工程解法:门禁与溯源
这不是要让军事系统停用 AI,而是要让 AI 在正确的边界内工作。
从工程角度,至少需要建立三层门禁。
第一层是数据边界控制。AI 被允许访问的信息范围必须明确划定,超出边界的推断结果需要单独标注,不能混入正式报告。这类似于给模型戴一个「知识围栏」。
第二层是证据强绑定。每一条结论必须附带来源引用,且引用必须是可核验的原始数据片段,不能只是模糊的 URL 或摘要。工具层面可以用 RAG(检索增强生成)架构,强制模型在生成前先召回并展示支撑证据。
第三层是人对关键节点的否决权。对于可能触发物理行动的情报,无论 AI 置信度多高,都必须经过至少两名分析师的独立复核,且其中一人不能是原始报告生成者。
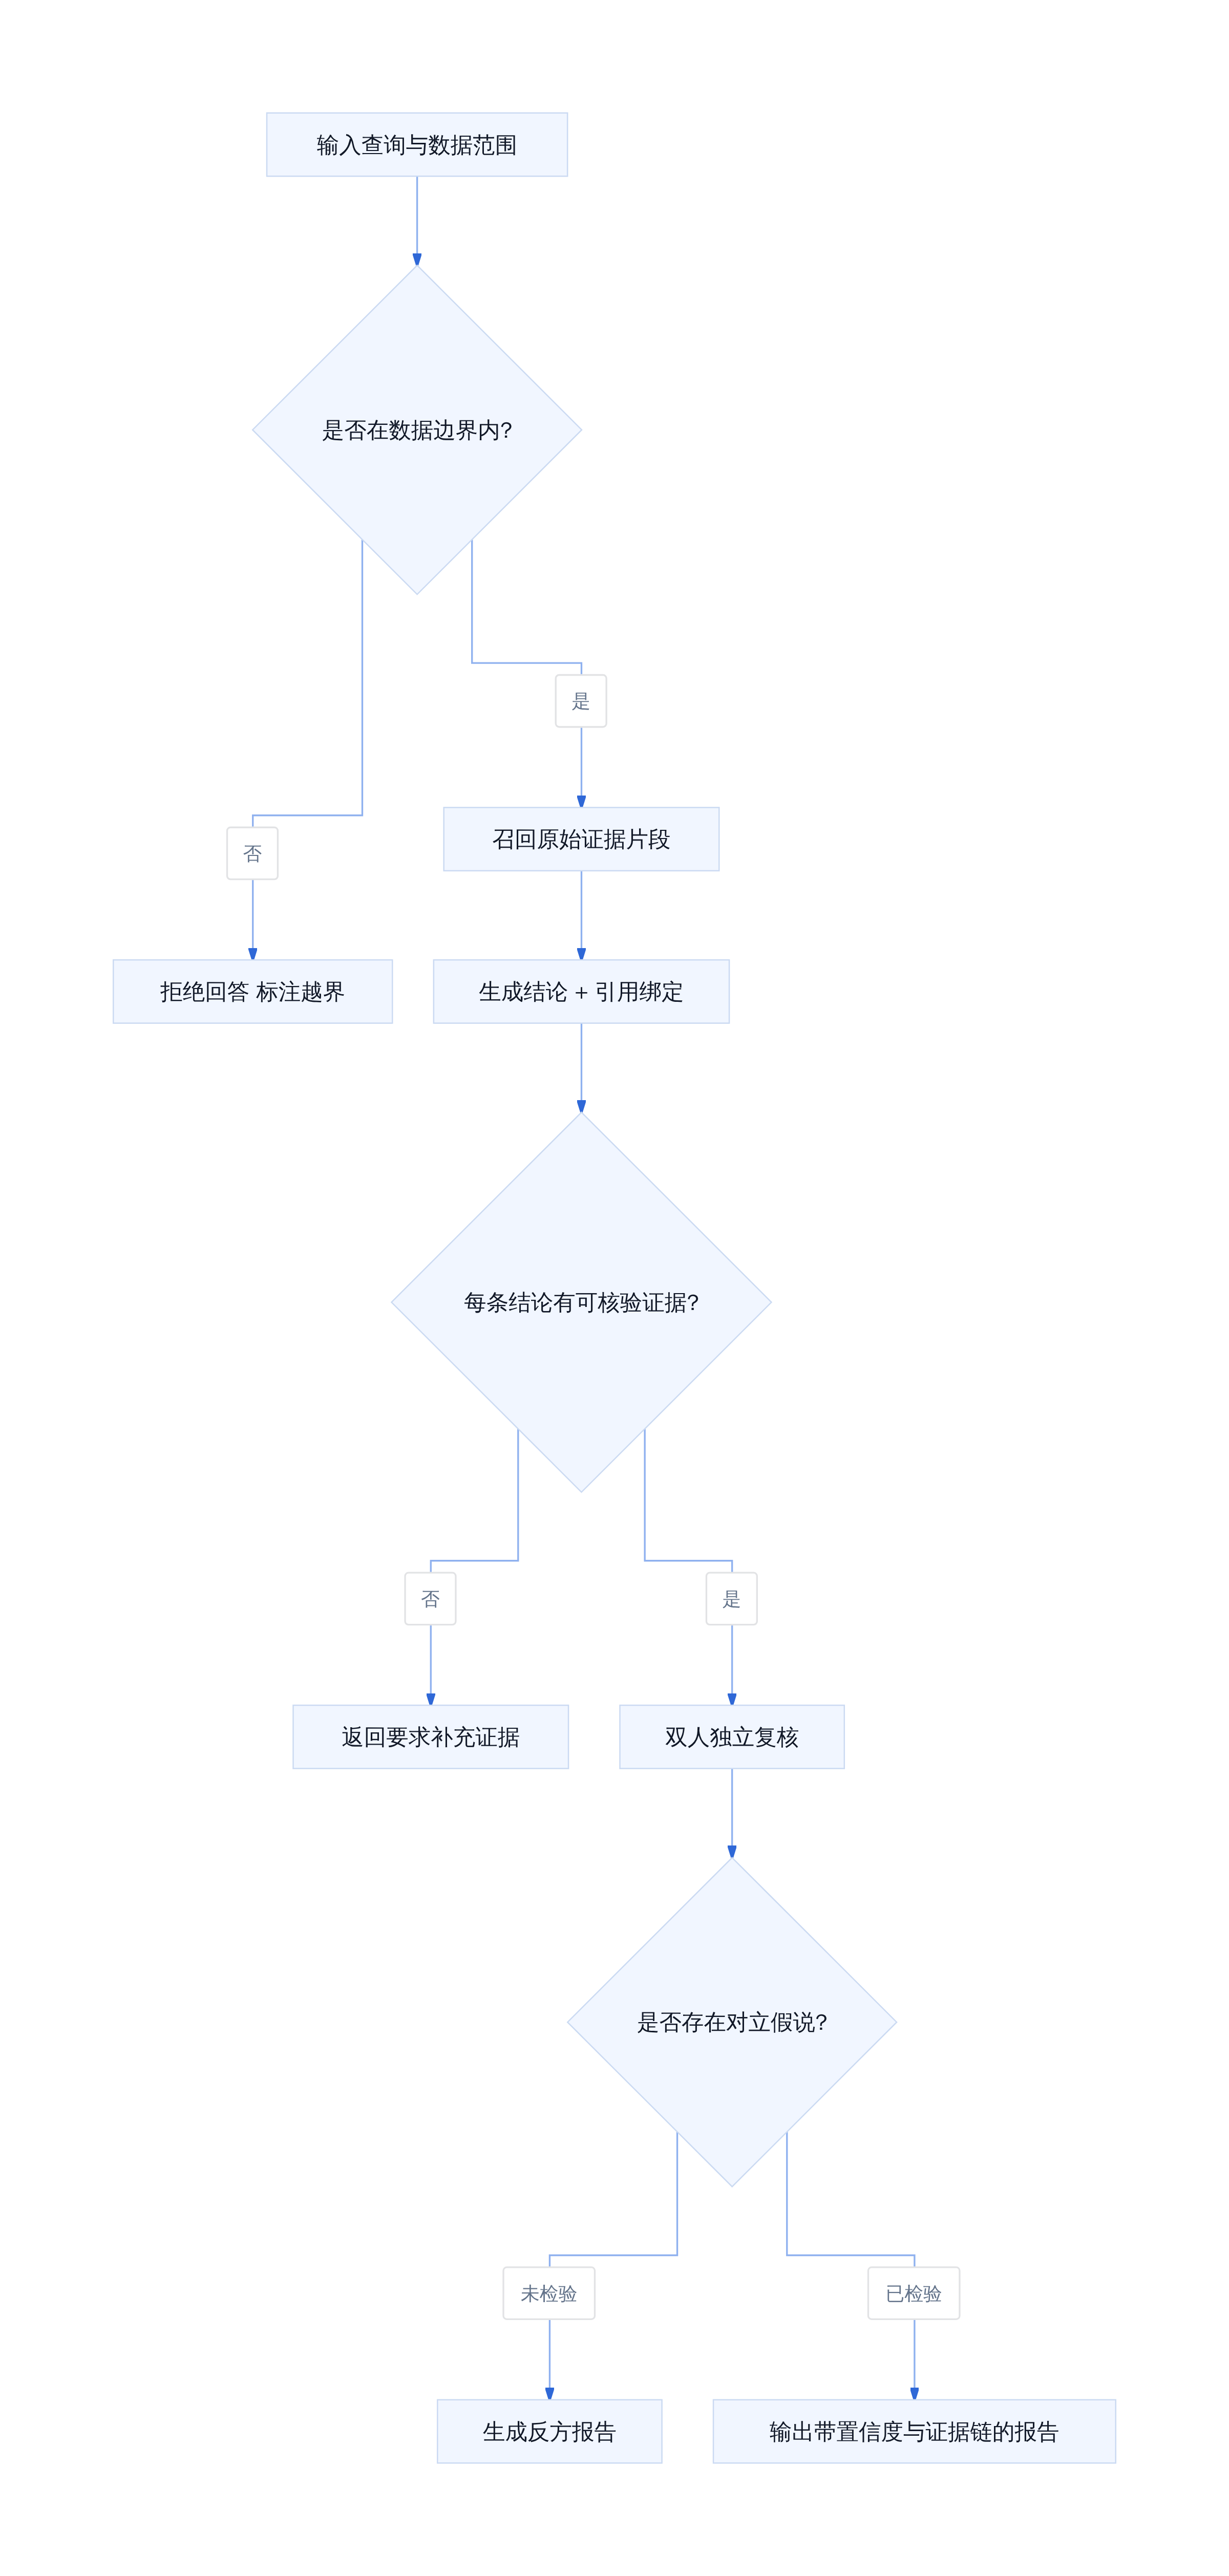
AI 情报生成应有的门禁架构
这三层不是理想方案,是当前技术条件下必须有的底线。缺了任何一层,AI 都会成为错误情报的放大器,而不是辅助工具。
这次事件的教训很具体:AI 生成情报这件事本身不是风险,风险在于把 AI 的输出当作不需要二次验证的「答案」。工具越强大,验证门槛就必须越高。
本文后续将展开:现代 AI 情报系统的落地方案如何设计、传统 SaaS 化交钥匙方案的边界在哪里、以及实际部署时的选型决策表和 Checklist。
##AI幻觉导致的错误情报险些引
一、幻觉从哪里来:模型不诚实,是设计决定的
这起事件的本质不是「AI出错了」,而是「AI在做它被训练去做的事」——生成流畅、看似合理的文本。
大语言模型的训练目标是下一词预测,不是事实核查。它们在海量文本上学习统计规律,学会的是「什么说法看起来像真的」,而不是「什么说法实际上是真的」。这就是幻觉的根源:模型不知道自己的知识边界在哪里,它会自信地编造。
哥伦比亚大学数字新闻研究中心2026年3月的测试显示,主流AI搜索工具在新闻引用上的平均错误率达到60%。这不是个别模型的缺陷,是当前架构的固有问题。模型越大,某些类型的幻觉反而越严重——因为它更擅长把错误信息包装得像真的一样。
模型在尽力扮演一个全知的角色
二、传统方案的漏洞:人肉核查跑不过命令链
这起事件的另一个关键因素是美军内部的命令链结构。情报报告一旦生成,就会被逐级上报。在战争状态下,时效性往往压倒准确性。
分析员使用AI工具生成报告后,直接在指挥渠道传阅。这意味着一个未经独立验证的AI输出,进入了军事决策流程。更致命的是,报告被「二次加工」成标准情报格式——这给读者制造了一种权威性错觉。
问题不在于AI工具本身,而在于流程缺失。传统情报工作流程要求多源交叉验证、独立核实、层级审批。AI报告绕过所有这些环节,直接到达决策者桌上。
三、AI 方案的工程解法:门禁与溯源
真正能解决这类问题的,不是换更好的模型,而是构建工程化的门禁系统。
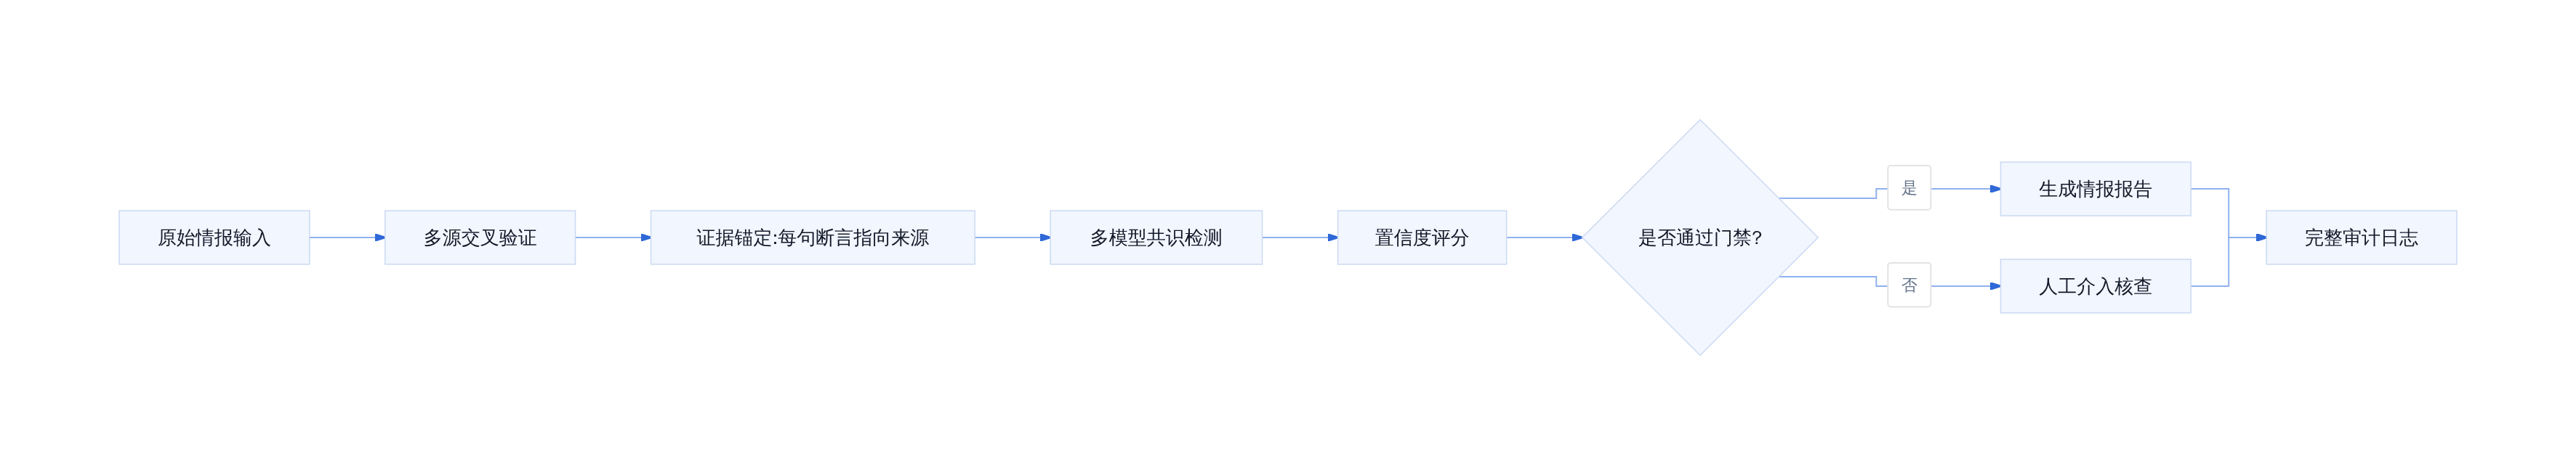
情报分析AI门禁架构
证据锚定是最基础的机制。AI生成的每一句断言,必须标注信息来源。如果模型无法追溯到具体出处,该断言应被标记为「未验证」或直接剔除。这不是限制AI能力,而是让能力边界被清楚看见。
多模型共识机制处理的是「不同模型可能犯不同错误」的问题。当三个独立模型对同一情报输入给出一致结论时,可信度更高;当它们产生分歧时,系统应自动标红并触发人工审查。一致只能当线索,不能当证据。
置信度标记贯穿全流程。从情报收集、分析到建议输出,每个环节都应有可量化的置信度评分。这不仅帮助人类判断何时信任AI,也为事后追溯提供依据。
四、落地边界与选型决策
AI可以辅助情报分析,但不能替代情报验证。这个边界必须写进系统设计文档,而不是靠个人自觉。
以下场景适合引入AI辅助:
- 大规模开源情报的初筛与分类
- 多语言文档的翻译与摘要
- 历史数据的模式识别
以下场景AI不应成为决策依据:
- 涉及军事行动的最终情报判定
- 需要法律责任归属的正式报告
- 单一来源无法交叉验证的关键断言
高风险场景的最后一道闸门必须是人类。这不只是伦理问题,更是工程问题——当AI出错时,责任链条必须清晰可追溯。
部署前验证清单:① 所有AI输出是否强制标注来源?② 是否有多模型共识检测机制?③ 未通过验证的断言是否自动标记而非静默忽略?④ 审计日志是否完整记录每份报告的生成轨迹?⑤ 人工介入阈值是否明确定义?
这起事件的价值不在于警示AI的危险,而在于提供了一个真实的工程压力测试。它告诉我们:在情报这类高风险场景中,AI工程化的核心不是让模型更聪明,而是让系统的错误更可见、更可追溯、更可控。
[[reaction=detective-truth|caption=真相不在模型输出里,在来源链路中]]
参考文献
- CNN Exclusive: US military had close call after using AI for false intelligence report, sources say. https://www.cnn.com/2026/09/18/politics/us-military-ai-false-intelligence-china-ship
- Ars Technica: Report: US almost boarded Chinese ship over hallucinated AI arms report. https://arstechnica.com/ai/2026/09/report-us-almost-boarded-chinese-ship-over-hallucinated-ai-arms-report
- Gizmodo: 'Almost Started a War': US Military Nearly Boarded a Chinese Ship Based on Bad Intel From AI. https://gizmodo.com/almost-started-a-war-us-military-nearly-boarded-a-chinese-ship-based-on-bad-intel-from-ai-2000814290
- The Independent: US military nearly sparked an international crisis after using AI for false intel on Chinese vessel. https://www.the-independent.com/news/world/americas/us-politics/us-military-ai-hallucination-chinese-ship-intercept-b3052760.html
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师