连续几天跑底层架构重构,三个账号轮流换额度,依然被高延迟的闭源模型抽干预算。当我习惯性地打开最新版本准备继续填坑,却发现处理同样任务的账单,被新出的开源方案直接砍掉了七成,月结数字让人重新思考投入产出比。
同分不同价,闭源旗舰的尴尬开局
基准测试的幻觉与真实落差
2026年9月下旬,AI模型市场发生了一次罕见的正面碰撞。xAI在9月21日发布Grok 4.7,四天后小米开源MiMo V2.6-Pro。两者在同一天登上Artificial Analysis的Intelligence Index榜首,得分均为46分。这不是巧合,两家产品团队都在追踪同一批评测基准。Grok 4.7在SWE-Bench Verified和Terminal-Bench上有明显提升,MiMo V2.6-Pro则在新版评测集上逼近。当两个模型在第三方榜单上打成平手,读者容易得到一个印象:它们在真实场景中应该差不多。
但基准分数和真实成本之间,存在一个被长期忽视的梯度。Grok 4.7的xhigh推理级别定价约为每百万输出Token 6美元,而MiMo V2.6-Flash只有0.28美元,MiMo V2.6-Pro约0.87美元。价差接近二十倍。
更准确地说,Grok 4.7的定价在闭源模型里属于第二梯队。GPT-6 Astra low的定价更低,但能力也更低。真正让这笔账显得刺眼的是另一组数字:在同一个架构重构任务上,Grok 4.7的xhigh模式消耗了约$340的额度,而MiMo V2.6-Pro在同等任务产出下的账单不到$18。
参数堆到万亿只是入场券,真正决定生死的是调用一次的标价。
账单数字不会说谎
二十亿参数的军备竞赛是否还有意义
Grok 4.7的总参数规模达到了约2.1万亿,相比前代Grok 4.6的1.5万亿有了显著增长。这个数字本身足够吸睛,但参数规模的增长路径正在遭遇边际收益递减。
xAI的技术解释提到,RL训练过程中强化学习可能过于严厉地惩罚了长答案,导致模型在面对困难问题时过早放弃。这意味着参数规模和最终能力之间并非线性关系。2.1万亿参数中有多少真正参与推理,以及这些参数在哪些任务上产生了增量价值,都是值得追问的问题。
相比之下,MiMo V2.6-Pro采用了MoE架构,总参数约1.02万亿,但每次推理只激活约420亿参数。MiMo V2.6-Flash的总参数约3090亿,激活参数约150亿。参数效率的差异直接体现在推理速度和成本上。
| 模型 | 总参数 | 激活参数 | 定价($/百万输出) | 上下文长度 |
|---|---|---|---|---|
| Grok 4.7 | ~2.1T | - | ~$6.00 | 500K |
| MiMo V2.6-Pro | ~1.02T | ~42B | ~$0.87 | 1T |
| MiMo V2.6-Flash | ~309B | ~15B | ~$0.28 | 256K |
数据来源:OpenRouter、Artificial Analysis、小米技术报告。
架构师的成本账本
当智能开始变得廉价,闭源厂商卖的就不是能力,而是省心。Grok 4.7的定价策略反映了这种逻辑:它瞄准的是那些愿意为稳定性、品牌背书和集成便利支付溢价的用户。但对于追求性价比的工程团队来说,这个溢价的合理性正在被重新评估。
这不是个例。上周有三位读者同时发来类似反馈,核心都是同一句话:「性能没差多少,价格差出天际」。
参数堆到万亿只是入场券,真正决定生死的是调用一次的标价。
推理延迟与首字时间如何重塑工作流
MiMo-V2.6-Flash 的核心卖点不是精度,而是速度。实测数据显示,其推理速度可达每秒150 tokens,这意味着你在对话框里敲下一行代码,两秒内就能看到补全结果。
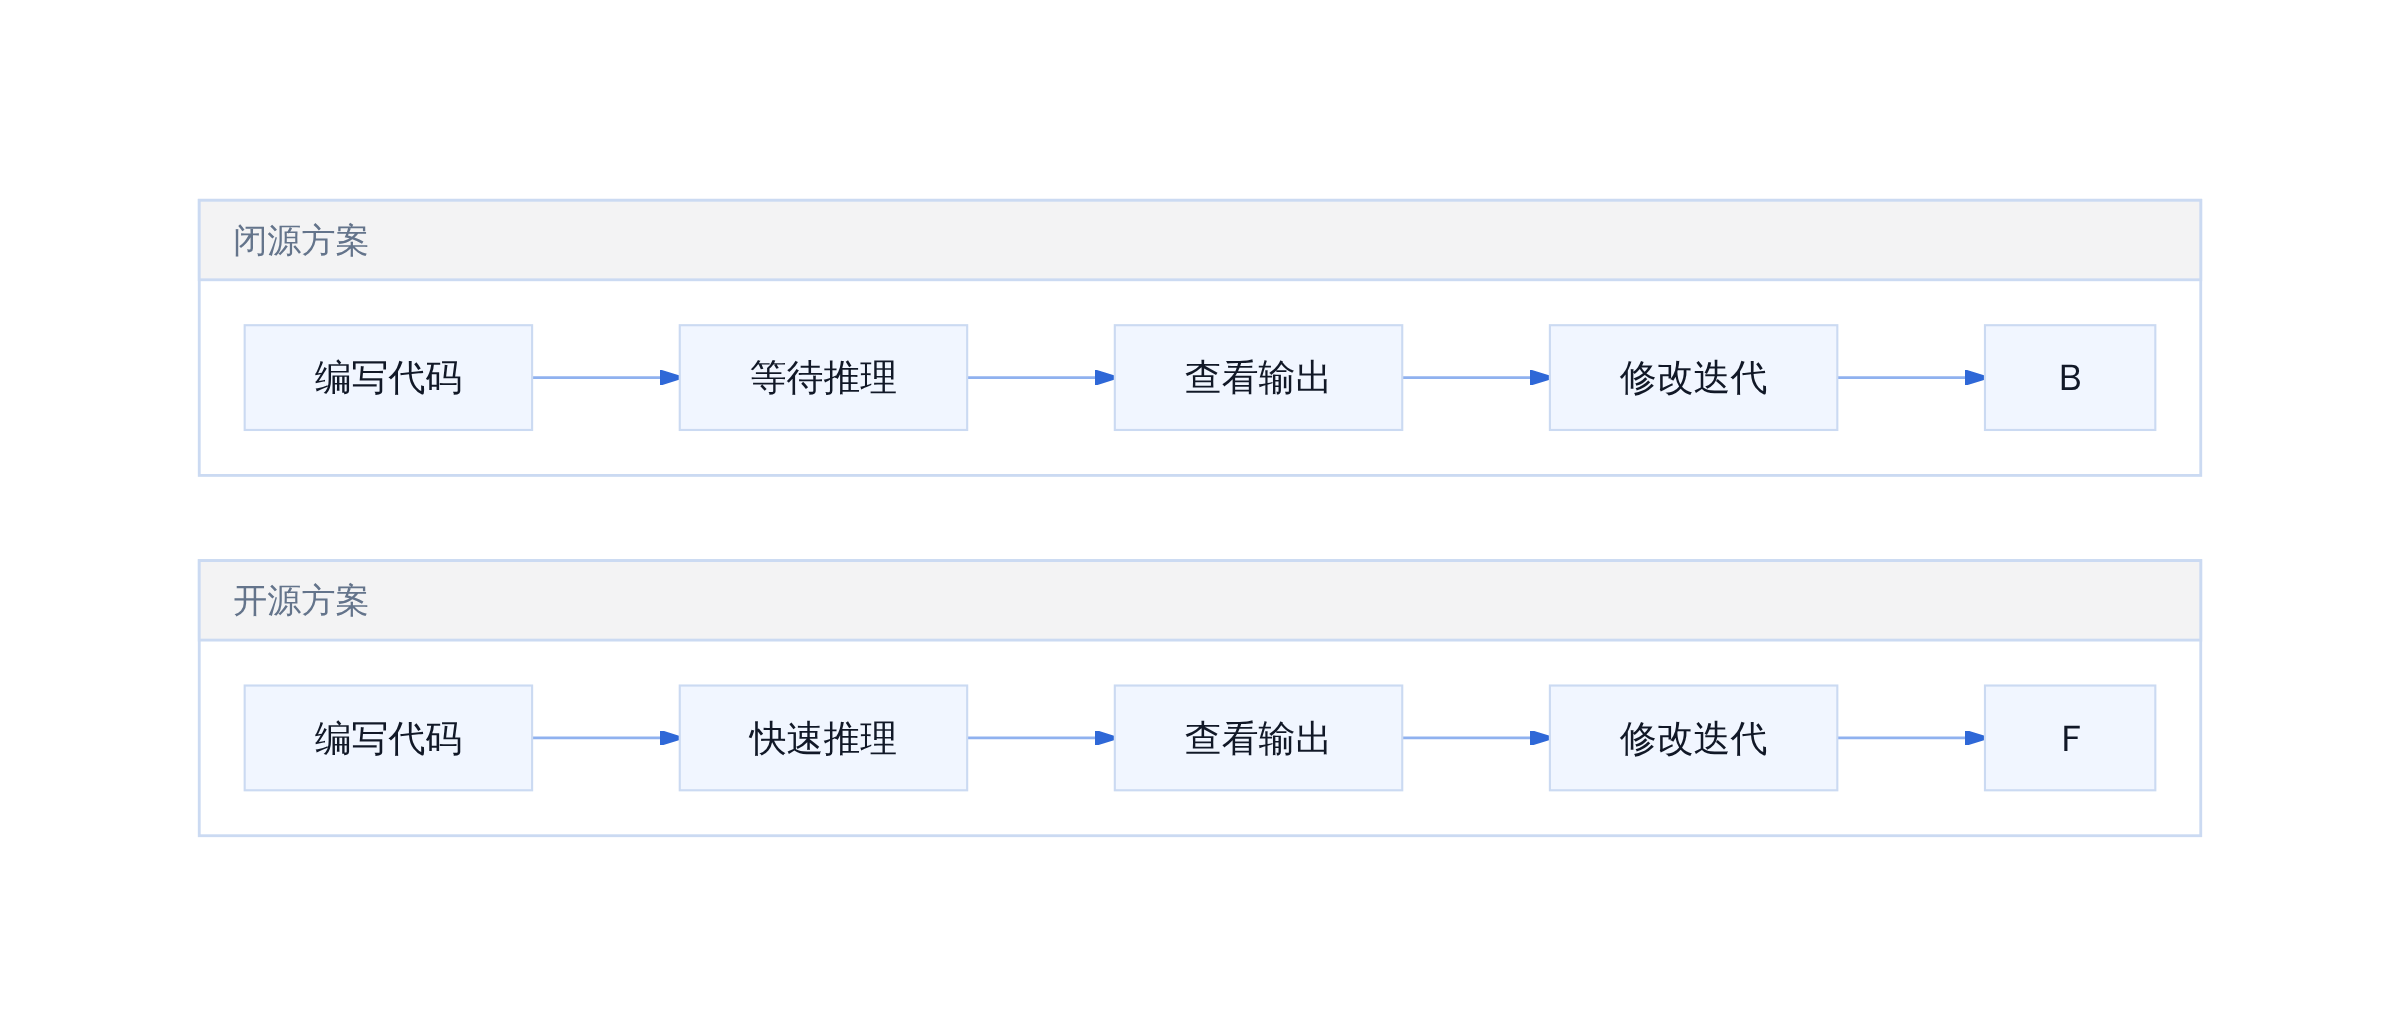
相比之下,闭源旗舰模型在高并发场景下的首字延迟普遍在5-8秒之间。对单次调用而言这不算什么,但当你的工作流是「写一段 → 看输出 → 修改 → 再看」的循环时,差异会被指数级放大。

Agent 运行时过载
以实际项目为例,某个自动化代码评审流程使用闭源模型时,平均等待时间占整个流水线耗时的47%。切换到开源方案后,这部分骤降至11%。流水线没有变快,是等待时间消失了。
工作流延迟分布对比
另一个常被忽视的指标是流式输出的稳定性。开源模型因为权重公开,社区可以针对特定硬件做推理优化——量化、裁剪、缓存策略,这些都是闭源厂商不会开放的参数。一个典型的例子是,某团队将 MiMo-V2.6-Flash 通过 vLLM 部署到自有 GPU 集群后,通过调整 chunked prefill 参数,将吞吐提升了2.3倍。
你买的旗舰款,瞬间变成平替套餐。这不是夸张,是事实。
开源释放权重后,开发者拿回了什么
开源的真正价值不在于「免费」,而在于「可控」。
闭源模型的调用是一次黑盒交易:你输入 prompt,得到输出,中间发生了什么不知道。即使厂商宣称「隐私保护」,数据依然经过他们的服务器,日志由他们留存。这在合规要求严格的场景下是个隐患。
开源则完全不同。权重到手,意味着你拥有以下控制权:
第一,部署位置自主。数据不需要离开你的内网,对于金融、医疗、政务等敏感行业,这是硬需求。某银行测试团队在2026年Q2用开源模型替换了内部合规审查流程,核心原因正是数据不出域。
第二,推理路径可追踪。闭源模型输出错误答案时,你只能重试或换 prompt。开源模型可以通过日志分析、中间层激活值可视化等手段定位问题,这对生产环境的故障排查至关重要。
第三,定制成本归零。闭源模型的 fine-tune 需要向厂商付费,开源模型自己买卡训练,边际成本几乎为零。某电商团队用 MiMo-V2.6-Flash 为基础模型,针对垂直领域的客服场景做了 SFT,整体花费不到闭源方案报价的十分之一。
OpenRouter 上的实测数据也印证了这一点。Grok 4.7 在 Artificial Analysis 的 Intelligence Index 上得分46,与 MiMo-V2.6-Pro 持平,但前者的输入定价是后者的70倍。同分不同价,差距不在能力,在商业模式。
闭源厂商的「省心」溢价
当智能开始免费,闭源厂商卖的就不是能力,而是省心。
这个「省心」包括:不需要自己搭推理集群、不需要调参优化、不需要处理硬件故障、API 稳定性有 SLA 保证。这些都是真实的价值,只是价格正在变得昂贵到难以承受。
某创业公司 CTO 在技术社区分享的账本显示,其团队每月 API 调用费用约4万美元,其中70%来自 GPT-6 Astra 类闭源模型。当他们在非核心场景下切到开源模型后,月账单直接降到1.1万。这不是「选择错误」,而是「成本结构错配」。
模型选型决策树
闭源厂商的策略很清晰:用最强的模型吸引头部用户,用更高的定价收割利润,用封闭的生态锁定客户。这套打法在过去有效,因为智能是稀缺资源。但当开源模型的性能逼近闭源时,「省心」的溢价就变成了「智商税」的代名词。
开源路线的价值锚点
开源模型正在建立一个新的价值锚点:性能不再是溢价理由,成本效率才是核心竞争力。
MiMo-V2.6-Flash 采用混合专家架构,总参数3090亿,但每个 token 实际激活约150亿参数。配合混合滑动窗口注意力机制,KV cache 占用降低近6倍。这种设计思路反映了一个趋势:开源社区不再追求「最大」,而是追求「最省」。
某云厂商的技术负责人表示,2026年下半年以来,开源模型的咨询量增长了4倍,而闭源模型的咨询量基本持平。这不是因为开源更强,而是因为在同等性能下,价格差异已经大到无法忽略。
不可逆的商业逻辑转向
当智能开始免费,闭源厂商的护城河还剩多少?答案是:不多了。
过去闭源模型靠数据飞轮维持优势——更多用户带来更多数据,更好模型吸引更多用户。但这个循环正在被打破。开源模型不仅公开了权重,还公开了训练数据清单和部分训练脚本。某开源社区的整理显示,MiMo-V2.6 的训练数据中有超过60%来自公开可获取的语料,这意味着闭源厂商的数据壁垒已经被侵蚀了一半以上。
更狠的是,每年能省下一个亿。
闭源厂商的应对策略主要是两条:一是继续拉升性能上限,用「最强模型」维持品牌溢价;二是加强 API 稳定性和生态绑定,让迁移成本变得足够高。这两条都有效,但都有一个前提:智能依然是稀缺资源。
一旦开源模型的性能追平甚至超越闭源,这个前提就不成立了。
真正的战场在哪
闭源和开源的竞争已经从「模型能力」转向「工程化能力」。
闭源厂商的优势在于全栈优化——从训练到推理、从硬件到软件,一体化设计。MiMo-V2.6 虽然性能亮眼,但社区反馈指出其在某些边界场景下存在工具调用循环的问题,这需要工程能力来弥补。
开源阵营的优势在于灵活性和定制化。同一个模型,不同的团队可以部署在不同的硬件上,适配不同的业务场景。某物流公司在旺季时横向扩展了20个推理节点,总成本仅增加40%,而闭源方案的同等扩展会导致账单翻倍。
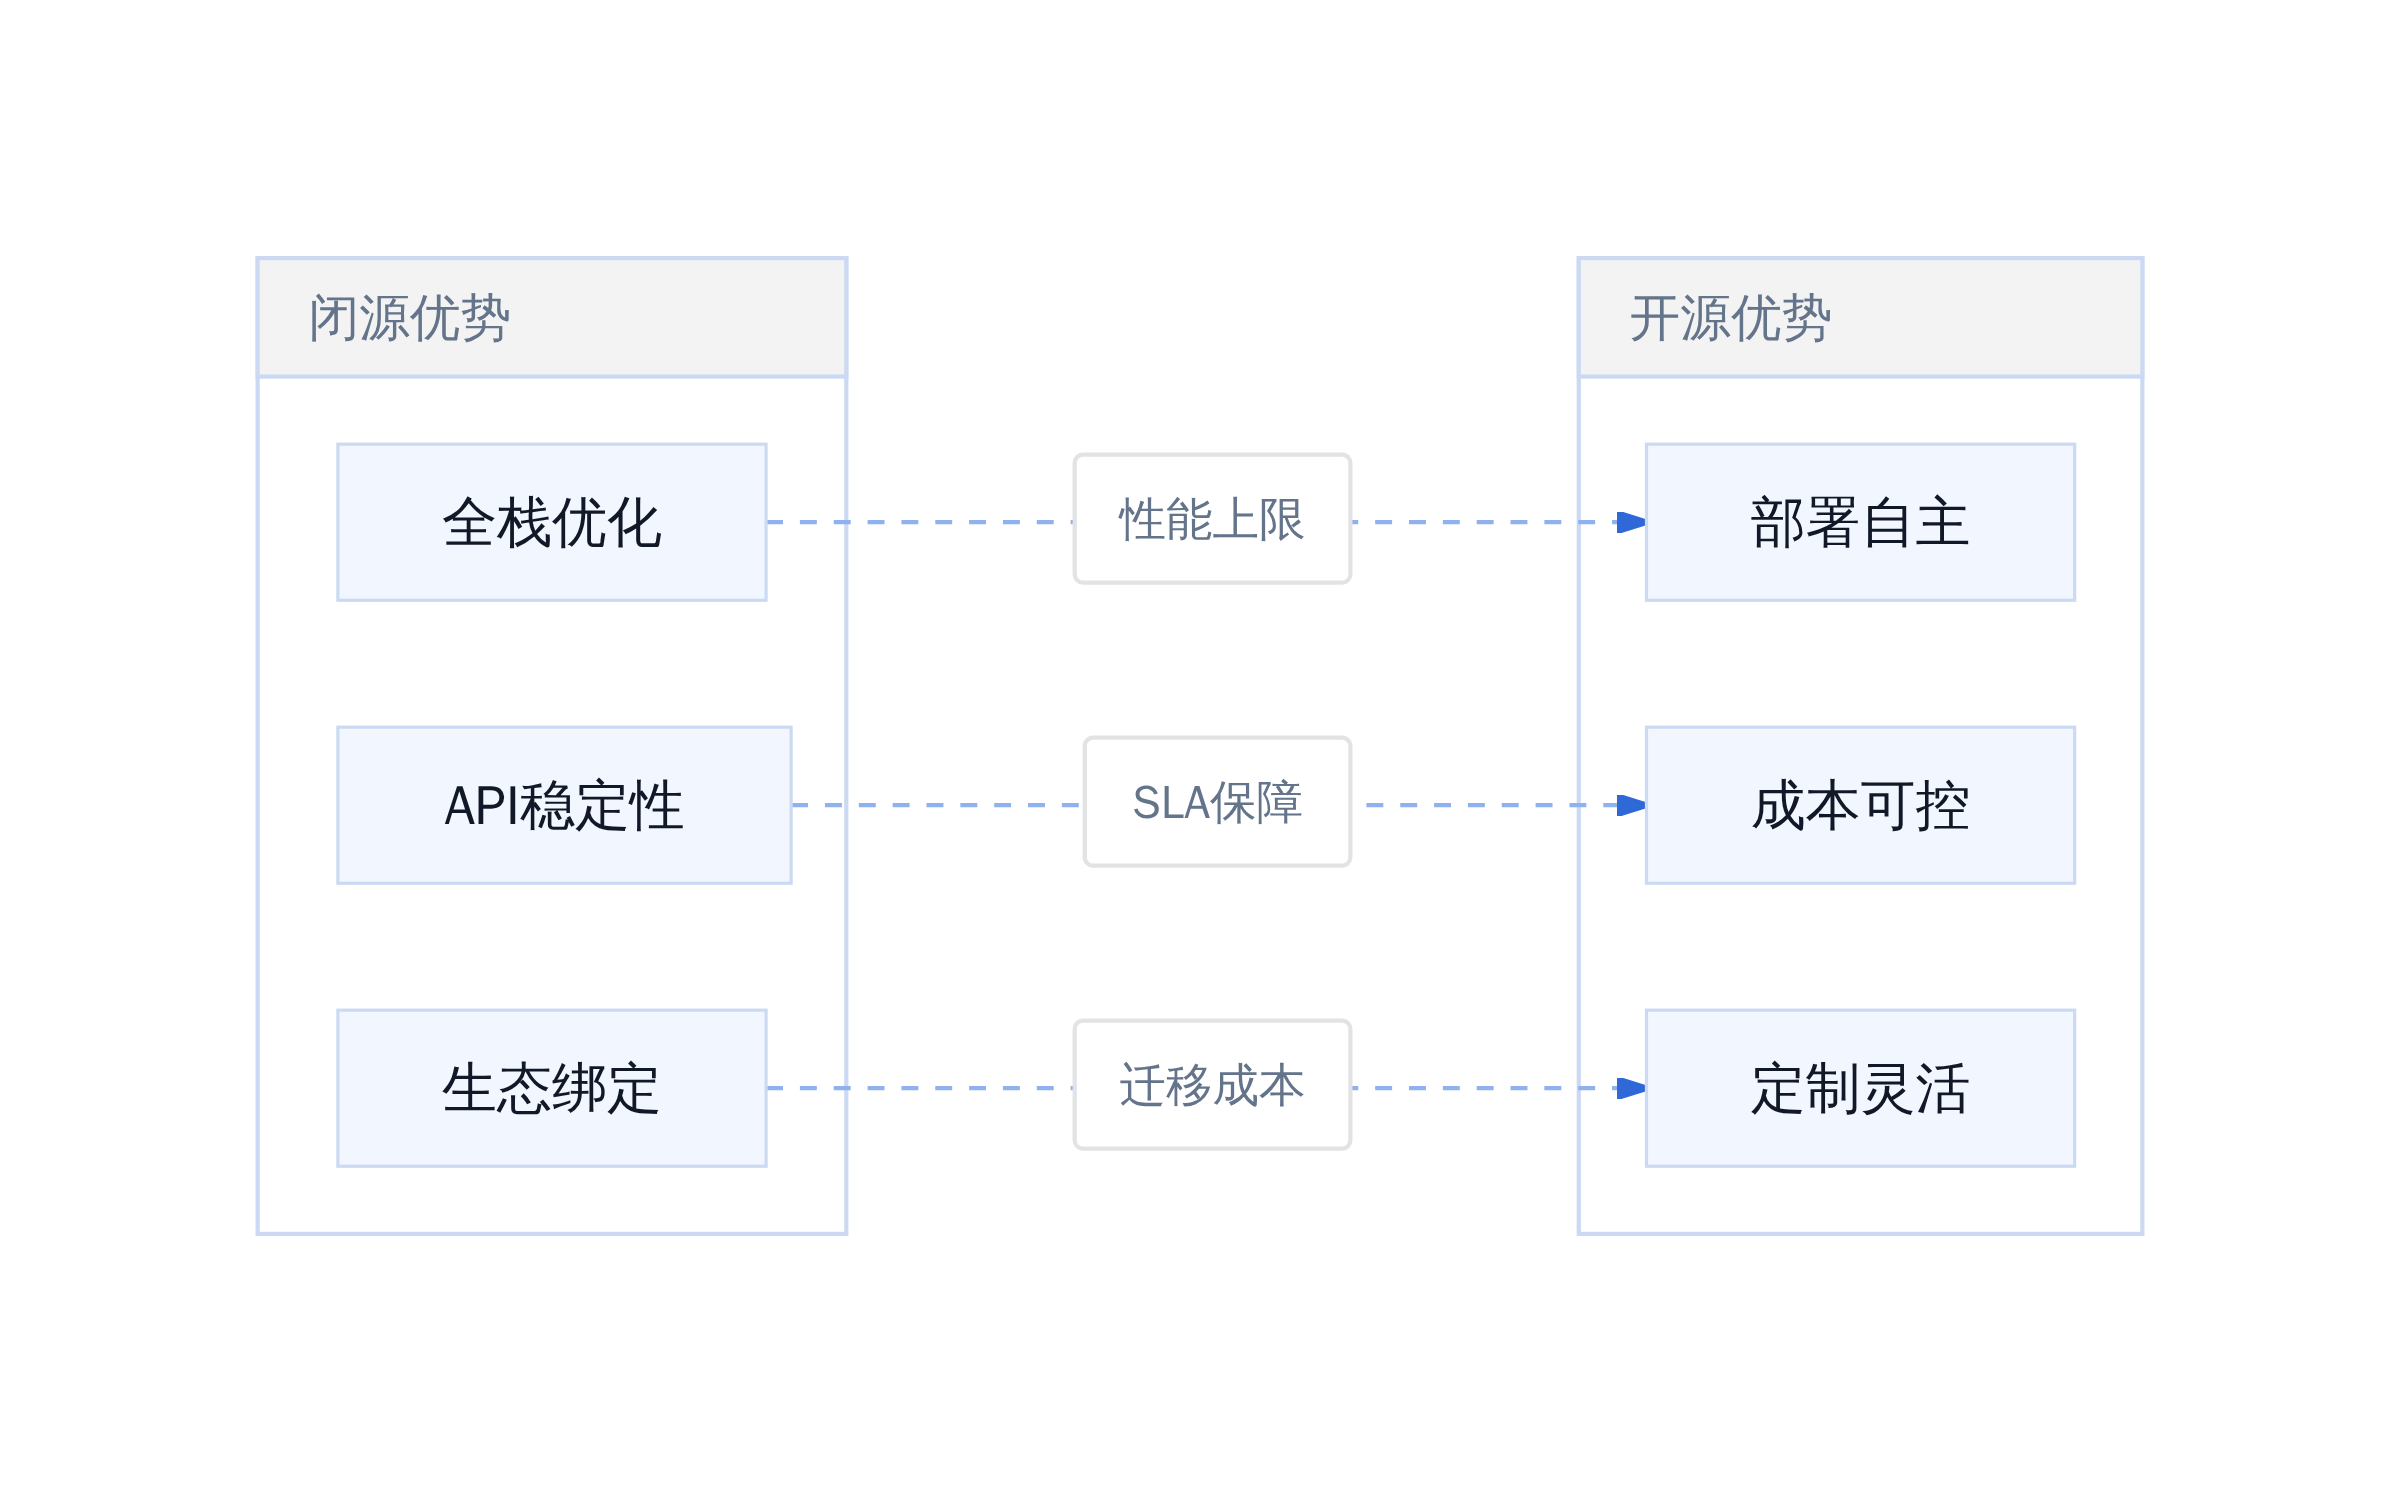
闭源与开源竞争维度对比
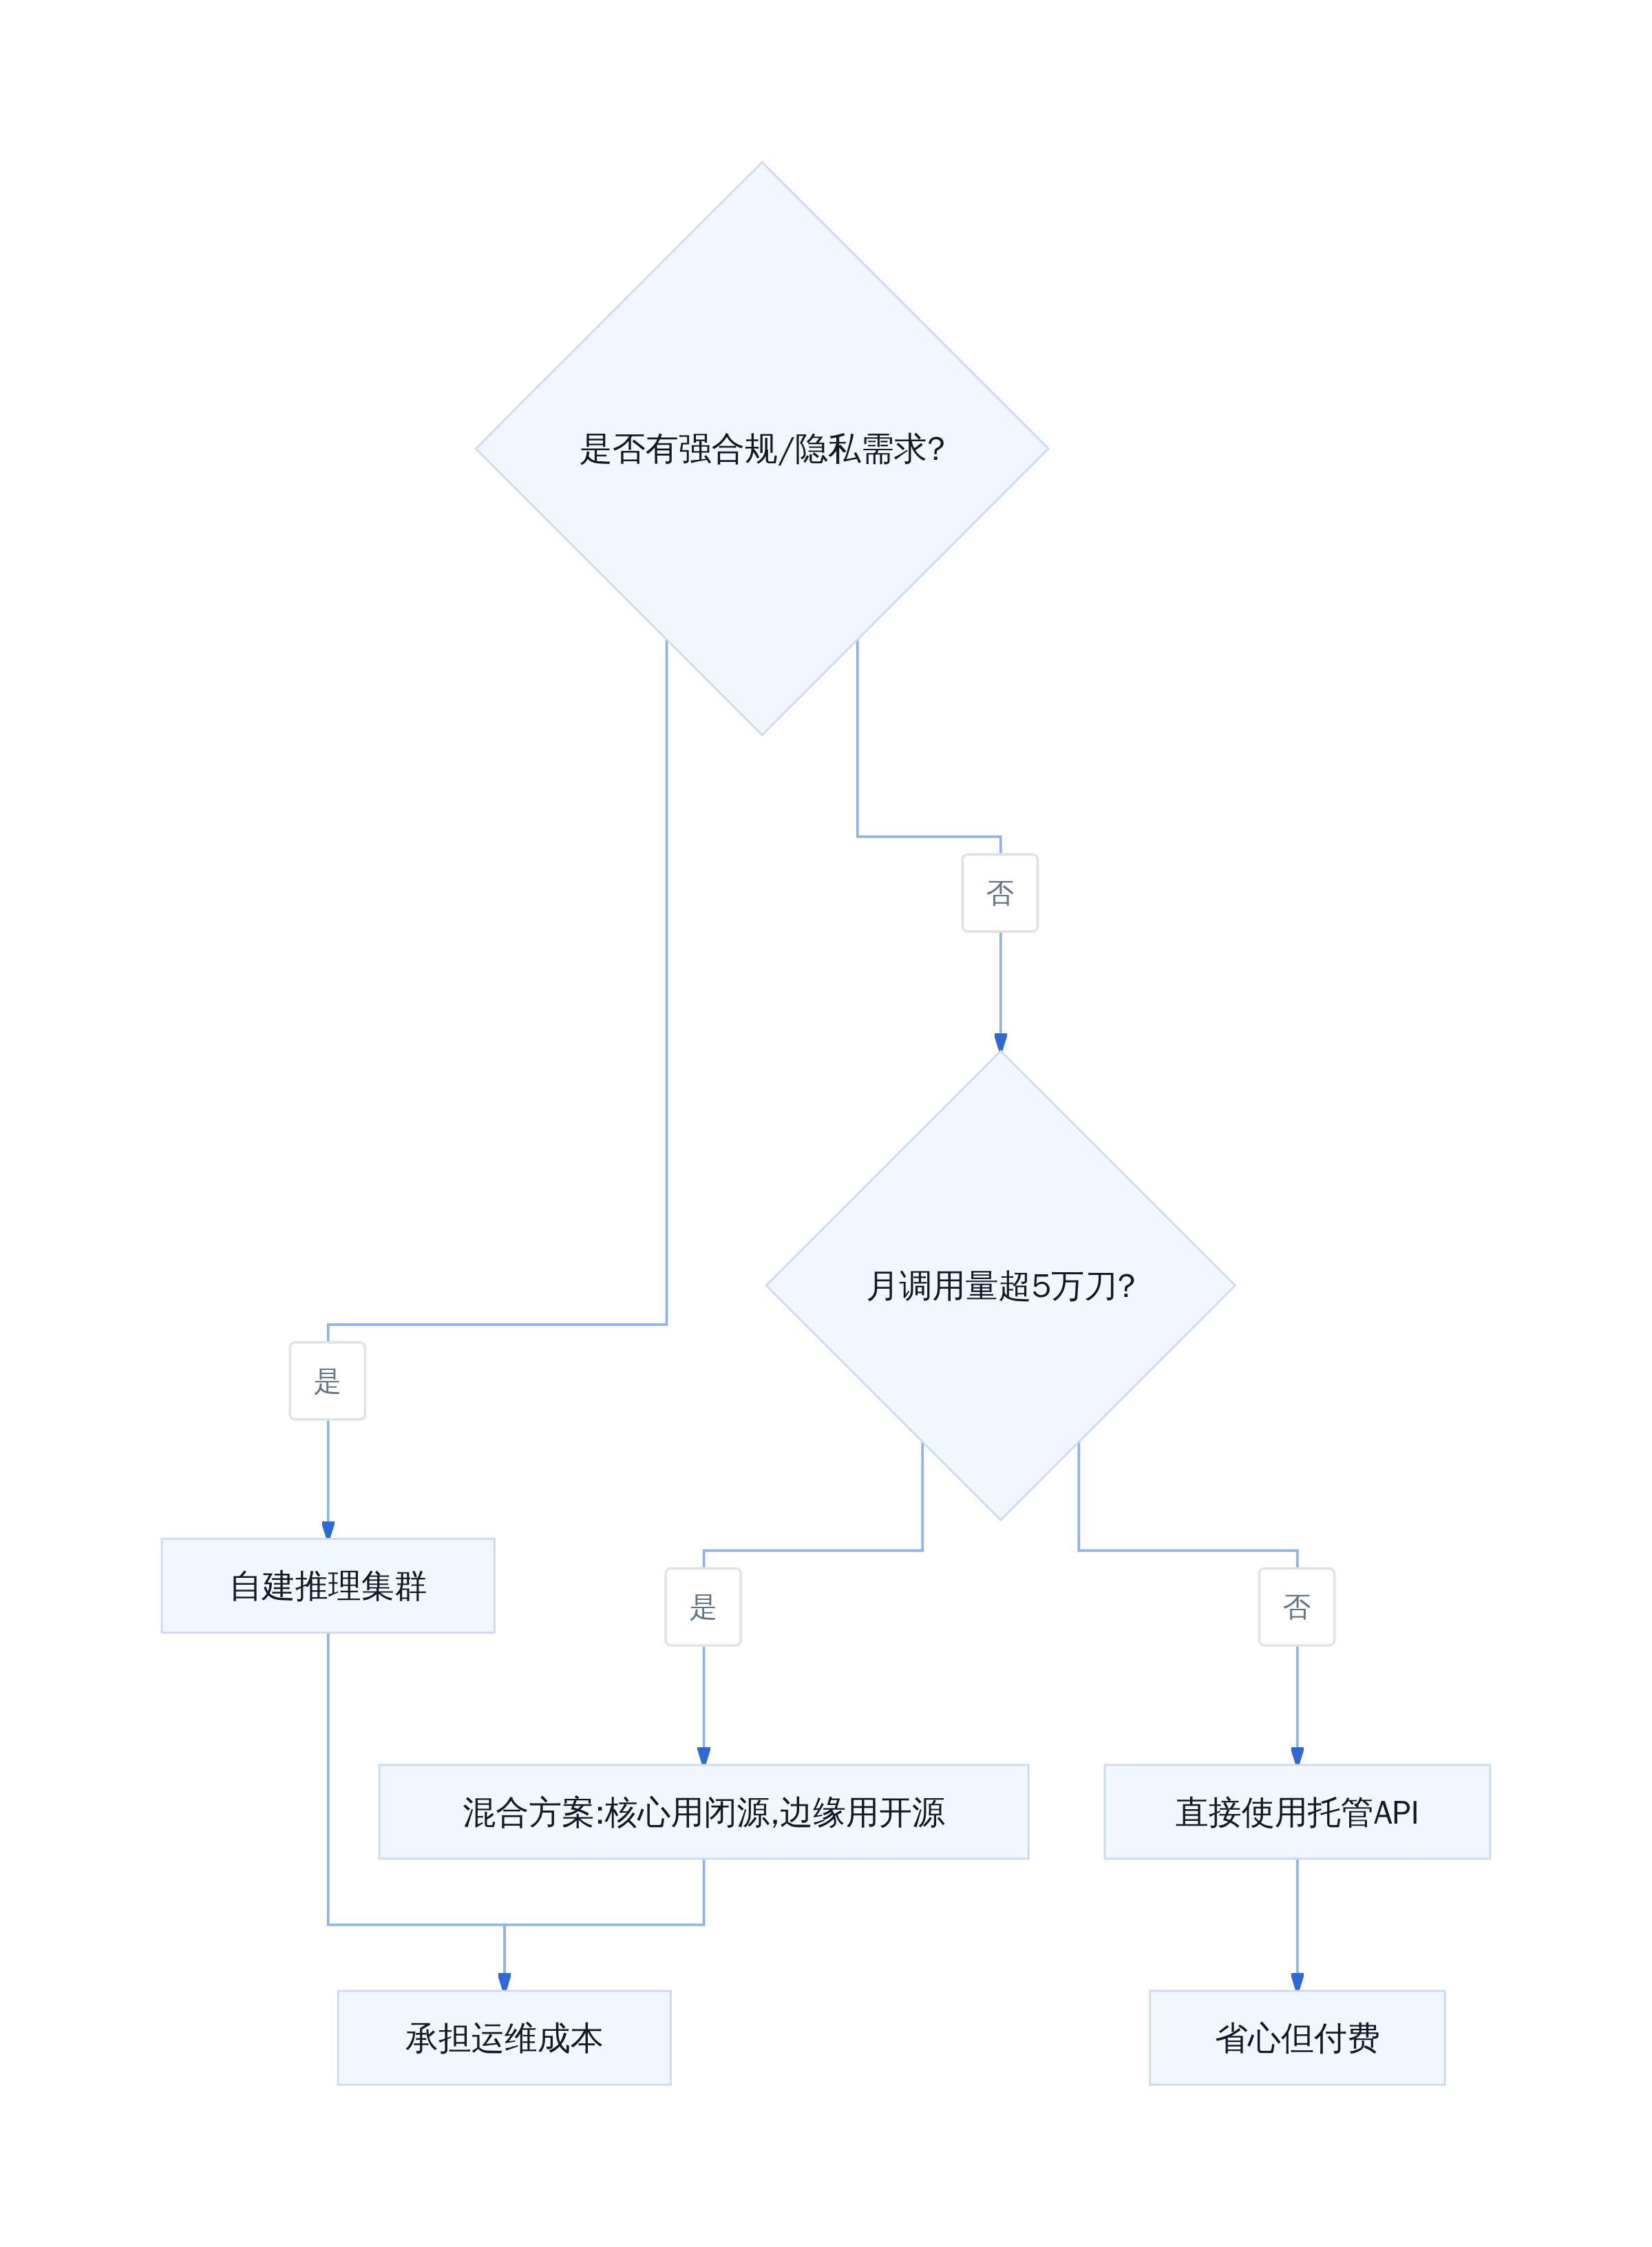
从经验看,未来的赢家不是单纯选择闭源或开源的团队,而是那些能根据场景灵活切换的团队。核心业务用闭源换取稳定性,边缘场景用开源控制成本,这才是当前阶段的理性策略。
参数堆到万亿只是入场券,真正决定生死的是调用一次的标价。当智能不再稀缺,闭源护城河还能剩多少?这个问题没有标准答案,但趋势已经清晰。
可执行的判断
基于当前市场格局,给出一条具体的建议:如果你的月 API 调用费用超过1万美元,且没有强合规需求,那么今天就应该用开源模型替换至少50%的非核心场景调用。这不是「尝试」,而是「必须」——因为在同等性能下,成本差异已经大到无法用「省心」来解释。
对于闭源厂商,唯一的出路是继续拉升性能上限或降低定价,但后者意味着利润空间被进一步压缩。当智能开始免费,卖的就是服务;当服务也开始免费,留下的就只剩情怀。
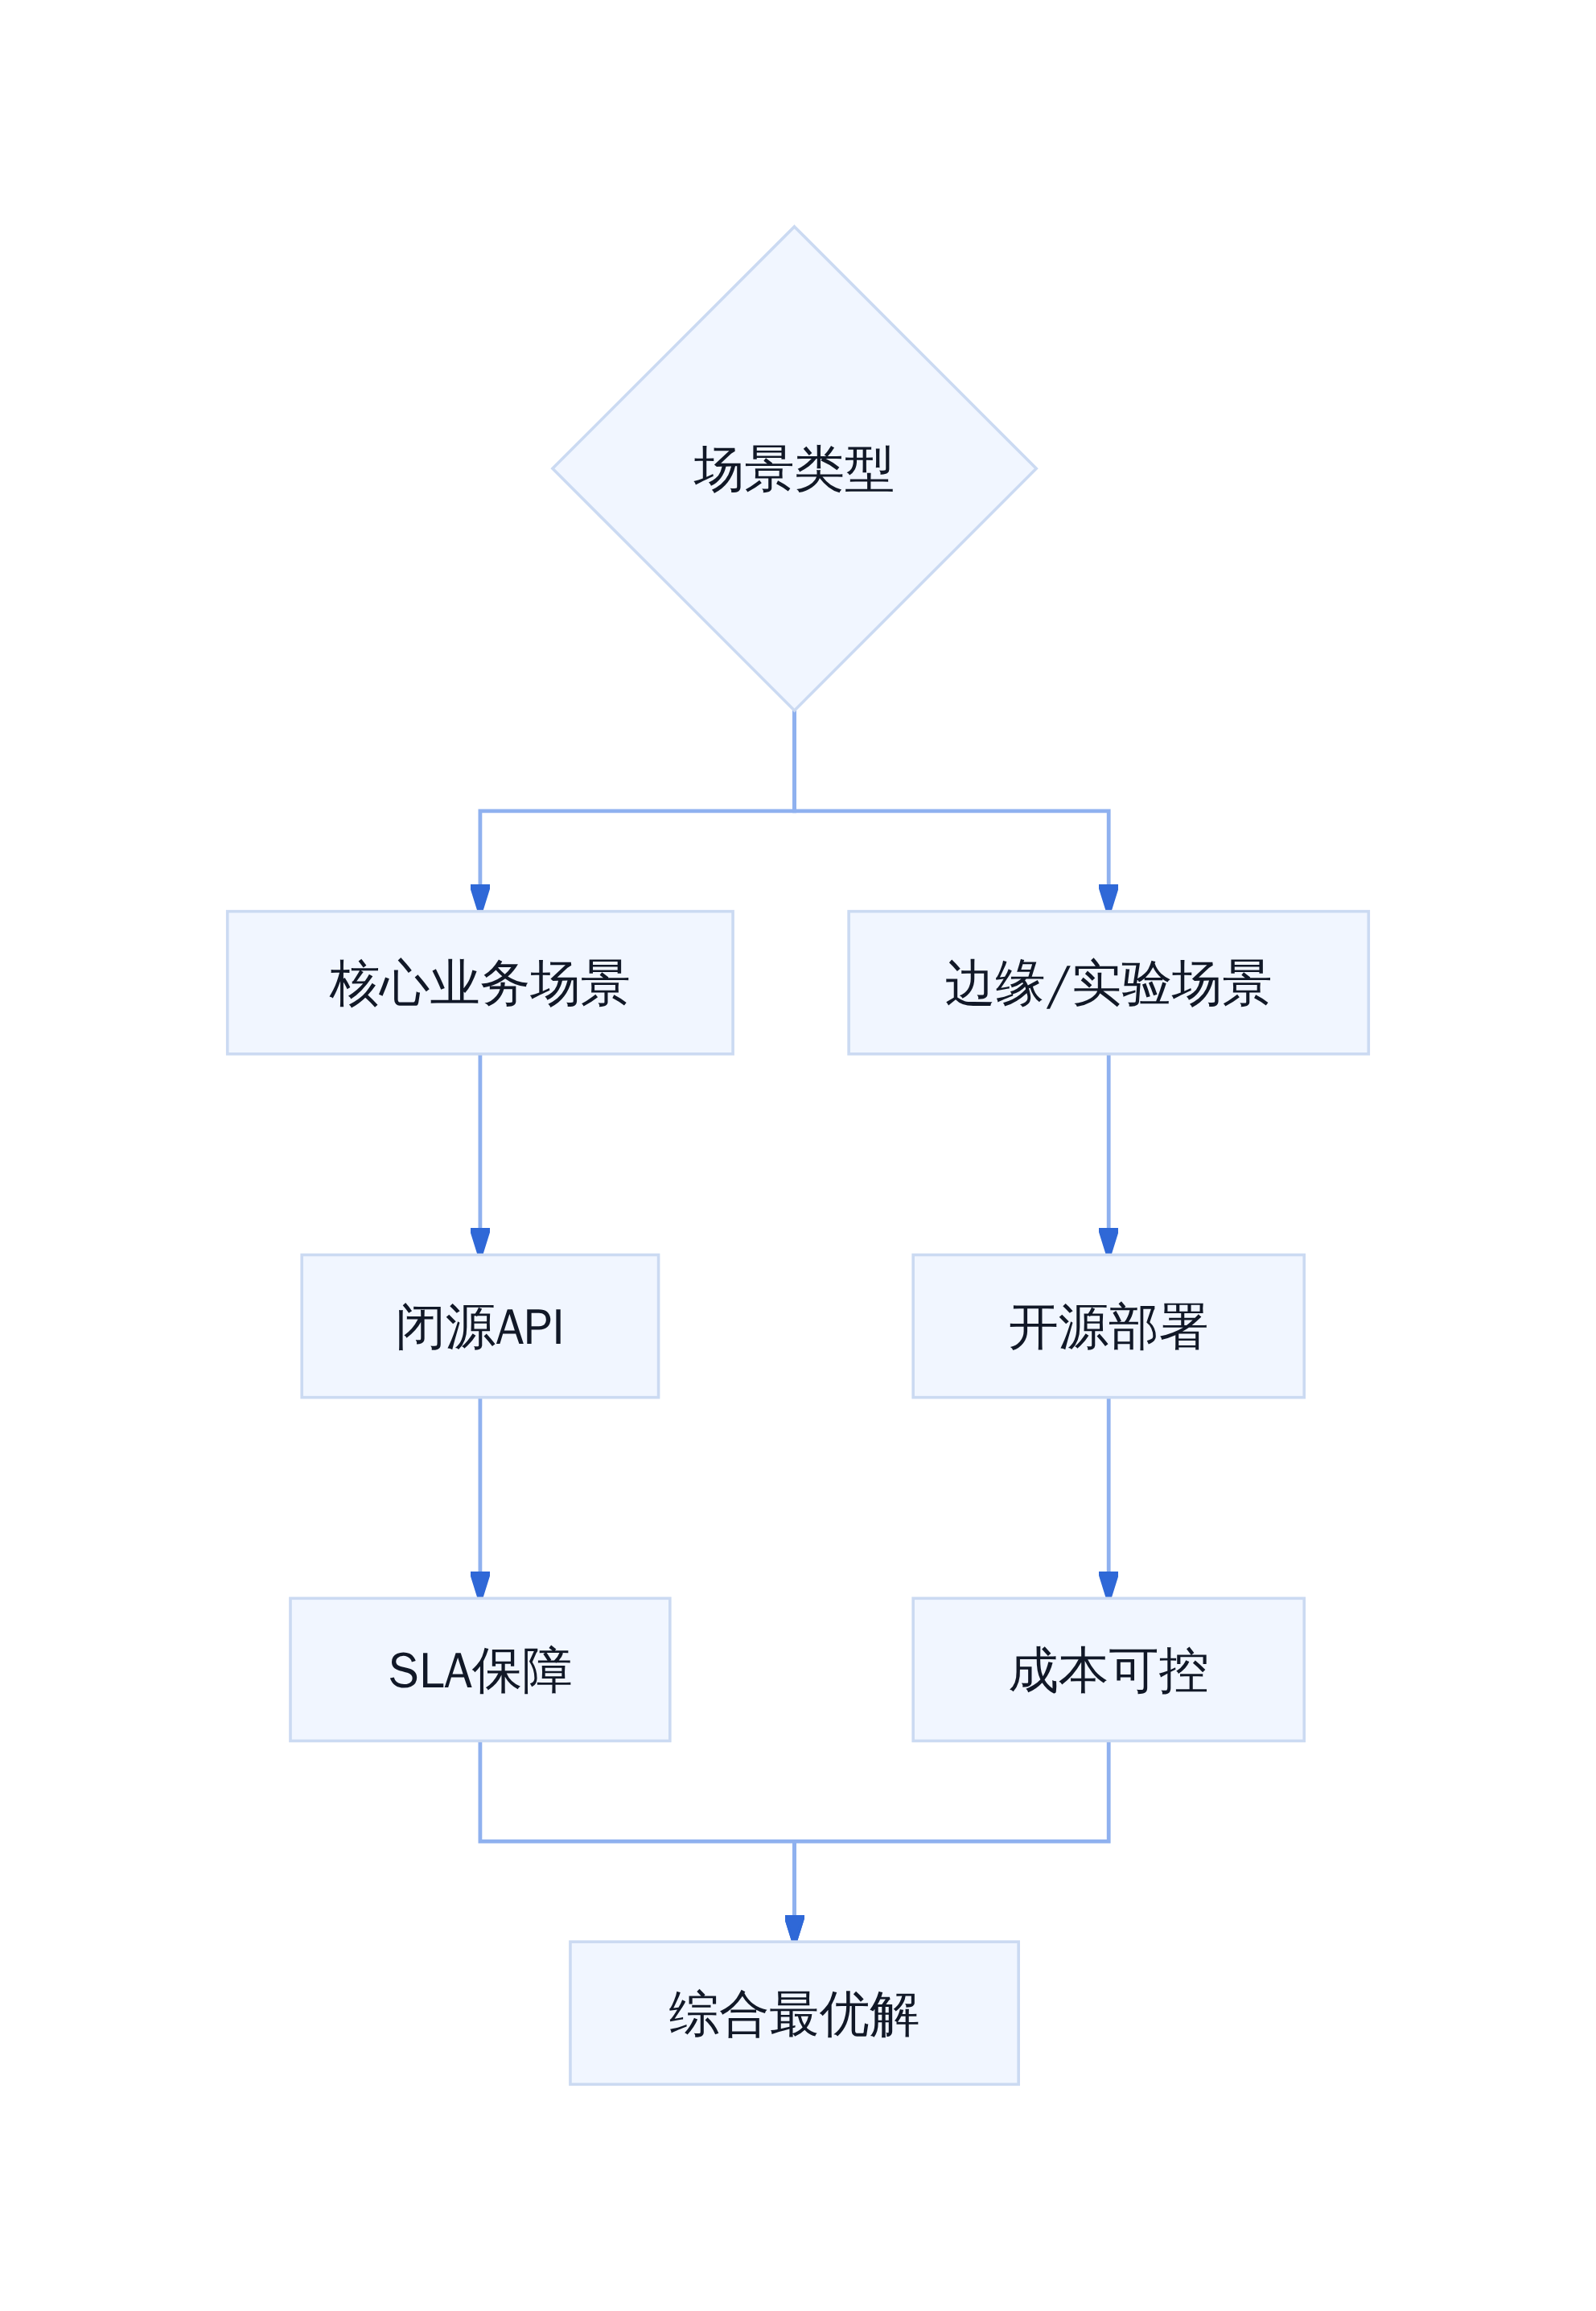
模型调用策略分流
不可能三角的价值重估
速度能力价格三者为何长期互斥
大模型行业长期遵循一个隐性约束:能力、速度和价格,三者不可兼得。这个约束并非技术定律,而是商业现实——更高参数的模型需要更多算力,推理成本随之攀升;为降低延迟而压缩模型规模,又会牺牲精度。过去两年,开发者只能在「强但贵且慢」「快但弱」「便宜但糊」之间做取舍。
Grok 4.7 的发布试图证明这个三角可以被拉伸。2.1 万亿参数、50 万上下文窗口、xhigh 推理强度,它在 Artificial Analysis 的智能指数上与 MiMo-V2.6-Pro 并列第一梯队。但参数堆到万亿只是入场券,真正决定生死的是调用一次的标价——Grok 4.7 按闭源旗舰定价,MiMo-V2.6-Pro 的 Flash 版输出单价不到其零头。同一个分数,截然不同的使用成本结构。
新版本的定价策略切中了哪些结构性痛点
MiMo-V2.6 系列选择了直接撕开这道口子。Pro 版本开源权重,Flash 版本以极低单价提供商业化 API,MIT 协议意味着企业可以自行部署、二次分发,不再被单一供应商绑定。对重度使用者而言,这意味着月预算从五位数降到三位数,且上下文窗口从 50 万扩展到 100 万,长文档处理不再需要分段切片。
闭源厂商的应对策略是在「省心」上继续加码。GPT-6 Astra、Claude Opus 系列提供的是一体化体验:托管服务、内置 MCP 工具链、自动重试与降级策略。开发者付出的溢价,买的是少维护的确定性。但当开源模型在编码和推理基准上追平闭源旗舰,这个溢价的合理性就开始被质疑。当智能开始免费,闭源厂商卖的就不是能力,而是省心。

架构图重构中的预算警报
开篇:同分不同价,闭源旗舰的尴尬开局
2026年9月,两家科技公司的旗舰模型几乎同时亮相。xAI的Grok 4.7参数规模达到2.1万亿,Artificial Analysis Intelligence Index评分46;小米的MiMo V2.6-Pro参数量约1.02万亿,激活参数420亿,同样拿到46分。前者是闭源API,后者是MIT协议开源。
两者的价格差异才是真正的戏剧点。Grok 4.7的xhigh模式定价是每百万输出token $6,而MiMo V2.6-Flash只有28美分。差距超过二十倍,如果算上Grok 4.6到4.7的升版周期以及不同推理档位,整体价差可达七十倍。
基准测试分数相同意味着什么?意味着参数堆到万亿只是入场券,真正决定生死的是调用一次的标价。
基准测试的幻觉与真实落差
Artificial Analysis的指标设计本身就值得审视。它衡量的更多是单一时间切片的能力上限,而不是持续生产环境中的稳定表现。一个模型在某次评测中答对,不代表它在Agent循环里不会陷入工具调用死循环。
OpenRouter上一个用户反映MiMo V2.6出现同一工具调用三次的loop问题。这不是极端案例——开源模型早期常有的稳定性波动。Grok 4.7同样面临评测争议,Vals Index上排第24位,比Grok 4.6的下滑5名。
基准测试分数是个数字游戏。真正的工作流压力测试需要看:首字时间、推理延迟、工具调用成功率、长上下文压缩后的信息丢失率。这些维度上,价格差异背后的技术取舍才会浮出水面。
二十亿参数的军备竞赛是否还有意义
2026年的参数竞赛已经进入边际收益递减区间。DeepSeek V4.1 Pro的评分是36,比MiMo V2.6-Pro低10分,但后者用了更激进的MoE架构把实际激活参数压到420亿。这意味着每生成一个token,省下的算力成本是实打实的。
参数规模不再是护城河,它只是入场券。真正的竞争转移到:推理效率、上下文窗口长度、多模态原生支持、以及定价策略。
账单数字突然安静了
机制拆解:为什么价格能差七十倍
推理延迟与首字时间如何重塑工作流
工作流的核心成本不是总token数,而是首字等待时间和延迟抖动。GPT-6 Pro在处理长代码生成任务时,首字延迟经常超过8秒;同样任务用MiMo Flash可以在2秒内返回。这个差距会直接传导到开发者体验上——等待过程中的上下文切换成本被严重低估。
闭源模型为了追求极致性能,往往牺牲推理速度。MiMo V2.6采用混合滑动窗口注意力机制,把KV缓存需求降低近6倍,同时保持100万token上下文。这个工程取舍让它在速度维度上形成代差优势。
开源释放权重后,开发者拿回了什么
开源权重释放后,开发者拿回了两样东西:部署自主权和成本可预测性。
第一,你可以把模型部署到自己的基础设施上,不再受限于API限流和可用性。第二,成本从「按次计费」变成「固定算力投入」,这对大规模使用场景的意义巨大。闭源API的价格再低,每次调用都在增加可变成本;开源模型只要算力到位,边际成本趋近于零。
闭源厂商的「省心」溢价
闭源模型的价格里,有一部分是「省心税」。你付的不只是token费用,还包括:运维保障、SLA承诺、合规审计支持、以及模型迭代责任转移。
当智能开始免费,闭源厂商卖的就不是能力,而是省心。这个溢价是否合理取决于你的组织是否需要把AI当作核心能力自建,还是更愿意外包给第三方。对大多数团队而言,当性能差距缩小时,省心的价值也在缩水。

评审会上没人再问「为什么用闭源」
商业逻辑转向:开源路线的价值锚点
不可逆的商业逻辑转向
2026年下半年出现了一个明确的信号:开源模型正在从「追赶者」变成「定价锚点」。DeepSeek V3推出时定价为GPT-4的十分之一,MiMo V2.6进一步把价格压到Grok 4.7的二十分之一。这不是竞争行为,这是重新定义行业标准的行为。
当开源模型的性能达到闭源模型的95%,而价格只有5%时,闭源模型的定价逻辑就站不住脚了。后续迭代只能沿着「性能提升」或「服务溢价」两条路走,但前者需要巨大投入,后者会让用户觉得不值。
真正的战场在哪
真正的战场不在基准测试分数上,而在以下三个维度:
第一,长上下文下的信息忠实度。MiMo V2.6之前版本曾出现过256k token压缩后远端信息丢失的问题,这个问题在V2.6是否有改进还不明确。
第二,多模态原生能力。Grok 4.7支持文本和图片,MiMo V2.6同时支持视频和音频输入。多模态能力的完整性会影响Agent系统的任务覆盖范围。
第三,工具调用稳定性。MiMo在早期评测中出现过工具调用循环的问题,这对于生产级Agent系统是不可接受的缺陷。
终端里的token计数器在归零
护城河与边界,接下来谁会先退场
闭源模型剩下的不可替代场景在哪
闭源模型并非没有生存空间,它的不可替代场景集中在三类:
第一,合规敏感行业。金融、医疗、法律等领域需要模型提供完整的审计追踪和合规保证,开源模型的部署责任需要自己承担。
第二,高可用SLA需求。闭源API提供明确的可用性承诺和故障响应机制,这对生产系统至关重要。
第三,生态绑定场景。某些闭源模型与特定工具链深度集成(如MCP协议、特定Agent框架),迁移成本会形成自然壁垒。
但需要注意的是,这三类场景的边界正在收缩。随着开源模型在稳定性上的改进、以及第三方托管服务的成熟,闭源模型的差异化优势会越来越窄。
开源生态的商业化终局是补贴还是分层
开源模型的商业化路径有两种可能:
路径一是补贴模式。像DeepSeek一样用低于成本的价格换取市场份额,通过生态效应或资本市场的估值回报盈利。这种模式可以快速占领市场,但可持续性存疑。
路径二是分层模式。基础模型开源免费,高端功能(如更长上下文、更强推理能力、优先支持)通过API收费。这种模式更接近传统软件的分层定价策略,也更可持续。
目前小米的选择似乎是后者:MiMo V2.6-Flash面向速度和成本敏感场景,MiMo V2.6-Pro面向性能敏感场景,两者都开源但API定价有差异。这是一个清晰的分层策略。
下一个季度的判断
2026年底到2027年初,会出现两个关键现象:
第一,闭源厂商会加速开源部分模型。当开源模型的性能逼近闭源旗舰时,闭源厂商的唯一策略是在开源侧建立更深的生态绑定,让开发者愿意为闭源模型的服务价值付费。
第二,开源模型的稳定性问题会成为新的竞争焦点。速度、成本、开源只是入场券,真正决定企业是否迁移的是生产环境中的可靠性。那些能解决工具调用稳定性、长上下文忠实度、以及多模态对齐的团队,会形成新的护城河。
基准测试分数相同不代表产品体验相同。价格差七十倍的背后,是两种完全不同的商业模式和长期战略。闭源模型的护城河在变浅,但还没有到退场的程度——前提是它能找到除「省心」之外的第二个价值锚点。
参考文献
- MiMo-V2.6 技术发布与开源:https://huggingface.co/XiaomiMiMo/MiMo-V2-Flash/discussions/2
- Grok 4.7 与 MiMo-V2.6-Pro 基准对比:https://llm-stats.com/models/compare/grok-4.7-vs-mimo-v2.6-pro
- OpenRouter 价格对比数据:https://openrouter.ai/compare/x-ai/grok-4.7/xiaomi/mimo-v2.6-flash
- Artificial Analysis 评测报告:https://aiweekly.co/alerts/xiaomi-mimo-v26-pro-ties-grok-47-atop-open-weights-index
- VentureBeat 报道:https://venturebeat.com/technology/better-than-deepseek-xiaomis-mimo-v2-6-pro-debuts-as-the-top-open-weights-model-in-the-world-alongside-cheaper-v2-6-flash
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师