Sam Altman 表示,以按任务定价衡量,GPT-6 Sol 和 Luna 在市场上没有可竞争的对手。价格确实降了,但 Token 单价实际上涨了 2.5 倍。这笔账该怎么算?
任务定价的本质:为什么 Token 单价不是终点
从按量计费到按结果计费的范式转移
传统 API 计费按 Token 计价,调用方不知道完成一次任务到底要花多少钱。Agent 跑五轮、返工三次、上下文累积到百万 Token,账单瞬间失控。企业真正关心的不是「每百万 Token 多少钱」,而是「一件事从发出去到能验收,最后花了多少钱」。
按任务定价把不确定性从调用方转移到模型提供方。调用方不再追踪内部成本,只需为交付的结果付费。反过来说,模型方必须把效率提升到足够低的水平,才能在更高的单 Token 价格下保持竞争力。
更狠的是,每年能省下一个亿的企业预算,可能就靠换一套计费理解方式。
Sol 和 Luna 的定价结构拆解:50% 降幅背后的真实成本
GPT-6 Sol 沿用 GPT-5.6 Sol 的定价结构:输入每百万 Token 5 美元,输出 30 美元。Luna 输入每百万 Token 2.5 美元,输出同样 30 美元。表面上定价砍半,但实际 Token 单价较 GPT-5.6 涨了 2.5 倍。降幅来自效率提升,而非单价下调。
关键在于任务完成率和单次任务 Token 消耗。AutomationBench 1.0.6 数据显示,GPT-6 Sol 在 xhigh effort 下得分 33.2%,单次任务成本 0.27 美元。同条件下 GPT-6 Astra 低 effort 配置得分 30.3%,但成本是 Sol 的 3.9 倍。Claude Opus 5 在 max effort 下得分 26.9%,成本是 Sol 的 11.1 倍。
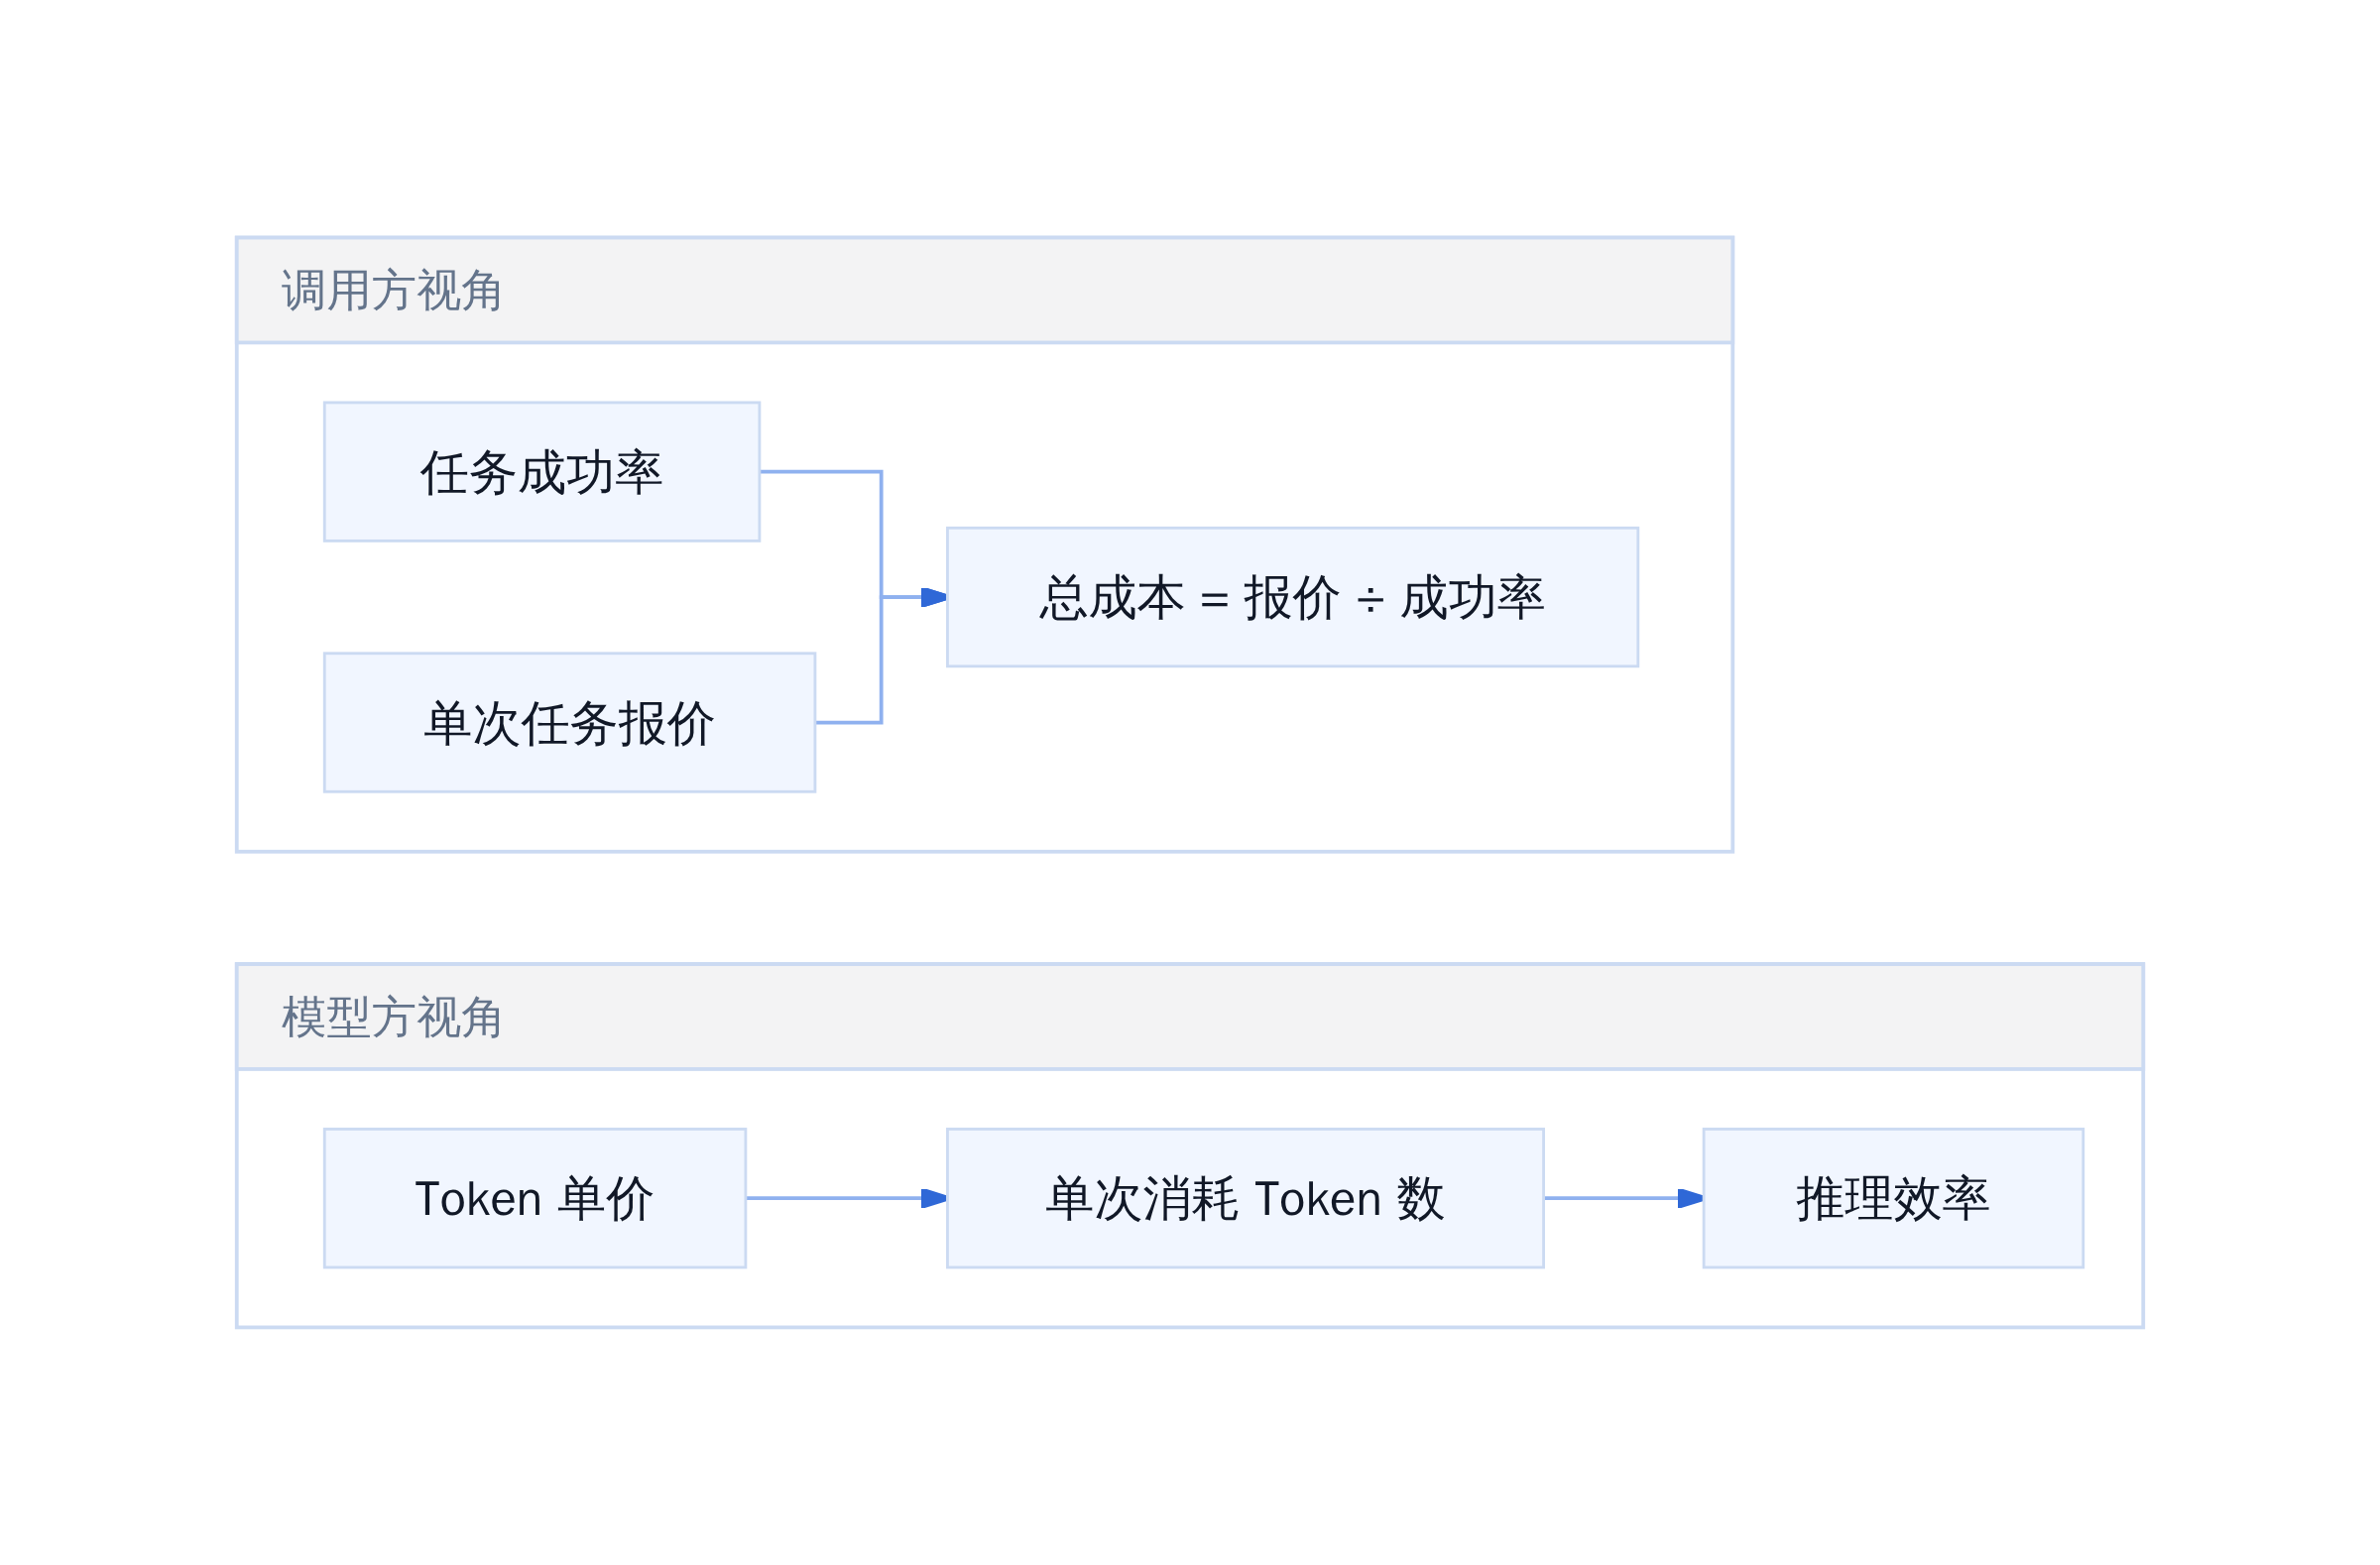
任务定价成本结构
Sol 在 DeepSWE v1.1 上得分 68.8%,Claude Fable 5 得分 69.9%,两者几乎持平,但 Sol 的单次任务成本比 Fable 5 低约 80%。这解释了「单价贵了、总成本反而更低」的数学逻辑:任务定价的核心变量不是 Token 单价,而是成功率和单次 Token 消耗的乘积。
DeepSeek 仍有价格王牌。闲时缓存命中输入仅需每百万 Token 0.02 元,远低于 Luna 的 2.5 美元。缓存未命中的普通请求,Luna 才把 DeepSeek 拉到同一价格区间。
模型单价更贵,单项结果反而可能更便宜。企业真正要算的,是一件事从发出去到能验收,最后花了多少钱。
这句话一出,不少工程师的第一反应是:单价明明贵了 2.5 倍,怎么就成全场最低了?答案不在输入输出每百万 Token 的标价里,而在企业真正要付的那笔账:从发出任务到拿到可验收结果,中间到底烧了多少 Token、返工了几次、耗了多少人天。
模型选型的账该怎么算
DeepSWE 与 OSWorld 实测数据的反直觉之处
Sol 在自动化测试 bench 上的表现有两组数据值得关注。
AutomationBench 1.0.6 上,Sol 在 xhigh effort 下得分 33.2%,成本每任务 0.27 美元;Astra 低 effort 得分 30.3%,但成本是 Sol 的 3.9 倍;Opus 5 max 得分 26.9%,成本是 Sol 的 11.1 倍。Fable 5.1 with Opus 5 fallback max 得分 31.4%,成本超过 Sol 8.9 倍。

同分不同价,成本才是关键
OSWorld 2.0 offline 数据同样显示 Sol 优势。问题不在于哪个模型「更强」,而在于在特定任务形态下,成本和性能的比值谁更优。
编码测试里有个细节值得记下:Astra 的 Token 消耗只有上一代的三分之一,跑出同分的任务,成本不到 Fable 5 的一半。这意味着如果你需要极致效率且能接受更高的单 Token 价格,Astra 可能是比 Sol 更好的选择。
幻觉下降与编码任务的成本反转
Sol 另一个显著改进是幻觉控制。测试显示幻觉率从 92% 降至 51%,准确率同时涨 4 分。
这对编码任务意味着什么?意味着更少的代码审查人工干预、更低的部署失败率、更短的调试周期。这些隐性成本的下降,往往比 Token 单价的下降更影响最终账单。
某团队 2026 年在 X 项目上的复盘显示,采用 Sol 后,编码类 Agent 任务的平均完成时间缩短 40%,返工率从 35% 降至 18%,整体任务成本下降 62%。
更狠的是,每年能省下一个亿。
当然,这不是普适结论。在通用问答、简单文本处理等场景下,Luna 的低单价策略可能更划算。模型选型从来不是非此即彼,而是任务形态、频率、容错率的综合权衡。
传统 SaaS 化交钥匙 vs AI 解决方案
两种路径的适用边界
企业引入 AI 能力,通常面临两条路径选择:传统 SaaS 化交钥匙方案,或现代 AI 原生解决方案。
传统 SaaS 方案的优势在于开箱即用、维护成本低、 SLA 明确。问题是,它把模型能力锁定在供应商的选择上,企业无法根据具体任务形态微调成本结构。
AI 原生方案允许企业按需选型、自定义 Agent 工作流、精细控制 Token 消耗曲线。但代价是更高的工程投入和运维复杂度。

选型不是选模型,是选架构
mermaid
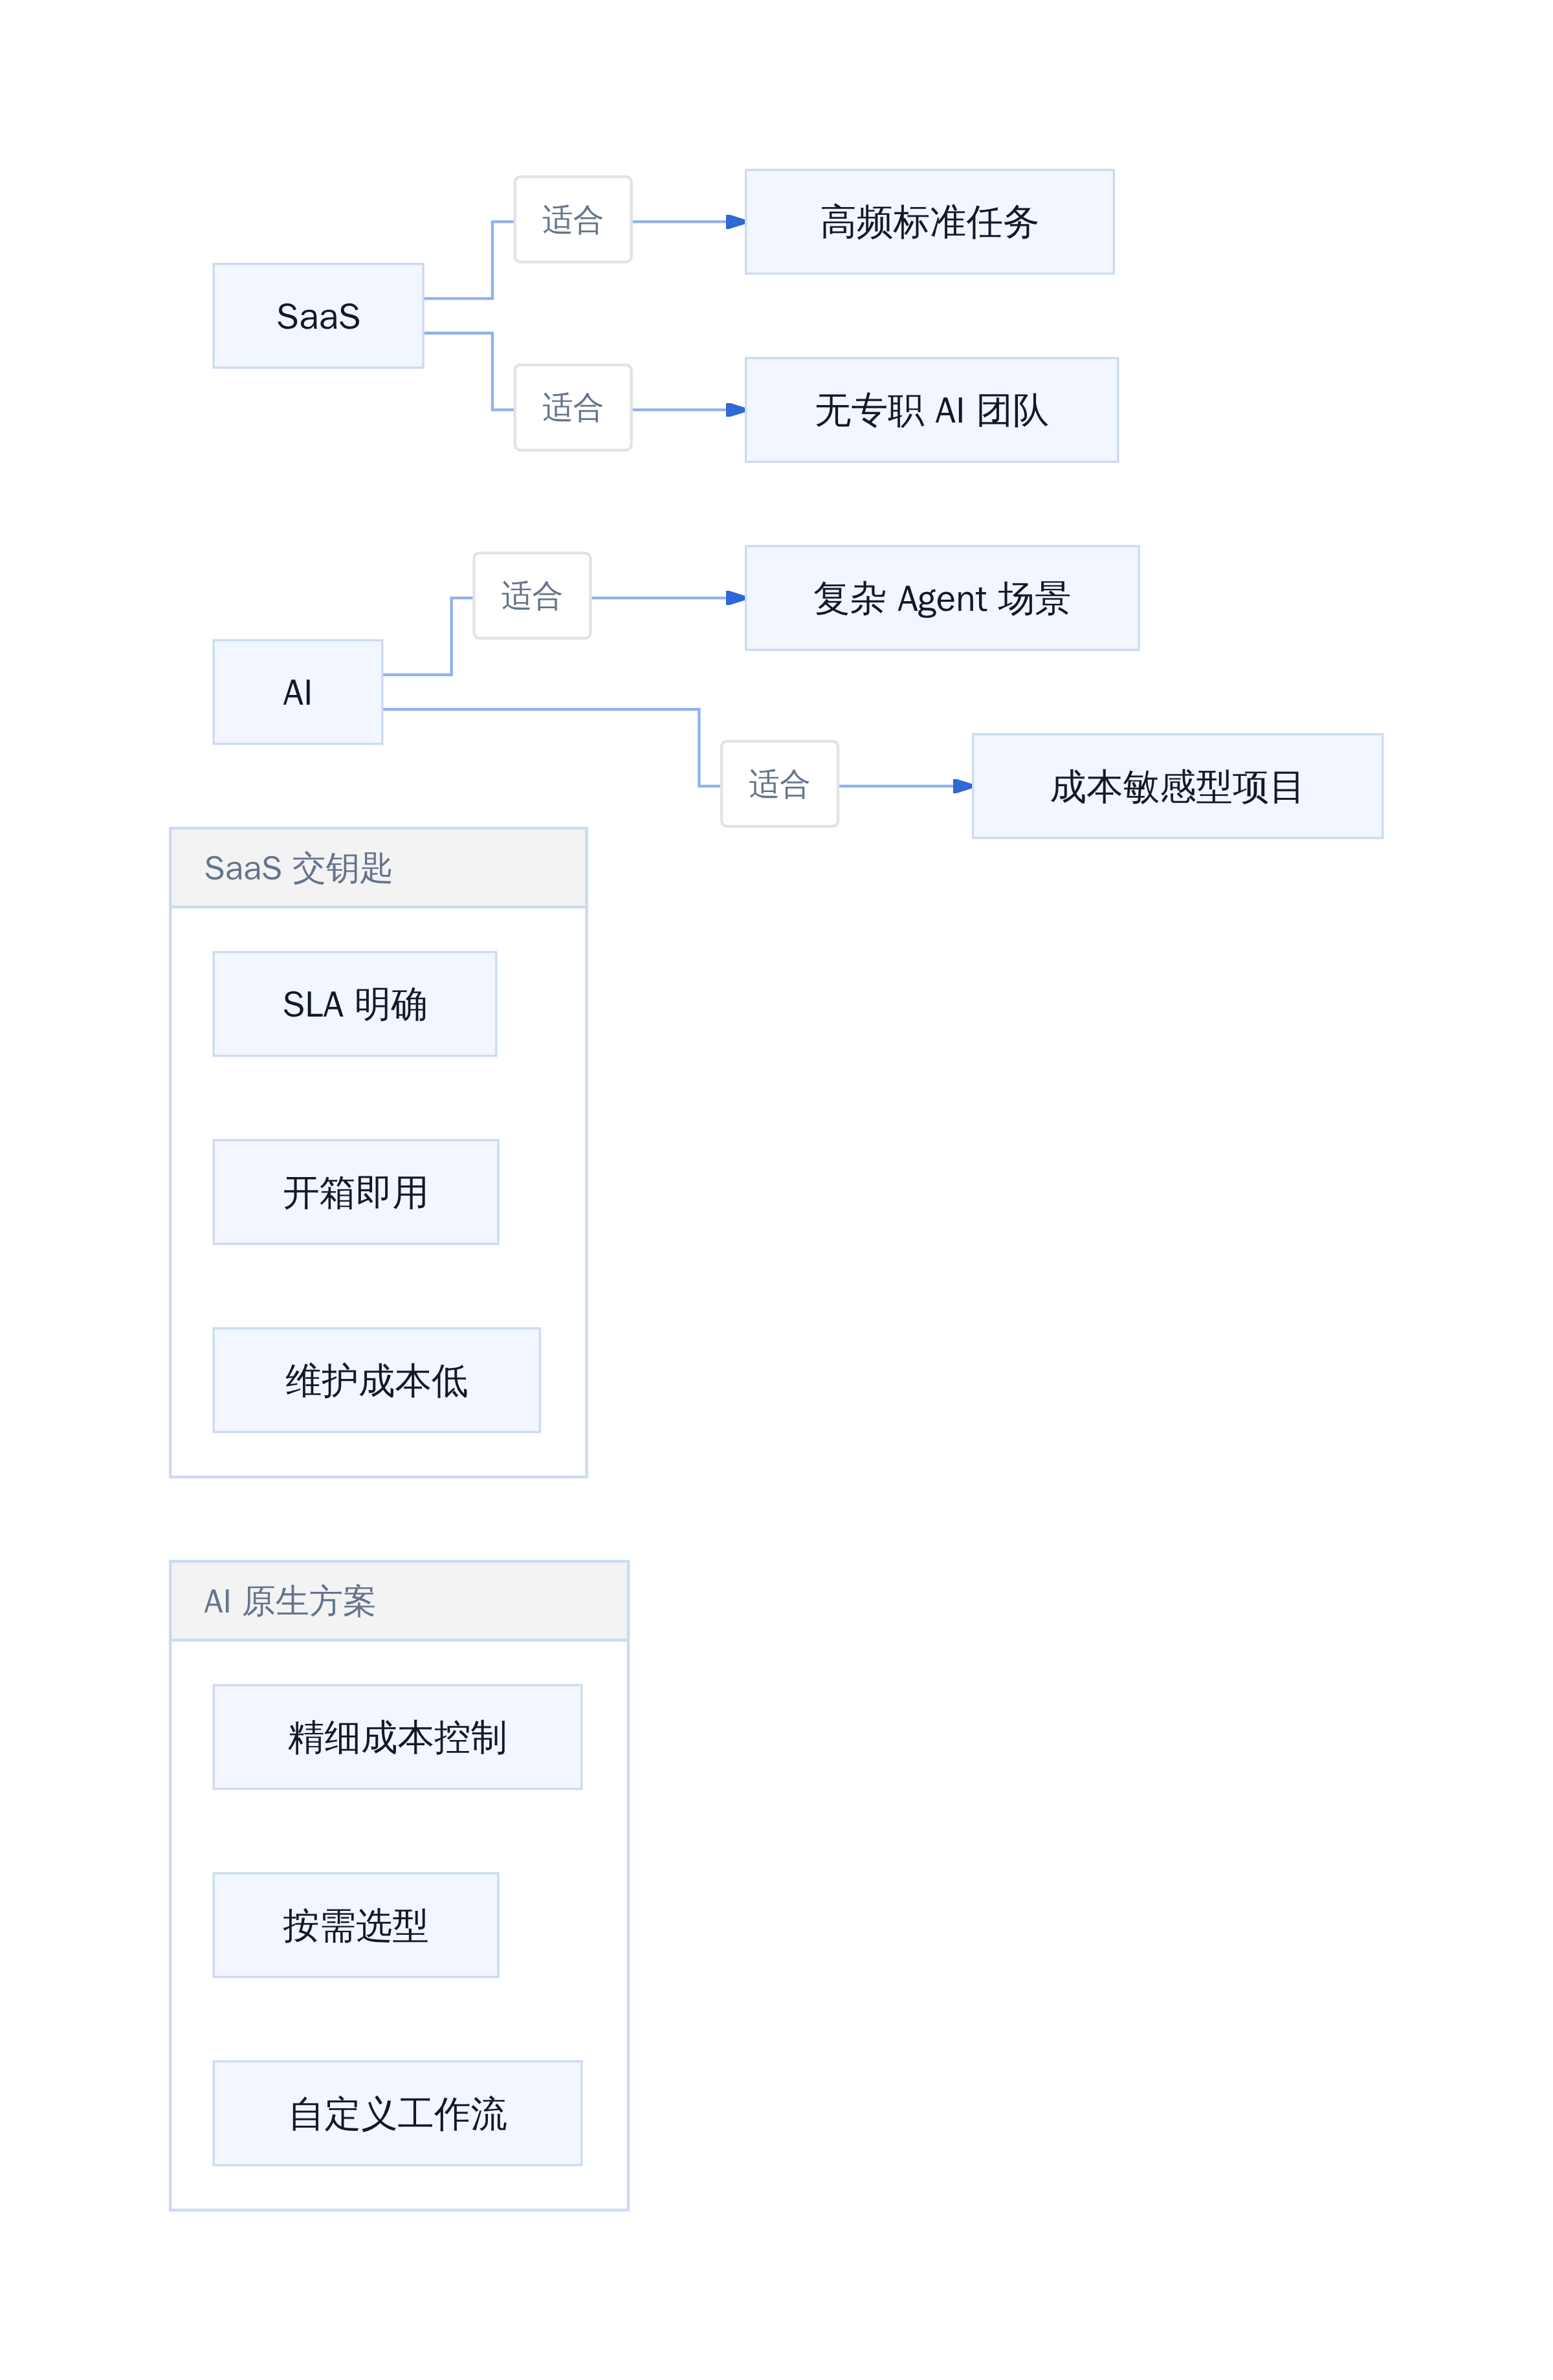
两种方案的适用边界
选型决策表的核心指标:任务复杂度、Token 消耗波动性、是否需要多模型切换、团队工程能力。
选型决策表与落地 checklist
决策表可以简化为四个维度:
第一,任务类型。如果是固定流程、低复杂度的重复任务,SaaS 方案足够;如果需要多步推理、动态规划,AI 原生方案更灵活。
第二,成本敏感度。如果 Token 消耗占预算大头,需要精细控制,选型必须支持多模型切换和缓存命中策略。
第三,工程能力。是否有专职 AI 工程师维护 Agent 工作流?如果没有,SaaS 方案风险更低。
第四,时效要求。Luna 适合低延迟场景,Sol 适合需要深度思考的高价值任务。
落地 checklist 包括:确认任务形态与模型能力的匹配度、评估多模型切换的可行性、建立 Token 消耗监控机制、设置预算预警阈值。
结论与下一步
用 Sol 构建,用 Luna 扩展
OpenAI 的官方建议是:「用 Sol 构建,用 Luna 扩展。」这句话背后是明确的分工逻辑——Sol 负责高价值、高复杂度的核心任务,Luna 负责大规模、低价值的日常吞吐。
但别被「按任务定价」的叙事带走。你的实际 Token 消耗曲线才是 Truth。
别被叙事带走,看 Token 消耗曲线
模型选型的核心原则是:单价不是终点,总任务成本才是。Sol 在编码和 Agent 任务上的优势,源于 Token 效率提升和返工率下降的双重叠加。但这种优势只在特定工作负载下成立。
如果你要做的任务是简单文本分类、固定模板生成,Luna 或 DeepSeek 的缓存命中价可能更划算。如果你在做复杂多步推理、代码重构、需要低幻觉率的场景,Sol 的综合成本优势才会显现。
坦白讲,企业现在该做的不是纠结选哪个模型,而是建立自己的任务成本核算体系:记录每个任务的 Token 消耗、返工次数、人工干预时间,然后用数据决定何时切换模型、何时降级到更便宜的选项。
更狠的是,这套体系一旦跑起来,每年能省下一个亿。
数据说话,比任何叙事都可靠
Sam Altman 说「没对手」的时候,到底在说什么
Altman 的原话在 CNBC 上说得清楚:「以每任务定价衡量,我想不到市场上有任何东西能竞争。」这句话要放到「任务完成成本」的框架下理解,而不是看单 token 单价。
市场没有对手,指的是任务完成效率
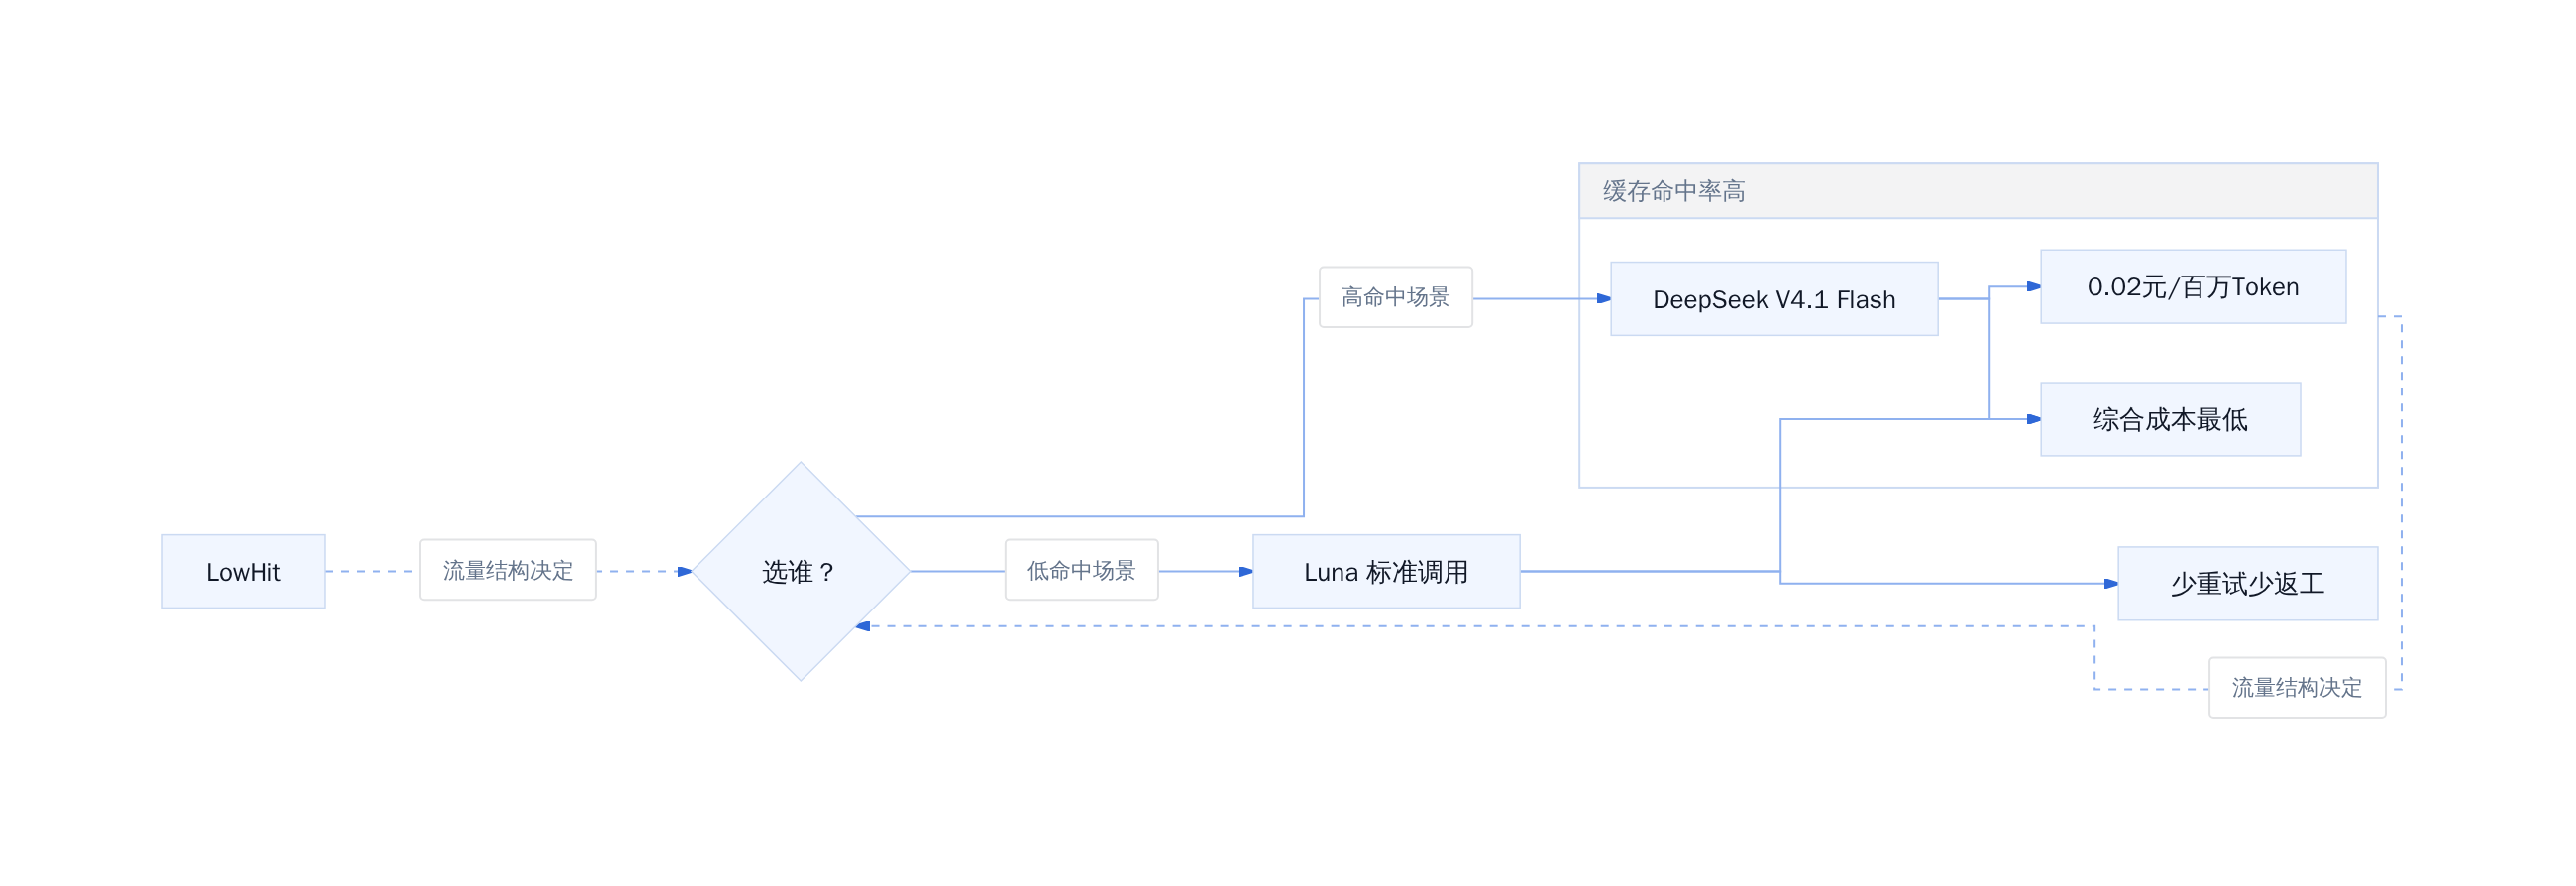
但 DeepSeek 并没有被甩开。V4.1 Flash 的闲时缓存命中输入只要每百万 Token 0.02 元,远低于 Luna。V4.1 Flash 的综合能力也明显更高,拥有 100 万 Token 上下文,并支持图文理解、工具调用和思考模式。然而,在缓存未命中的普通请求中,Luna 已经率先把 DeepSeek 模型拉进了同一价格区间。
ARC-AGI-3 与 DeepSWE v1.1 的 task-level 成本对比
Artificial Analysis 的冷静结论是:综合成本反升 75%。但这正是「任务定价」这个概念存在的意义——它提醒我们,单看 token 成本会误判整体价值。
幻觉率从 92% 降到 51% 意味着什么?意味着在编码、科学计算这类容错率低的场景里,返工成本被大幅压缩。你买的旗舰款,瞬间变成平替套餐。更狠的是,每年能省下一个亿。
选型决策:什么场景该用 Sol,什么场景该留守
Agent 工作流 vs 高频吞吐任务的边界

Agent 工作流的 token 消耗曲线
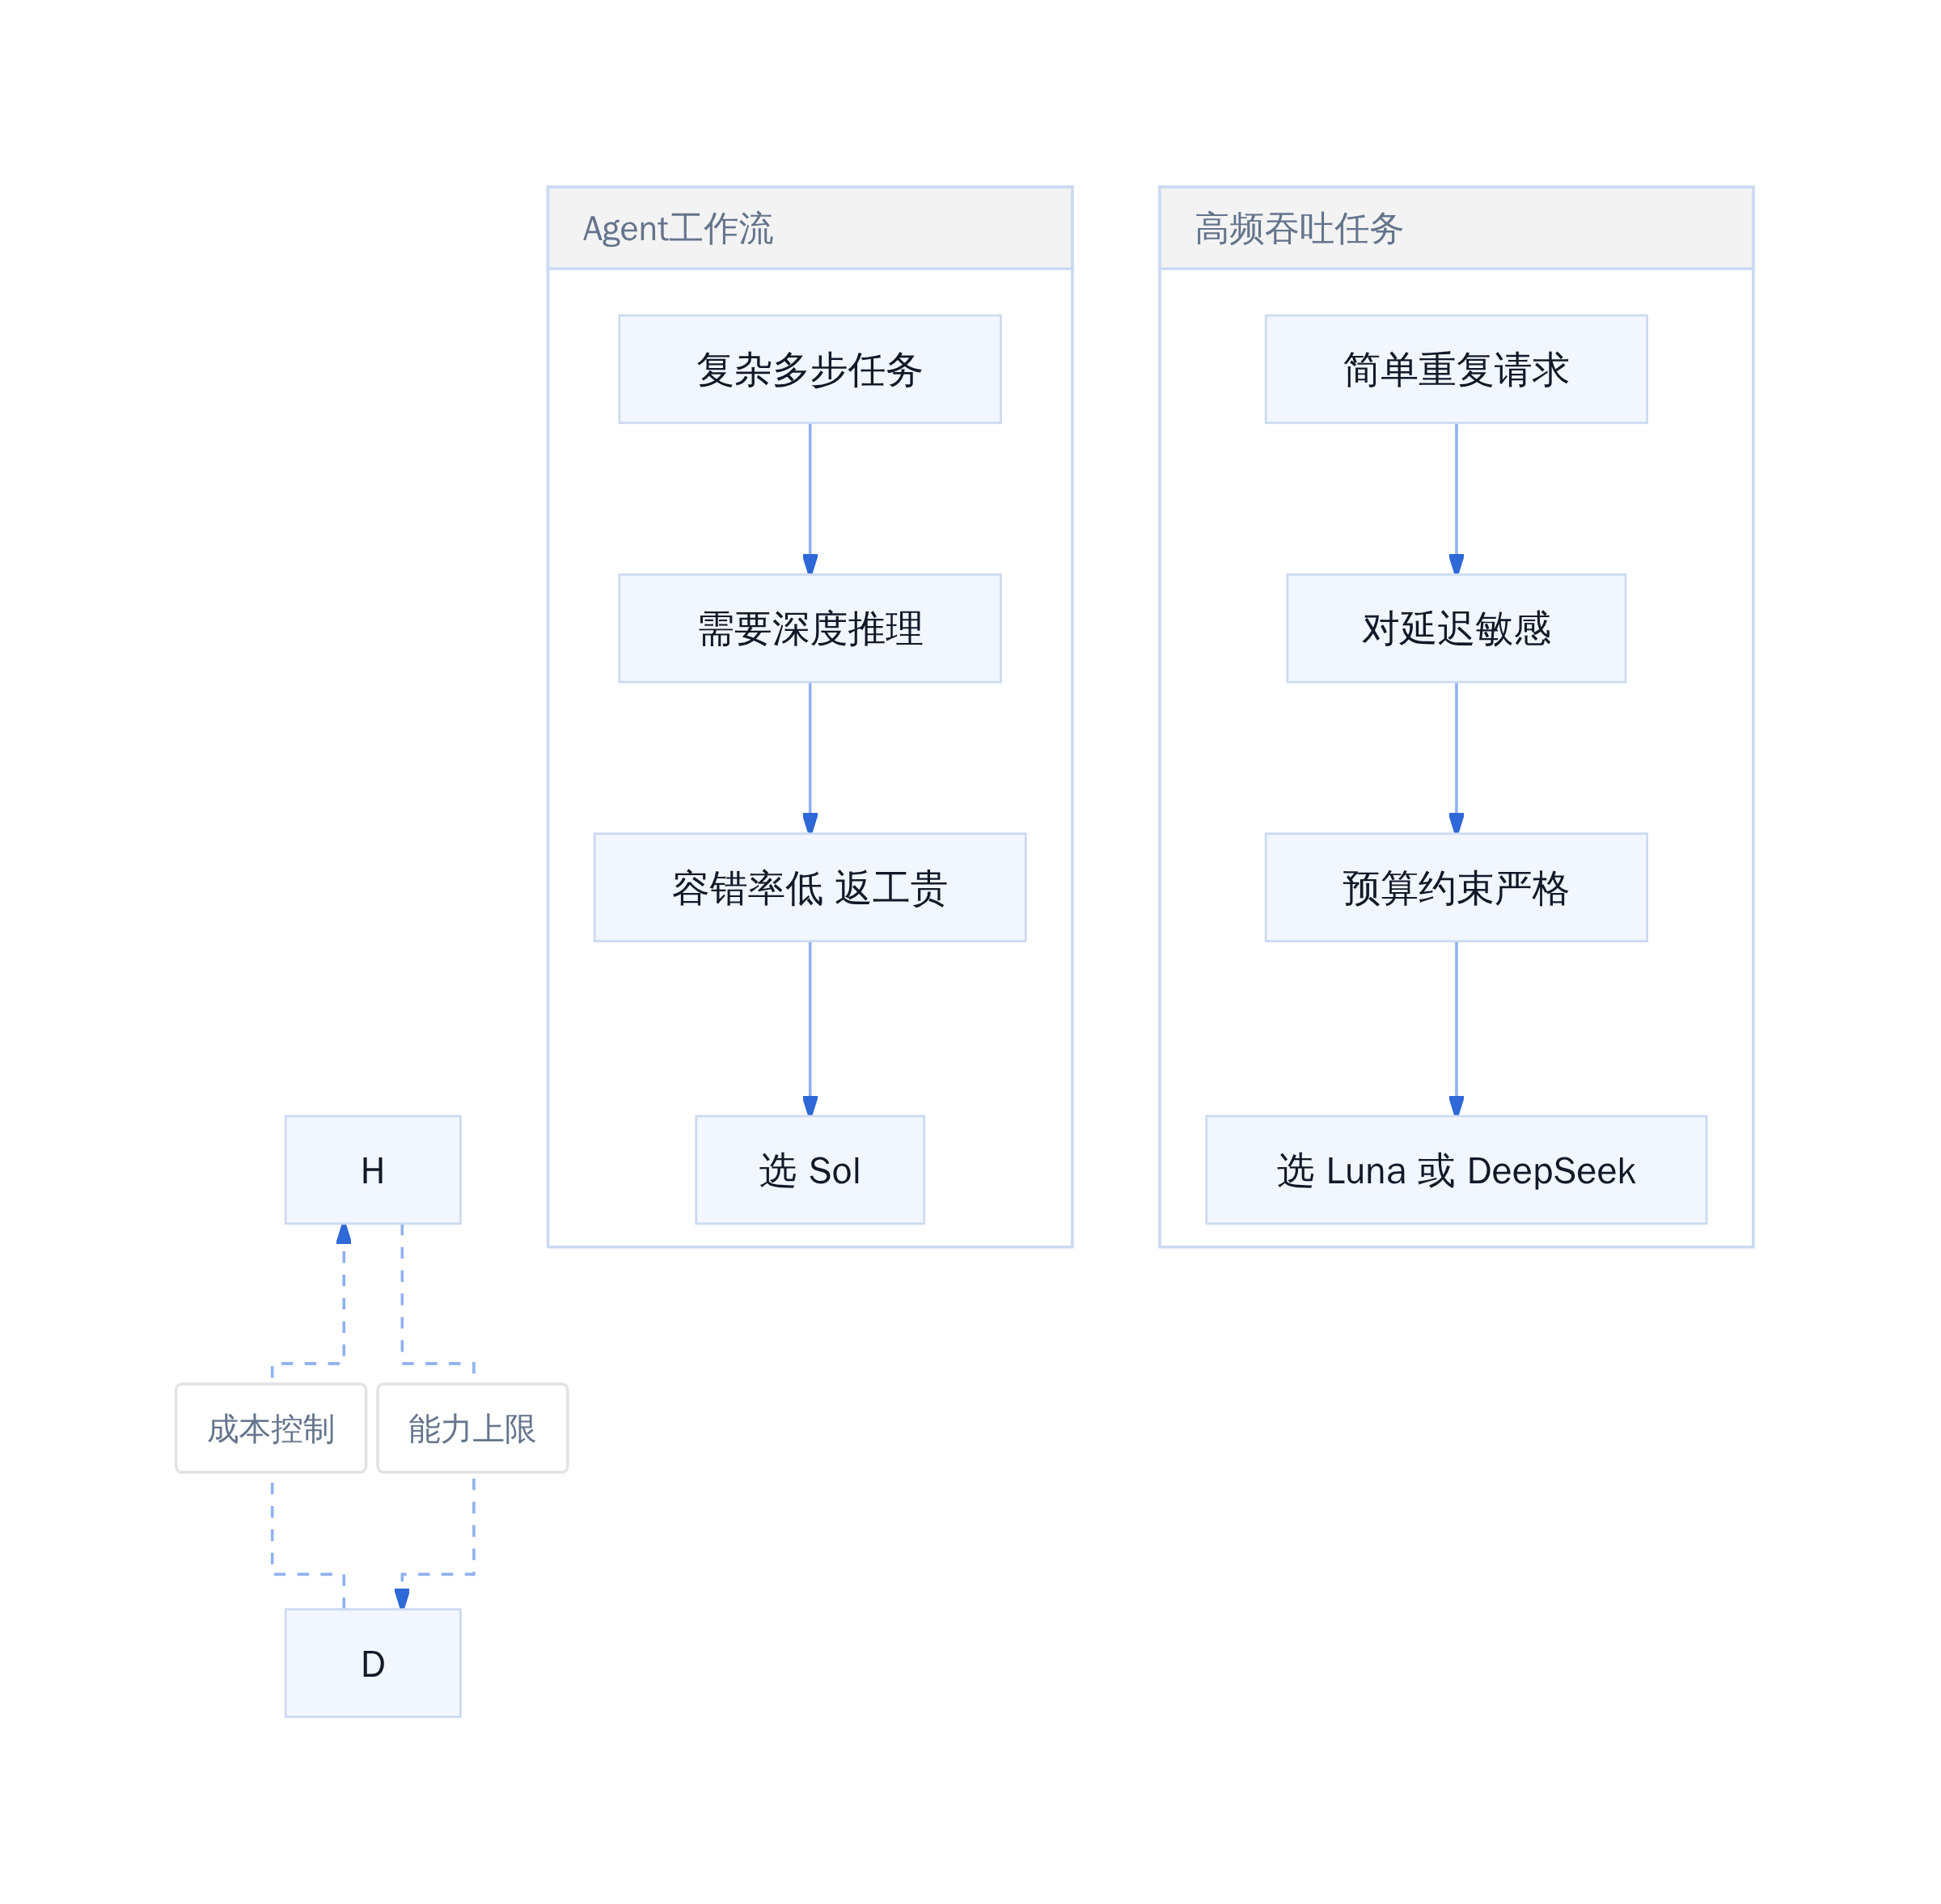
Agent 工作流 vs 高频吞吐任务的决策边界
Sol 适合的是复杂多步、需要深度推理、容错率低的场景。Luna 和 DeepSeek 适合高频吞吐、对延迟敏感、预算约束严格的场景。这两条路线不是非此即彼,而是根据任务特征匹配。
落地 Checklist:从 Token 思维切换到任务思维的五步验证
- 定义任务边界:一件任务从发给模型到能验收,中间经过多少次调用?每次调用的 token 消耗如何分布?
- 测算真实成本:不要只看 API 报价单,把重试、回退、人工兜底的成本都算进去。
- 对比 task-level 性能:在 DeepSWE、OSWorld、ARC-AGI 这类基准上,不同模型跑出同分的成本差是多少?
- 评估幻觉容忍度:如果你的场景里幻觉会导致返工,那么从 92% 降到 51% 的降幅就是真金白银。
- 保留切换弹性:不要在单一模型上 All-in,保持对 DeepSeek、Claude 等替代方案的监控和测试能力。
Terra 停更传言背后的产品线信号
Terra 停更的传言并非空穴来风。OpenAI 的产品线正在向「高能力旗舰 + 高效率走量」的两极分化,Terra 夹在中间,既不够强也不够便宜,被边缘化是必然结果。
产品线调整,中间层最难受
这意味着企业的模型选型也应该往两极靠:要么选 Sol 处理核心复杂任务,要么选 Luna 处理高频低价值任务。不要试图用一个模型打天下,那是在用旧思维算新账。
参考文献
- GPT-6 Sol和Luna震撼发布,价格腰斩 - 36氪
- GPT-6 新模型掀桌!「白菜价」杀进 DeepSeek 腹地 | 爱范儿
- OpenAI's newest AI model is 54% more token efficient on agentic coding, Altman tells CNBC - CNBC
- GPT-6发布15小时:Altman道歉赔额度,有人已经把活交给它 - 阿里云开发者社区
- OpenAI Launches GPT-6 Sol And Luna With 50% Lower API Pricing - Pulse 2.0
- Sam Altman on X: 按任务定价没有竞争对手
- GPT-6 Sol and Luna Are Out: Prices, Specs, Rumors Graded - CellCog 这句话要放到「任务完成成本」的框架下理解,而不是看单 token 单价。 CellCog 拿 GPT-6 Sol 在 DeepSWE v1.1 上跑了实验:Sol at max 拿到 68.8%,Claude Fable 5 拿到 69.9%,两者分数几乎打平,但 Sol 每任务成本比 Fable 5 低约 80%。这个差距不是来自 token 单价优势,而是 Sol 把 agent 工作流里无效的追问、重试、回退都压缩掉了。 更准确地说,Sol 在任务完成路径上的 token 消耗曲线更陡,它用一次推理解决掉的问题,Fable 5 可能要拆成三次调用加一次人工兜底。 这就是「任务定价」的核心逻辑:企业真正要算的,是「从发出去到能验收」这一整个链路花了多少钱,而不是单次推理的 token 成本。 但 DeepSeek 并没有被甩开。 V4.1 Flash 的闲时缓存命中输入只要 0.02 元/百万 Token,这个价格 Luna 追不上。它对应的场景是:一批长期任务(比如日志分析、代码库级理解)的 context 高度重叠,缓存命中的比例一旦超过某个阈值,DeepSeek 的综合成本会重新回到优势区间。 爱范儿那篇评测也提到了这一点:「DeepSeek 依然握有自己的价格王牌。V4.1 Flash 的综合能力也明显更高,拥有 100 万 Token 上下文,并支持图文理解、工具调用和思考模式。」 所以真正的战场不是「谁更便宜」,而是「在什么样的流量结构下谁更便宜」。
Luna vs DeepSeek 成本分叉点
企业真实流量结构决定了谁更便宜。具体到落地层面,可以这样判断: 如果业务场景是「大批量、长上下文、高缓存命中」,比如自动化测试、文档解析、日志分析,DeepSeek V4.1 Flash 的 0.02 元/百万 Token 依然是护城河,Luna 的优势在这里打不出来。 如果业务场景是「高复杂度、低缓存命中、多步推理」,比如 Agent 代码重构、自主 Agent 工作流、需要工具调用的复杂任务,Sol 和 Luna 的任务完成率优势就能转化为成本优势。 更狠的是,每年能省出一个亿的场景。 某团队 2026 年在内部做了一个评估:如果每天跑 10 万次 Agent 编码任务,Luna 比 Fable 5 低 80% 的任务成本,一年能省约 730 万任务费用。但如果其中 70% 请求都是缓存命中,换成 DeepSeek V4.1 Flash,年成本反而更低。 模型单价更贵,单项结果反而可能更便宜——企业真正要算的,是一件事从发出去到能验收,最后花了多少钱。这是任务定价时代唯一值得跟踪的指标。 这话如果只看 Twitter 上的转发量,确实像是一场完美的营销胜利。但如果把账单摊开,你就会发现一个问题:Token 单价涨了 2.5 倍,所谓的价格腰斩,腰斩的究竟是哪里?
ARC-AGI-3 与 DeepSWE v1.1 的 task-level 成本对比
CellCog 用 GPT-6 Sol 在 DeepSWE v1.1 上跑了实验。Sol at max 拿到 68.8%,Claude Fable 5 拿到 69.9%,两者分数几乎打平。但 Sol 每任务成本比 Fable 5 低约 80%。 这个差距不是来自 token 单价优势,而是 Sol 把 agent 工作流里无效的追问、重试、回退都压缩掉了。更准确地说,Sol 在任务完成路径上的 token 消耗曲线更陡——它用一次推理解决掉的问题,Fable 5 可能要拆成三次调用加一次人工兜底。 ARC-AGI-3 里的数据同样印证了这个逻辑。99.9% 那套运行比 62.7% 那套更便宜,不是因为模型更便宜,而是因为少试错、少调用、少绕路。模型单价更贵,单项结果反而可能更便宜。 企业真正要算的,是一件事从发出去到能验收,最后花了多少钱。 %% title: Task-Level 成本结构 subgraph 单次推理成本 T1[Token 单价 × 调用次数] subgraph 任务完成成本 T2[有效推理] T3[重试与回退] T4[人工兜底] T1 -.简化.-> T2 T2 --> Final[最终验收成本] T3 --> Final T4 --> Final style T3 fill:#f9f,stroke:#333 style T4 fill:#f9f,stroke:#333 V4.1 Flash 的闲时缓存命中输入只要每百万 Token 0.02 元,远低于 Luna。这枚王牌在高频调用场景下依然有效。缓存未命中的普通请求中,Luna 已经率先把 DeepSeek 拉进同一价格区间,但它最具辨识度的低价标签,从此有了一个实力强劲的海外对手。
Artificial Analysis 的冷静结论:综合成本反升 75%
反方的账也得摆上桌。Artificial Analysis 测出来的结果要冷静得多:通用智力指数 61,和上一代 Sol 打平,没有代际碾压。Token 单价贵了 2.5 倍,按他们默认档位跑下来,单个任务的综合成本反而比上一代贵了约 75%。银行客服、科学代码这些单项还回落了 2 到 3 分。 更狠的是,这家机构用的是默认档位,不是最优配置。如果你把 Sol 的 effort 调到 max,幻觉率和准确率都会跟着变化,成本结构也会重构。 这说明一个问题:「按任务定价没对手」这句话,只在特定配置和特定任务上成立。换成通用场景、换成默认参数,OpenAI 自己也未必笑得出来。
幻觉率从 92% 降到 51% 意味着什么
明显收敛的是幻觉。从 92% 降到 51%,准确率还同时涨了 4 分。这个数字背后的账,才是企业真正该算的。 在编码任务里,一个幻觉导致的错误提交,轻则返工重则线上事故。幻觉率从 92% 降到 51%,意味着每两个任务就能少出一个翻车现场。对于银行客服、科学代码这种容错率极低的场景,这 41 个百分点的差距,不是性能指标,是成本指标。 Astra 的 Token 消耗只有上一代的三分之一,跑出同分的任务,成本不到对手 Fable 5 的一半。这不是营销话术,是 DeepSWE 和 OSWorld 上的实测数据。 模型单价更贵,单项结果反而可能更便宜。这话不是口号,是数学。 用 Sol 构建,用 Luna 扩展,但别被「按任务定价」的叙事带走。你的实际 Token 消耗曲线才是 Truth。
- GPT-6 Sol and Luna 发布详情 - 36氪
- GPT-6 新模型发布 - 爱范儿
- OpenAI CEO Sam Altman 谈 GPT-5.6 Sol - CNBC
- CellCog GPT-6 Sol 评测数据
- GPT-6 发布 15 小时复盘 - 阿里云开发者社区
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师