五年一场仗:从3%到50%的市场翻转
2022年,国内某大厂采购会议桌上摆着两份报价:一份是英伟达H800,一份是华为升腾910B。采购负责人当时毫不犹豫签了前者——如今这份合同已成历史。
那段时间,英伟达在中国AI加速器市场的占有率接近95%,国产芯片几乎被挤出核心采购名单。昇腾910B单卡算力不及H100的一半,生态适配成本也让不少团队望而却步。行业共识是「有H800不用,非要选国产,纯属给自己找麻烦」。
但麻烦很快就来了。
2022年的分水岭:英伟达95%独占,国产芯片无地自容
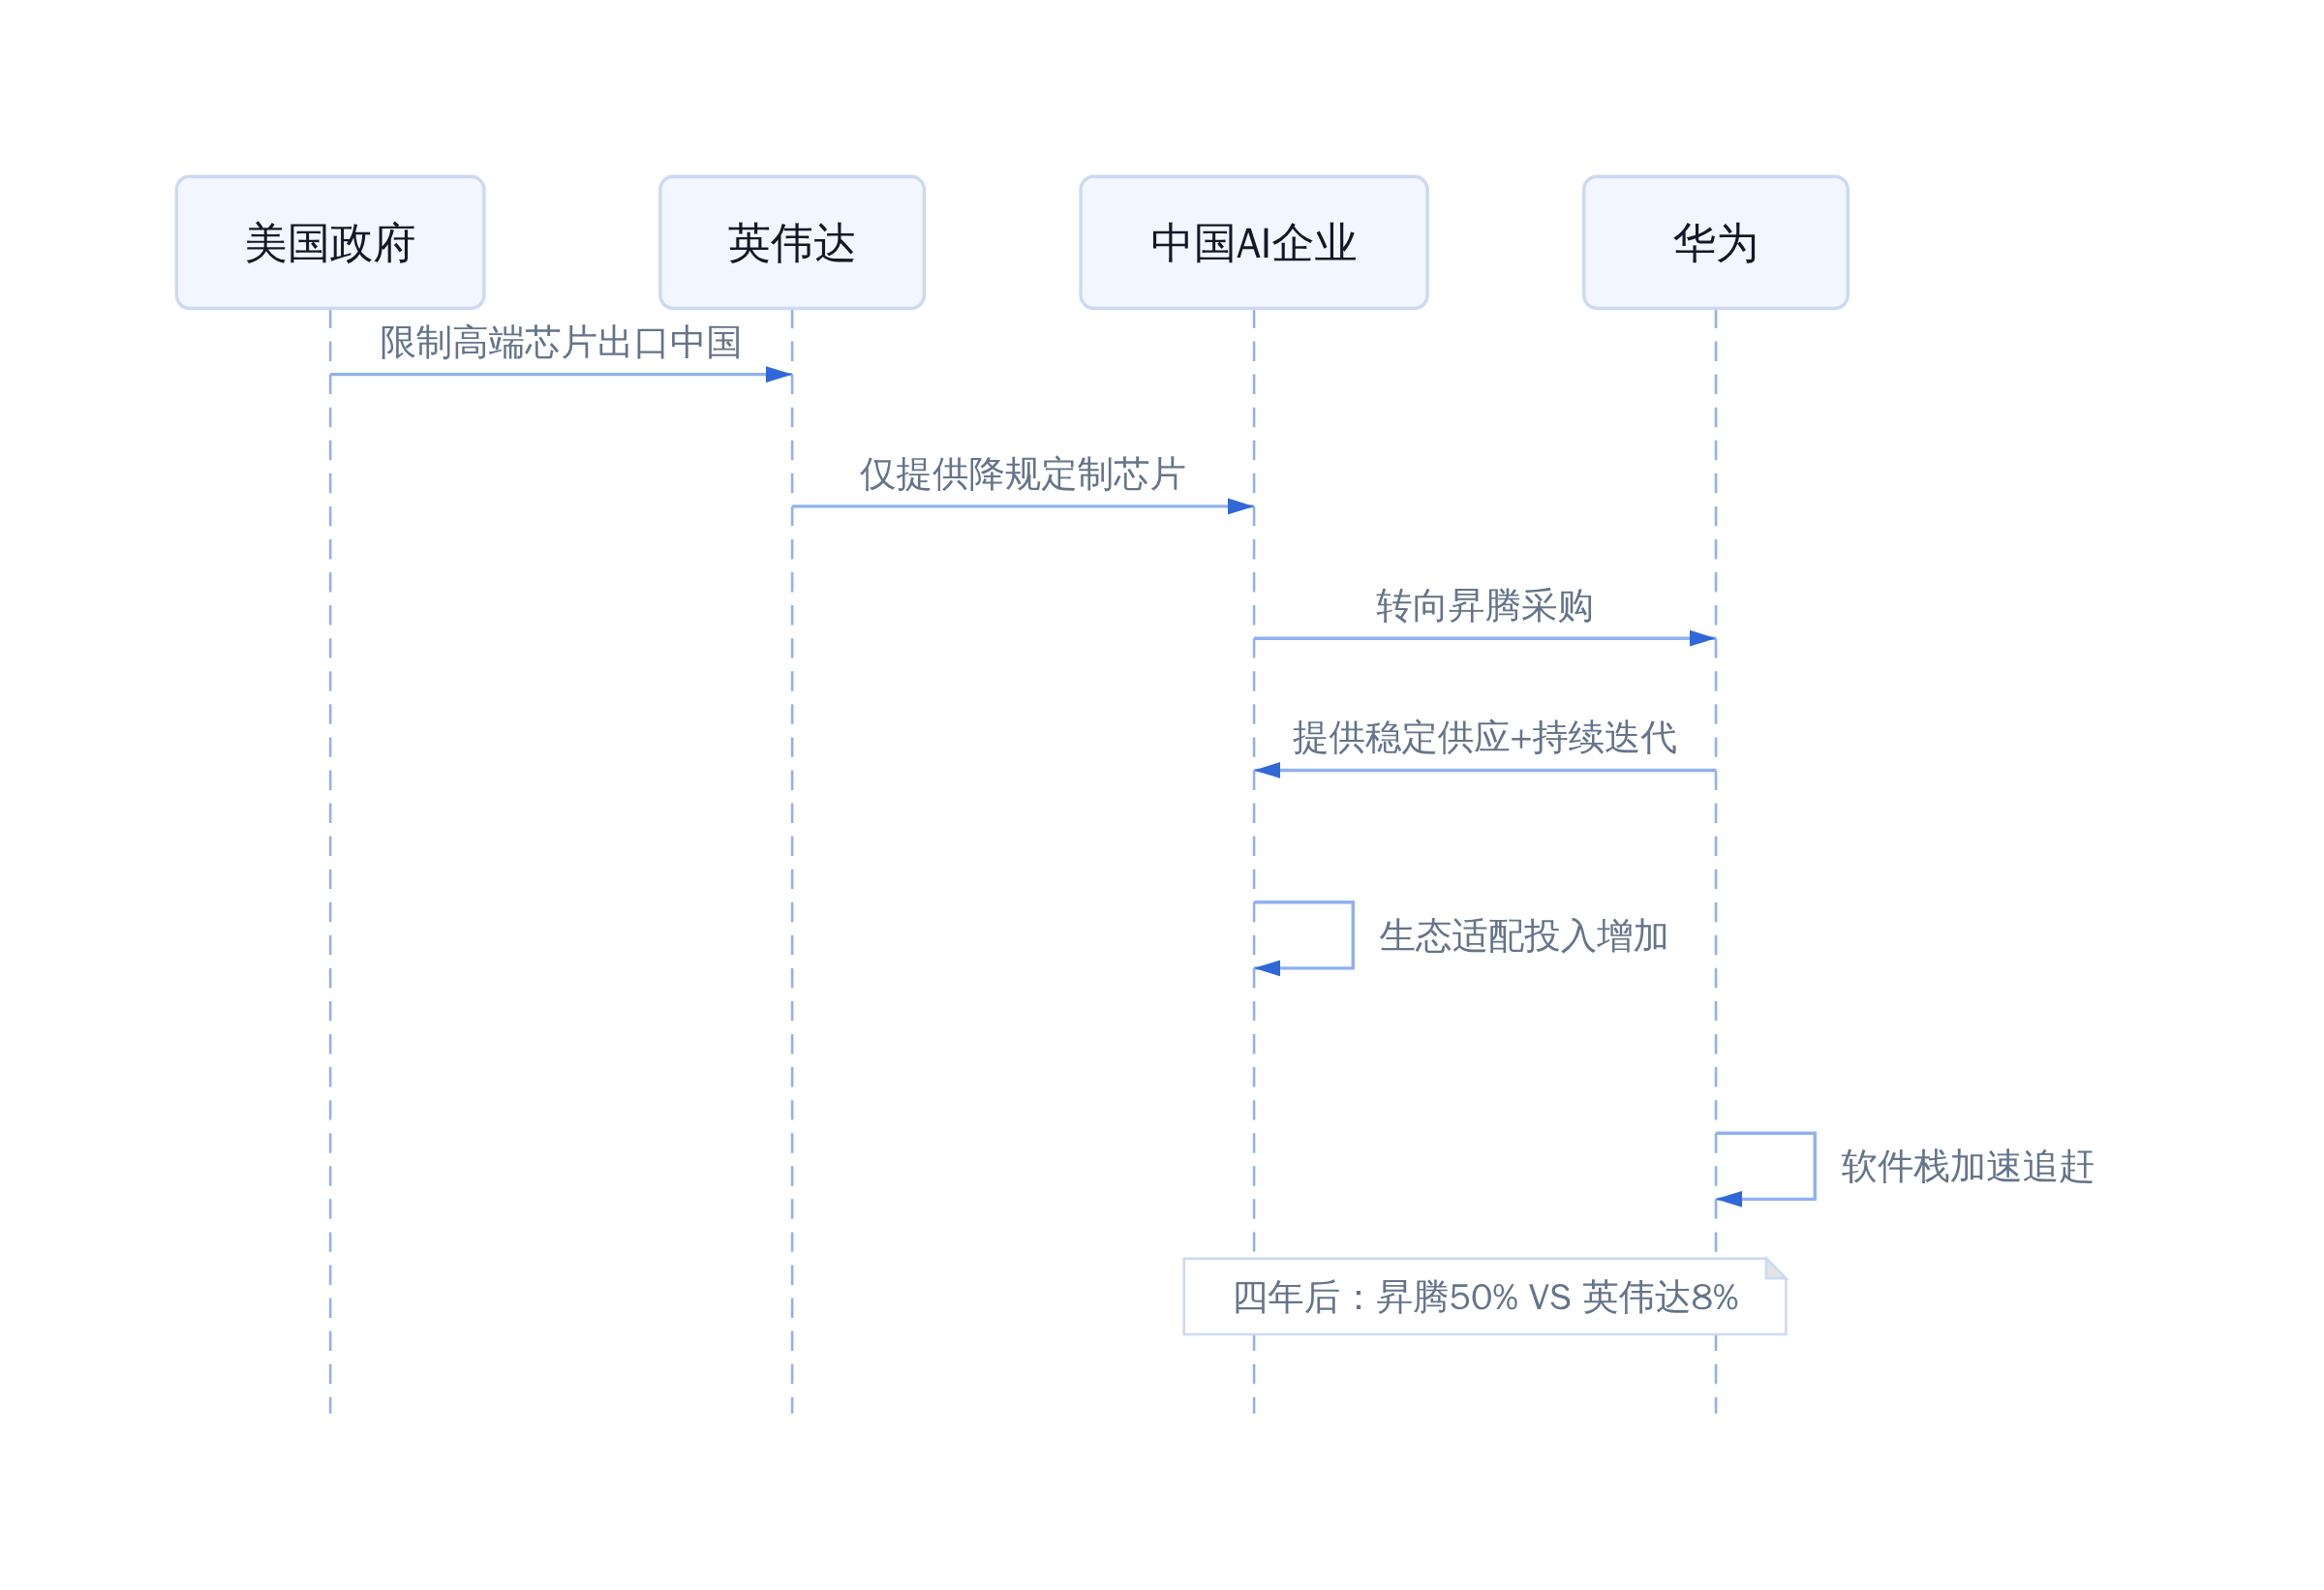
2022年11月,美国商务部将英伟达A800、H800纳入出口管制,原本能卖的芯片突然需要许可审批。2023年10月新一轮规则收紧,连阉割版H20也无法进入中国市场。
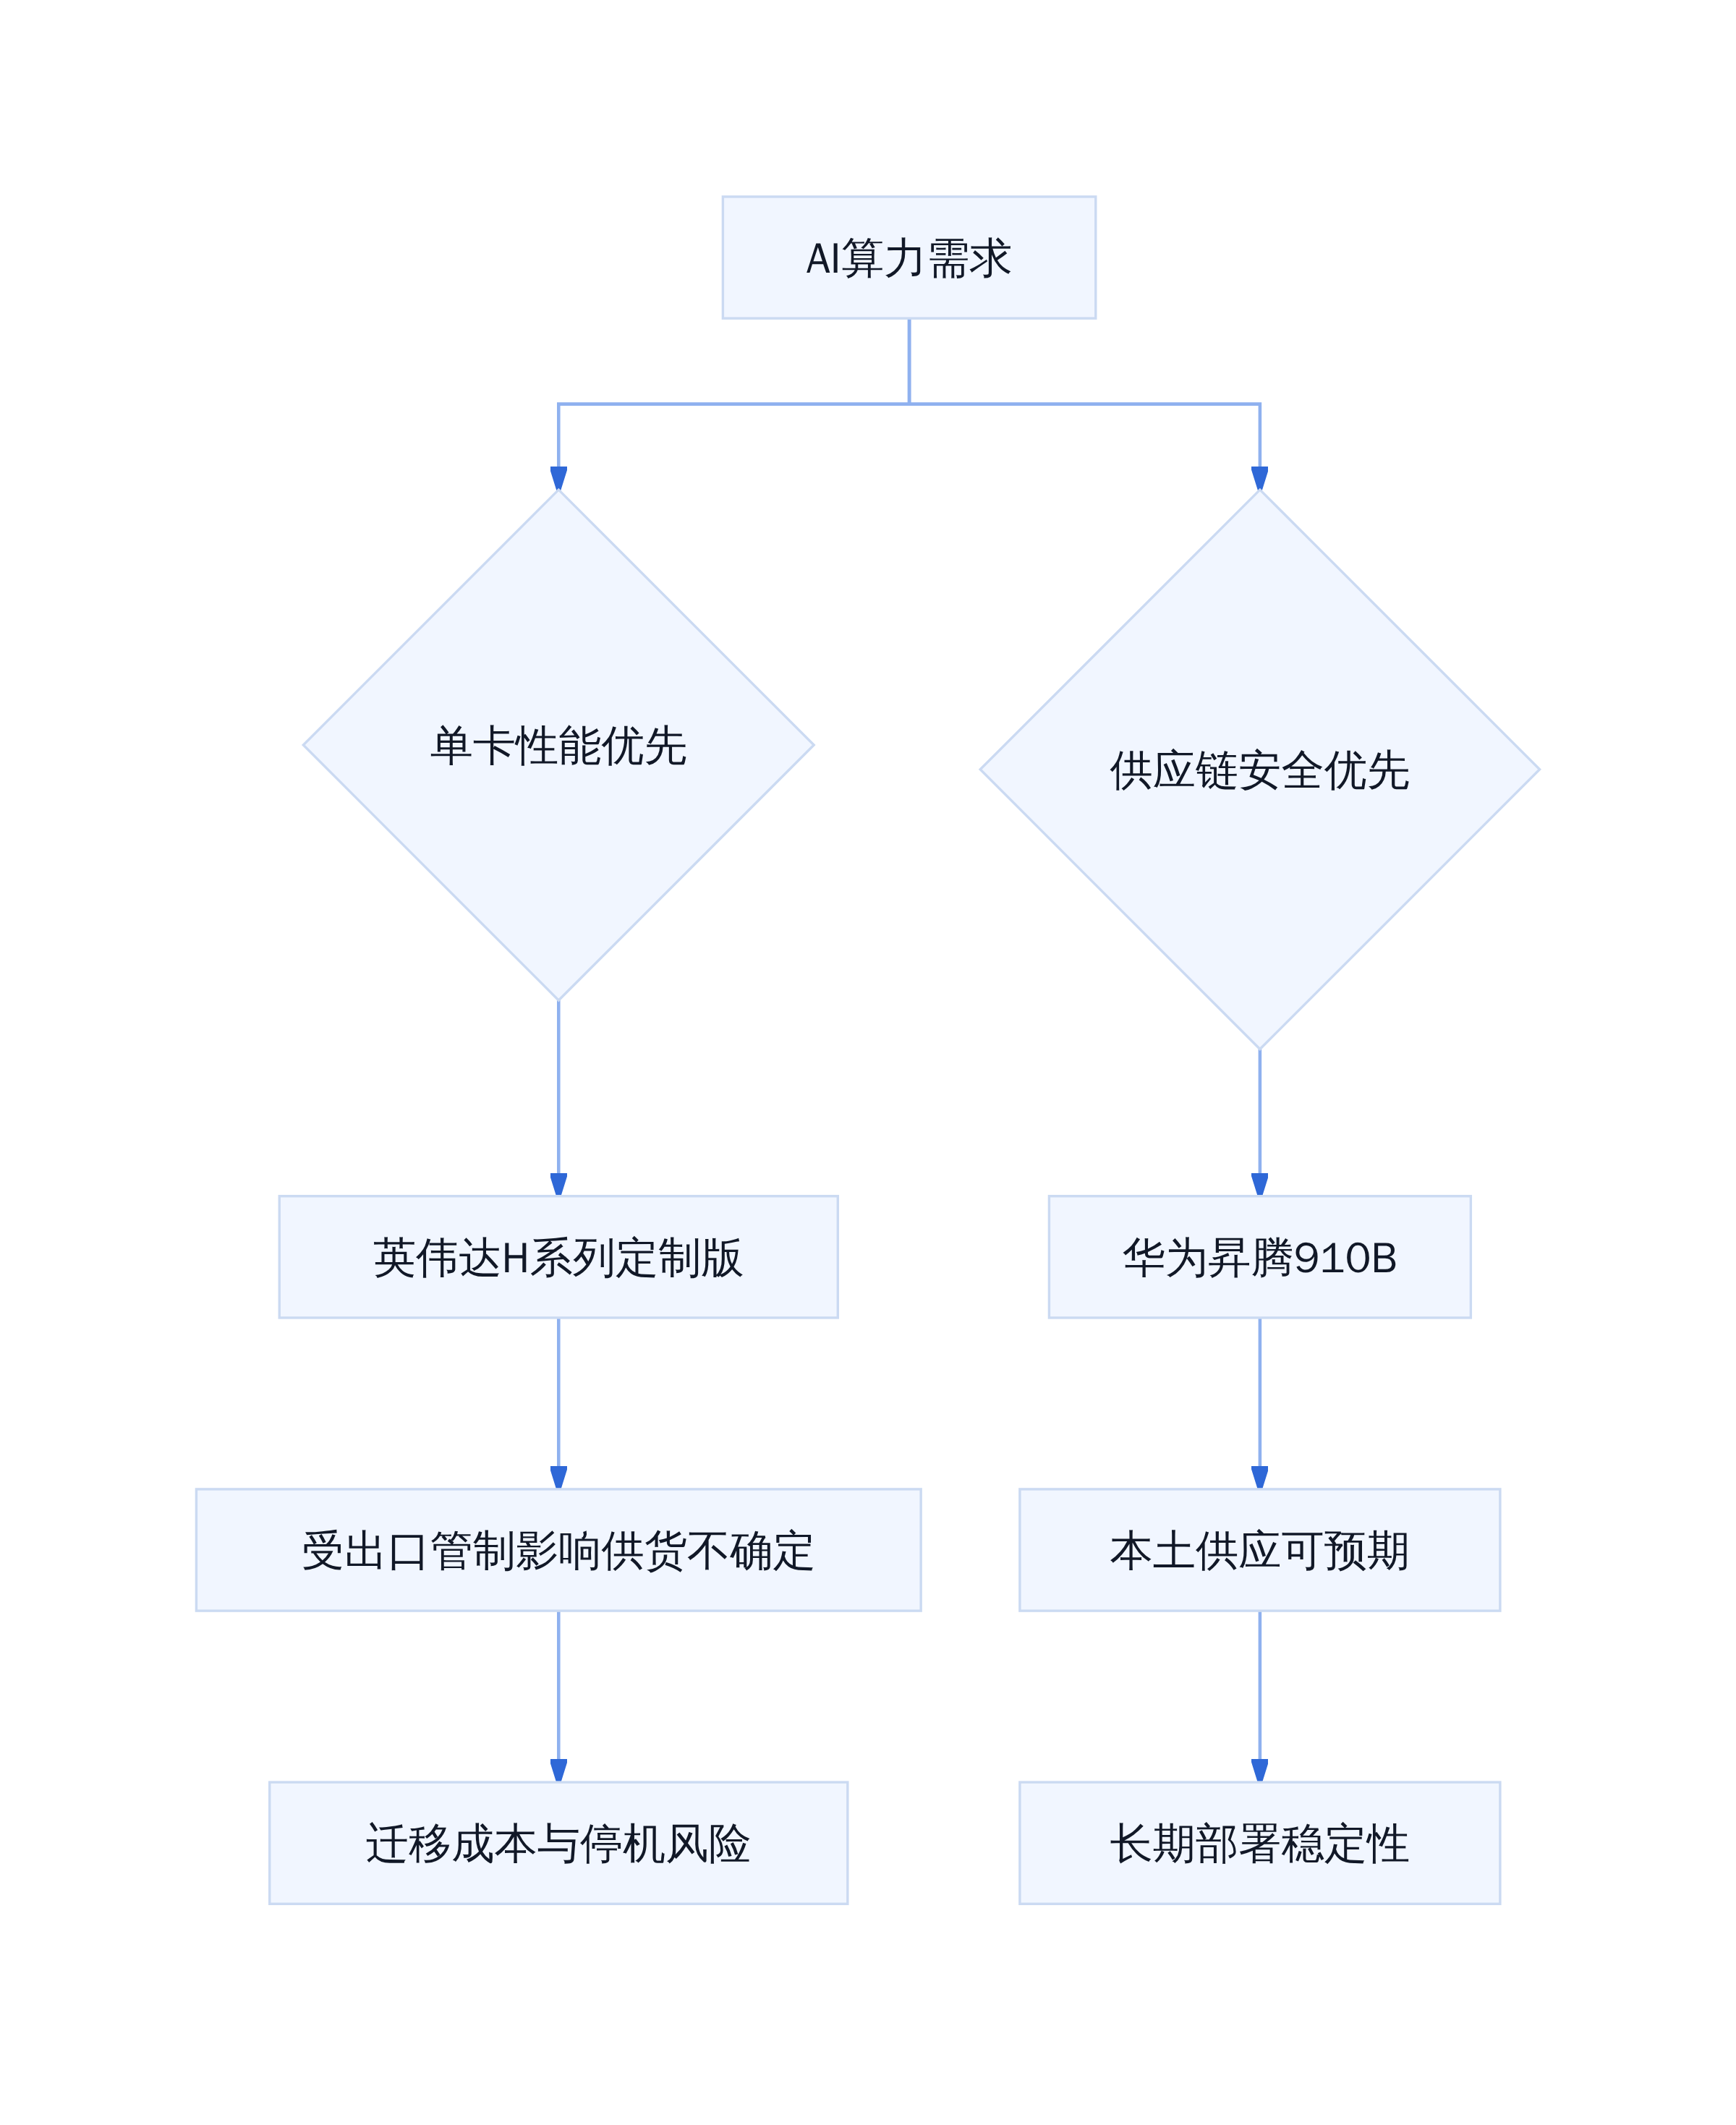
采购决策的逻辑因此发生断裂。英伟达的供货承诺不再可靠——今天能给H800,明天政策一变就拿不到了。昇腾910B的性能短板依然存在,但它有一个英伟达无法提供的优势:供应链安全。
「即使芯片不那么先进,至少供应有保障,不必日复一日担心断供。」这是当时部分企业CIO的真实想法。对AI基础设施而言,稳定供应本身就是一种核心能力。
2025年:英伟达跌至55%,升腾首次突破30%
到了2025年,市场数据开始显现结构性变化。IDC统计显示,中国云端AI加速器市场全年交付约400万片,其中国产厂商交付165万片,份额跃升至41%,英伟达降至55%。华为昇腾以约81万片的出货量领跑国产阵营,占国产总出货量的近半壁江山。
这一阶段的竞争逻辑发生了微妙转换。英伟达在中国只能提供经过严格降规的定制芯片,带宽、显存、互联带宽全部受限。昇腾910B通过大规模集群互联补齐了单卡算力不足——配合自研软件栈,在千卡集群上的模型训练效率已达到可用水平。
国产算力集群的工程实现
AI算力需求
黄仁勋在2025年公开场合承认,美国对华芯片限制政策产生了适得其反的效果。「华为与DeepSeek正在引领中国AI芯片的自力更生」,他在接受采访时的表述印证了市场转向的客观趋势。
2026年7月:升腾50%对英伟达8%,差距拉至六倍
时间来到2026年7月。根据多方数据交叉验证,英伟达在中国AI加速器市场的份额已降至8%,昇腾则达到50%,比例差距扩展至六倍。这不是小幅波动,而是市场结构的根本性翻转。
TrendForce报告复盘了近三年的变迁轨迹:2024年国产AI芯片整体占比约30%,2025年跃升至41%,2026年上半年高端AI芯片出货量同比增长83%。其中昇腾的增长速度远超行业均值。
关键驱动因素之一是昇腾910C的推进。据WSJ报道,华为已向客户披露昇腾910C在性能上可对标英伟达H100,虽然量产进度面临一定挑战,但信号意义明确:华为的迭代节奏正在追平国际主流水平。
徐直军全连接大会确认:'我们确实已超过'
2026年9月17日,华为全连接大会。徐直军正面回应市场份额变化:「根据华为收集的数据,昇腾在中国市场的份额确实已超越英伟达。」他同时强调,推动芯片与半导体价值链的全面自给自足是必然的前进道路。
海思首席科学家廖恒博士补充了一个关键信息:两年前昇腾最大障碍在于PyTorch与CUDA形成的软件壁垒,但近18个月来,这一差距已显著缩小。软件生态的追赶速度,往往比硬件迭代更决定长期竞争力。
华为发布的Peerium计算架构与UnifiedBus(灵衢总线)技术,支持多达一百万个处理器实现对等互连。这打破了传统主从架构范式,在大模型训练的模型浮点运算利用率(MFU)上带来了实质性提升。

美国封锁的因果链:越想卡死,越帮对手站稳
正文图解 2
数据不会骗人,但数据也需要放在正确的框架里理解。昇腾份额超过英伟达,不等于昇腾技术全面领先——在全球市场英伟达仍占据80%以上份额。这一结论的适用边界是中国AI加速器市场,且以出货量为口径统计。
真正的判断在于:当一条供应链的安全性与另一条供应链的性能优势发生冲突时,市场选择了前者。对美国而言,这是战略意图与实际结果的背离;对中国AI产业而言,这是一次被迫完成的供应链重构,代价不小,但结果是确定的。
美国为什么越禁越失控?
四年前的H800并非完整版的H100。美国商务部2023年出台首轮限制后,英伟达紧急推出这款「中国特供」,算力密度砍掉一半,互联带宽缩水,但依然保留了CUDA生态的全部兼容性。当时的选择逻辑很简单:升腾的CANN软件栈还在爬坡,PyTorch适配不稳定,集群调度经验为零。英伟达虽然性能打折,但工程师不用重写代码,项目按时上线的风险更低。
这一轮选择,代价是后来被反复验证的。
2024年,美国第二轮限制落地,英伟达被迫再出一刀——H20。这次阉割更狠,FP8算力直接砍到原版H100的十分之一,互联带宽降为800GB/s,但价格反而更高。业内流传一个段子:客户花H100三倍的钱,买回来一个训练效率只有H100三分之一的卡。
英伟达芯片:每次更新都是给客户发问号
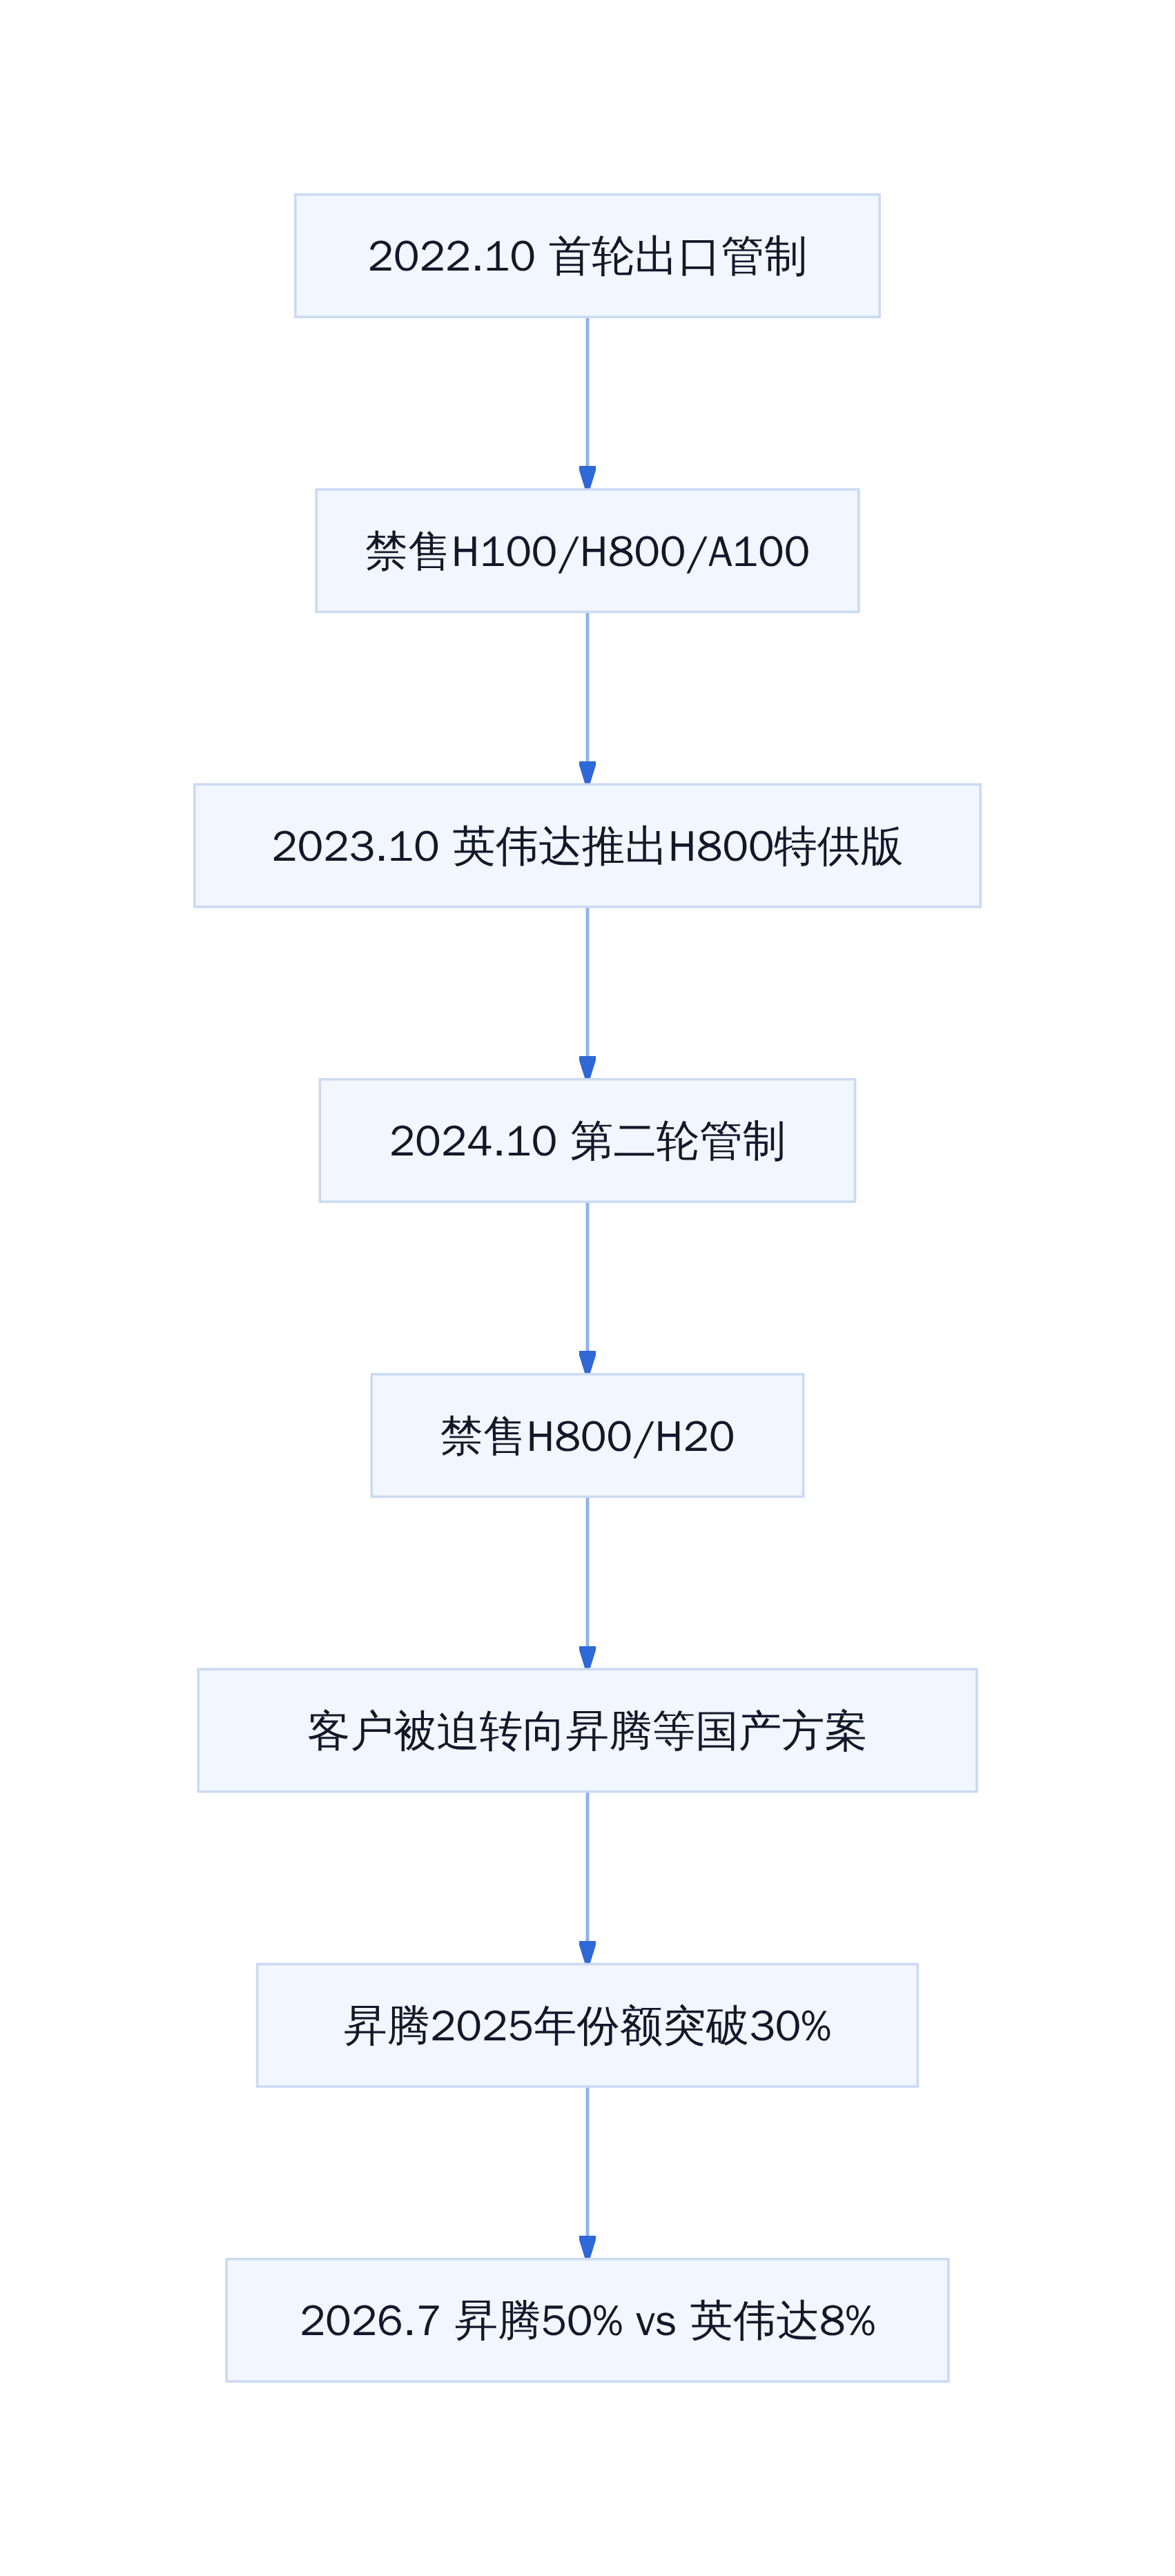
2022.10 首轮出口管制
政策制定者的算盘原本很清楚:只要中国拿不到顶级芯片,AI竞赛就赢不了。他们假设了一个关键前提——芯片性能差距无法被其他手段弥补。但这个假设在工程世界里站不住脚。
算力是一个系统问题,不是一个单点问题。当单卡性能不足时,可以通过集群规模来补偿。华为在2026年全连接大会上发布的Peerium计算架构和UnifiedBus(灵衢总线),目标就是把百万级处理器拉到同一个对等计算网络上。这不是修修补补,是从架构层面重新定义「算力」:不再依赖单卡峰值,而是看集群级别的MFU(模型浮点利用率)。
从H800到H20:一轮轮阉割没拦住中国需求
H800和H20的命运,揭示了美国出口管制策略的一个结构性矛盾:每一次限制都在缩小英伟达在中国的可选范围,同时扩大了国产芯片的生存空间。
H800时期,客户还能用CUDA生态的惯性来合理化采购。代码不改动,运维团队不换人,风险可控。到了H20,这个逻辑就开始裂了。训练一个万参数模型,H20需要比H100多花三倍的时间和电费,但交付时间还未必有保证。对于头部云服务商来说,这笔账不是算不清,而是被迫算清之后才发现:国产方案的综合成本正在逼近甚至超越英伟达特供版。
问题的核心在于,美国管制政策制造了一个虚假的市场信号。管制让英伟达的供给变得不可预测——今天能买H20,明天可能也被禁。企业采购决策从「性能最优」变成了「供应确定」。昇腾910B虽然没有H20的性能,但有一个H20永远给不了的东西:稳定出货。
连H20也禁了之后,客户只能看向昇腾
2024年底到2025年初,H20也被列入了禁售清单。这意味着英伟达在中国市场彻底没有合规产品了。不是不想卖,是不让卖。
这个节点对中国AI芯片厂商来说,是一个真正的分水岭。之前还有「国产替代」这个说法的争议空间——性能不够、生态不行、风险太高。现在没有争议了,昇腾是唯一剩下的选择。
但这并不意味着昇腾的胜利是轻松的。客户采购昇腾,需要付出几个真实成本:一是代码迁移,PyTorch的昇腾适配从2023年的「能用」到2025年的「基本好用」,中间经历了至少两代框架迭代;二是运维重构,集群调度、故障恢复、性能调优都要从头学起;三是人才储备,原来招聘GPU工程师,现在要招昇腾工程师,市场上这个人才池子还很浅。

客户:别问,问就是升腾
徐直军在全连接大会上的回应很直接:即使芯片不那么先进,至少供应有保障,不必日复一日担心断供。这句话不是谦辞,是工程现实。对于一家正在赶产品进度的AI公司来说,「芯片随时可能被禁」这个不确定性,比「芯片慢一点」这个性能差距更难承受。
黄仁勋承认:政策适得其反
2026年初,黄仁勋在接受美国战略与国际研究中心(CSIS)采访时,用了一个不常见的措辞:美国对华芯片限制「适得其反」。
这句话的分量比很多人想象的要重。作为英伟达CEO,黄仁勋的商业利益和美国政府的技术管制政策之间,一直存在张力。他在中国市场的收入占比很高,每一轮限制都直接冲击营收。但他没有选择在公开场合抨击政策——他只是陈述了一个事实:限制没有阻止中国AI发展,反而加速了中国自研芯片的崛起。
韩国媒体The Chosun Daily的报道提供了一个具体的例子:DeepSeek R1在华为昇腾950PR上优化后,推理成本比在英伟达H100上低了约40%。这不是一个简单的性能对比,而是技术路线的分叉——当英伟达还在依赖单一芯片的算力密度时,中国厂商已经在用软件优化+异构集群的方式绕开了硬件限制。
芯片性能的追赶速度,远远快于管制政策收紧的速度。英伟达H100到H20,性能差距从两代缩短到了半代。但升腾910B到910C,性能也在翻倍。当国产芯片每年提升50%–100%的算力,而管制只是不断向下移动禁区时,这个追赶就变成了一场不对称赛跑。
伯恩斯坦的预测或许是最冷静的注脚:英伟达在中国AI加速器市场的份额,预计将从2024年的66%降至2026年的8%左右。这不是因为中国客户更喜欢昇腾,而是因为美国政策替中国客户做了选择。
即使芯片不那么先进,至少供应有保障,不必日复一日担心断供。——徐直军
这句话的后半句才是真正的结论:美国想卡死中国AI,结果中国AI踩着禁运令站了起来。
升腾凭什么能翻盘?
算力翻倍路线图:一年一代的节奏有多猛
昇腾的核心节奏可以用四个词概括:一年一代、算力翻倍。徐直军在2025年全联接大会上明确提出了这一路线图,并在2026年得到了验证。
从910B到910C,再到面向推理的910PR,华为的迭代速度明显快于行业常规周期。这种节奏的背后是产品策略的转变:不再追求单芯片性能绝对领先,而是通过快速迭代和架构创新来弥补短板。910B对标A100,910C对标H100——这个对标关系虽然不能完全等同于实际性能,但已经表明华为在追赶路径上的明确目标。
一年一代的节奏在芯片行业极为罕见。传统芯片厂商的新品周期通常在2-3年,华为之所以能做到一年迭代,靠的不是单点突破,而是整个供应链的协同作战——从设计、流片到封装测试,每一个环节都在压缩时间。
Peerium架构与灵衢总线:百万级互连的真正价值
2026年全联接大会上,华为发布了Peerium计算架构与UnifiedBus(灵衢总线)技术。这两项技术的核心价值不是单芯片性能,而是多芯片协作效率。
传统超算架构是主从式:一个中心节点调度其他节点。Peerium的对等互连设计打破了这个范式,最多支持一百万个处理器节点之间直接通信。这意味着大规模集群的扩展不再受限于中央调度瓶颈。
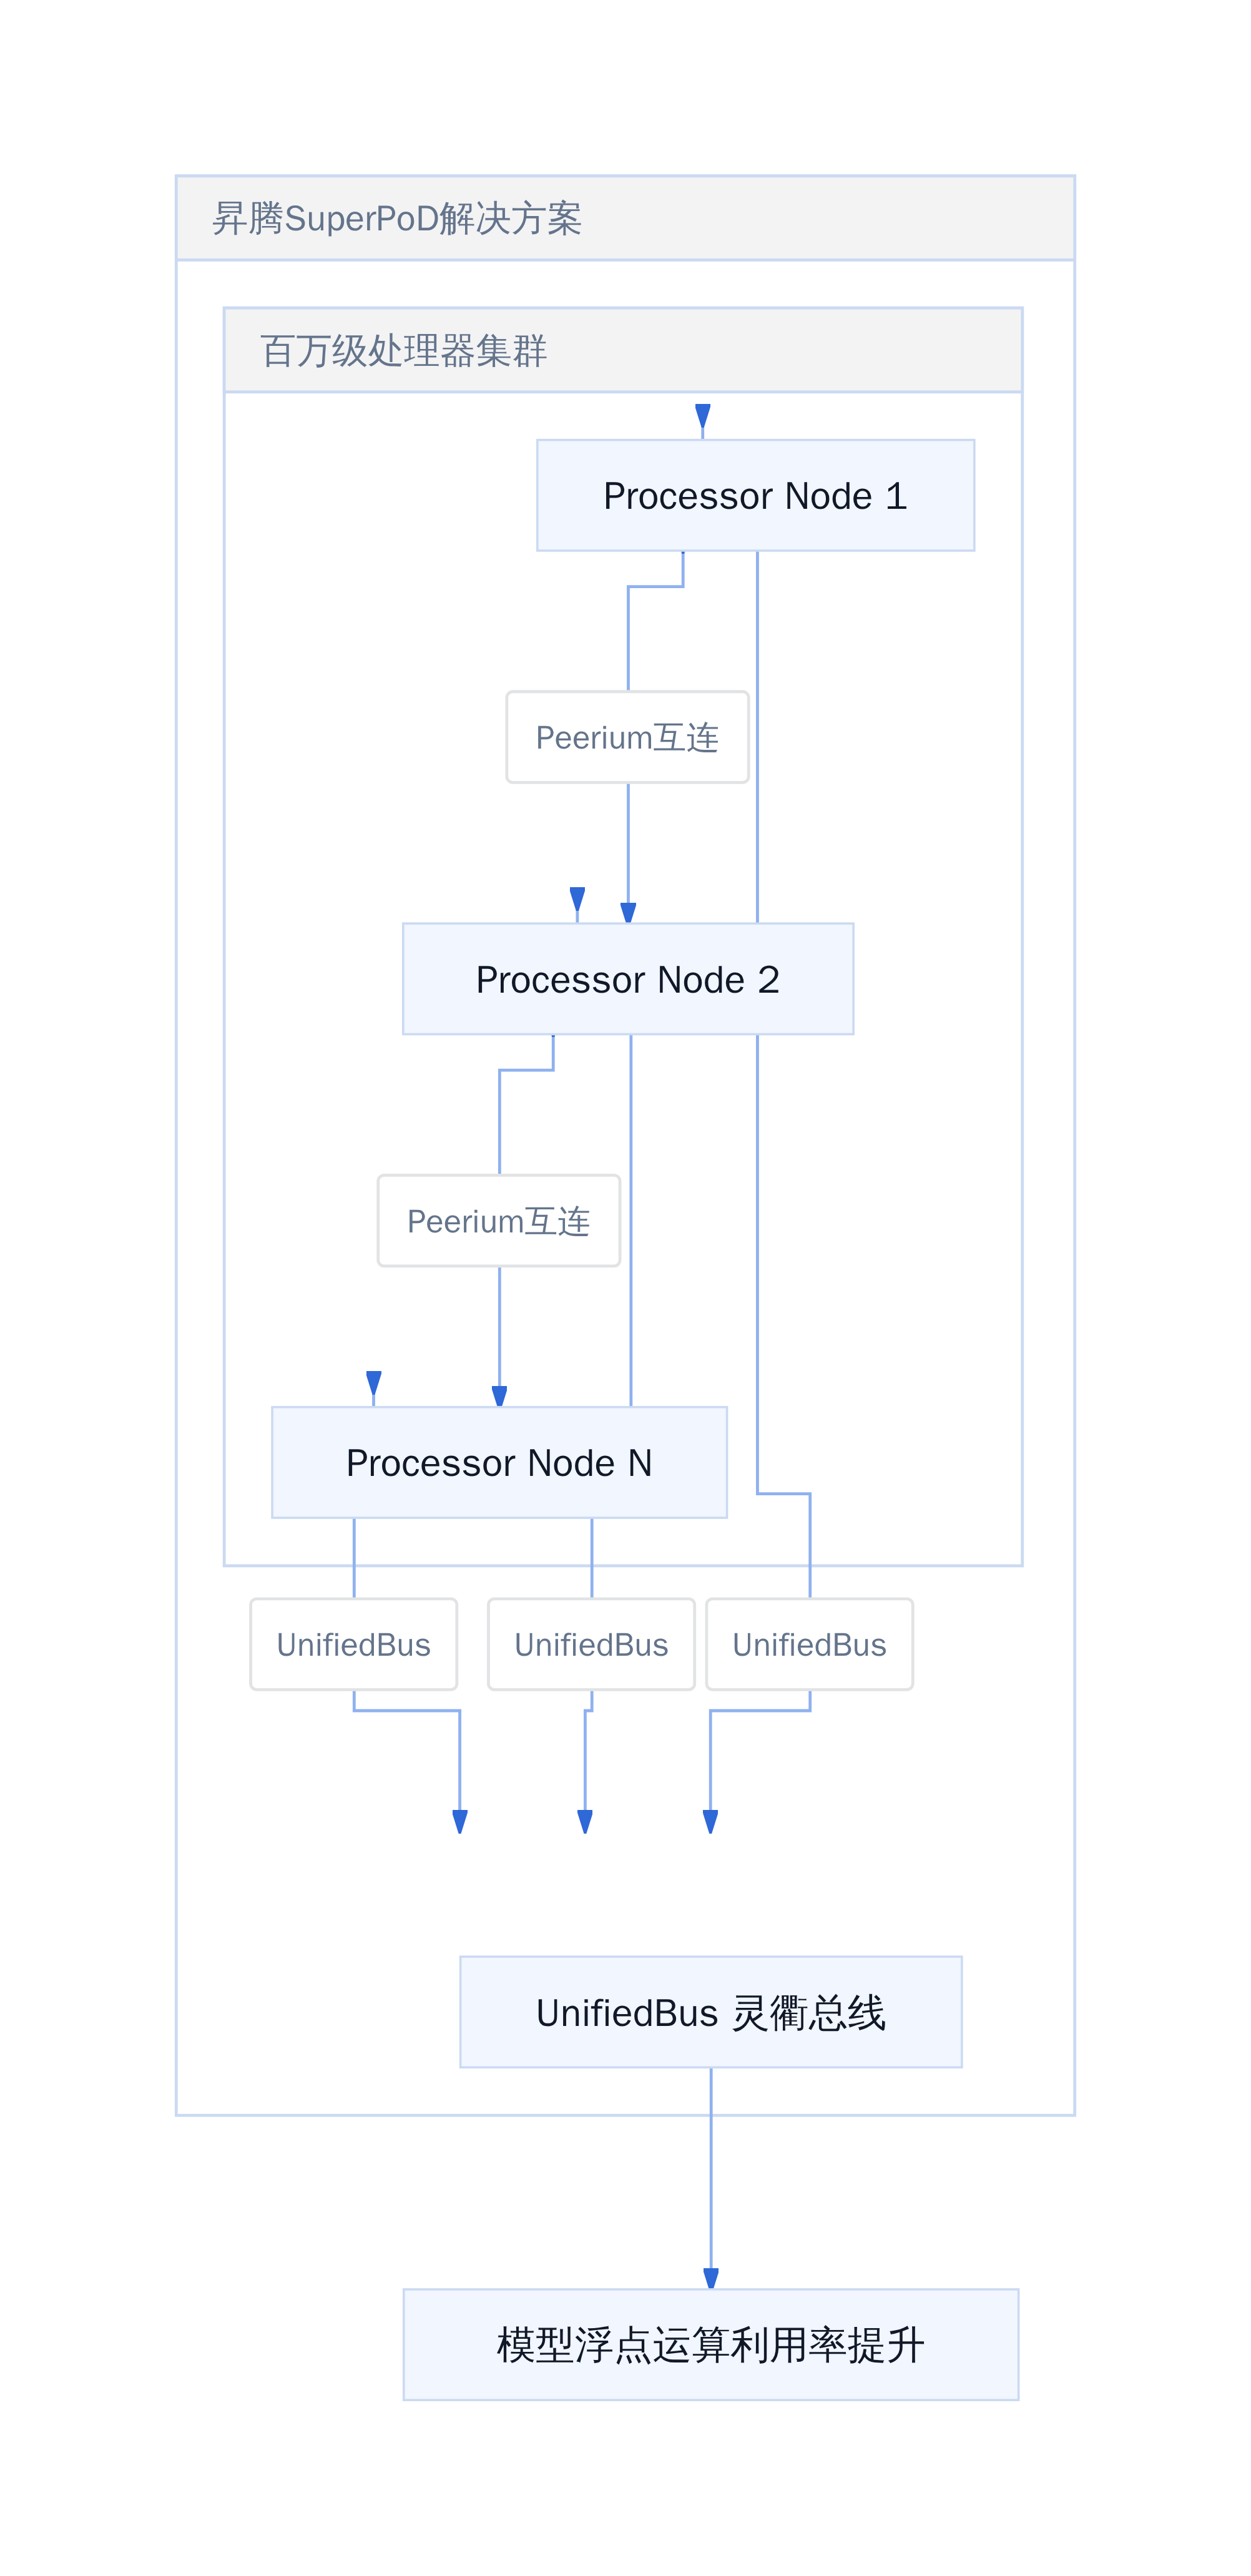
昇腾SuperPoD解决方案
这一架构的直接收益是MFU(Model FLOPs Utilization)的提升。对于大模型训练而言,MFU决定了实际算力利用率——如果互连带宽不足,再强的单卡性能也会被通信等待时间稀释。Peerium+UnifiedBus的组合,本质上是在解决大规模训练中的通信效率问题,这也是英伟达NVLink体系的竞争对手。
软件生态:PyTorch/CUDA壁垒如何被填平
软件生态曾经是昇腾最大的短板。海思首席科学家廖恒博士在大会上明确指出:两年前昇腾的最大障碍就是PyTorch与CUDA形成的软件壁垒。但近18个月来,模型数学与软件栈的追赶速度超预期。
这里的关键词是「近18个月」。CUDA生态的建设花了十几年,昇腾要在三年内填平这一差距,靠的不是模仿,而是策略性绕行。CANN(Compute Architecture for Neural Networks)作为昇腾的底层软件栈,已经实现了对PyTorch、TensorFlow等主流框架的原生支持。对于大多数开发者而言,代码迁移的成本正在快速降低。
廖恒的判断是「软件与CUDA的差距显著缩小」——这个表述是克制的,没有说「完全追上」,但方向是明确的。对于一个依赖生态粘性的市场来说,缩小差距和完全追上之间,只差一个临界点的到达时间。
拐点之后的长路
单芯片制程瓶颈依然存在
市场份额翻盘,不代表问题都解决了。徐直军在全连接大会上说的很直白:「即使芯片不那么先进,至少供应有保障。」这句话的潜台词是,华为昇腾在单芯片性能上,还没有完全追平英伟达的最顶尖产品。
先进制程节点被卡住,是一个结构性约束。台积电无法为华为代工5纳米以下的芯片,这是目前昇腾910C、910D这类产品能做到的极限。相比之下,英伟达的Blackwell架构用的是台积电最成熟的CoWoS封装,算力密度和互联带宽仍在持续迭代。
但华为的应对策略很清楚:单点打不过,就用集群补。SuperPoD架构引入Peerium计算架构和UnifiedBus(灵衢总线),号称支持一百万个处理器对等互连。这套设计绕开了传统主从式架构的瓶颈,把大量中等性能的芯片拼成一个超大规模计算体。
这个思路本质上是对「摩尔定律失效」的一种工程回应——当单芯片性能提升遇到物理天花板时,靠规模和互联效率来填补缺口。
国产三强格局:昇腾、平头哥、昆仑芯的分野
昇腾不是中国唯一在做AI芯片的团队。阿里平头哥推出了含光系列和最新的Yitian 920,百度昆仑芯也已经迭代到多代,两者的出货路径和昇腾有所不同。
从定位来看,三家有明显分野。昇腾走的是通用型全栈路线,从芯片到CANN软件栈到MindSpore框架,再到ModelArts云平台,覆盖训练和推理全场景。平头哥的含光主要面向推理侧,更偏向阿里云内部的模型部署需求,同时也对外提供云服务。昆仑芯则更聚焦具体业务场景,百度的搜索和推荐算法是其主要落地场景。
出货数据上,昇腾以约81万张的年出货量遥遥领先,占国产总出货量的近一半。平头哥和昆仑芯各有侧重,但整体规模与昇腾不在同一量级。这意味着昇腾不仅在国内市场与英伟达正面竞争,同时也是国产替代的主力军。
国产芯片厂商之间并非零和关系。更大的蛋糕意味着更多供应商有生存空间,生态的丰富性反而对整体竞争力有利。关键问题在于,这些芯片能否真正跑通大模型训练链路,还是只停留在推理端的局部优化。
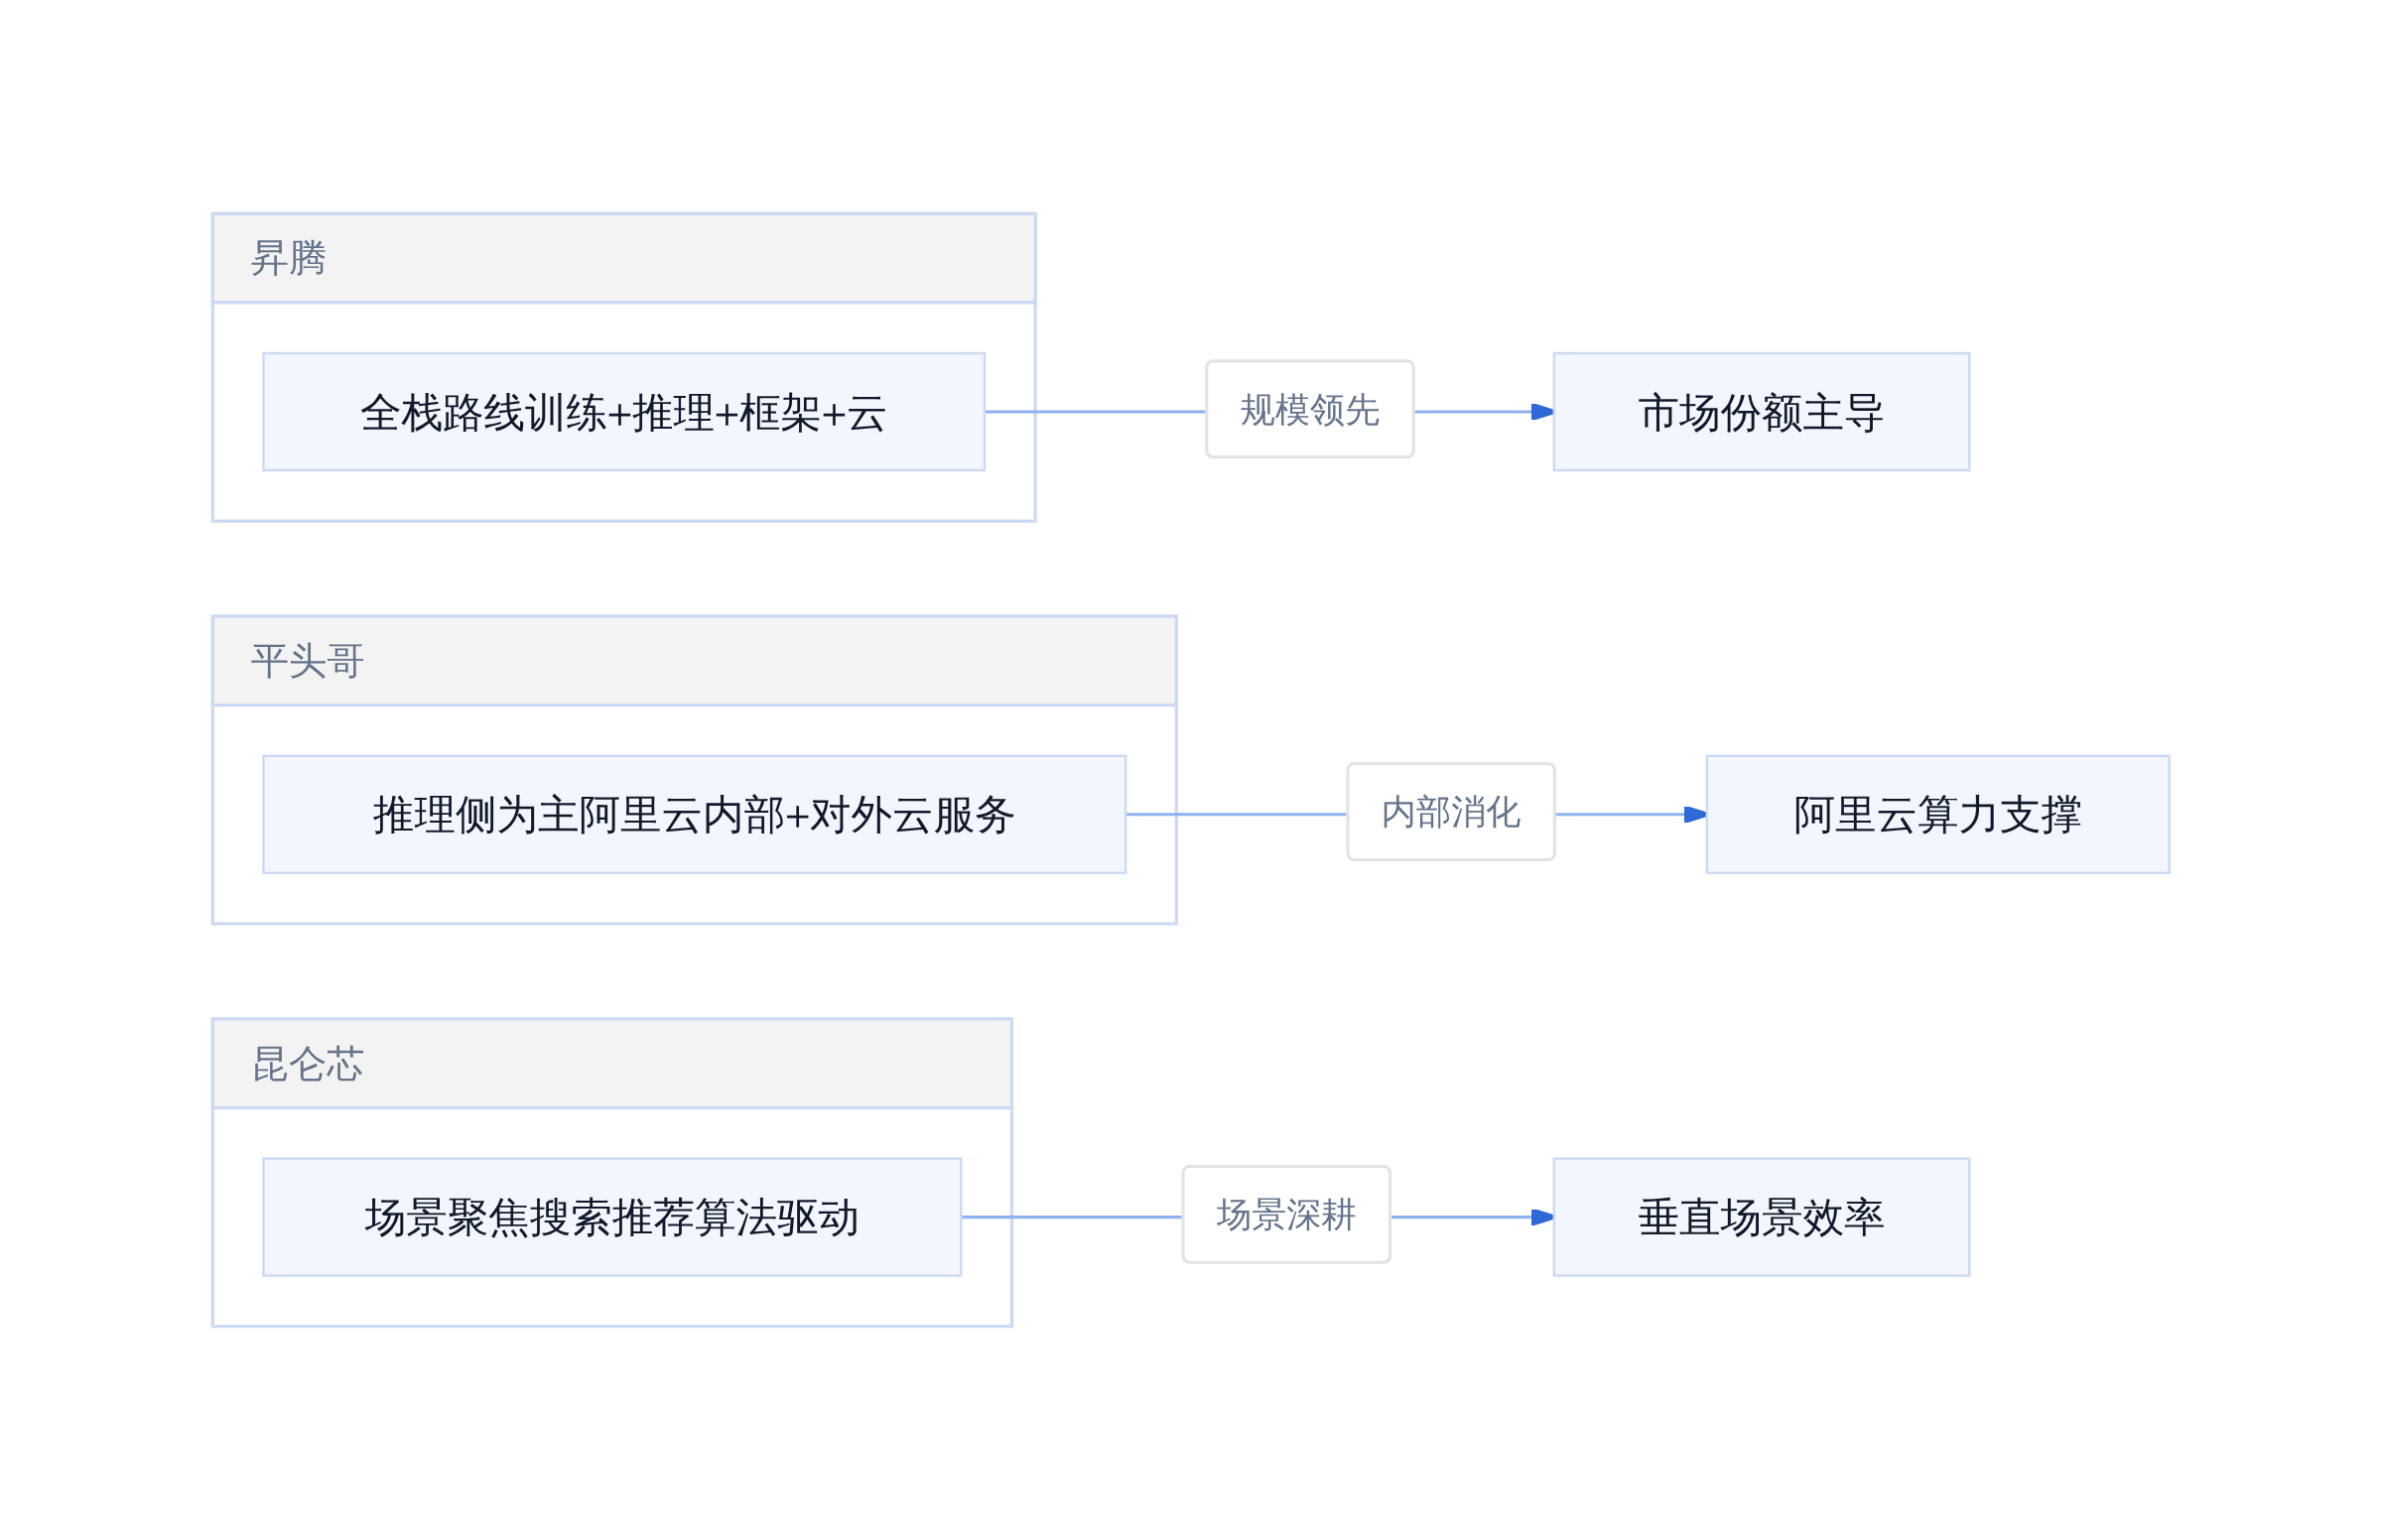 训练+推理+框架+云">
全栈路线
训练+推理+框架+云
自给自足的战略意义:宁可慢,不能断
徐直军说的「不必日复一日担心芯片断供」,是这场市场翻转背后最核心的逻辑。美国从H800、A800一路阉割到H20,最后连H20也禁了,这一轮轮操作并没有让中国AI停下来,反而逼出了一个不受外部管控的完整供应链。
这个逻辑和当年「两弹一星」的决策高度相似——关键核心技术是要不来、买不来、讨不来的。昇腾50%的市场份额背后,是一条从设计、EDA工具、制造到封装测试逐步本土化的产业链正在成型。
黄仁勋承认政策适得其反,这句话值得拆解。禁运确实延缓了部分时间进度,但也消除了企业选择上的犹豫——当英伟达随时可能断供时,转用昇腾就不再是一个「备用方案」,而是一个「必选项」。
从商业决策的角度看,这种确定性本身就有价值。一家公司可以选择性能更强的芯片,但前提是稳定供货;一个团队也可以选择迁移成本更低的技术栈,前提是供应链不会突然中断。美国禁运实际上帮中国AI企业做了一个最难的决策:不用选了。
更狠的是,这条路的边际成本正在下降。每年研发投入叠加出货量增长,华为在先进封装、Chiplet、互联协议上的积累在加速摊薄。2026年昇腾的出货节奏已经跑到「一年一代、算力翻倍」的轨道上。
拐点只是起点。单芯片性能的追赶仍在继续,软件生态的差距也在缩小,但最大的确定性已经摆在眼前:中国AI的算力底座,不再系于一张来自加州的报关单。
参考文献
- 华为全连接大会2026,徐直军演讲实录,https://ijiwei.com/n/1115193
- IDC《2025年度中国云端AI加速器市场报告》,2026年4月发布
- WSJ报道《华为准备推出新芯片挑战英伟达,克服美国制裁》,2026年9月13日,https://cn.wsj.com/articles/华为准备推出新芯片挑战英伟达-克服美国制裁-7ac44cd7
- The Chosun Daily报道《华为与DeepSeek引领中国AI芯片自力更生》
- TrendForce市场数据统计
- 电子工程专辑报道《华为:昇腾AI芯片中国份额已超过英伟达》,https://www.eet-china.com/mp/a528770.html
- 网易报道《华为官方确认,昇腾AI芯片份额已超过英伟达了!》,https://www.163.com/dy/article/L88BARKM05119JRD.html
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师