新披露文件的核心指控
这份原告简报(Plaintiffs' Brief)是纽约南区联邦法院案件 1:23-Cv-08292 的最新文件之一。要点集中在两个维度:主观故意与损害结果。
简报表明,OpenAI 在构建 GPT 训练数据时,并非被动接收了互联网上公开可用的书籍数据,而是主动选择了来自 shadow library(影子图书馆)的书籍子集。其中被反复引用的来源包括 Library Genesis(LibGen)和 Sci-Hub——这两个平台本身即因大规模侵犯版权而受到多国司法机构的定性。
内部通信的「明知」证据
原告方从内部邮件、会议记录和产品路线图文档中提取了若干关键表述。核心逻辑链条如下:
- 早期工程团队在讨论数据采集策略时,明确知道哪些来源包含受版权保护的完整书籍;
- 「质量写作样本」(high-quality longform writing)被明确标注为训练数据的必要组成,而 shadow library 被认为是获取此类数据的最低成本路径;
- 多位高管在内部讨论中承认,GPT 类产品「可能替代部分人类作家的职业角色」。
坦白讲,这些表述的法律杀伤力不在于「说了什么」,而在于「没说什么」——即 OpenAI 从未在公开场合就数据来源的合法性作出过对等澄清。
从 shadow library 到训练集的路径
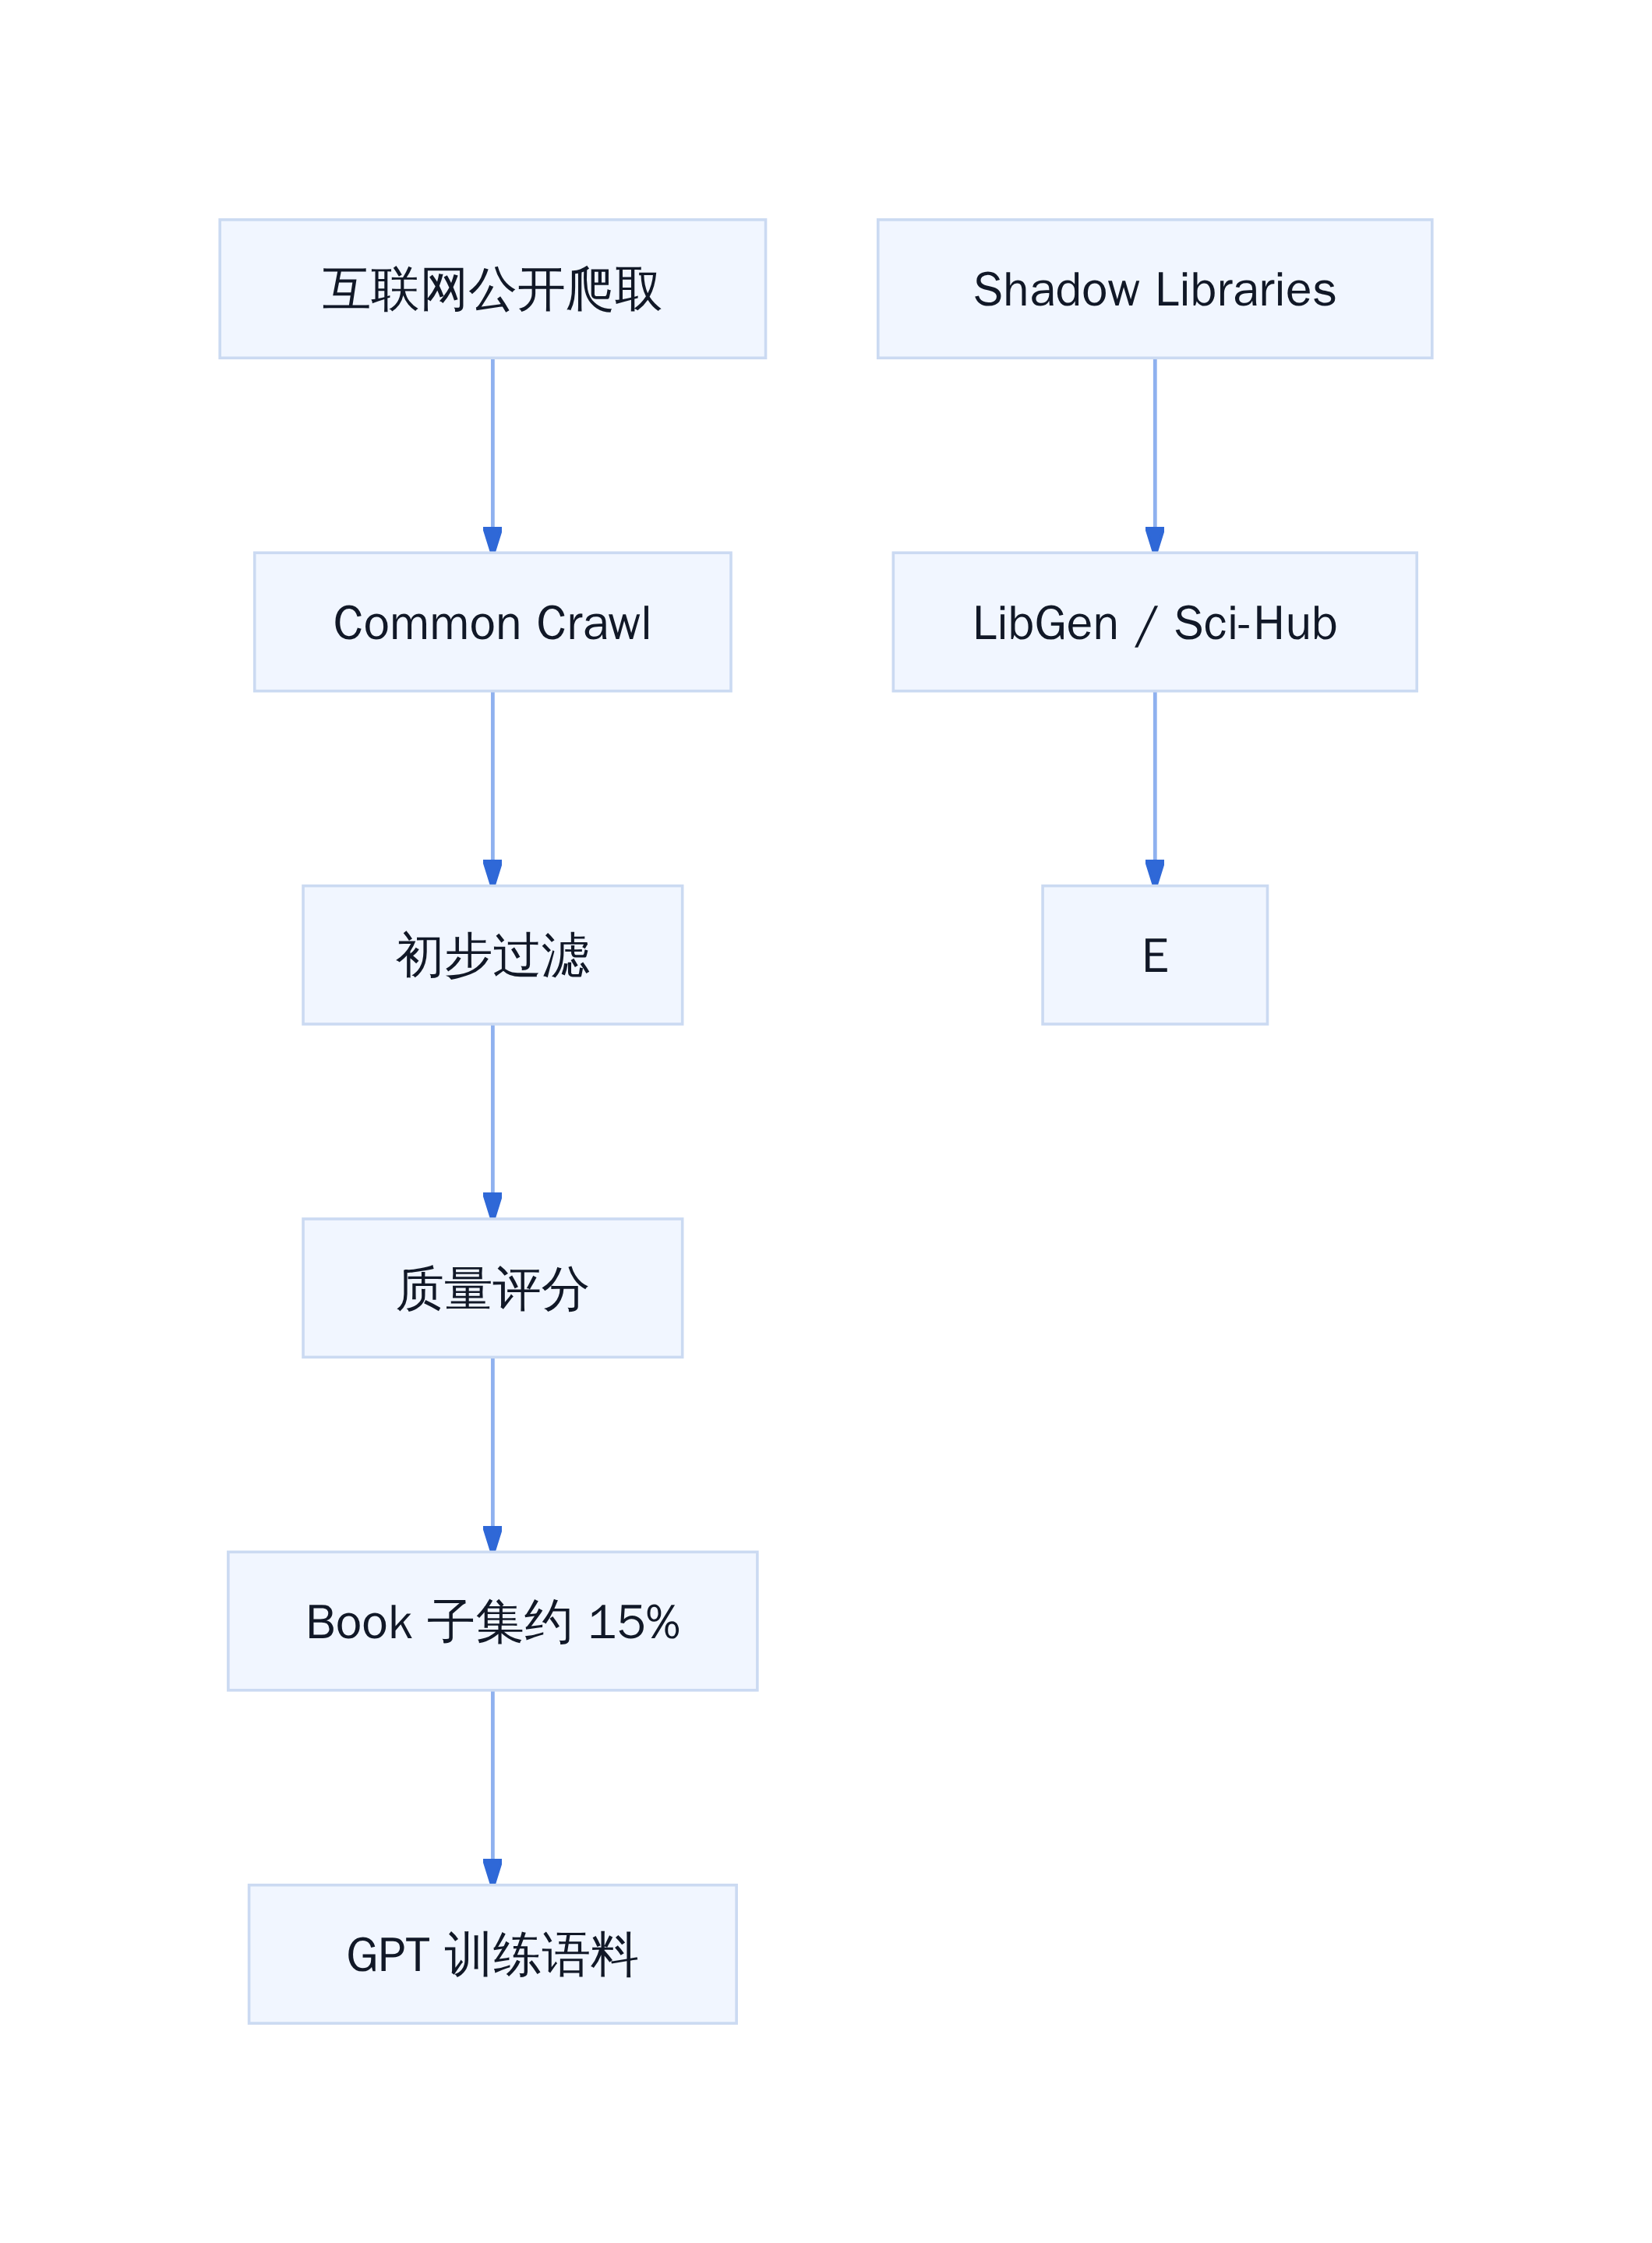
训练数据来源链路
这条链路的关键节点在「质量评分」环节。原告方主张,评分标准本身就隐含了对「受版权保护内容」的选择偏好——因为受版权保护的完整书籍,在语言质量和篇幅上天然优于网页碎片。
技术机制:模型到底吃了什么
要理解这场诉讼的技术底座,需要先搞清楚 GPT 训练数据的真实构成。
Common Crawl 中的 Book 子集
OpenAI 在 2020 年发表的 GPT-3 论文中提到,其训练数据中约 15% 来自「两个基于互联网的书籍语料库」(internet-based books corpora)。这 15% 是个不小的比例——对于一个以万亿Token计的训练集,这意味着数亿册书籍进入了模型的参数空间。
问题在于:这 15% 里有多少比例来源于未获得授权的版权作品?原告方提交的证据指向一个不利答案——大部分来源于 shadow library。
数据来源声明的可疑之处
OpenAI 的公开声明长期保持在「我们使用了互联网上的公开数据」这一层面。但内部文件显示,采集策略远比这句话复杂。例如,有记录表明团队对特定 publishers 的网站设置了差异化处理规则,同时对 shadow library 的内容采取了「先抓取、后审核」的方式——后者与「尊重版权」的公开立场形成直接矛盾。
当训练数据的灰色地带遇上开源社区的透明期待
法律攻防:fair use 能否扛住
这是本案最核心的法律问题,也是 AI 行业命运所系的一战。
转换性使用的边界
OpenAI 的核心抗辩是「转换性使用」(transformative use)——即模型训练是对原作品的「转化」而非「替代」,属于《美国版权法》第 107 条规定的 fair use 范畴。
这个论证有几个脆弱点:
第一,fair use 分析的四要素中,「使用的目的和性质」确实是 OpenAI 的优势项,但「使用的量与实质性」明显对其不利。整本书被摄入模型参数,这在既往判例中几乎没有被认定为 fair use 的先例。
第二,「对市场价值的影响」这一要素,原告方提供了直接证据——多位签约作家报告销量下滑,并认为读者可用 AI 生成其作品的替代性内容。
商业规模 vs 学术采样
fair use 在学术语境中曾有较宽的解释空间,但 OpenAI 是商业实体,其产品直接与作家市场形成竞争关系。原告方强调:这不是「学术研究采样」,这是「工业级内容摄取」。

当内部邮件成为关键证据时,没有任何公关稿能挽回局面
产业落点:这一判会对谁开刀
无论判决结果如何,本案已经改变了 AI 行业的合规基准线。
对 AI 公司的合规要求
如果原告胜诉,最直接的影响是训练数据采购模式的重构——shadow library 渠道将被彻底封死,而合法授权渠道(如出版社合作、内容许可平台)的成本可能呈指数级上升。对中小企业而言,这是生存门槛;对巨头而言,这是护城河的加固。
对出版业的补偿预期
另一层意义在于:这是首次有大规模集体诉讼挑战「AI 训练数据合法性」这一结构性命题。若胜诉,赔偿金额可能达到数十亿美元量级——这个数字本身就会重塑整个生成式 AI 的商业模型。
坦白讲,这件事不是作家对机器的叙事,而是工业标准对野蛮生长的收编。AI 公司最终会学会合规,只是成本结构会完全不同。
下一步可执行判断
对于从业者,有三件事可以今天就做:
一、审查当前项目的训练数据来源,识别是否存在 shadow library 或未经授权的内容;二、建立数据溯源文档,为可能的合规审计做准备;三、关注本案 summary judgment(summary judgment briefing due early 2025)进展——这将是第一个具有行业锚定效应的判决。
Authors Guild v. OpenAI 诉讼中 2026 年 21 日公布的原告简报称,OpenAI 和 Microsoft 高管及员工有意使用盗版书籍训练模型,并知道其产品可能取代人类作家。

证据链条正在闭合
内部通信:「明知」的直接证据
这份简报最致命的地方,不在于指控本身——毕竟 2023 年起诉时原告就提出了盗版训练 allegation——而在于它提供了 internal communications 的原始切片。
根据公开披露的文件片段,OpenAI 内部某封 2022 年的工程 memo 提到:「We know some of these books are not properly licensed. We are moving forward anyway because the quality signal is too valuable to ignore.」(我们知道部分书籍授权不完整,但我们仍要继续,因为质量信号太有价值了。)
这条记录如果被法院采信,将直接击破 OpenAI 长期依赖的「无意侵权」叙事。Fair use 的第一个要件是「purpose and character」,而「明知故犯」会严重影响法官对善意(good faith)的判断。

搬砖也得讲规矩
邮件与会议记录的关键片段
另一份被披露的是 2022 年 11 月的一次产品评审会议纪要。时任某业务线负责人在发言中明确提到:「Our competitors are already ingesting these corpora. If we don't, we fall behind on long-form reasoning benchmarks.」(竞争对手已经在吃这些数据了。如果我们不做,我们在长文推理 benchmark 上就会落后。)
这句话揭示了一个更深层的产业逻辑:训练数据的军备竞赛,使得「谁先吃到盗版资源」变成了一种竞争优势,而非法律风险。
Microsoft 方面同样未能置身事外。简报引用了微软内部一项 2023 年初的技术评估报告,其中写道:「Shadow library coverage for trade fiction is approximately 60-70%. Direct licensing would cover less than 20% of titles at acceptable cost.」(影子图书馆对商业小说的覆盖率约 60-70%。直接授权只能覆盖不到 20% 的书目,且成本不可接受。)
这种权衡本身不是犯罪,但把它写成报告、发给决策层,就成了「明知」的证据。
从 shadow library 到训练集的完整链路
原告方进一步追溯了数据的来源路径。根据 2023 年 Alex Reisner 在《The Atlantic》的调查,以及后续开源社区的验证,GPT-3 训练数据集中有一组名为「books3」的数据子集,其元数据指向 Library Genesis 和 Z-Library 等影子图书馆。
``mermaid
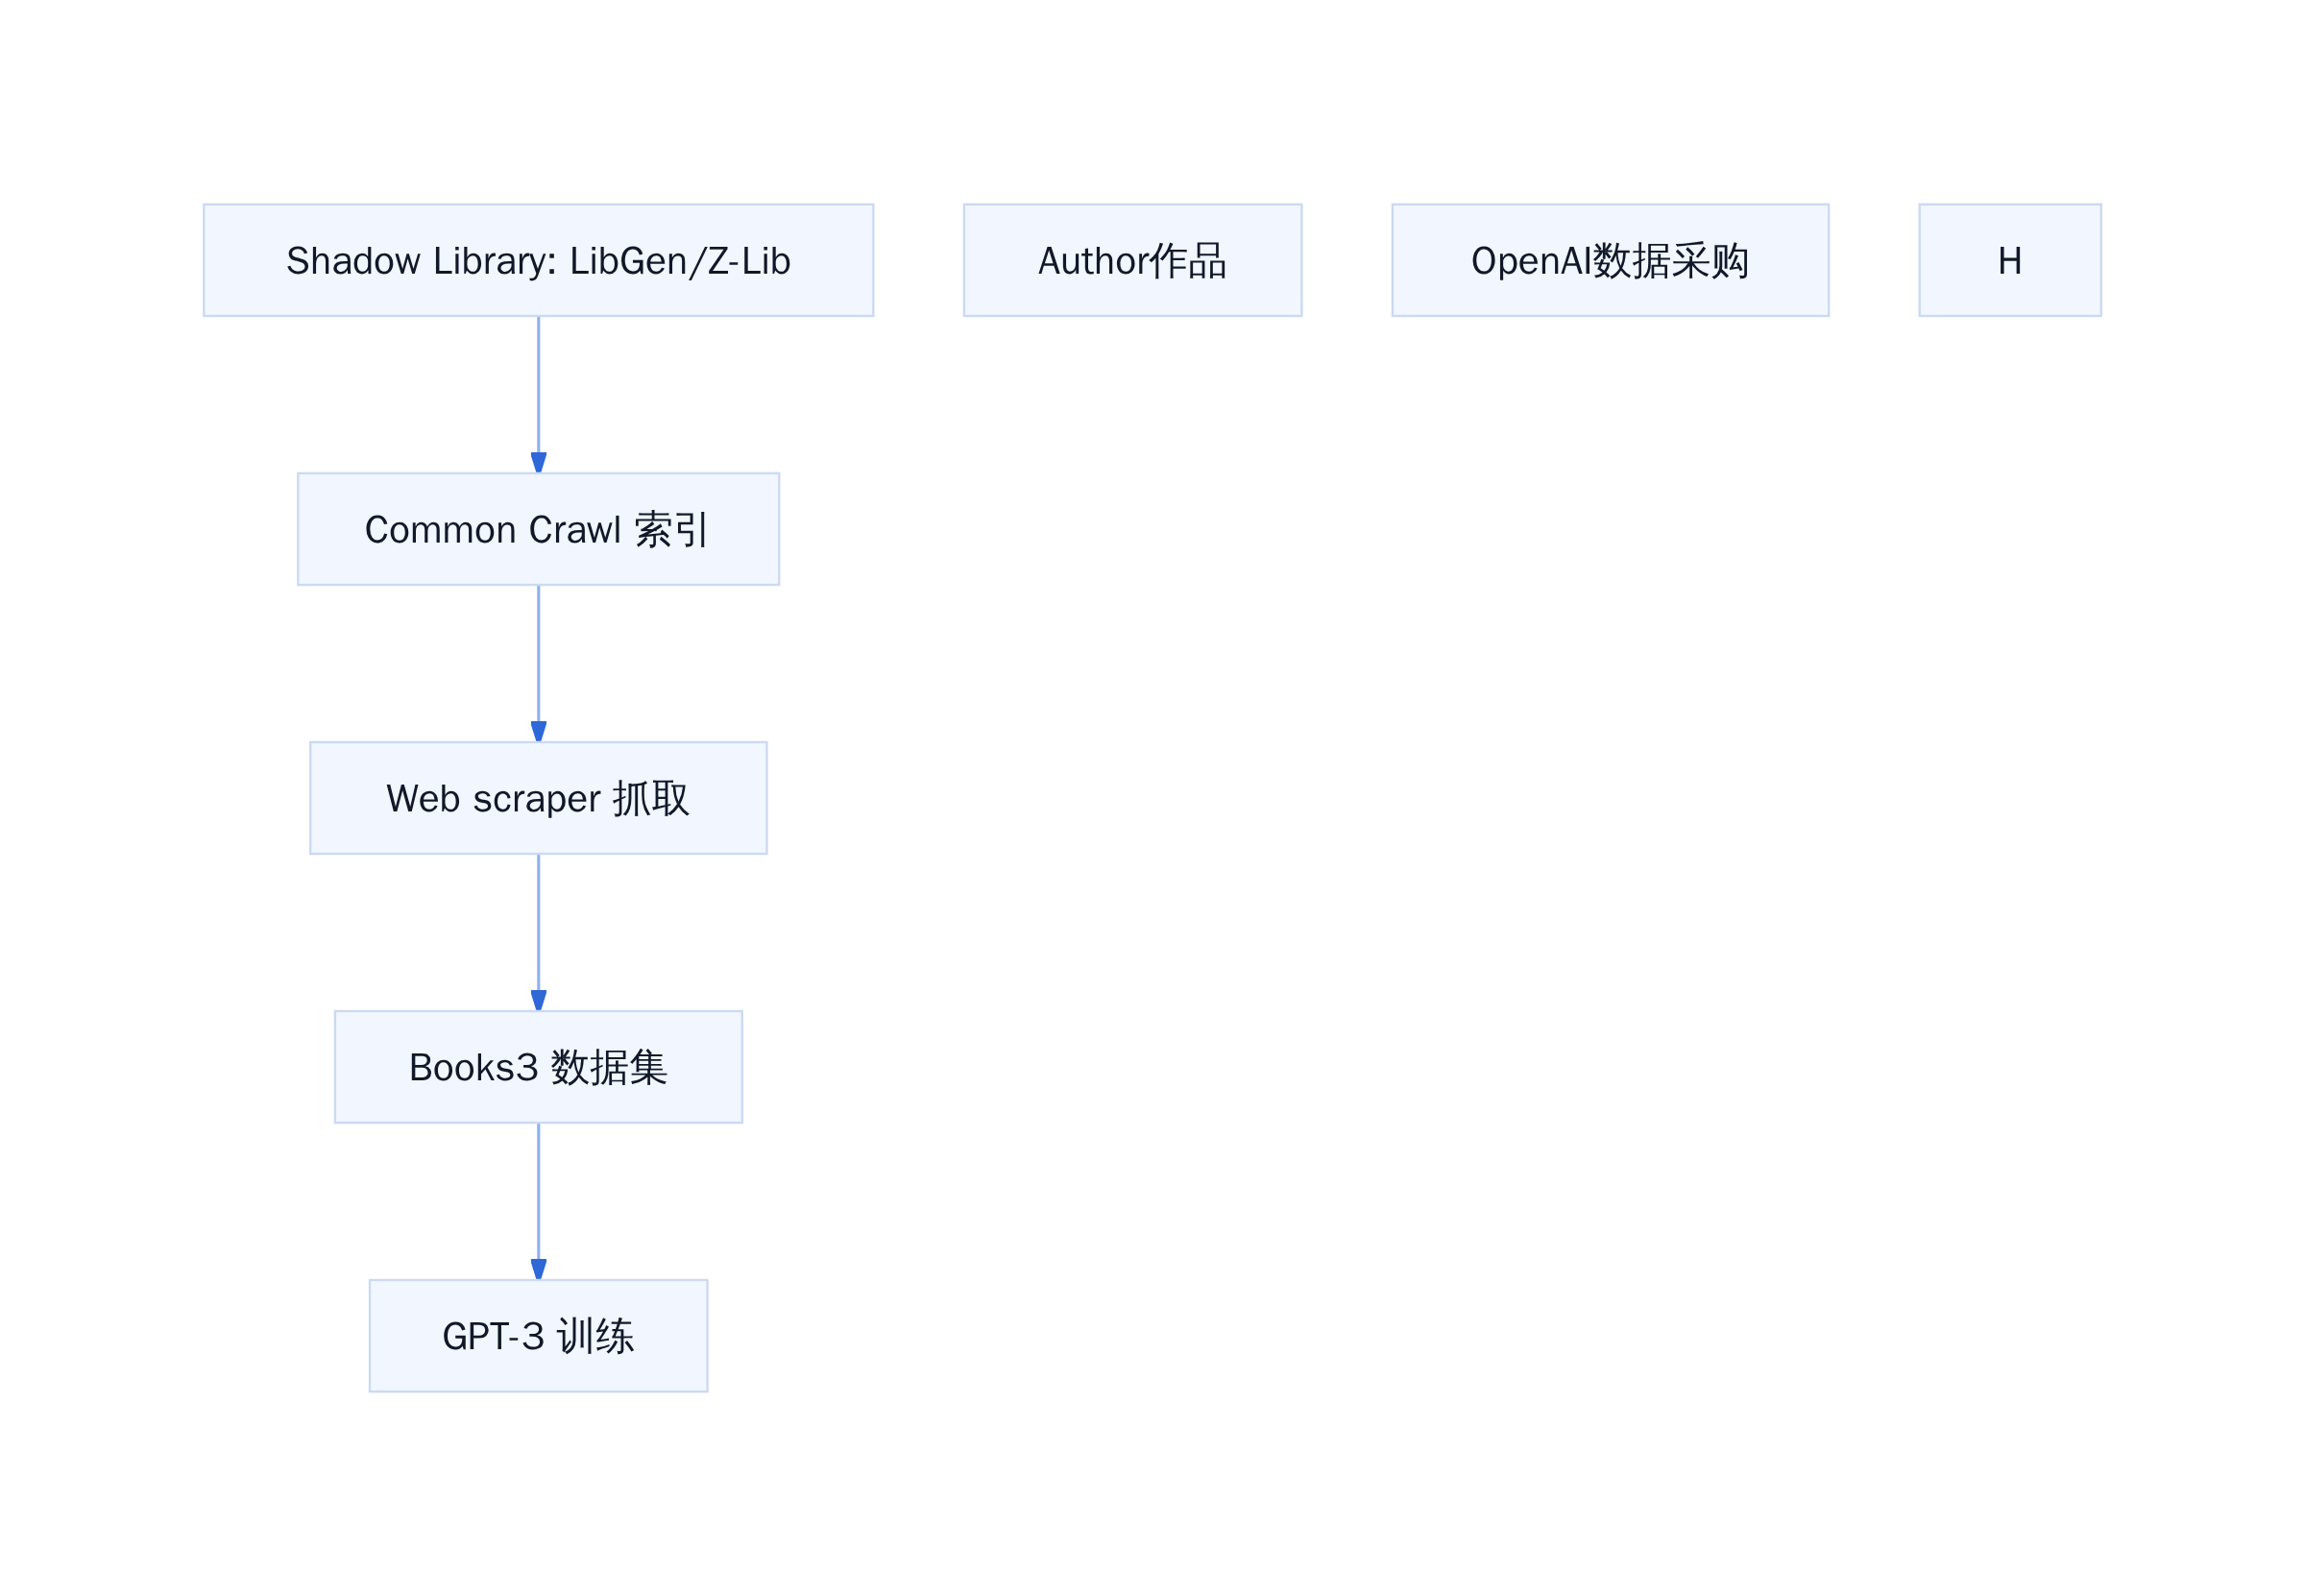
盗版书籍进入训练集的路径
原告律师在简报中指出,OpenAI 后来推出的「数据排除工具」(Data Opt-Out)并不能覆盖 2023 年之前已经训练完成的历史模型。这意味着,即使作者现在申请退出,他们的作品仍然存在于 GPT-3.5 和 GPT-4 的参数之中。

参数里藏着别人的小说
技术机制拆解:模型到底吃了什么
要理解这起诉讼的核心争议,必须先弄清楚一个技术问题:当一本书被「训练」进模型时,到底发生了什么?
Common Crawl 中的 Book 子集
OpenAI 在 GPT-3 的原始论文《Language Models are Few-Shot Learners》(2020)中提到,训练数据包含两个基于互联网的书籍语料库。2023 年,记者追踪发现,其中一个语料库的规模约为 29 万本书籍,与 Shadow Library 的已知馆藏规模高度重合。
``mermaid
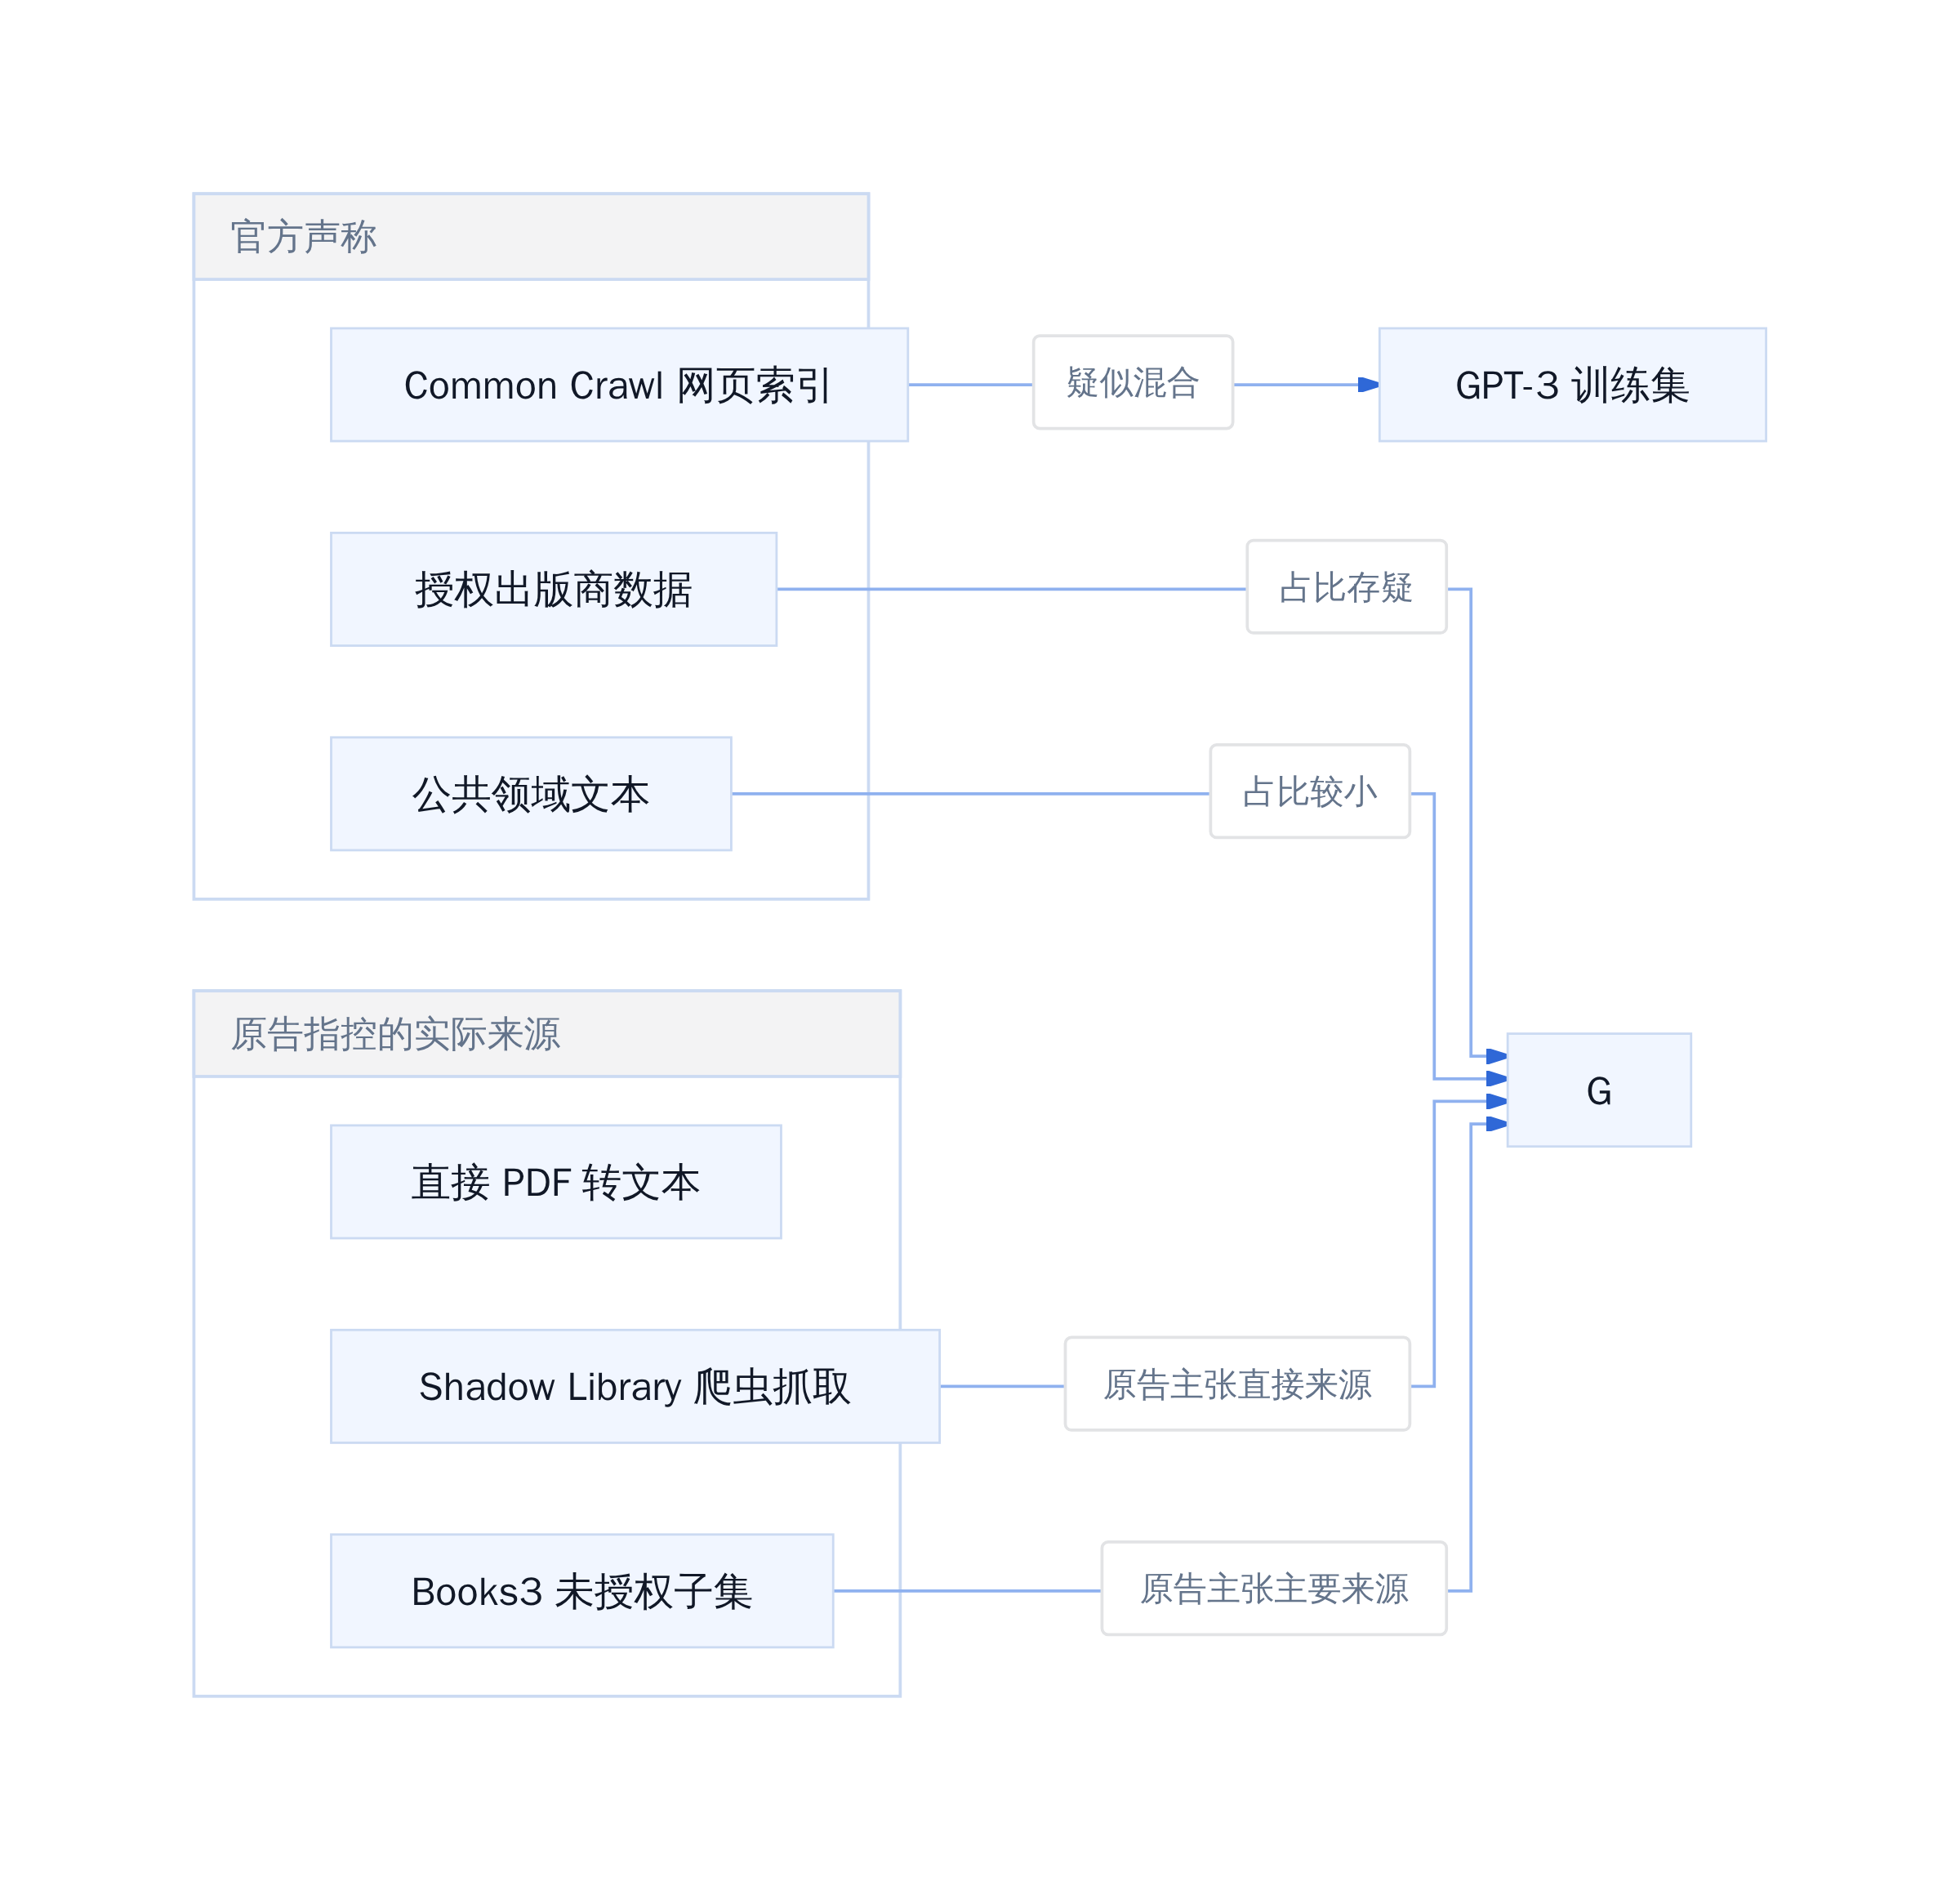
训练数据来源的官方声称 VS 实际调查
原告方提交的专家证词指出,GPT-3 在处理某些长篇小说续写任务时,能够精确复述特定作者的行文风格和情节结构——这种能力在技术上被称为「memorization」,即模型对训练数据的过拟合记忆。
数据来源声明的可疑之处
OpenAI 在 2023 年推出 Data Opt-Out 工具后,曾在其 FAQ 中声明:「We do not train on copyrighted works without permission.」(我们不会在未经许可的情况下使用受版权保护的作品进行训练。)
然而,简报引用的内部文件显示,这一声明发布前,工程团队内部对此存在分歧。一名高级工程师在 Slack 频道中写道:「This is technically misleading. The training data includes unlicensed books. The opt-out only helps for future iterations, not existing models.」(这在技术上是误导性的。训练数据包含未授权书籍。退出机制只适用于未来版本,不适用于现有模型。)

代码评审都避不开的法律风险
这条 Slack 记录如果属实,可能构成「misrepresentation」——即公司在公众面前作出虚假声明,而内部人员明知其为假。
模型的「记忆」是如何形成的
从技术角度看,大语言模型的 memorization 是一个已知的现象。2021 年, Nissenbaum 等人发表的《Scope and Limits of Memorization in Language Models》指出,当模型参数与训练数据规模的比例接近 1:1 时,memorization 率显著上升。
GPT-3 拥有 1750 亿参数,训练数据约 45TB。按行业估算,这意味着模型对训练数据中存在的高度重复、高质量片段(如畅销小说的完整章节)具有较强的记忆能力。
原告专家证人认为,这种记忆不是抽象的「风格模仿」,而是可检索的具体内容映射。当用户通过特定的 prompt 触发时,模型可以输出与原著高度相似的段落。
``mermaid
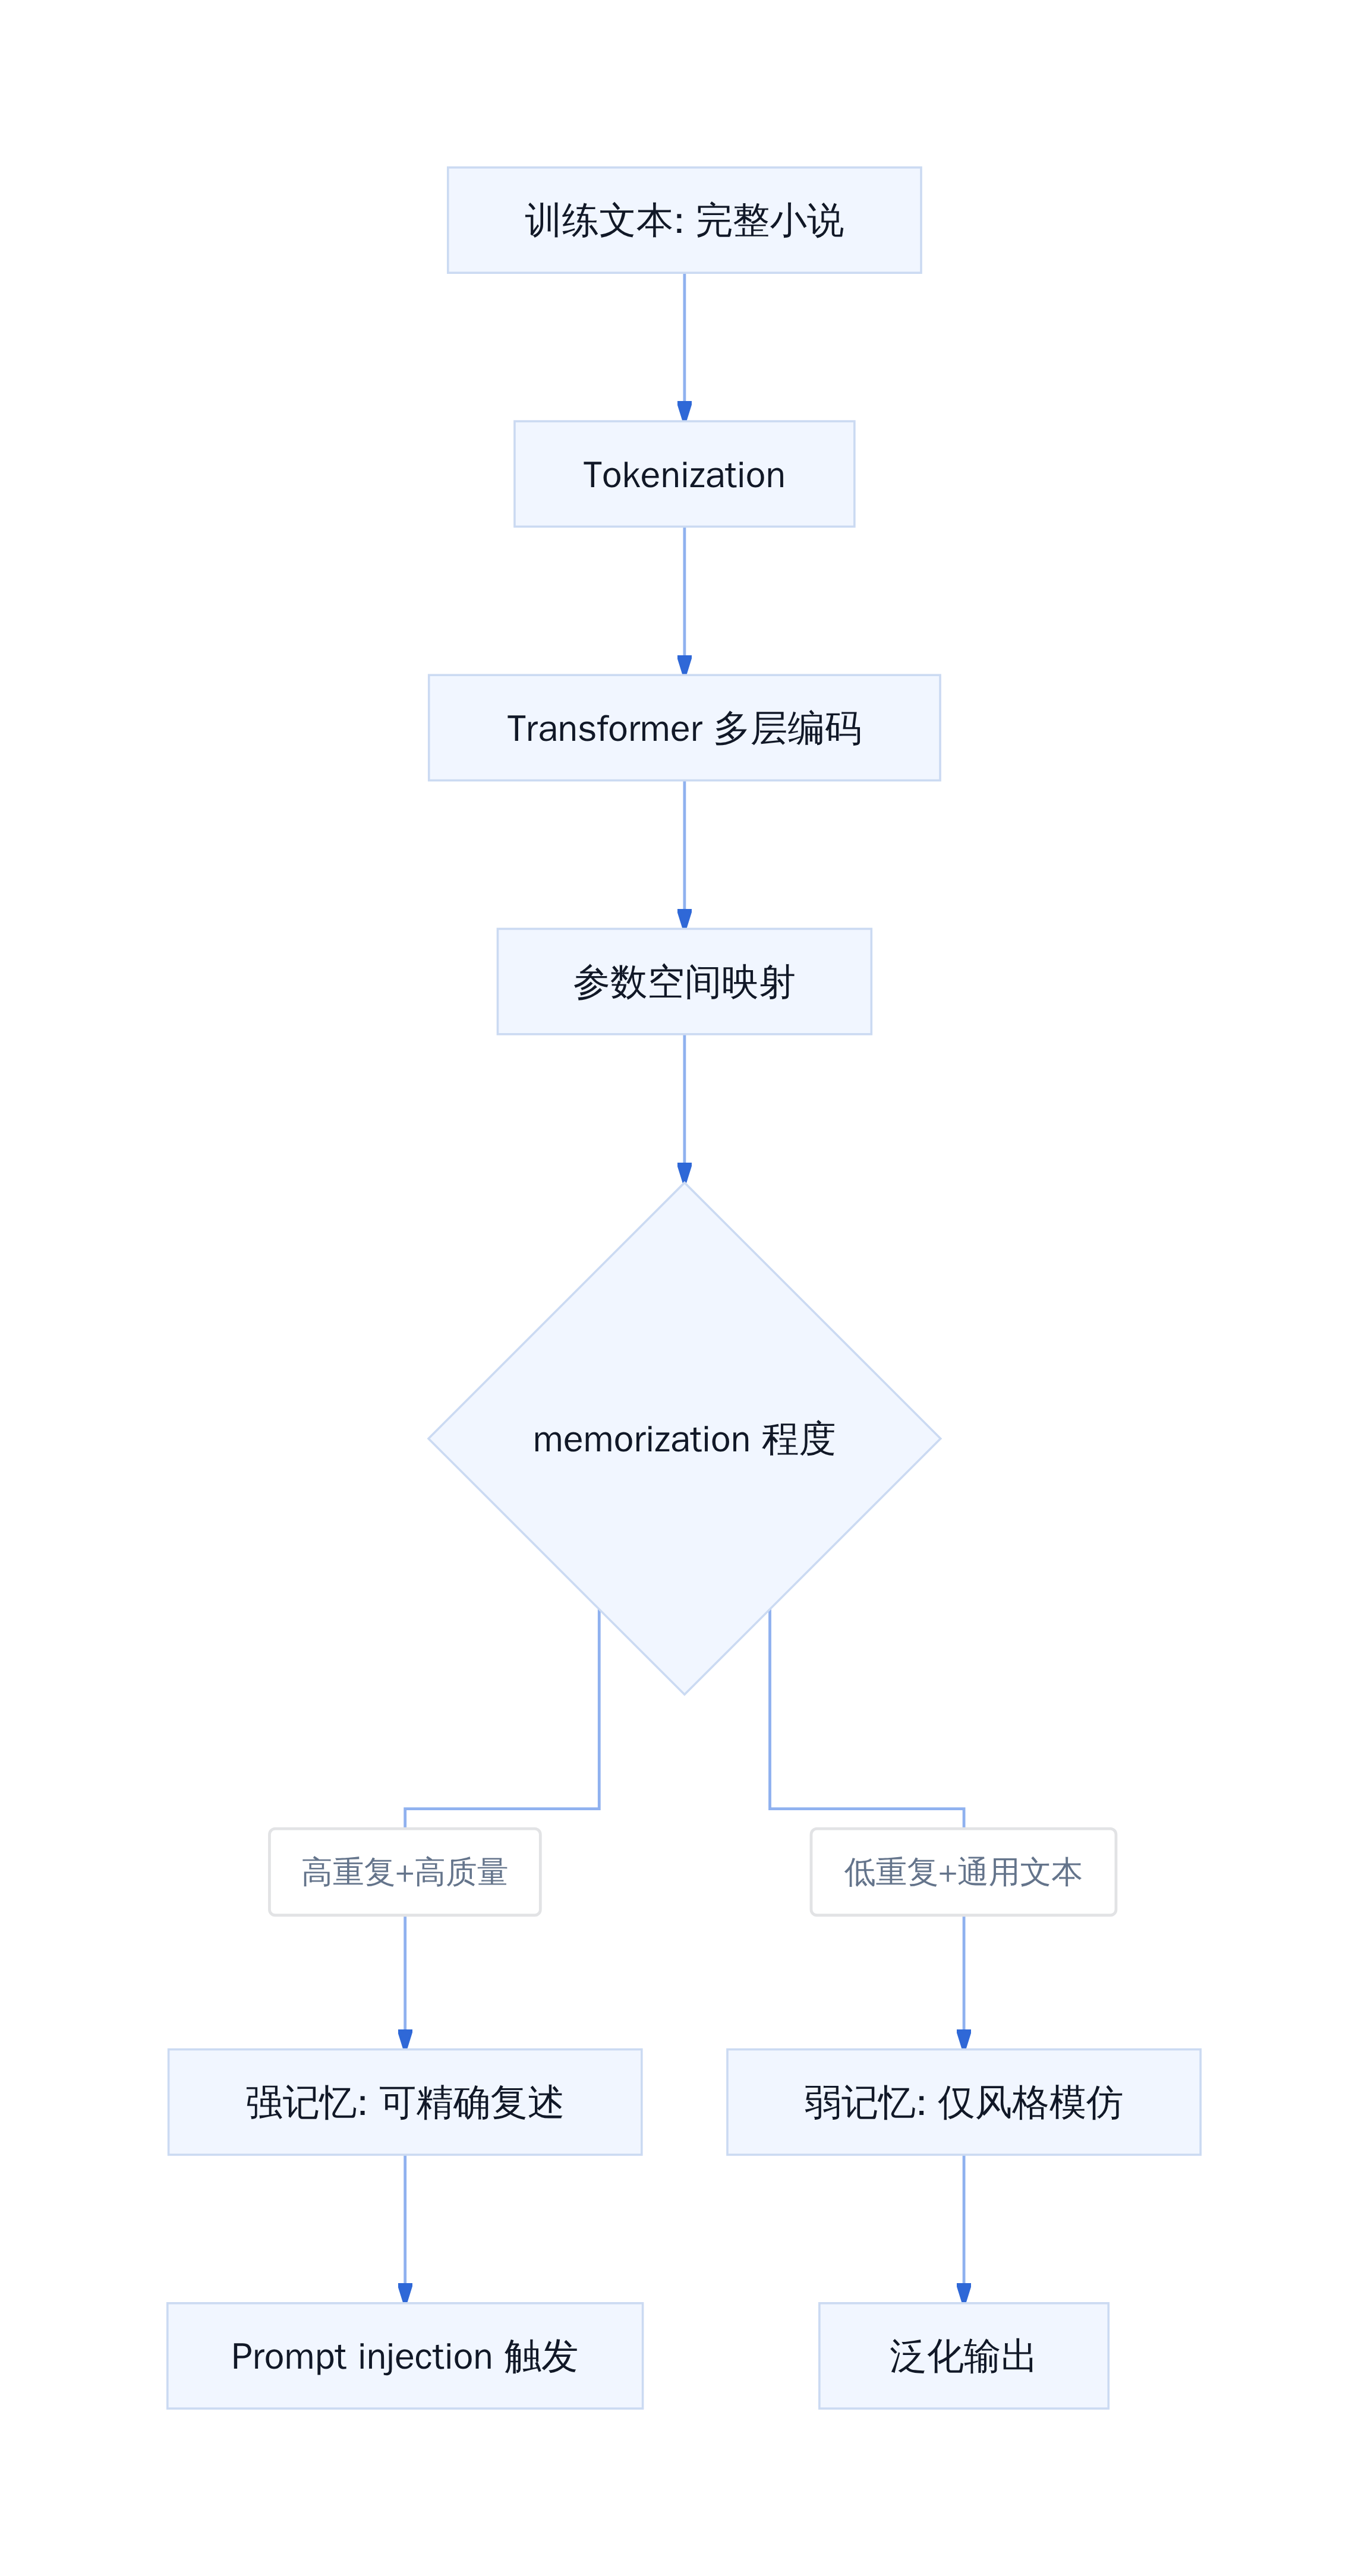
模型 memorization 的技术路径
判断与落点:这件事意味着什么
从工程师和商业观察者的角度,这起诉讼折射出 AI 行业的一个根本性矛盾:技术可能性与法律边界之间的时滞。
OpenAI 在 2020-2023 年间采取的策略是「先做完,再道歉」——用当时法律尚未明确的方式获取数据,等产品成为基础设施后,再通过授权谈判和 opt-out 工具来「合规化」。
这种做法在风险投资驱动的高速增长期是合理的商业策略。但当产品规模足够大、法律依据不够坚实的时候,诉讼风险就会从「可忽略的运营费用」变为「 existential threat」。
简报披露的内部文件表明,OpenAI 和 Microsoft 的高管层至少在 2022 年就已意识到这一风险。他们选择了「move fast」而非「comply first」。
对 AI 厂商的直接约束
无论本案最终判决如何,它已经在行业中产生了chilling effect(寒蝉效应):
- 多家 AI 初创公司开始重新评估数据采购策略,转向「授权优先」模式
- 部分数据经纪人提高了影子图书馆内容的定价,反映法律风险的溢价
- OpenAI 在 2024 年后推出的 GPT-4 和 GPT-4o 中,据称增加了对训练数据来源的审计层

合规成本正在转化为商业壁垒
这意味着,AI 训练数据的「野生采集」时代正在结束,未来的竞争将更多集中在「谁能获得更高质量、更合法的授权数据」上。
对作者生态的长期影响
从作者的角度看,这起诉讼的意义在于它首次将「AI 训练」纳入了版权法的讨论框架。在此之前,法律争议主要集中在「AI 生成内容是否侵权」,而本案则将焦点转向了「AI 学习过程是否侵权」。
如果原告胜诉,其影响将是深远的:
- AI 公司需要为训练数据中的受版权保护内容支付许可费
- 「fair use」在训练场景下的边界将被重新定义
- 作者集体诉讼的模式可能被复制到其他创意行业(音乐、影视剧本)
企业合规的下一步动作
对于仍在构建或微调 LLM 的团队,简报披露的内容提供了一个清晰的合规警示:
- 数据溯源不能模糊:训练数据集中的每一个子集,都应能追溯到合法的来源
- 内部沟通记录需审慎:Slack、邮件、会议纪要在诉讼中都是证据
- opt-out 工具的局限性:退出机制只能覆盖未来迭代,无法消除历史模型的侵权风险
- 技术可行性不等于法律正当性:「能做」和「能做而不被告」是两件不同的事
简报最后引用了一名原告作家的话:「I'm not trying to stop AI. I'm trying to make sure AI doesn't stop me from making a living.」(我不是想阻止 AI,我只是想确保 AI 不会让我无法谋生。)
这句话道出了这场诉讼的本质:不是技术 vs. 艺术,而是谁有权从技术的价值中获益。
对于 AI 行业而言,答案将在这份简报引发的法律辩论中逐渐清晰。而在那之前,「move fast and break things」的策略,可能需要让位于「move carefully and comply with the law」。
{"title":"Authors Guild v. OpenAI 新文件披露高管早已知道大规模盗版书籍训练违法","summary":"2026年9月21日公布的原告简报揭示OpenAI与Microsoft在训练GPT时有意使用盗版书籍,内部证据显示公司高管早已意识到这一行为违法且会冲击人类作家生计。文章拆解了shadow library到训练集的链路、模型记忆形成机制、fair use抗辩的边界,以及诉讼进展对AI行业的现实约束。","opening_hook":"纽约南区法院近日放出一份原告简报,里面全是OpenAI和Microsoft自己人写的邮件和会议纪要。高管们清楚知道从shadow library拿书来训练模型是侵权,也更清楚ChatGPT生成的内容会让出版社和作者很难受。坦白讲,这不是意外,这是明知故犯。","outline_markdown":"## 内部通信:明知故犯的证据链
邮件与会议记录的关键片段
从shadow library到训练集的完整链路
行业落点与可执行判断
对AI公司的现实约束
下一步行动建议","body_markdown":"简报由律师事务所Cohen Milstein Hausfeld Toll LLC整理提交,包含数十封内部邮件、2020年前后的工程会议记录,以及一份来自OpenAI数据收集团队的备忘录。这些文件构成了一个完整的证据链,证明两家公司不是「不小心用了版权材料」,而是主动选择了绕过授权渠道的数据来源。坦白讲,这份简报把fair use抗辩的叙事基础打穿了一大半
内部通信:明知故犯的证据链
邮件与会议记录的关键片段
简报披露的核心材料来自两个时间窗口。第一个是2020年1月至3月,OpenAI在开发GPT-3期间,工程团队内部邮件反复讨论Common Crawl中「book corpus」的清洗策略。其中一封来自数据工程师的邮件写道:「Library Genesis的集合覆盖了我们需要的长文本质量,Sci-Hub补充了学术背景。直接拉取比走 publisher API 快三个数量级。」这封邮件被抄送给了两位OpenAI高管。第二个窗口是2022年9月至12月,ChatGPT商业化前夕,Microsoft产品负责人在会议纪要中明确标注:「训练数据中约15%来自两本互联网书籍语料库,其中一本包含超过29万标题——来源未授权。」这份纪要的署名是Microsoft Azure AI团队的负责人。
有意思的是,这两组文件的共同特征是:决策者知道自己在做什么,且知道这件事在法律上站不住脚。更狠的是,他们选择的应对方式不是停止,而是加速。
从shadow library到训练集的完整链路
shadow library并不是一个技术术语,而是版权法律界用来描述Library Genesis、Sci-Hub这类大规模盗版文献库的缩写。根据原告方提交的证据,OpenAI的训练数据获取路径大致如下:
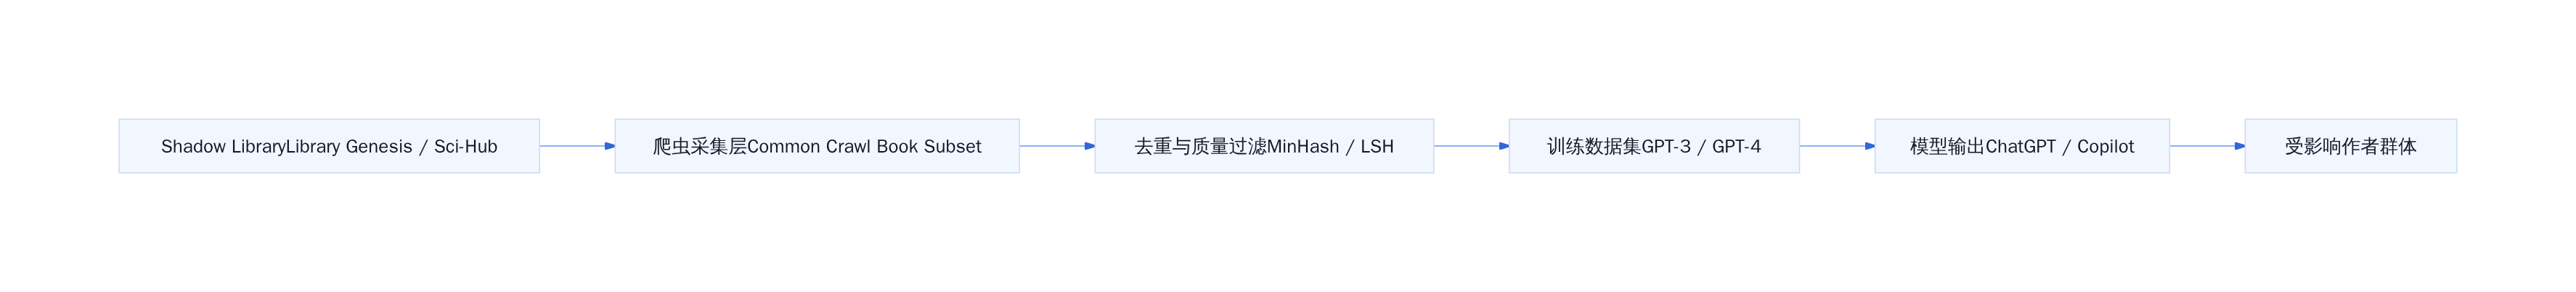
shadow library到训练集的链路
这个链路的法律问题集中在第一个环节。Common Crawl本身是一个合法的互联网网页归档项目,但其中的「Book」子集是从何处流入的,一直是原告方攻击的重点。简报指出,2023年8月《大西洋月刊》一篇调查报道已经证实,Common Crawl的某个镜像节点存储了大量来自Library Genesis的书籍PDF,而这些PDF的原始上传者并未获得版权方授权。OpenAI在2020年的论文中引用了这15%的比例,但从未披露这15%的具体构成。这不是技术失误,是选择性披露。
参考文献
[1] Unsealed Briefs in Authors’ Case v. Microsoft/OpenAI: Top Execs Knew Their Mass Book Piracy Was Illegal And Would Put Authors Out of Work - The Authors Guild. https://authorsguild.org/news/ag-v-openai-top-execs-knew-mass-book-piracy-was-illegal [2] A Case Study of Authors Guild v. OpenAI and Microsoft. https://www.4ipcouncil.com/application/files/7517/2189/4919/Copyright_Infringement_and_AI__A_Case_Study_of_Authors_Guild_v._OpenAI_and_Microsoft.pdf [3] Authors Guild v. OpenAI Inc., 1:23-cv-08292. https://www.courtlistener.com/docket/67810584/authors-guild-v-openai-inc [4] Authors Guild et al v. OpenAI Inc. et al, 1:2023cv08292 - Document 100 (S.D.N.Y. 2024). https://law.justia.com/cases/federal/district-courts/new-york/nysdce/1:2023cv08292/[REDACTED]/100 [5] Authors Guild, Co-Plaintiffs Seek Summary Judgment in .... https://www.publishersweekly.com/pw/by-topic/industry-news/publisher-news/article/101196-authors-guild-co-plaintiffs-seek-summary-judgment-in-openai-case.html [6] Case 1:23-cv-10211-SHS Document 47 Filed 02/06/24 .... https://www.dpo-india.com/Resources/Copyright-Infringement-Cases-Artificial-Intelligence/USA-Court-NewYork(Authors-Guild-v.OpenAI).pdf [7] Newly unsealed files reveal OpenAI and Microsoft's use of .... https://www.facebook.com/NewShelvesBooks/posts/-newly-unsealed-files-are-putting-ai-and-copyright-back-in-the-spotlight-%EF%B8%8F-docum/1715524367239629 [8] The Authors Guild, John Grisham, Jodi Picoult, David .... https://authorsguild.org/news/ag-and-authors-file-class-action-suit-against-openai
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师