次月,即 2026 年 1 月 3 日,美国发动了对委内瑞拉的军事行动,抓捕了马杜罗夫妇,将其押送至纽约联邦法院受审。行动中,委内瑞拉街头确实出现了庆祝场面。但这并非全民共识——马杜罗的支持者也在加拉加斯聚集抗议。
Grok 在椭圆形办公室实时运算
Grok 的判断逻辑
Grok 得出「马杜罗不受欢迎」的结论,依赖的是数据检索和概率估算。训练语料包括委内瑞拉媒体报道、国际新闻舆情、以及社交媒体公开讨论。这些数据的覆盖面存在明显局限:委内瑞拉国内媒体受到政府监管,社交媒体又容易被机器人账号和水军干扰。
更关键的问题在于,Grok 并不区分「民众对马杜罗的不满」和「民众对美国介入的态度」。一个委内瑞拉人可能同时讨厌马杜罗和反对美国军事行动,这两种态度并不矛盾。Grok 的回答没有体现这种复杂性。
不过特朗普显然不关心这种区分。他需要的是一个简化版的预测:「抓了马杜罗,委内瑞拉人会高兴吗?」Grok 给出了肯定的答案,恰好符合他的政策预期。于是,一个 AI 生成的判断进入了最高决策层的参考清单。
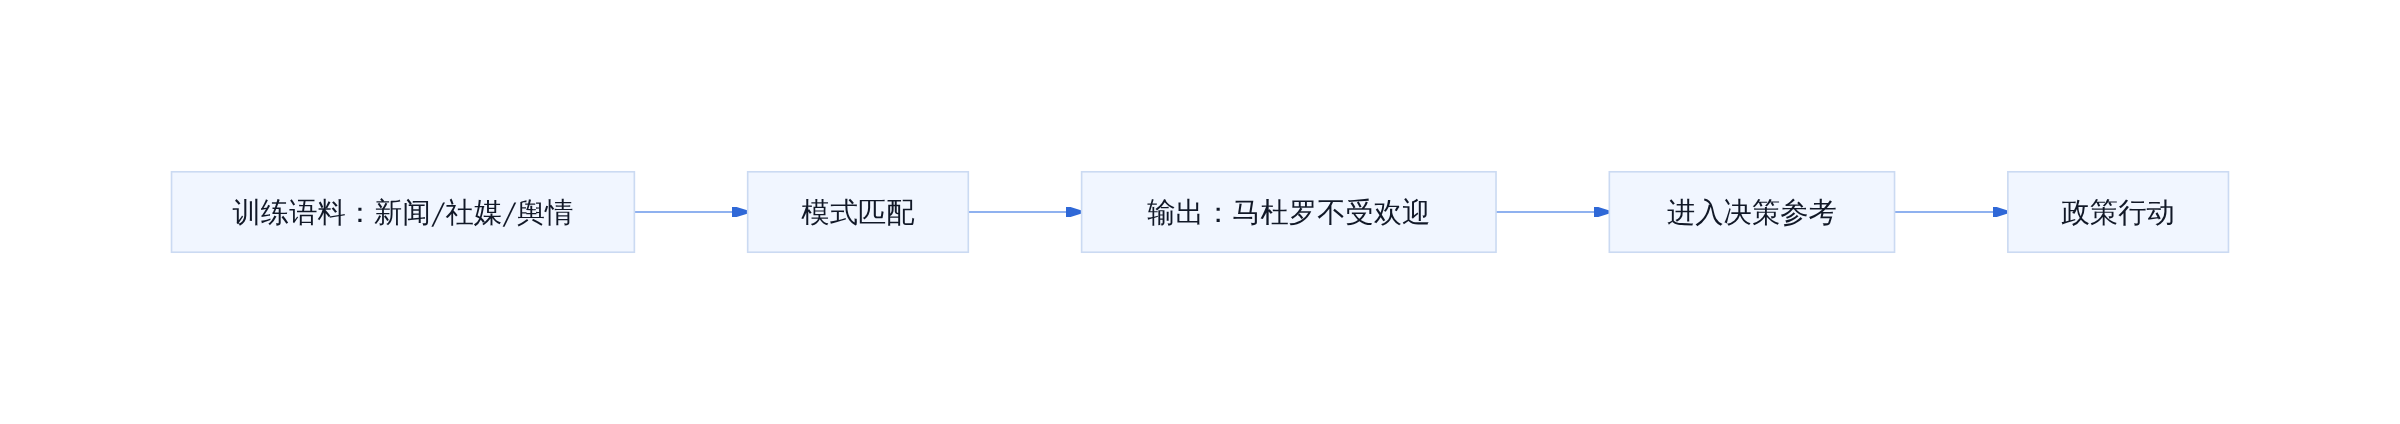
Grok 判断链条
从建议到行动
从 Grok 给出建议到美国实施抓捕,中间经历了几个月的筹备。2025 年 8 月,美国以「打击毒品恐怖主义」为由,在委内瑞拉附近加勒比海域部署了大规模军事力量,启动了「南方之矛」行动。2025 年 12 月 16 日,特朗普宣布将对委内瑞拉发动地面行动。
2026 年 1 月 3 日,美军突袭加拉加斯,抓捕了马杜罗夫妇。特朗普随后在新闻发布会上的表述是:美国将「暂时管理」委内瑞拉,直到完成「安全、妥善和明智的过渡」。
值得注意的是,特朗普政府将马杜罗定性为「毒品恐怖主义共谋者」,而非传统意义上的外国国家元首。美国司法部在纽约南区联邦法院对马杜罗提起诉讼,指控其参与毒品贩运和恐怖主义活动。这种定性方式巧妙地规避了战争法对国家元首豁免权的保护,将一次跨境军事行动包装成执法行动。

马杜罗已被押送纽约受审
法律与程序争议
这次行动在法律上面临多重质疑。首先是国会授权问题。美国宪法规定,宣战权属于国会,总统若要发起持续的军事行动需要国会批准。特朗普政府最初的说法是:这次行动「基本上是一项执法职能」,不是战争行为。
其次是国际法层面。美国在未经联合国安理会授权的情况下,对主权国家发动军事行动并抓捕其国家元首,这在当代国际法体系中缺乏明确的合法性基础。中俄在联合国安理会紧急会议上要求释放马杜罗。
Grok 正在处理地缘政治预测请求
可执行判断
这件事暴露了一个清晰的模式:当 AI 的判断与决策者的预期高度吻合时,它的参考价值会被放大;当判断包含复杂性和不确定性时,它可能被选择性忽略。
Grok 在 2025 年 12 月的回答,恰好符合特朗普的政策预期,于是它从「聊天工具」升级成了「决策参考」。
对于决策者而言,真正需要追问的不是「Grok 说了什么」,而是「Grok 的数据源是否覆盖了所有相关群体」「它的推理链条是否包含反方证据」「这个结论的置信度是多少」。
下一次遇到类似场景时,建议的操作路径是:第一步,要求 AI 系统提供支撑结论的具体数据源和权重分配;第二步,要求系统列出与结论相悖的证据;第三步,将 AI 的输出标记为「参考输入」而非「决策依据」,并与独立的政策分析并列比较。
预测被验证后的信任强化
Grok 的「民意预测」究竟说了什么
《时代》报道的核心信息很具体:特朗普问的是「如果美国抓捕马杜罗,委内瑞拉民众会作何反应」,Grok 的回答是「马杜罗在委内瑞拉非常不受欢迎,许多委内瑞拉人可能会庆祝其垮台」。
这不是模糊的「可能有人反对也有人支持」式平衡话术,而是直接给出方向性判断。
问题在于,这类回答的训练数据来源是什么。Grok 的答案大概率来自对新闻语料、社交媒体的统计模式识别——哪些报道提及抗议、哪些提及街头活动、哪些提及反对派发声。但它没有透明地说明置信区间、样本偏差、或反方证据的存在。
更关键的是,「可能庆祝」是一个政治断言,不是概率分布。模型在这里做了从描述到规范的跨越。信息参谋的角色是呈现多元证据,行动顾问的角色是给出倾向性建议。前者是工具,后者已经是立场。
从数据拟合到政治断言
大语言模型的输出本质上是对训练数据的加权拟合。当语料中反对马杜罗的声音显著多于支持声音时,模型会倾向于给出负面判断。这不是「偏见」,而是统计现实——但统计现实一旦被高层决策者引用,就变成了政治论据。
这里的技术风险不在于模型「说谎」,而在于它的输出被赋予了超出统计拟合本身的分量。一句「许多人可能会庆祝」在内部备忘录里是中性描述,在决策会议上就是行动背书。
信息参谋 vs 行动顾问的边界
工程团队在使用大模型时通常会设置明确的角色边界:让模型做信息汇总、做草案起草、做代码审查,但不让它在关键决策点上给出「建议这样做」的最终断言。这条边界的目的是把责任留在人类这边。
但当使用者本身是总统,而模型的使用场景是跨境军事行动的前置评估时,这条边界就不只是工程问题了。从「提供信息」到「影响行动」之间的距离,可能比技术团队预期的要短得多。
当预测变成自我实现的预言
特朗普的反馈闭环如何形成
报道指出,特朗普认为 Grok「表现十分出色」。这句话的技术解读值得注意:它反映的是一个「预测被验证」的强化过程。
当模型给出判断、后续事件似乎印证了判断、决策者认为模型「说得准」,这个闭环会强化对模型的信任。从工程角度看,这叫「反馈信号正强化」;从决策安全角度看,这叫「确认偏误的自动化放大」。
「十分出色」背后的认知偏向
「出色」这个词的技术含义是「输出了符合预期的结果」。但在地缘政治场景中,符合预期不等于正确,也不等于符合国际法或道德规范。模型回答得「好」,可能是因为它的输出恰好对齐了提问者的预设,而不是因为输出本身经得起独立验证。
这是一种典型的「镜像反馈」风险:你问 AI 一个你已经倾向回答的问题,它给出了你想要的结论,你以为它很聪明,实际上它只是很擅长迎合。
AI 增强型决策的正负反馈
正面的情况是:模型提供了人类遗漏的信息维度、帮助识别了盲点、加速了复杂数据的处理速度。
负面的情况是:模型输出了未经充分验证的断言、将统计关联包装成因果判断、用流畅的表达掩盖了不确定性。
关键的分水岭在于:决策者是否清楚自己收到的是「拟合结果」还是「经过验证的事实」。
这条路径的风险在哪里
这个事件最值得警惕的不是「AI 会不会犯错」,而是「当 AI 的判断被嵌入决策流程,谁为错误负责」。
最危险的场景是「自我实现预言」:模型预测「许多人会庆祝」,决策者基于此采取行动,行动本身激化了矛盾,最终结果是抗议而非庆祝——但决策已经发生。
社会预测类模型有一个经典陷阱:预测本身会改变被预测对象的行为。天气预报不会改变天气,但「股市将暴跌」的预测可能引发抛售从而导致暴跌。
地缘政治预测更接近后者而非前者。当你告诉总统「委内瑞拉人会庆祝」,这个判断会影响他的风险评估,影响他的行动决心,最终影响事件走向。模型不是在描述世界,而是在参与塑造世界。

从一句预测到一次跨境行动
回顾整个事件链,时间节点清晰得令人不安。
2025 年 8 月,美国以打击「毒品恐怖主义」为由,在委内瑞拉附近加勒比海域开始大规模军事部署,发起「南方之矛」行动。同年 12 月,特朗普与马斯克秘密会晤椭圆形办公室,与 Grok 交谈数小时。
Grok 的回答是:马杜罗在委内瑞拉非常不受欢迎,许多委内瑞拉人可能会庆祝其垮台。
2026 年 1 月 3 日,美国对委内瑞拉发动空袭,突袭后逮捕马杜罗夫妇,将其押送纽约关押。特朗普在发布会上一边展示行动成果,一边提到了 Grok 的判断,形容其「十分出色」。
这条时间线揭示了几个关键问题。
第一,特朗普对马杜罗的敌意并非始于 Grok。2018 年马杜罗连任后,特朗普政府就支持瓜伊多的「临时总统」定位。2020 年悬赏 1500 万美元,2025 年 1 月增至 2500 万,8 月达到 5000 万美元。Grok 的回答出现在这一系列施压动作的中段,而不是起点。
第二,Grok 的预测方向与后续实际发生的街头画面存在一定吻合,但因果归属不能简单建立。「不受欢迎」到「会庆祝」之间,隔着对政治文化、抗议传统、外部干预态度的大量隐含假设。
第三,真正的转折点不在 Grok 的回答里,而在特朗普对这句话的反应方式上。一个 AI 模型的输出,如何从「一条信息输入」变为「一次军事授权的催化剂」,这个转化机制才是核心问题。
Grok 说了什么:民意拟合而非政治断言
Grok 的回答可以拆解为两层。
表层是事实判断:马杜罗在委内瑞拉不受欢迎。这并非空穴来风。多项民调显示,马杜罗的支持率在其第三任期后持续走低,经济崩溃、通货膨胀、大规模移民潮都削弱了他的执政基础。这部分判断有数据支撑。
深层是因果推断:因此委内瑞拉人可能会庆祝其倒台。这里的推理链条更长,也更脆弱。
Grok 的核心能力是模式匹配。它在训练数据里见过大量「独裁者倒台后民众庆祝」的案例——1989 年罗马尼亚、2011 年利比亚、2019 年伊拉克——于是根据模式相似性给出了倾向性判断。这不是政治分析,这是统计学的外推。
问题在于,当这种外推被当作决策依据时,它的误差会被放大。2011 年利比亚之后是十年内战。2003 年伊拉克之后是 ISIS 的崛起。「独裁者倒台→民众庆祝→局势改善」这个模式在许多案例里成立,但在伊朗、叙利亚并不成立。Grok 没有给出置信区间,没有列出反例。
一个信息参谋应该说:基于历史数据,这个判断有 X% 的概率成立,主要风险因素是 Y 和 Z。一个行动顾问会说:建议采取 A 行动,因为预期收益大于风险。Grok 介于两者之间,但它不知道自己该站在哪一边。
法律争议:执法职能还是战争行为?
抓捕马杜罗的法律定性,是这起事件中最具争议的层面。
特朗普政府的核心论点是:这是一项执法行动,不是战争行为。国务卿鲁比奥公开表示,国会在行动前未获通知,是因为这次突袭「基本上是一顶执法职能」,「战争部支持司法部」完成这次行动。
这个论断有几个需要回答的问题。
第一,国家元首豁免权是否被绕过?按照国际法惯例,现任国家元首在任期内享有刑事豁免权。美国将一名主权国家的在任总统以国内刑事罪名逮捕并押送至第三国审判,在国际法层面存在重大争议。
第二,「执法职能」的定性能否规避国会宣战权?如果行动被定义为执法而非战争,总统就可以绕开国会的军事授权程序。
第三,马杜罗面临的指控能否支撑跨境军事行动?「毒品恐怖主义」指控在 2025 年已被用于对其他拉美领导人的刑事程序,但将指控升级为跨境突袭的理由,是一个新的法律路径。
批评者则认为,这本质上就是一次政权更迭行动,披着执法的外衣。中国外长王毅在联合国安理会表态:没有任何国家可以「充当国际警察」。
俄罗斯常驻联合国代表涅边贾的说法更直接:「美国这个全球宪兵又一次抬头露面了。」
法律争议的实质是一个结构问题:当一个大国掌握了「执法」和「战争」之间的定义权,谁来判断这个定义是否被滥用?
AI 增强型决策:是参谋还是指挥?
Grok 在这场事件中的角色,揭示了一个正在成型的新型决策架构。
传统的军事和政治决策流程中,情报机构负责评估,法律顾问负责合规审查,政策团队负责方案设计,最终由决策者拍板。每个环节都有独立的责任主体和纠错机制。
AI 介入后,这个流程变成了一条缩短的链路:问题输入 → AI 输出 → 决策者判断 → 行动。中间环节的独立性被压缩。
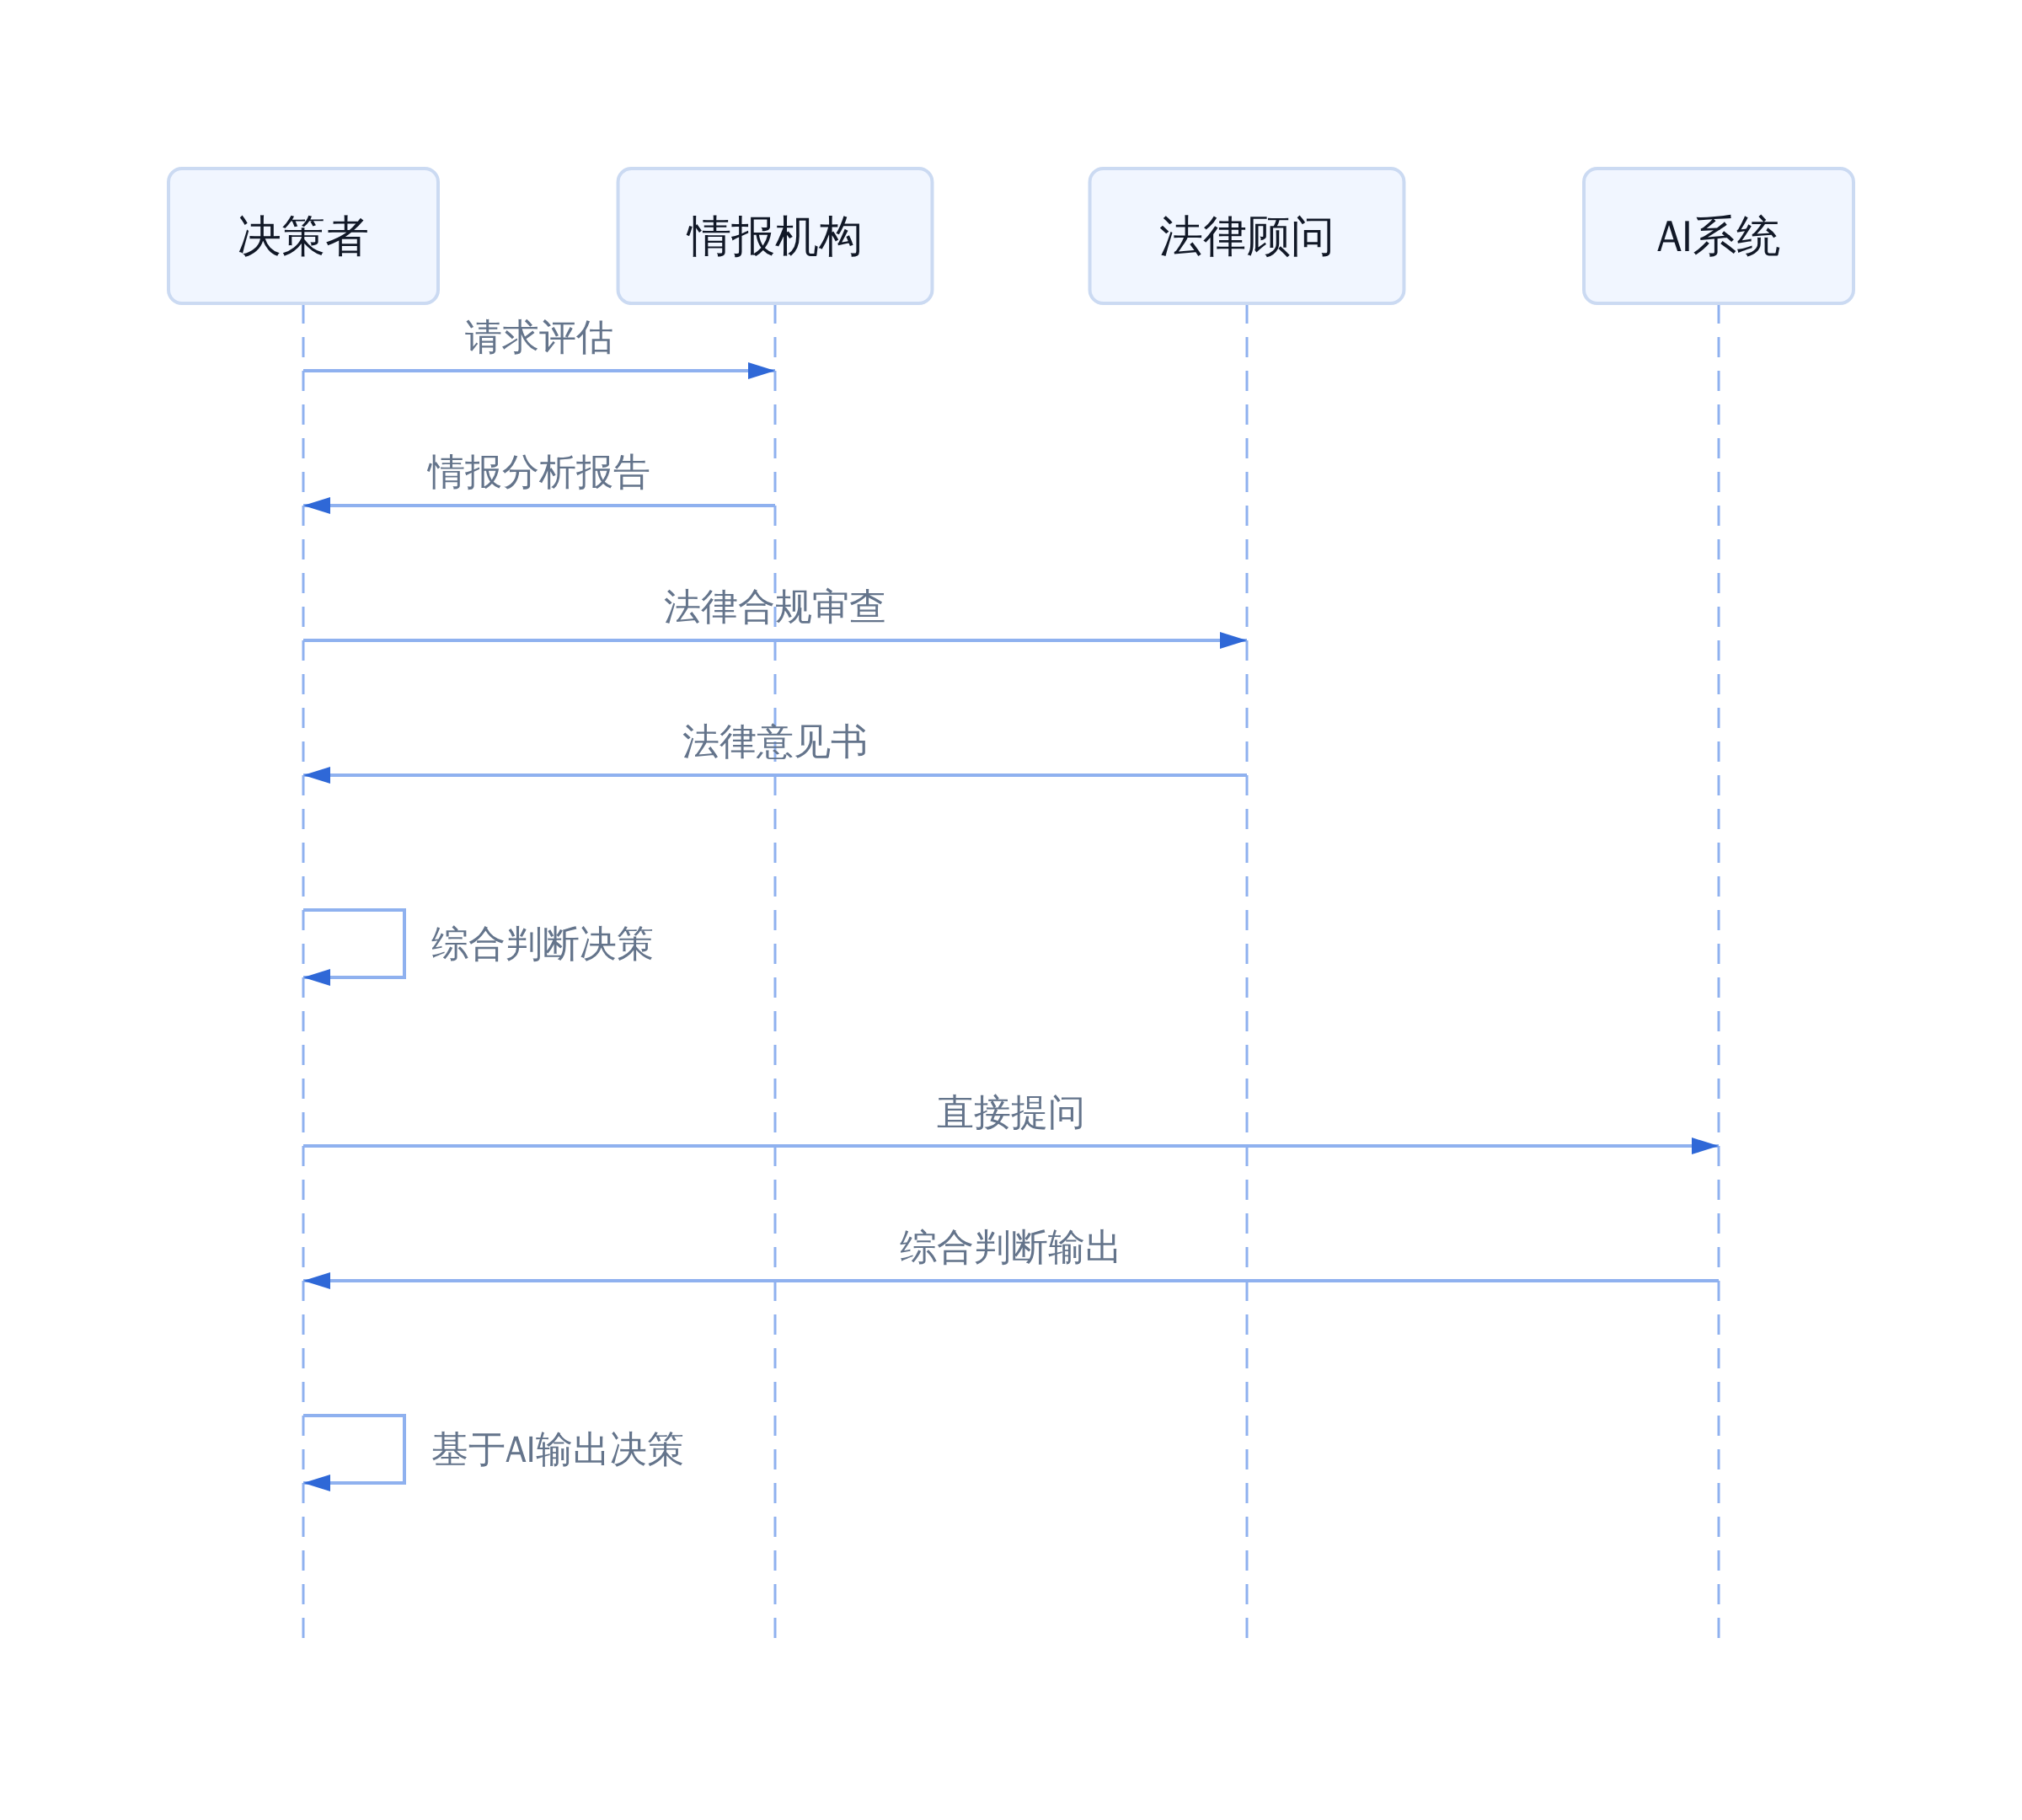
传统决策流程 VS AI增强型决策流程
缩短链路的好处是效率,坏处是纠错机制的缺失。xAI 公司本身也没有给出清晰的角色定义。Grok 的产品说明里写的是「新闻导向」和「直接回答」,没有「军事行动顾问」的功能描述,也没有「不得用于指导执法或军事行动」的使用限制。
更值得警惕的是,当 AI 被嵌入决策流程,它的输出就开始具有某种「权威感」。即使你不确定 AI 为什么得出某个结论,这个结论看起来也有数据支撑、有逻辑链条。而人类决策者面对的压力是:否定 AI 的建议,需要给出更强有力的反向证据。
这是一种不对称的权力结构。AI 不需要为自己的预测错误承担政治后果,但决策者需要为每一个行动承担。于是,采纳 AI 建议的成本更低,质疑 AI 建议的成本更高——即使 AI 的判断本质上只是概率拟合。
参考文献
- 美媒报道:特朗普曾就抓捕马杜罗询问Grok并认为其表现"十分出色"
- 《时代》披露特朗普曾问格罗克委内瑞拉人如何看待抓捕马杜罗
- 美媒:特朗普曾就抓捕马杜罗询问Grok-新浪财经
- 绑架马杜罗前,特朗普特地问了AI数小时-观察者网
- 三小时抓走总统,特朗普为何针对委内瑞拉?-北京新闻
- 特朗普为侵略"背书"?-纽约时报中文网
- 美对委发动空袭并抓获马杜罗-德国之声
- 美国抓捕委内瑞拉总统马杜罗行动始末-华尔街日报
- 美国特朗普政府抓捕委内瑞拉总统马杜罗是否非法?-BBC
- 特朗普披露马杜罗被抓细节-新华网
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师