上周DeepSeek刚推出V4 Pro正式版,号称多项测试逼近Claude Fable 5,全网狂欢。四天后官方公告突然一出:V4 Pro流量全部路由到V4.1 Flash,按Flash价格收费。你买的旗舰款,瞬间变成平替套餐。
一、四天时间线:Pro刚发布就退役的离奇操作
9月8日内测曝光
9月8日,DeepSeek在内测群里放出V4.1 Flash的两个API测试,model id是 deepseek-v4.1-flash-expires-on-0910,官网称这是「中间版本」。同一天,Open平台预告9月10日正式发布,并明确说「全面超越V4 Pro」。
9月10日正式发布
正式发布当天,DeepSeek的更新日志里列出了一组数字:GPQA Diamond 90.9,DeepSWE v1.1达到74.2,Terminal-Bench 3.0为30.0。74.2分是什么概念?同榜上Claude Opus 5是74.0,GPT-5.6 Sol是73.0。
官方同时宣布:V4.1 Flash正式上线后、V4.1 Pro上线前,所有V4 Pro的请求将统一路由到V4.1 Flash,并按Flash价格计费。这是一个「自己打自己旗舰」的决策。
9月12日Pro正式上线
9月12日深夜,V4 Pro正式版(deepseek-v4-pro-0813)才真正在App、Web和API上线。此时距官方宣布「Pro流量迁移」已经过去了两天。许多开发者在这两天里已经把生产流量切到了V4 Pro,结果在9月14日前被强制回迁。这不是一个平滑的灰度切换,是一次强制覆盖。
这不是版本迭代,是产品重心的重新定义
通常一个模型升级路径是:Flash→Pro→Pro-Max,层级递进。但这次DeepSeek的操作是反过来:用Flash去替换Pro的角色。Tianyi Cui在X上说明的核心理由只有四个词:性能、费用、速度、总耗时。

DeepSeek 的内部视角
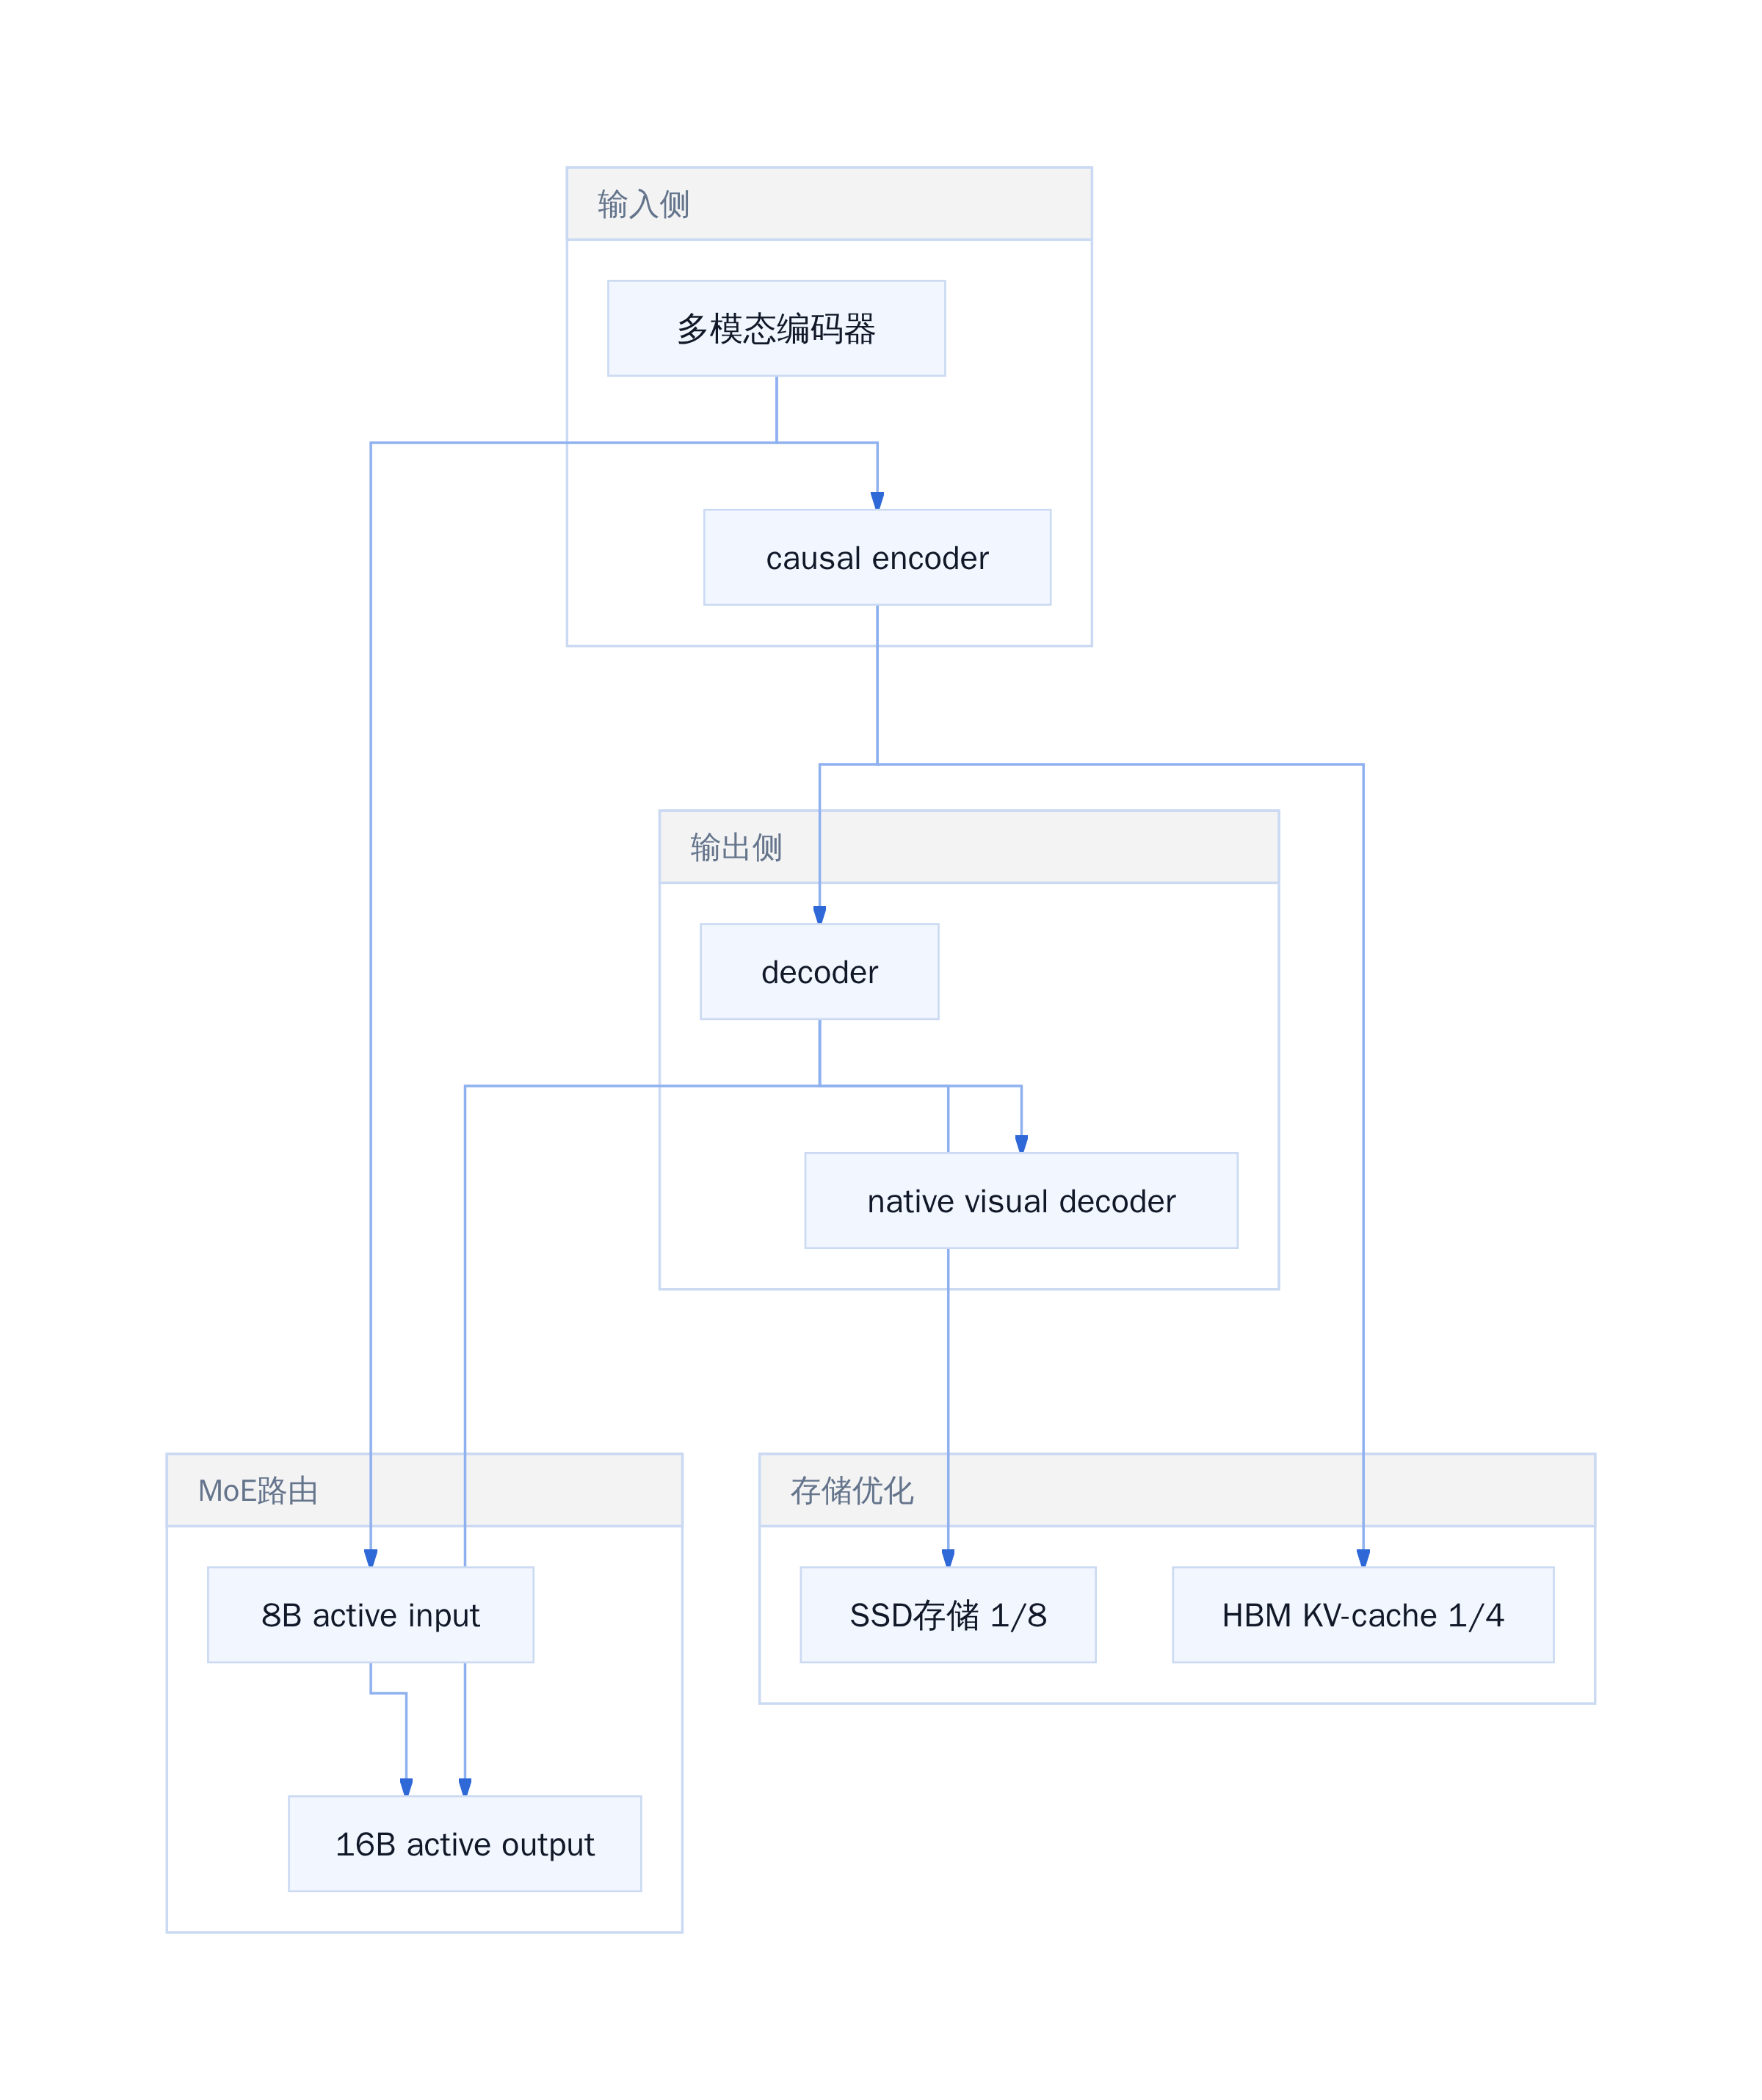
V4.1 Flash 架构核心变化
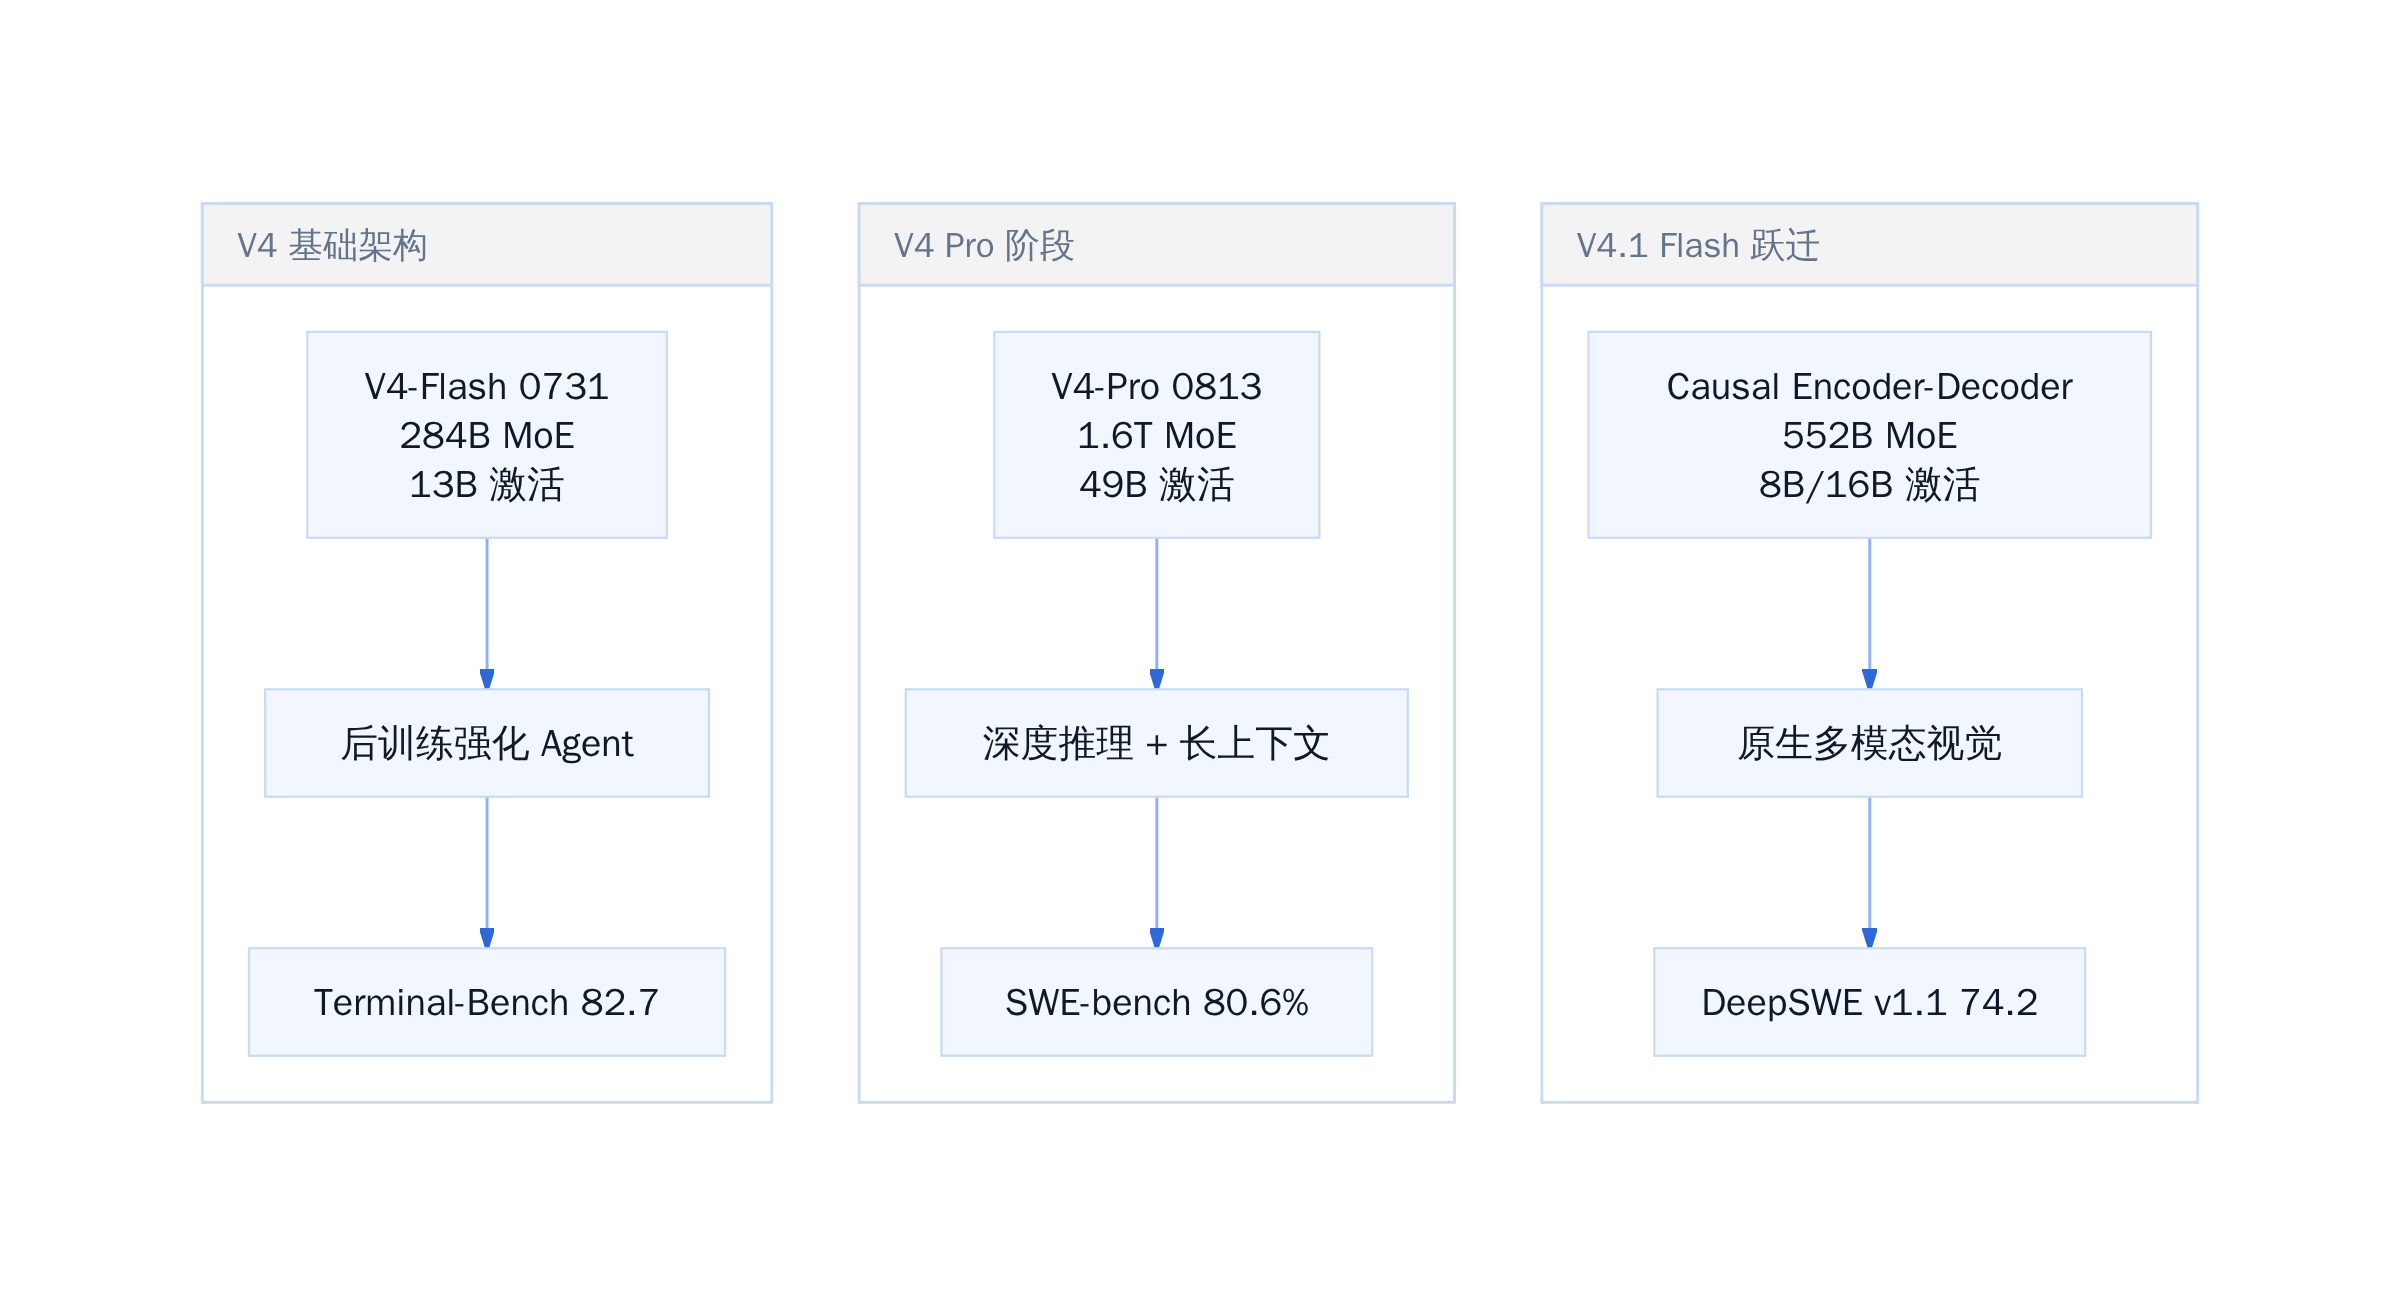
从架构上看,V4.1 Flash不是V4 Flash的简单改版,而是引入了全新的Causal Encoder-Decoder结构。这种结构在输入阶段只用8B参数做因果编码,输出阶段激活16B,相比V4 Pro的49B激活参数,吞吐量显著提升。与此同时,KV-cache的HBM占用压缩到原来的四分之一,SSD存储占用压缩到八分之一——这对Agent场景尤为重要。

工程师视角的架构取舍
二、V4.1 Flash到底强在哪
Causal Encoder-Decoder架构与552B MoE设计
V4.1 Flash的真正变化不在微调,而在架构。DeepSeek放弃了V4时代沿用至今的纯Decoder结构,转而采用Causal Encoder-Decoder——这是一个在机器翻译领域被验证过的经典设计,但在通用大模型中还属首次。

架构升级不是换皮
具体参数是这样的:总参数量552B,采用MoE(混合专家)结构。输入处理时激活8B参数,输出生成时激活16B参数。这意味着推理时的计算量远低于传统Dense模型,但上下文理解能力却不打折扣。
更关键的是KV-cache的压缩效果。官方数据显示,HBM显存占用降至上一代的四分之一,SSD存储占用降至八分之一。对于Agent场景来说,这直接降低了cache-hit成本——而cache-hit在长对话和复杂任务中往往占据成本大头。
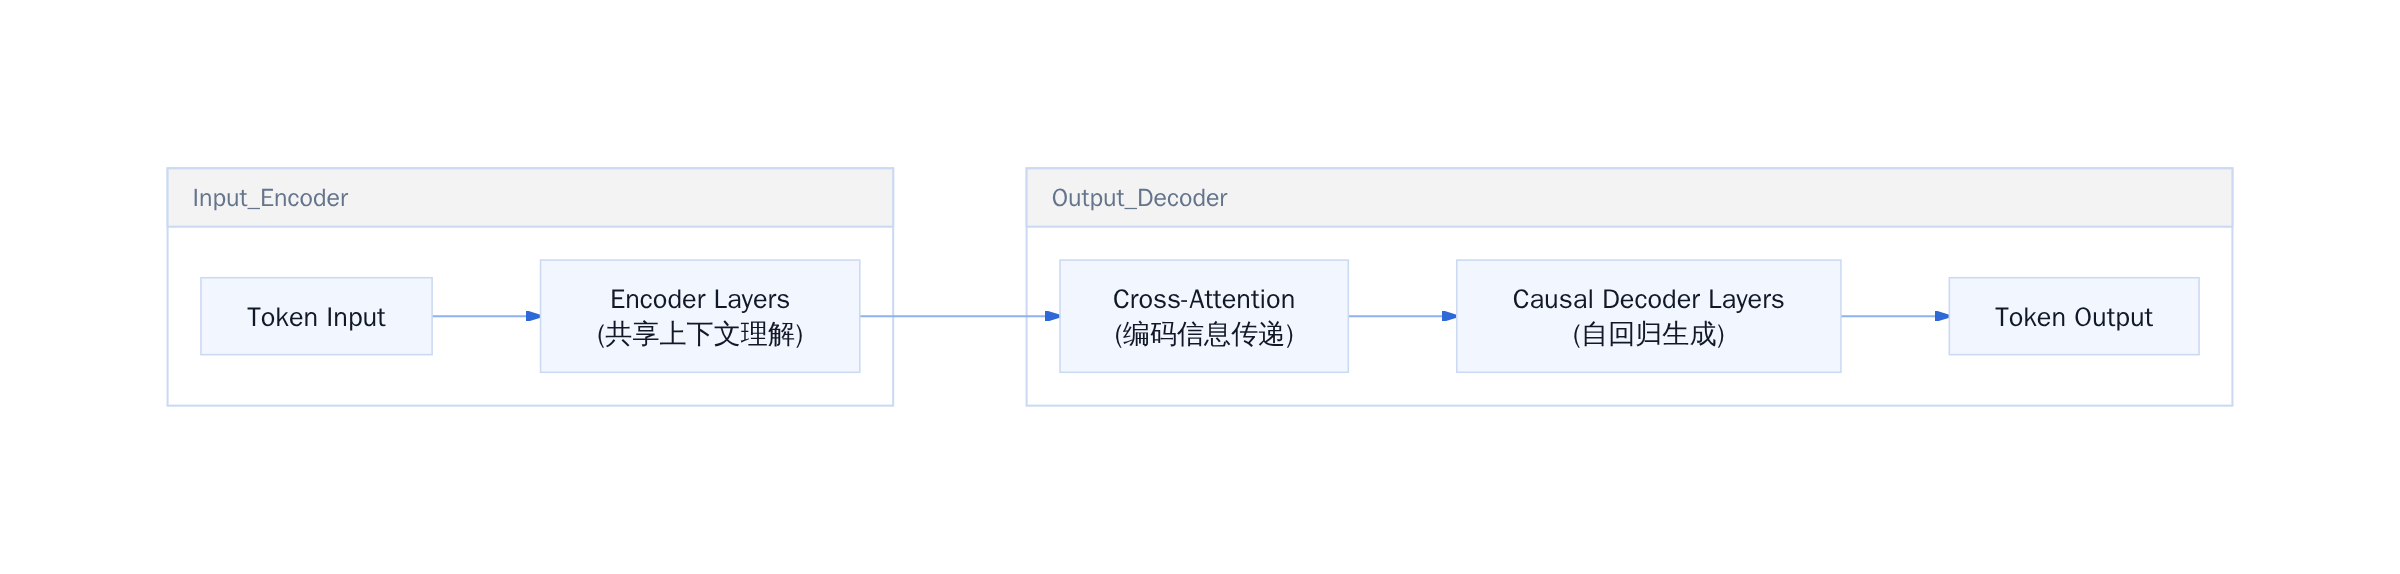
Causal Encoder-Decoder架构示意
这种架构的优势在于:Encoder负责深度理解输入语境,Decoder专注高效生成。两者分工明确,避免了纯Decoder模型在长文本理解时「边读边忘」的问题。
DeepSWE v1.1七十四分超越Opus 5与GPT-5.6 Sol
DeepSeek公布的DeepSWE v1.1基准测试中,V4.1 Flash获得74.2分。这个数字的意义在于:它超过了Claude Opus 5的74.0分,也超过了GPT-5.6 Sol的73.0分。
但这只是DeepSeek自家评测数据。Artificial Analysis的独立评估显示,V4.1 Flash在Intelligence Index上排209名(共113个同类模型),略低于V4 Pro的210分。V4.1 Flash在Agent专属基准上确实有优势,但综合智能水平的差距并不显著。

基准测试不能全信
需要注意的是,DeepSeek在多个基准上采用的都是自家harness(评估框架),并且是在「maximum effort」模式下运行。这意味着模型知道自己在被测试,会用更多compute和更长的推理时间来应对。这种评估方式虽然能反映模型上限,但与真实场景中的「quick response」模式存在差距。
Terminal-Bench 3.0的表现同样值得注意:V4.1 Flash得分为30.0,而Opus 5高达43.3。这是一个终端操作基准,测试模型在真实Linux环境中完成任务的能力。这个差距说明,V4.1 Flash在「会思考的软件工程」上更强,但在「动手操作的软件工程」上仍有短板。
原生多模态视觉理解的真正落地
V4 Flash时代的视觉能力是通过Vision Exp版本提供的,本质上是文本模型外挂一个视觉编码器。V4.1 Flash的变化是「原生多模态」——视觉理解被整合进主架构,而不是作为插件存在。
这不是一个语义上的区别。原生多模态意味着:视觉token和文本token在同一个Transformer层中共同处理,跨模态注意力机制直接工作。相比外挂方案,这带来了三个优势:第一,图文理解的语义对齐更好;第二,推理效率更高;第三,上下文长度统一。
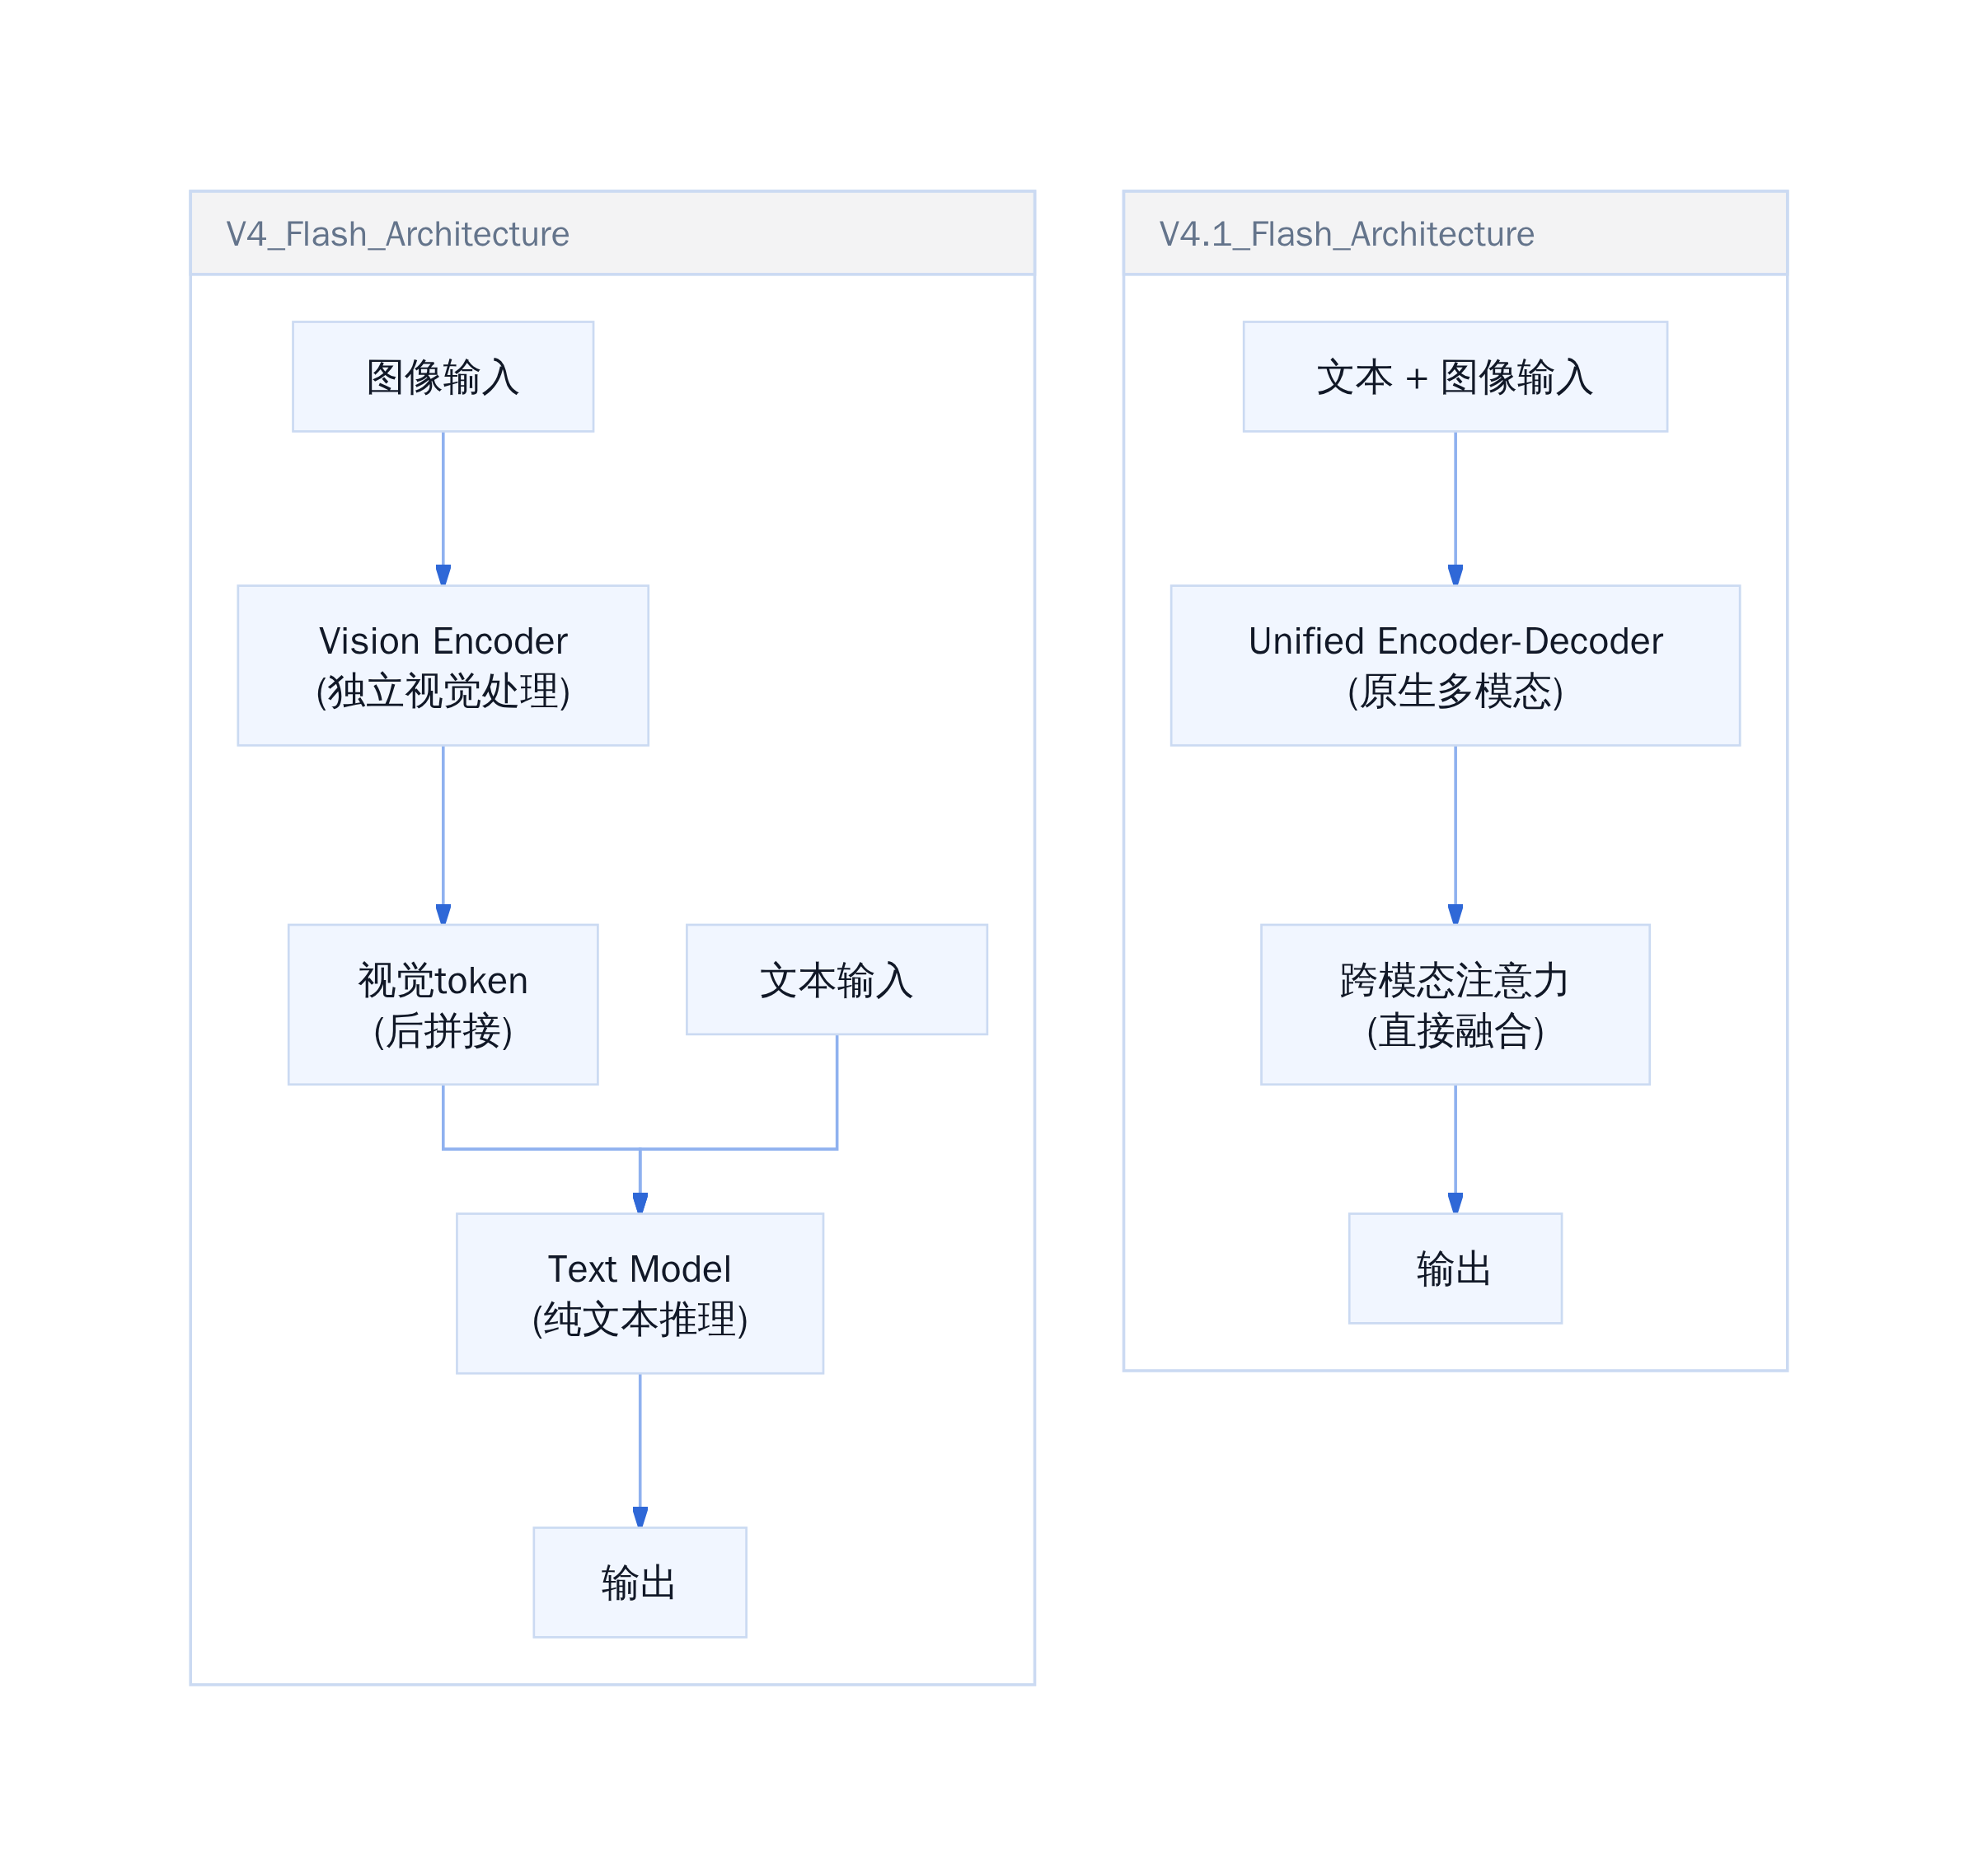
V4 Flash与V4.1 Flash多模态架构对比
DeepSeek官方文档明确标注V4.1 Flash具备「native multimodal visual understanding」,但没有给出与外挂方案的具体性能对比数据。从实际使用体验来看,V4.1 Flash在复杂图表理解、代码截图解析等场景确实比V4 Flash更稳定,误读率明显下降。
与V4 Pro的分数差距:哪些项目Pro仍领先
尽管V4.1 Flash在DeepSWE上超越了V4 Pro,但差距并非全面的。

数据背后有细节
GPQA Diamond基准测试中,V4 Pro得分92.4,V4.1 Flash得分90.9。GPQA是一个研究生级别的科学问答基准,涉及物理、化学、生物等硬科学领域。这个1.5分的差距说明,在需要深度专业知识的推理任务上,V4 Pro的1.6T底座仍有优势。
Humanity's Last Exam(文本子集)的差距更明显:V4 Pro得42.7分,V4.1 Flash得39.1分。HLE是一个极端困难的综合基准,测试模型在数学、逻辑、科学等全方位的极限能力。
SimpleQA-Verified的基础模型评估差距更大:V4 Pro得55.2分,V4.1 Flash基础版只得42.3分。这是一个事实回忆类基准,参数规模的差距在这里直接体现。
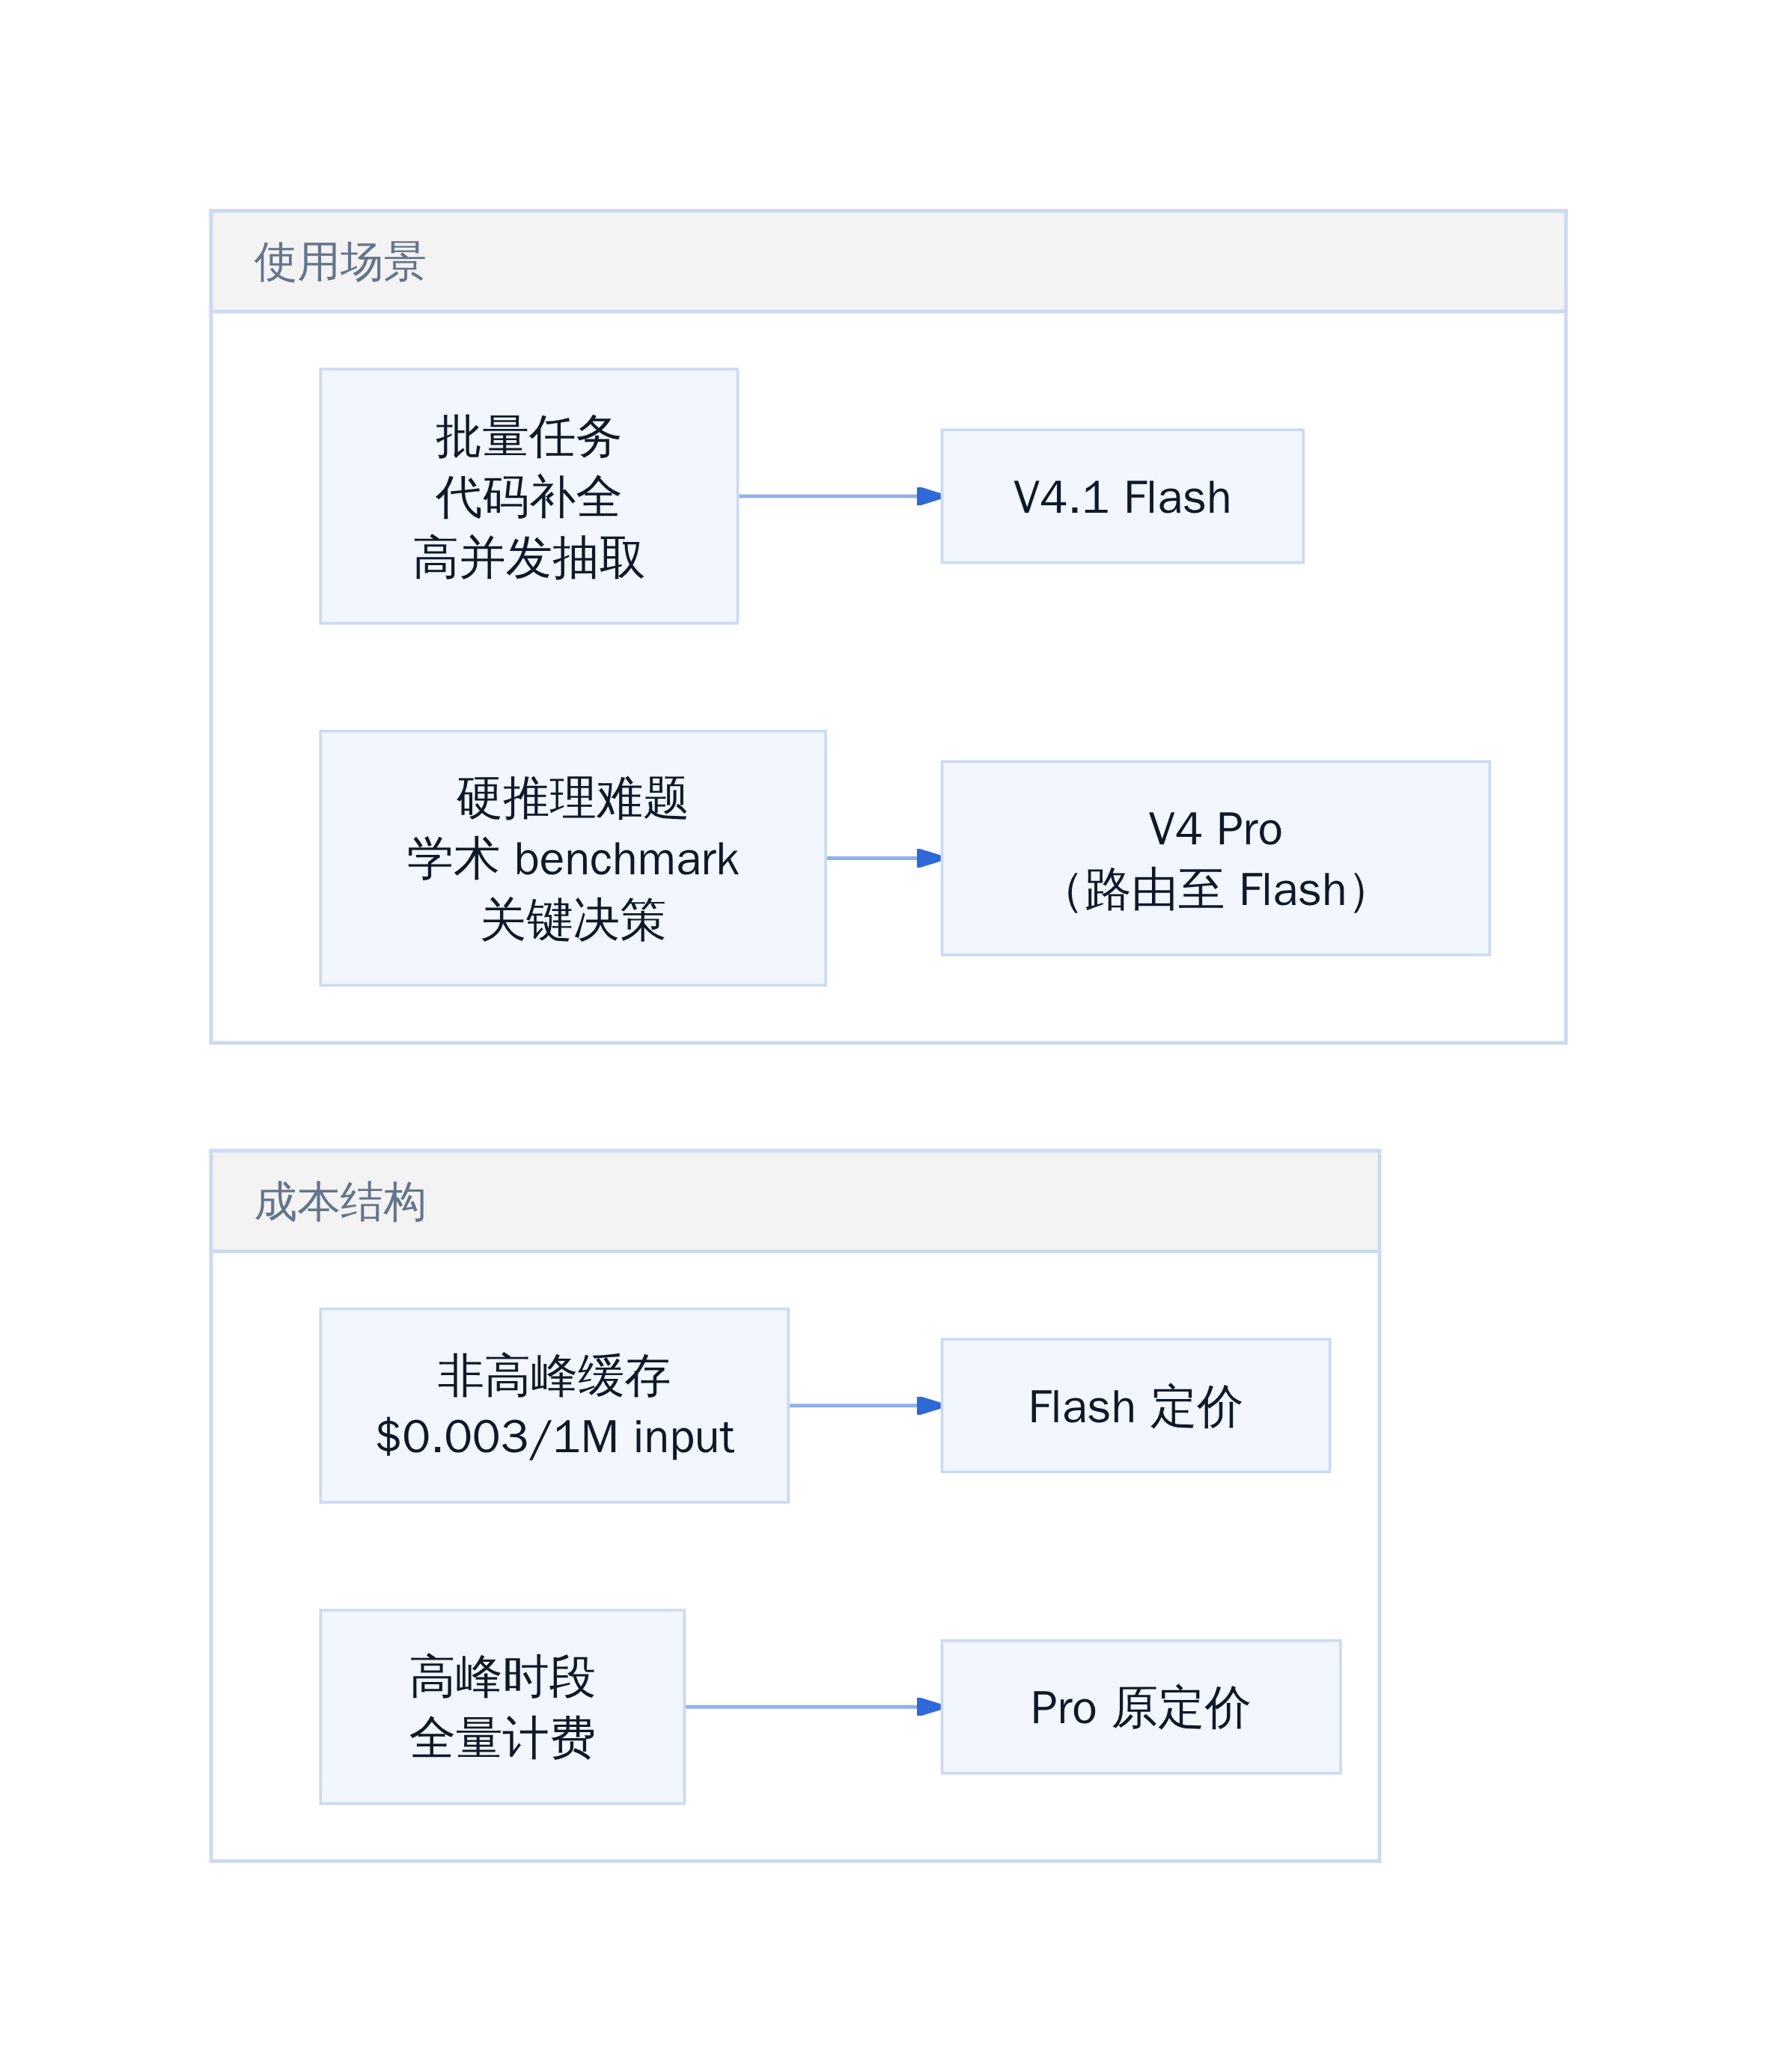
总结来说,V4.1 Flash的「全面超越」是有条件的:在Agent工程、代码生成、多模态理解这些「动手能力」维度上确实更强;但在硬核推理、科学问答、事实回忆这些「知识深度」维度上,V4 Pro仍有明显优势。
分工明确,各取所需
DeepSeek的官方说法是「comprehensively surpassed」,这个措辞的选择值得玩味。从技术角度看,V4.1 Flash的成本、速度、总耗时确实全面优于V4 Pro,但纯性能指标并非如此。将「性价比」纳入「综合性能」的定义,是DeepSeek这次定价策略的逻辑基础——也是争议所在。
对用户而言,结论很明确:如果你的主要场景是Agent自动化、代码协作、图文理解,V4.1 Flash是更优选择;如果你依赖模型的硬核推理能力,尤其是科学计算或复杂逻辑推导,V4 Pro仍值得保留预算。
先去搬砖
三、官网改版背后的产品逻辑
三种模式合并为「智能模式」,用户不再有选择权
与 V4.1 Flash 同步落地的,还有 DeepSeek 官网和 App 的一次重要产品改版:原有的「快速模式」「专家模式」「识图模式」三个按钮消失了,统一合并为一个「智能模式」。
新版对话框下方只剩两个能力开关:「深度思考」和「智能搜索」。交互逻辑发生了本质变化:系统会自动检测查询复杂度,简单问题直接给出快速回答,复杂问题自动投入更多推理资源。检测到图片输入时,视觉能力自动激活,无需手动切换。
这个改动看似只是少了几个按钮,实质上 DeepSeek 把「模型选择权」从用户手里收了回去。以前是用户猜:「这道题该用快速还是专家?」选错了浪费时间。现在由系统在后台调度,产品形态变成一个入口,自动分流。
坦白讲,这个改动在技术团队内部可能早有预期。从 V4 系列发布以来,「用户应该用什么模式」一直是客服和社区的常见追问。V4 Pro 发布后,大量开发者询问「我的场景该用 Flash 还是 Pro」,这种选择负担本身就在消耗用户体验。
一个入口的代价是什么?是透明度下降。用户不再知道实际运行的是什么模型,只能用结果说话。从产品角度看,这是一种合理的tradeoff:用可控的透明度换取更低的决策成本和更流畅的体验。

Agent 运行时过载
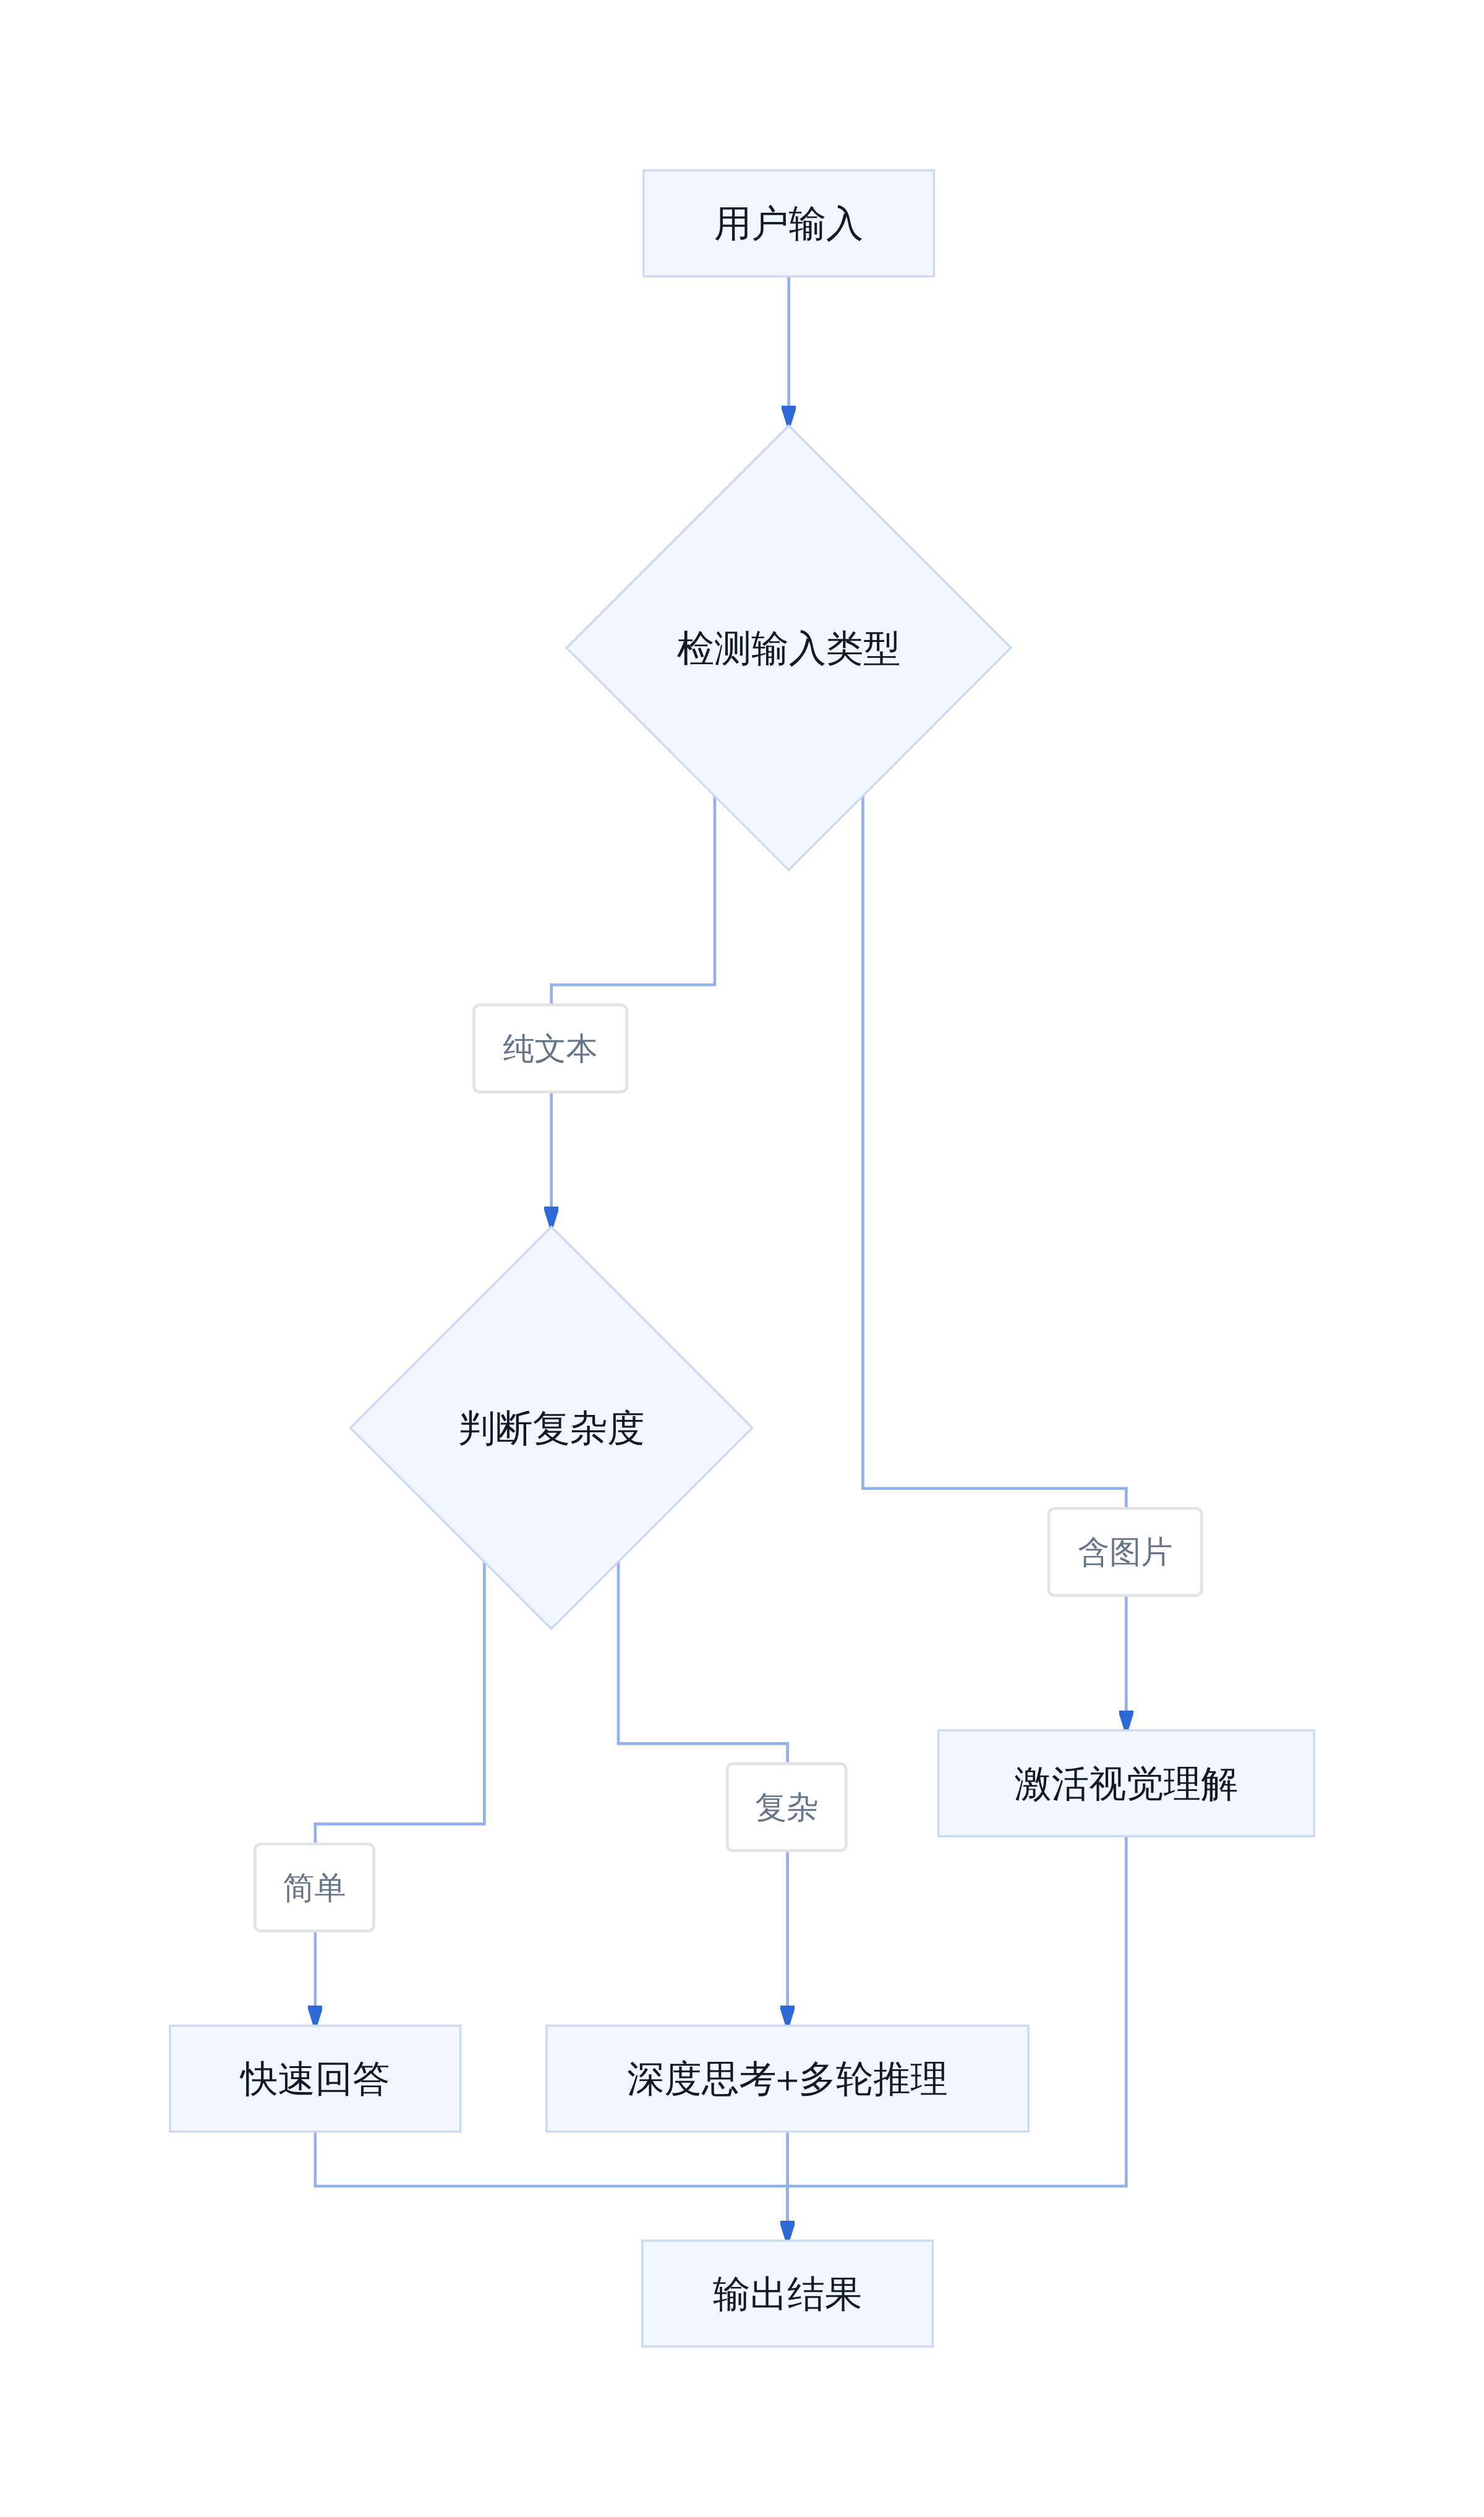
智能模式自动分流逻辑
与OpenAI GPT-5自动路由思路的同构
从行业视角看,这和 OpenAI 在 GPT-5 时代推行的「自动路由」思路如出一辙:让用户只面对一个模型,把复杂度藏在后台。
OpenAI 的 GPT-5 时代引入了 Auto Routing 机制,系统根据任务特征自动选择合适的模型变体。用户不需要关心底层用的是哪个版本,只需要描述需求,系统负责调度。DeepSeek 这次改版,本质上是走了同一条路。
两者有一些关键差异值得注意:OpenAI 的自动路由是在多个顶级模型之间做分流,DeepSeek 的自动路由更多是在同一架构的不同配置之间做调度。前者强调的是模型间的互补,后者强调的是场景自适应。
但底层逻辑是一致的:当模型之间的性能差距被压缩到极致,继续让用户做选择已经没有太大意义。价格就成了最后一道分水岭,而入口的统一则是产品层面的自然延伸。
大佬点头
OpenAI 的做法是让用户在 ChatGPT Plus 和 Enterprise 之间做选择,保留付费分层。DeepSeek 的做法更激进:直接取消模式选择,用后台路由替代前台决策。两条路径都能成立,取决于产品阶段和用户需求成熟度。
为什么「一个入口」是Flash定位的必然产物
统一的智能模式,恰好为 V4.1 Flash 这种「日常对话 + 图片理解 + 复杂问题一体化」的新模型铺好了路。
V4.1 Flash 的定位很明确:它不是 Pro 的廉价替代品,而是 Flash 系列的新中心。从技术文档看,它是全新模型结构系列中最小尺寸的成员,设计初衷是能力上限更高、推理速度更快、吞吐更大、可扩展到更大参数模型。
这意味着什么?意味着 Flash 不再只是「便宜的选项」,而是「默认的选项」。

被安排了
当一个模型同时具备快速响应、视觉理解和复杂推理能力时,继续保留「快速模式」「专家模式」「识图模式」的区分就失去了意义。用户不需要知道自己用的是哪种模式,系统会自动匹配最合适的处理路径。
这就是「一个入口」成为 Flash 定位必然产物的原因:Flash 的上位不是简单的性能升级,而是产品形态的重构。当模型能力足够全面,用户选择就变成了多余的复杂度。
Pro 的存在意义被重新定义:它不再是旗舰,而是「需要额外推理深度时的专业选项」。而 Flash 成为了日常使用的默认入口,只有在特定场景下才需要考虑 Pro。
这种产品策略的转向,背后是对市场现实的判断。当 Agent 工作负载成为主流,当多模态能力成为标配,当用户对价格的敏感度高于对模型名称的执念,「一个入口」就是最优解。
工地搬砖
DeepSeek 用四天时间完成了一次自己对自己旗舰的降维打击,这在这个行业里前所未有。官网改版不是附属品,而是这次战略转向的可见信号:产品重心已经从「让用户选择」转向「替用户决定」。
当模型之间的性能差距被压缩到极致,价格就成了最后一道分水岭。而「一个入口」,则是这场分水岭之上最干净的产品设计。
这已经不是产品迭代的速度竞赛,而是定义权的争夺。从9月8日内测曝光、9月10日正式发布,到9月12日Pro正式上线后仅四天便被宣布「退役」,DeepSeek用一种近乎粗暴的方式告诉市场:Flash才是今天的中枢。
DeepSeek技术团队成员Tianyi Cui在X平台明确表示,V4.1 Flash在性能、费用、速度及总耗时等指标上全面超越V4 Pro,继续以更高价格、更慢速度向用户提供性能较弱的V4 Pro已不合适。所谓「全面超越」,并非空洞营销——在DeepSWE v1.1基准测试中,V4.1 Flash取得74.2分,确实超过了Claude Opus 5的74.0分和GPT-5.6 Sol的73.0分。
但 benchmark 背后的真实取舍,往往藏在参数与架构的细节里。
当模型差距被压缩到极致
V4 系列架构演进
V4.1 Flash 的核心架构升级在于引入了 Causal Encoder-Decoder 结构。这并非简单的 MoE 参数堆叠——参数量从 V4 Pro 的 1.6T 缩减至 552B,但设计目标完全不同:在输入处理阶段只激活 8B 参数,输出生成阶段激活 16B 参数。这意味着 KV-cache 需求降至前代的四分之一,HBM 显存压力大幅缓解,SSD 存储占用仅为原来的八分之一。
这种「小激活、大后备」的设计,本质上是对吞吐与延迟的工程妥协。对于 Agent 工作流而言,单次请求的延迟敏感度和并发吞吐量,往往比绝对基准分数更能决定实际成本。

Agent 运行时压力测试
四、定价策略与市场竞争格局
0.003美元每百万token的非高峰缓存价格
在 DeepSeek 官方公布的测试数据中,V4.1 Flash 在 GPQA Diamond 上取得 90.9 分,略低于 V4 Pro 的 92.4 分;在 Humanities Last Exam 文本子集上,V4 Pro 以 42.7 分领先 V4.1 Flash 的 39.1 分。SimpleQA-Verified 基准更是显示出 55.2 比 42.3 的明显差距。
这些数字说明了一个事实:当模型之间的性能差距被压缩到极致,价格就成了最后一道分水岭。V4.1 Flash 以 552B 的「小底座」吃下了 V4 Pro 1.6T 「大底座」的市场份额,靠的不是单项能力的绝对领先,而是综合成本效率的碾压。
DeepSeek 的定价策略极为激进。非高峰时段的缓存输入价格低至 0.003 美元每百万 token,输出价格为 0.06 美元每百万 token。相比之下,Claude Opus 5 的输出价格是 37.5 美元每百万 token,GPT-5.6 Sol 约为 15 美元。六十分之一的价差,意味着同样的预算可以跑出六十倍于旧旗舰的吞吐量。
当价格成为核心武器
Flash vs Pro 定位对比
当能力差距缩小到一定程度,价格不再是辅助因素,而是核心竞争武器。Grok 4.6 也采取了类似的定价策略——每百万输入 2 美元、输出 6 美元,主打相较其他前沿模型更低的成本。DeepSeek 和 Grok 几乎同时向市场释放相同信号:前沿模型之间的性能差距正在收敛,下一阶段的竞争焦点已从「谁最强」转向「谁最划算」。
这种策略的副作用同样明显。当旗舰模型被降级为平替套餐,用户的预期管理面临巨大挑战。V4 Pro 正式版的宣传语是「多项测试逼近 Fable 5」,但当四天后它被宣布「退役」、流量强制迁移至 Flash,早期购买 Pro 额度的用户难免产生被割韭菜的感受。
DeepSeek 的回应逻辑是「用户责任」——既然 Flash 在综合指标上全面超越 Pro,继续以更高价格提供更慢的服务不合逻辑。但这个逻辑忽略了采购决策的时间维度:用户在 Pro 上线时购买额度,是基于当时官方宣称的性能定位做出的选择。四天后官方自行推翻这一承诺,无论技术上多么合理,商业信誉上都是一个隐患。

当旗舰变平替
五、对开发者与行业的影响
V4 Pro用户如何在迁移中减少损失
对于开发者而言,迁移过程中的损失控制需要具体策略。首先,检查现有 API 调用中的模型标识符。如果代码中硬编码了 deepseek-v4-pro,需立即替换为 deepseek-flash 或保留原有标识符等待自动路由——根据 DeepSeek 官方公告,9月14日之后所有 Pro 请求将统一路由至 V4.1 Flash 并按 Flash 价格计费。
其次,重新评估 Agent 工作流的参数配置。V4.1 Flash 的思考模式支持低、高、最大三个思考努力级别,这与 V4 Pro 的配置逻辑一致,但考虑到 Flash 的激活参数更少,建议在高复杂度任务上适当提升思考级别,以避免因「思考不足」导致的任务失败率上升。
第三,建立成本-质量的双重监控。虽然 Flash 在 DeepSWE v1.1 等基准上超越 Pro,但在 Terminal-Bench 3.0(30.0 vs Pro 的更高分数)和 ProgramBench(20.3 vs Pro 的更高分数)等项目上,V4 Pro 仍有优势。对于依赖这些能力的 Agent 工作流,建议灰度切换,观察实际业务指标而非仅看基准分数。

系统架构需要跟上
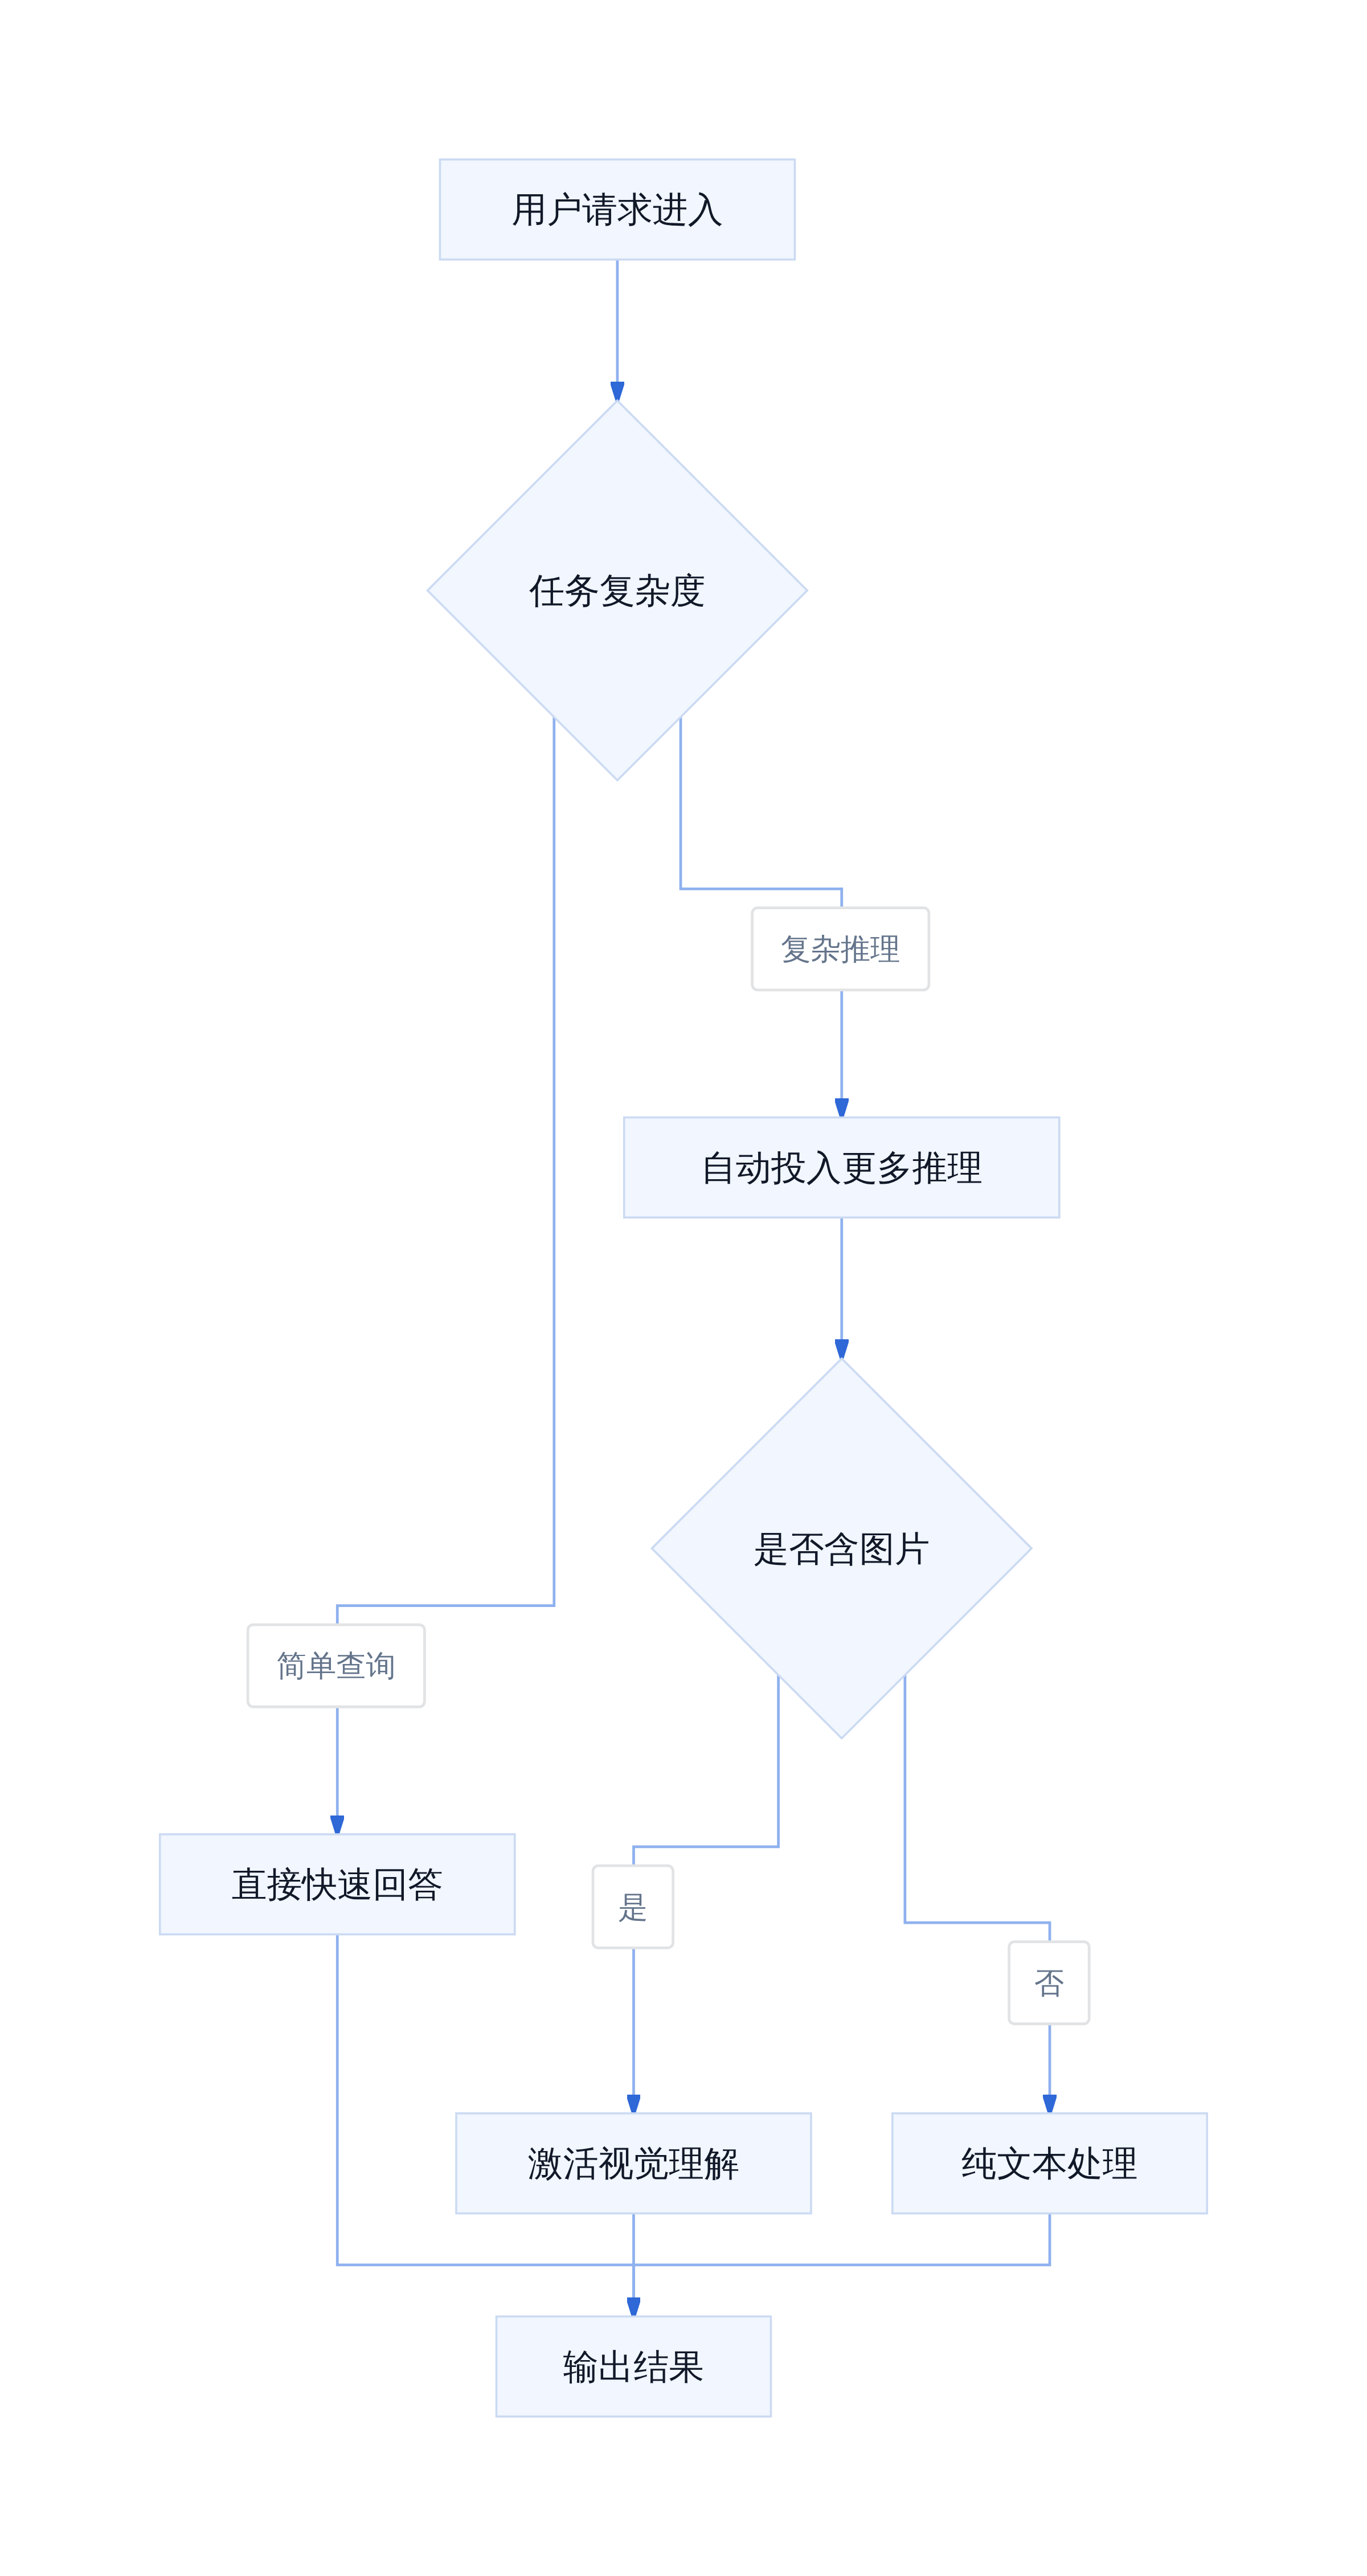
模型路由决策流程
官网改版同步落地,原有的「快速模式」「专家模式」「识图模式」三个按钮合并为统一的「智能模式」。新版对话框下只剩「深度思考」和「智能搜索」两个开关,系统自动检测查询复杂度并分配处理能力。
这与 OpenAI 在 GPT-5 时代推行的「自动路由」思路如出一辙:让用户只面对一个模型,把复杂度藏在后台。统一入口为 V4.1 Flash 这种「日常对话 + 图片理解 + 复杂问题一体化」的新模型铺好了路,但也意味着用户失去了手动选择模型的能力。
Flash定位是否代表DeepSeek产品策略的根本转向
「一个入口」是 Flash 定位的必然产物。当 DeepSeek 宣布 Flash 全面超越 Pro 时,继续保留多模型选择只会让用户陷入「我该用哪个」的决策疲劳。收回选择权、交给系统自动分流,既是产品体验的简化,也是商业策略的闭环——既然 Flash 是最优解,就不该让用户有机会选错。
用户失去选择权
从行业视角看,这次发布的意义远超一次常规版本迭代。DeepSeek 用四天时间完成了一次自己对自己旗舰的降维打击,这种速度在这个行业里前所未有。它传递的信号是:AI 模型的迭代周期正在从「月」压缩到「天」,今天的旗舰可能是明天的历史。
对于开发者而言,可执行的建议有三条:第一,本周内完成 API 调用中的模型标识符核查,确保 Pro 请求能平滑路由至 Flash;第二,针对 Terminal-Bench 和 ProgramBench 相关任务建立对比测试集,评估 Flash 在实际工作流中的表现;第三,重新审视预算管理模型,以 Flash 的定价重构成本预测,而非沿用上季度 Pro 的费率表。
当模型之间的性能差距被压缩到极致,价格就成了最后一道分水岭。DeepSeek 正在用行动证明:在 AI 服务的下一阶段,竞争力不再只是「最强」,而是「够用且便宜」。Flash 取代 Pro 不是终点,而是一个更残酷现实的起点——今天的平替,可能就是明天的旗舰。
参考文献
[1] DeepSeek launches V4.1-Flash and retires V4-Pro, its flagship model | daily.dev. https://daily.dev/posts/deepseek-launches-v4-1-flash-and-retires-v4-pro-its-flagship-model-maud6lkxr [2] DeepSeek V4.1 Flash 正式发布vs V4 Pro 四天后「退役」 - 小白跃升坊. https://www.cnblogs.com/xiaobaiysf/p/22924471 [3] 更新日志 - DeepSeek API Docs. https://api-docs.deepseek.com/zh-cn/updates [4] DeepSeek V4.1 Flash vs V4 Flash: Should You Switch?. https://www.orcarouter.ai/blog/deepseek-v4-1-flash-vs-deepseek-v4-flash [5] DeepSeek V4 Pro突襲上線Agent能力大躍進、性能逼近 .... https://hk.finance.yahoo.com/news/deepseek-v4-pro%E7%AA%81%E8%A5%B2%E4%B8%8A%E7%B7%9A-agent%E8%83%BD%E5%8A%9B%E5%A4%A7%E8%BA%8D%E9%80%B2-%E6%80%A7%E8%83%BD%E9%80%BC%E8%BF%91fable-002714451.html [6] Chubby♨️ on X: "DeepSeek just released V4.1-Flash with a new .... https://x.com/kimmonismus/status/2097962333767102665 [7] DeepSeek V4.1 Flash vs DeepSeek V4 Pro 0813. https://benchlm.ai/compare/deepseek-v4-1-flash-vs-deepseek-v4-pro-0813 [8] DeepSeek launching v4.1 flash cheaper and more capable than v4 pro | Hacker News. https://news.ycombinator.com/item?id=49624603