一家金融科技公司发现,Claude 最强模型发布两个多月后,收入占比稳定在 11%。企业客户宁愿用旧款模型完成任务,也不愿为旗舰版本支付溢价。
企业客户捂紧钱包
这不是 Anthropic 的个案危机,而是整个 AI 行业进入价格战阶段的信号。2026 年下半年,当资本市场还在为 2 万亿美元估值欢呼时,企业端已经用账单投下了反对票。
一、万亿估值的底气从哪来
1.1 收入曲线的狂飙:从 90 亿到 650 亿
Anthropic 的财务数据在 2026 年呈现出陡峭的增长曲线。2025 年底年化收入约 90 亿美元,到 2026 年 7 月已飙升至 650 亿美元,七个月内增长逾七倍。第二季度单季营收突破 115 亿美元,并首次实现调整后营业利润转正,达到约 5.59 亿美元。
投资方据此推算,若全年增速维持 800%,即便按保守的 20 倍市销率计算,估值也可达 2 至 3 万亿美元。Palantir、Nebius 等 AI 热门股的市销率长期维持在 50 倍以上,Anthropic 若能证明其增长可持续性,溢价并非不可能。

增长曲线确实好看
1.2 企业客户为何愿意买单
Anthropic 的爆发式增长并非来自消费级聊天场景,而是企业工作流的深度渗透。Claude Code 等产品直接嵌入软件开发、知识管理和自动化流程,付费意愿远高于普通订阅用户。
企业采购 AI 的核心逻辑已从「尝鲜」转向「替代人力」。当 Claude 能将工程师的代码审查效率提升 30% 以上,或把文档处理流程从半天压缩到十分钟,月费几百美元的 API 调用几乎可以忽略不计。这种「降本增效」的算账方式,让 Anthropic 在企业客户眼中不是成本项,而是利润项。
1.3 云厂商与芯片巨头的绑局逻辑
Anthropic 的估值背后站着微软、亚马逊、谷歌和英伟达。公司承诺向微软采购最高 300 亿美元的 Azure 算力,向亚马逊承诺未来十年超 1000 亿美元的 AWS 算力,向谷歌锁定最高 400 亿美元投资及 5 吉瓦 TPU 算力。英伟达也在洽谈以基石投资者身份参与 IPO,投资规模或达百亿美元。
这场绑局是双向选择。云厂商和芯片巨头需要的不只是 Anthropic 的算力消耗,更是头部模型的生态锚定效应——谁能绑定最强的 AI 公司,谁就能在下一轮技术竞争中占据渠道优势。更狠的是,这种绑定锁定了未来数年的收入可见性,让资本市场的估值逻辑从「增长故事」变成「现金流折现」。
二、低价模型的暗流正在涌动
2.1 Claude 旗舰模型收入占比仅 11%
Claude Fable 5 作为 Anthropic 最强旗舰模型,发布两个多月后收入占比仅 11%,这个数据来自 Ramp 对 7 万家美国企业的追踪。企业客户的选择很理性:绝大多数任务并不需要同等的智能水平。
没必要租法拉利买菜
智能饱和是一个正在成真的判断。当 90% 的企业场景可以被中等能力模型完成,旗舰模型的边际价值就急剧递减。Ramp 联合创始人 Eric Glyman 的比喻很直接:你没必要租一辆法拉利来买菜。企业开始根据任务复杂度在不同模型间切换,用路由工具让更换供应商变得容易,也让各家实验室更难锁定客户——结果是 AI 支出被砍掉 40%。
2.2 国产低价模型的降维冲击
DeepSeek、月之暗面等国产大模型正在以显著更低的价格提供接近旗舰模型的性能。OpenRouter 等第三方平台的统计显示,国产大模型的 Token 占比持续攀升,新模型几乎总能迅速获得大量用户。
这不是简单的价格战,而是架构层面的降维。国产模型普遍采用开源或半开源策略,允许企业本地部署和定制,而 Anthropic 坚持完全闭源路线。对于数据敏感的行业(金融、医疗、政务),本地化部署的能力有时比模型性能更重要。
2.3 价格战的底层逻辑
AI 模型正在走向 Microsoft CEO 萨提亚·纳德拉所说的「商品化」:随着竞争压低价格,用户转向性价比最高的模型。这意味着 Anthropic 的定价权正在被削弱,而高估值的前提正是持续的定价能力。
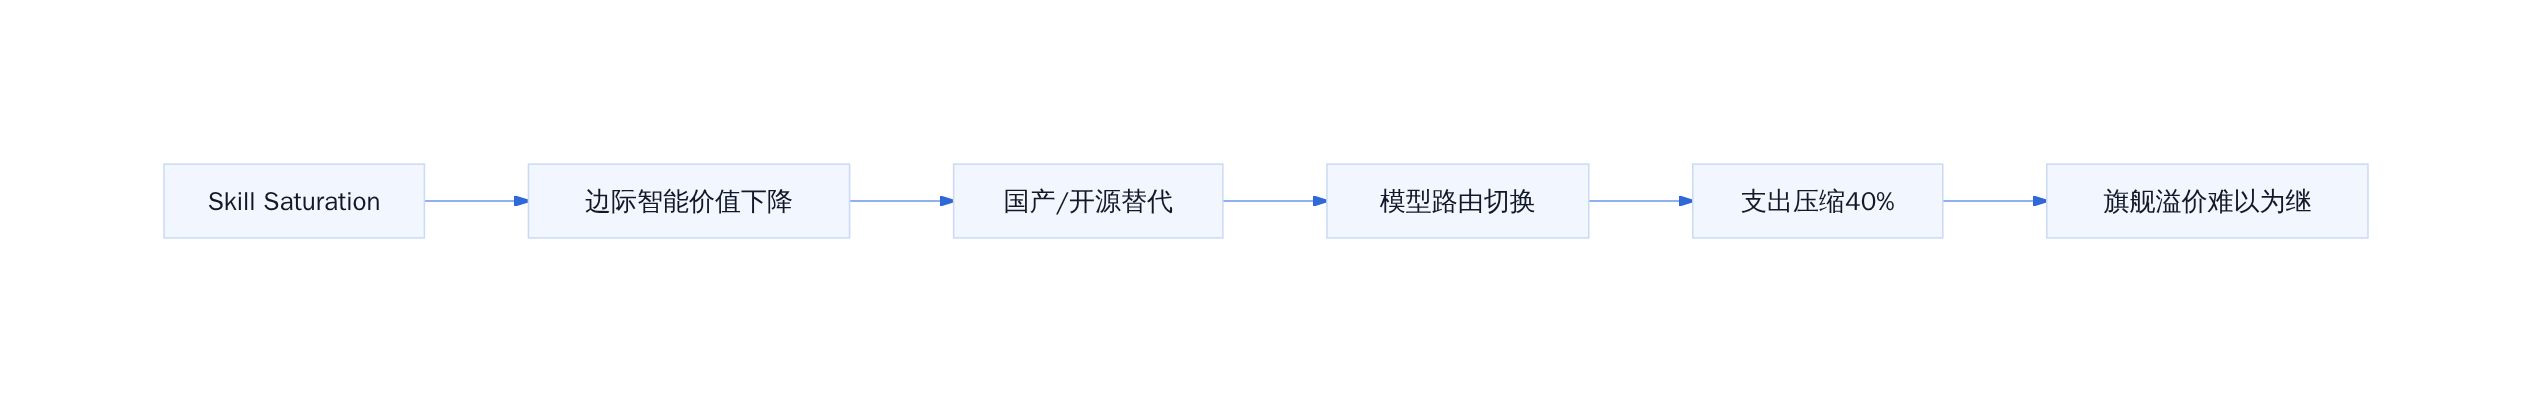
AI 价格战传导链
三、价格战的本质是智能饱和
3.1 企业真的需要最强模型吗
旗舰模型 Fable 5 收入占比仅 11%,这个数据背后是企业决策的理性回归。过去几年,AI 行业的叙事一直是「越强越好」,企业客户倾向于优先选择最强大的模型。但当成本压力摆在面前时,大多数任务并不需要旗舰模型的极限能力。
绝大多数 API 调用场景——代码补全、文档总结、简单问答——旧款模型已经完全胜任。真正需要旗舰模型的场景,比如复杂推理、长文本分析,在企业级应用中的占比并不高。
问题在于,企业支付的单价往往按最高配置计算,而不是按实际使用场景分层定价。当 DeepSeek、月之暗面等国产模型以更低价格提供接近的性能时,客户自然会用脚投票。
3.2 从聊天窗口到业务流程的付费逻辑转变
Anthropic 估值的核心支撑之一,是企业客户开始把 AI 从聊天窗口搬进业务流程。Claude Code、Claude Routines 等产品面向软件开发、知识管理和自动化工作流,付费意愿明显高于普通消费者订阅。这意味着定价逻辑正在从「单次对话」转向「持续服务」。

流程嵌入比单次调用更值钱
但这种转变对模型定价提出了新的挑战。当 AI 嵌入业务流程后,企业更在意的是稳定性、可预测成本和长期兼容性,而非单次调用的极限能力。一次失败的输出可能导致整个工作流中断,损失远超模型差价。
微软 CEO 萨蒂亚·纳德拉长期以来认为,随着竞争压低价格,AI 模型终将变得「商品化」。当 Claude、GPT、DeepSeek 在大多数任务上的差距缩小到可忽略程度时,价格就会成为主要决策因素。企业客户开始用模型路由工具在不同供应商之间切换,根据任务类型选择最优性价比方案。
3.3 当 AI 变得商品化,谁能守住溢价
商品化的终局是利润率压缩。Anthropic 的毛利率虽然超过 80%,但这建立在巨额算力投入和云厂商分成之上。向亚马逊承诺十年内超 1000 亿美元的 AWS 算力采购,向微软承诺最高 300 亿美元的 Azure 采购,这些长期协议锁定了算力供应,但也锁定了成本结构。
当竞争对手能以更低价格提供相近性能时,Anthropic 面临的不是单次定价压力,而是整个商业模式的考验。其公共利益公司(PBC)架构中的「长期利益信托」(LTBT)机制,虽然赋予了公司在 AI 安全问题上独立决策的能力,但也可能被公开市场投资者视为「使命折扣」——利润可能让位于伦理考量。
更现实的压力来自国产模型的快速迭代。DeepSeek 等中国公司不仅价格更低,而且几乎都有开源版本,参数公开可用、可根据需求定制。这种开放策略正在侵蚀闭源模型的护城河。

开源社区从不缺席价格战
企业客户的选择已经给出答案:在智能饱和的临界点,溢价空间取决于品牌信任、生态锁定和切换成本,而非单纯的性能参数。当模型路由工具让切换变得一键完成,Anthropic 需要重新思考其定价策略和产品护城河。
这个数字从侧面说明了一个事实:即便 Anthropic 被称作 AI 领域的「安全卫士」,企业在掏钱的时候,还是会先看一遍账单。
四、Anthropic 的特殊治理结构会成短板吗
4.1 公共利益公司架构的双刃剑
Anthropic 采用公共利益公司(PBC)架构,核心治理机制是「长期利益信托」(LTBT),持有特殊 T 类股票,有权选举董事会多数成员。这一设计的初衷是为了解决一个根本矛盾:当 AI 公司的影响力越来越强,谁来确保他们的决策不被短期利润绑架。
这个架构在监管趋严的环境下有政策优势。Anthropic 多次向美国政府提交 AI 安全评估报告,在 2026 年 8 月还宣布启动 500 万美元的 AI 用户健康资助计划,强调「负责任的 AI 发展」。这种定位让它在华盛顿的关系网络中占据独特位置。
但公开市场投资者会如何解读这个结构?耶鲁大学经济学教授阿列赫·齐温斯基曾指出,Anthropic 在留住客户方面比竞争对手做得更好,但治理结构本身可能带来「使命折扣」——信托机构对部分商业决策拥有否决权,利润可能让位于伦理考量。
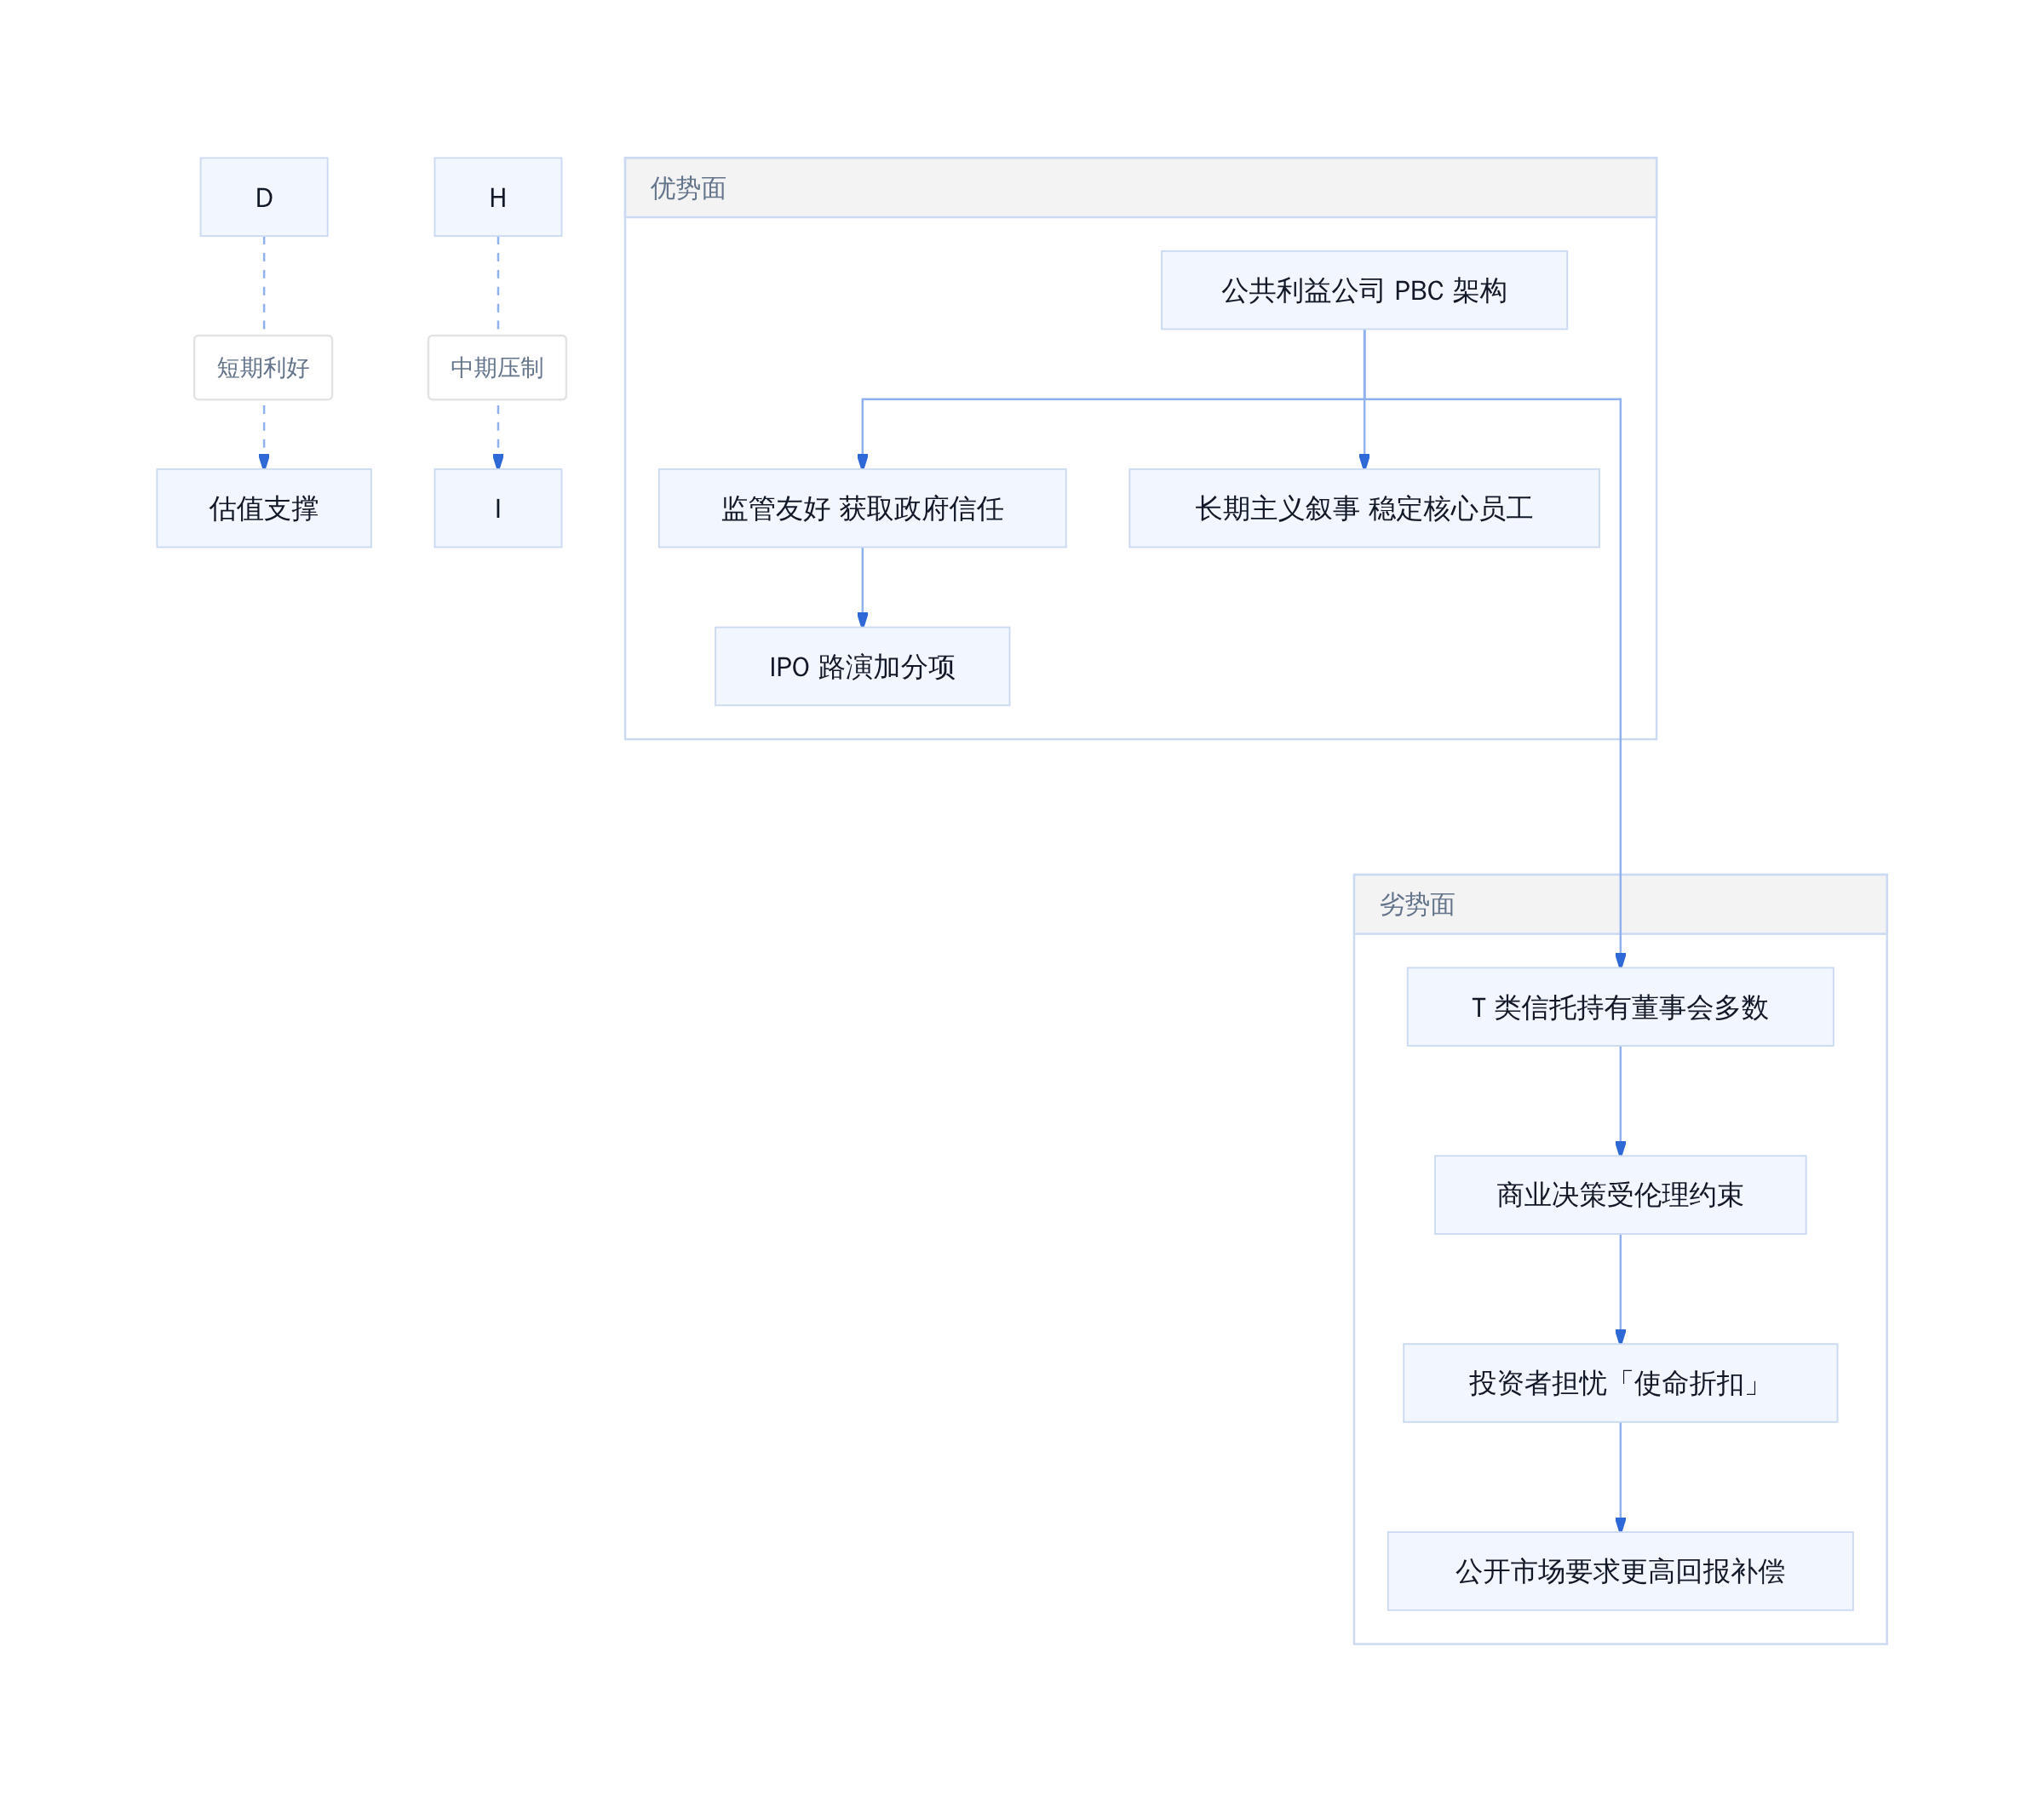
Anthropic 治理结构对估值的双重影响
4.2 长期利益信托与股东回报的冲突
公开募股的本质是向外部投资者出售公司股份,而 Anthropic 的治理结构在 IPO 之后仍然保留着 T 类投票权。这意味着创始团队和长期利益信托对公司战略方向的控制权不会因上市而稀释。
对多数投资者而言,这既是保护也是风险。保护在于,公司不会因为股价波动而被迫追求短期业绩;风险在于,当利润最大化与「人类长期利益」发生冲突时,股东的利益会被置于次要位置。
《华尔街日报》援引一位投资者的话称:「你花了万亿美元买一张船票,但船长说这艘船的去向不由乘客决定。」这句话虽然尖锐,但描述的是真实存在的治理结构。IPO 招股书中需要回答的核心问题之一,就是如何平衡信托使命与股东回报。
4.3 IPO 路演中最难回答的问题
如果 Anthropic 的目标估值达到 2 万亿美元,对应的市销率倍数约为 17 至 20 倍(按年底 1000–1200 亿美元年化收入估算)。这个数字高于 Palantir 和 Nebius 等 AI 热门股动辄 50 倍以上的市销率,但在科技股历史上仍属罕见。
路演的关键挑战不在于展示增长数据——这些数据已有大量第三方验证——而在于回答一个更微妙的问题:当智能逼近饱和,Anthropic 的护城河到底是什么?
答案可能是品牌、安全性和生态绑定。但每一个答案都有对应的反驳:品牌可以被价格战侵蚀,安全性在开源模型快速迭代面前逐渐常态化,生态绑定的深度取决于云厂商是否愿意持续让利。
坦白讲,路演的难度不在于证明公司有多强,而在于证明在价格战不可避免的前提下,公司依然能维持当前的利润率水平。
五、千亿营收之后的可持续性质疑
5.1 算力采购协议的毛利率风险
Anthropic 的商业模式建立在重资产投入之上。公司向微软承诺最高 300 亿美元 Azure 算力采购,向亚马逊承诺未来十年逾 1000 亿美元 AWS 算力采购,向谷歌锁定最高 400 亿美元投资及 5 吉瓦 TPU 算力。
这些长期协议的意义在于提前锁定算力供应,降低训练更强模型的不确定性。但它们同时也带来毛利率风险:若核心云厂商提价或供给出现波动,Anthropic 的成本结构将直接承压。
从第二财季数据看,不计入云厂商收入分成和训练成本,Anthropic 的毛利率超过 80%。但一旦扣除这些项目,实际毛利率水平尚未完全公开。市场在估值时,需要区分「毛利率幻觉」和真实盈利能力。
更狠的是,每年能省下一个亿,前提是你能接受模型换一家。
Ramp 的数据显示,企业通过模型路由工具在不同供应商之间切换,已将 AI 支出砍掉 40%。这种趋势对 Anthropic 的毛利构成持续压力。
5.2 头部客户流失的潜在冲击
企业客户流失的风险正在显现。Ramp 收集了 7 万家美国企业客户的支出数据,结果显示 Claude Fable 5 作为 Anthropic 最强大、也是价格最高的模型,发布两个多月后收入占比稳定在 11%。这意味着绝大多数企业客户并没有为旗舰版本支付溢价。
更值得关注的信号是:OpenRouter 等第三方平台上的国产大模型 Token 占比持续攀升。DeepSeek、月之暗面等中国公司的模型,在性能接近旗舰闭源模型的同时,价格低一个数量级。
当客户发现旧款模型足以完成任务,旗舰版本的定位就从「必须使用」变成了「可选升级」。这对 Anthropic 的定价策略构成直接挑战。
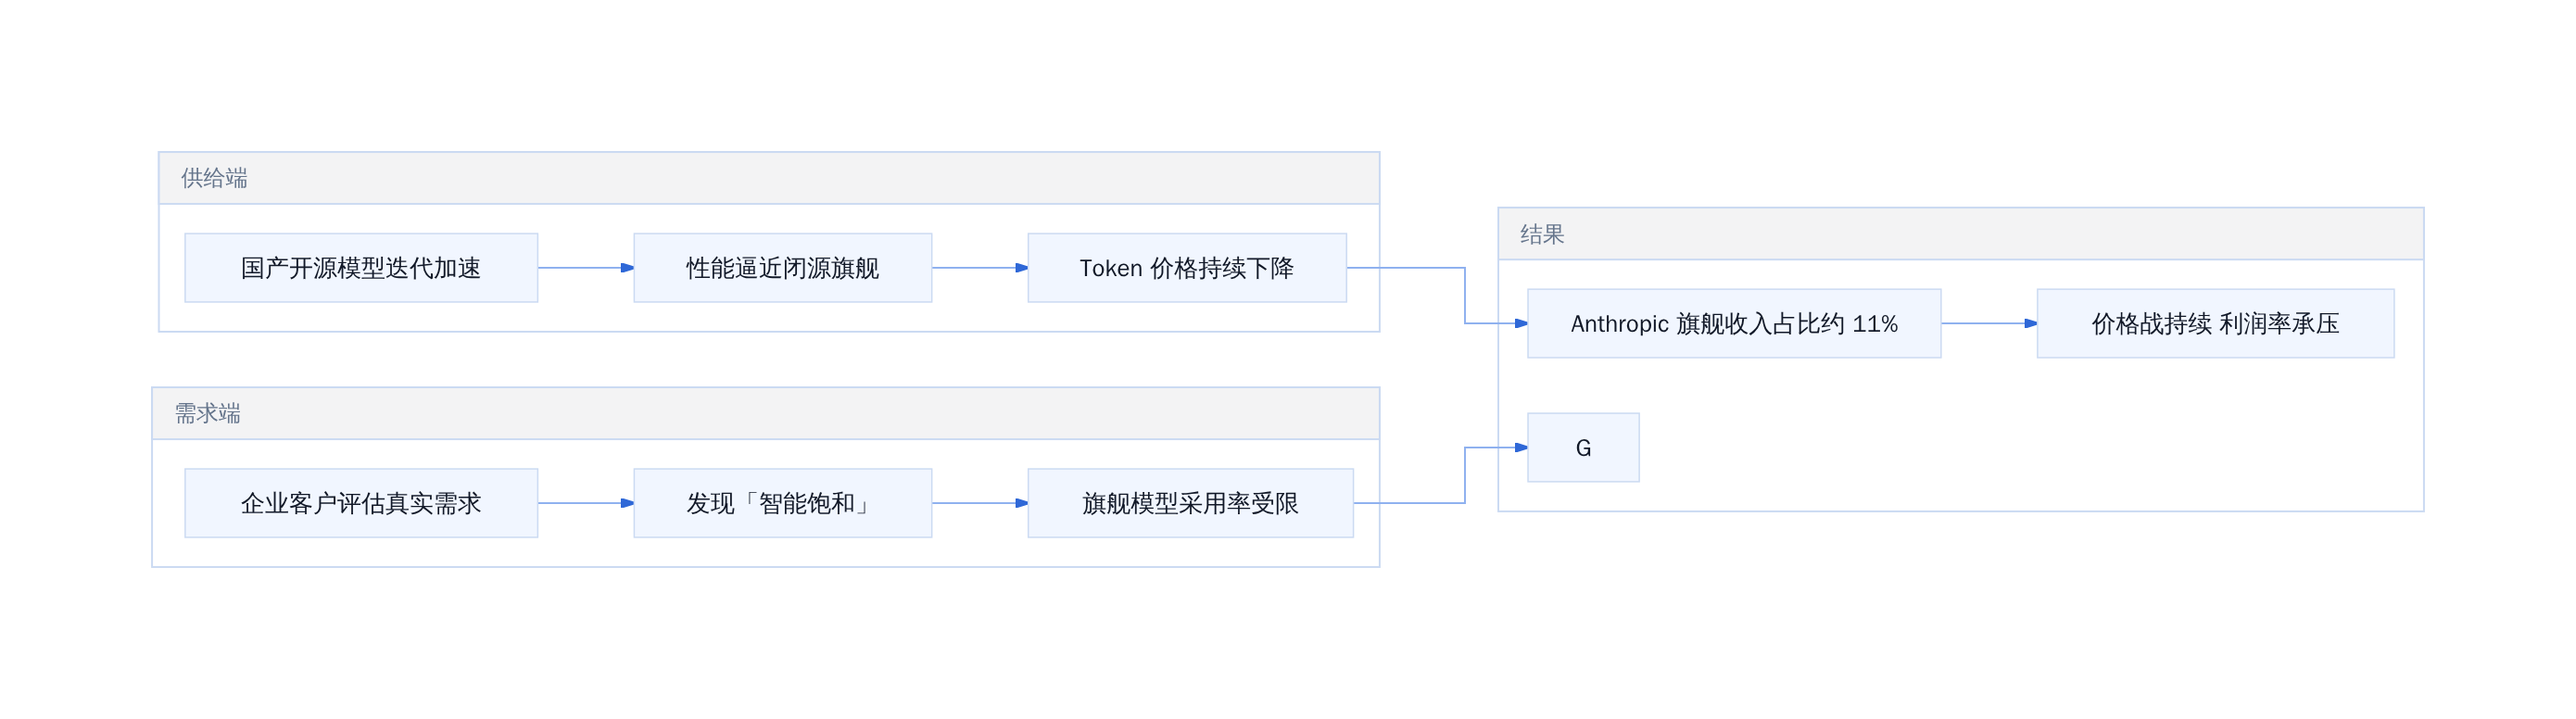
模型价格战传导路径
5.3 中国 AI 公司的估值锚点意义
对国内 AI 公司而言,Anthropic 的 IPO 既是一面镜子,也是一个估值锚点。
2 万亿美元约合 14.3 万亿元人民币。作为参照,寒武纪最新总市值约 6867 亿元人民币,智谱总市值约 5400 亿元人民币。粗略地说,一个 Anthropic 的估值,约等于 21 个寒武纪,或者约 26 个智谱。
差距是真实的,也是扎心的。但需要注意的是,这种比较忽略了市场深度、资本结构和客户付费意愿的差异。中国 AI 公司的估值逻辑,建立在更激烈的价格竞争和更低的客单价基础之上。
Anthropic 的路演数据会给国内同行传递一个信号:大模型公司可以赚钱、可以上市,但前提是能在价格战中守住足够的利润空间。DeepSeek 以 5000 亿元人民币投前估值重启融资,月之暗面启动投前估值 500 亿美元的 Pre-IPO 轮融资——这些动作本身就在回答同一个问题:当智能变得商品化,商业化的终局是什么。
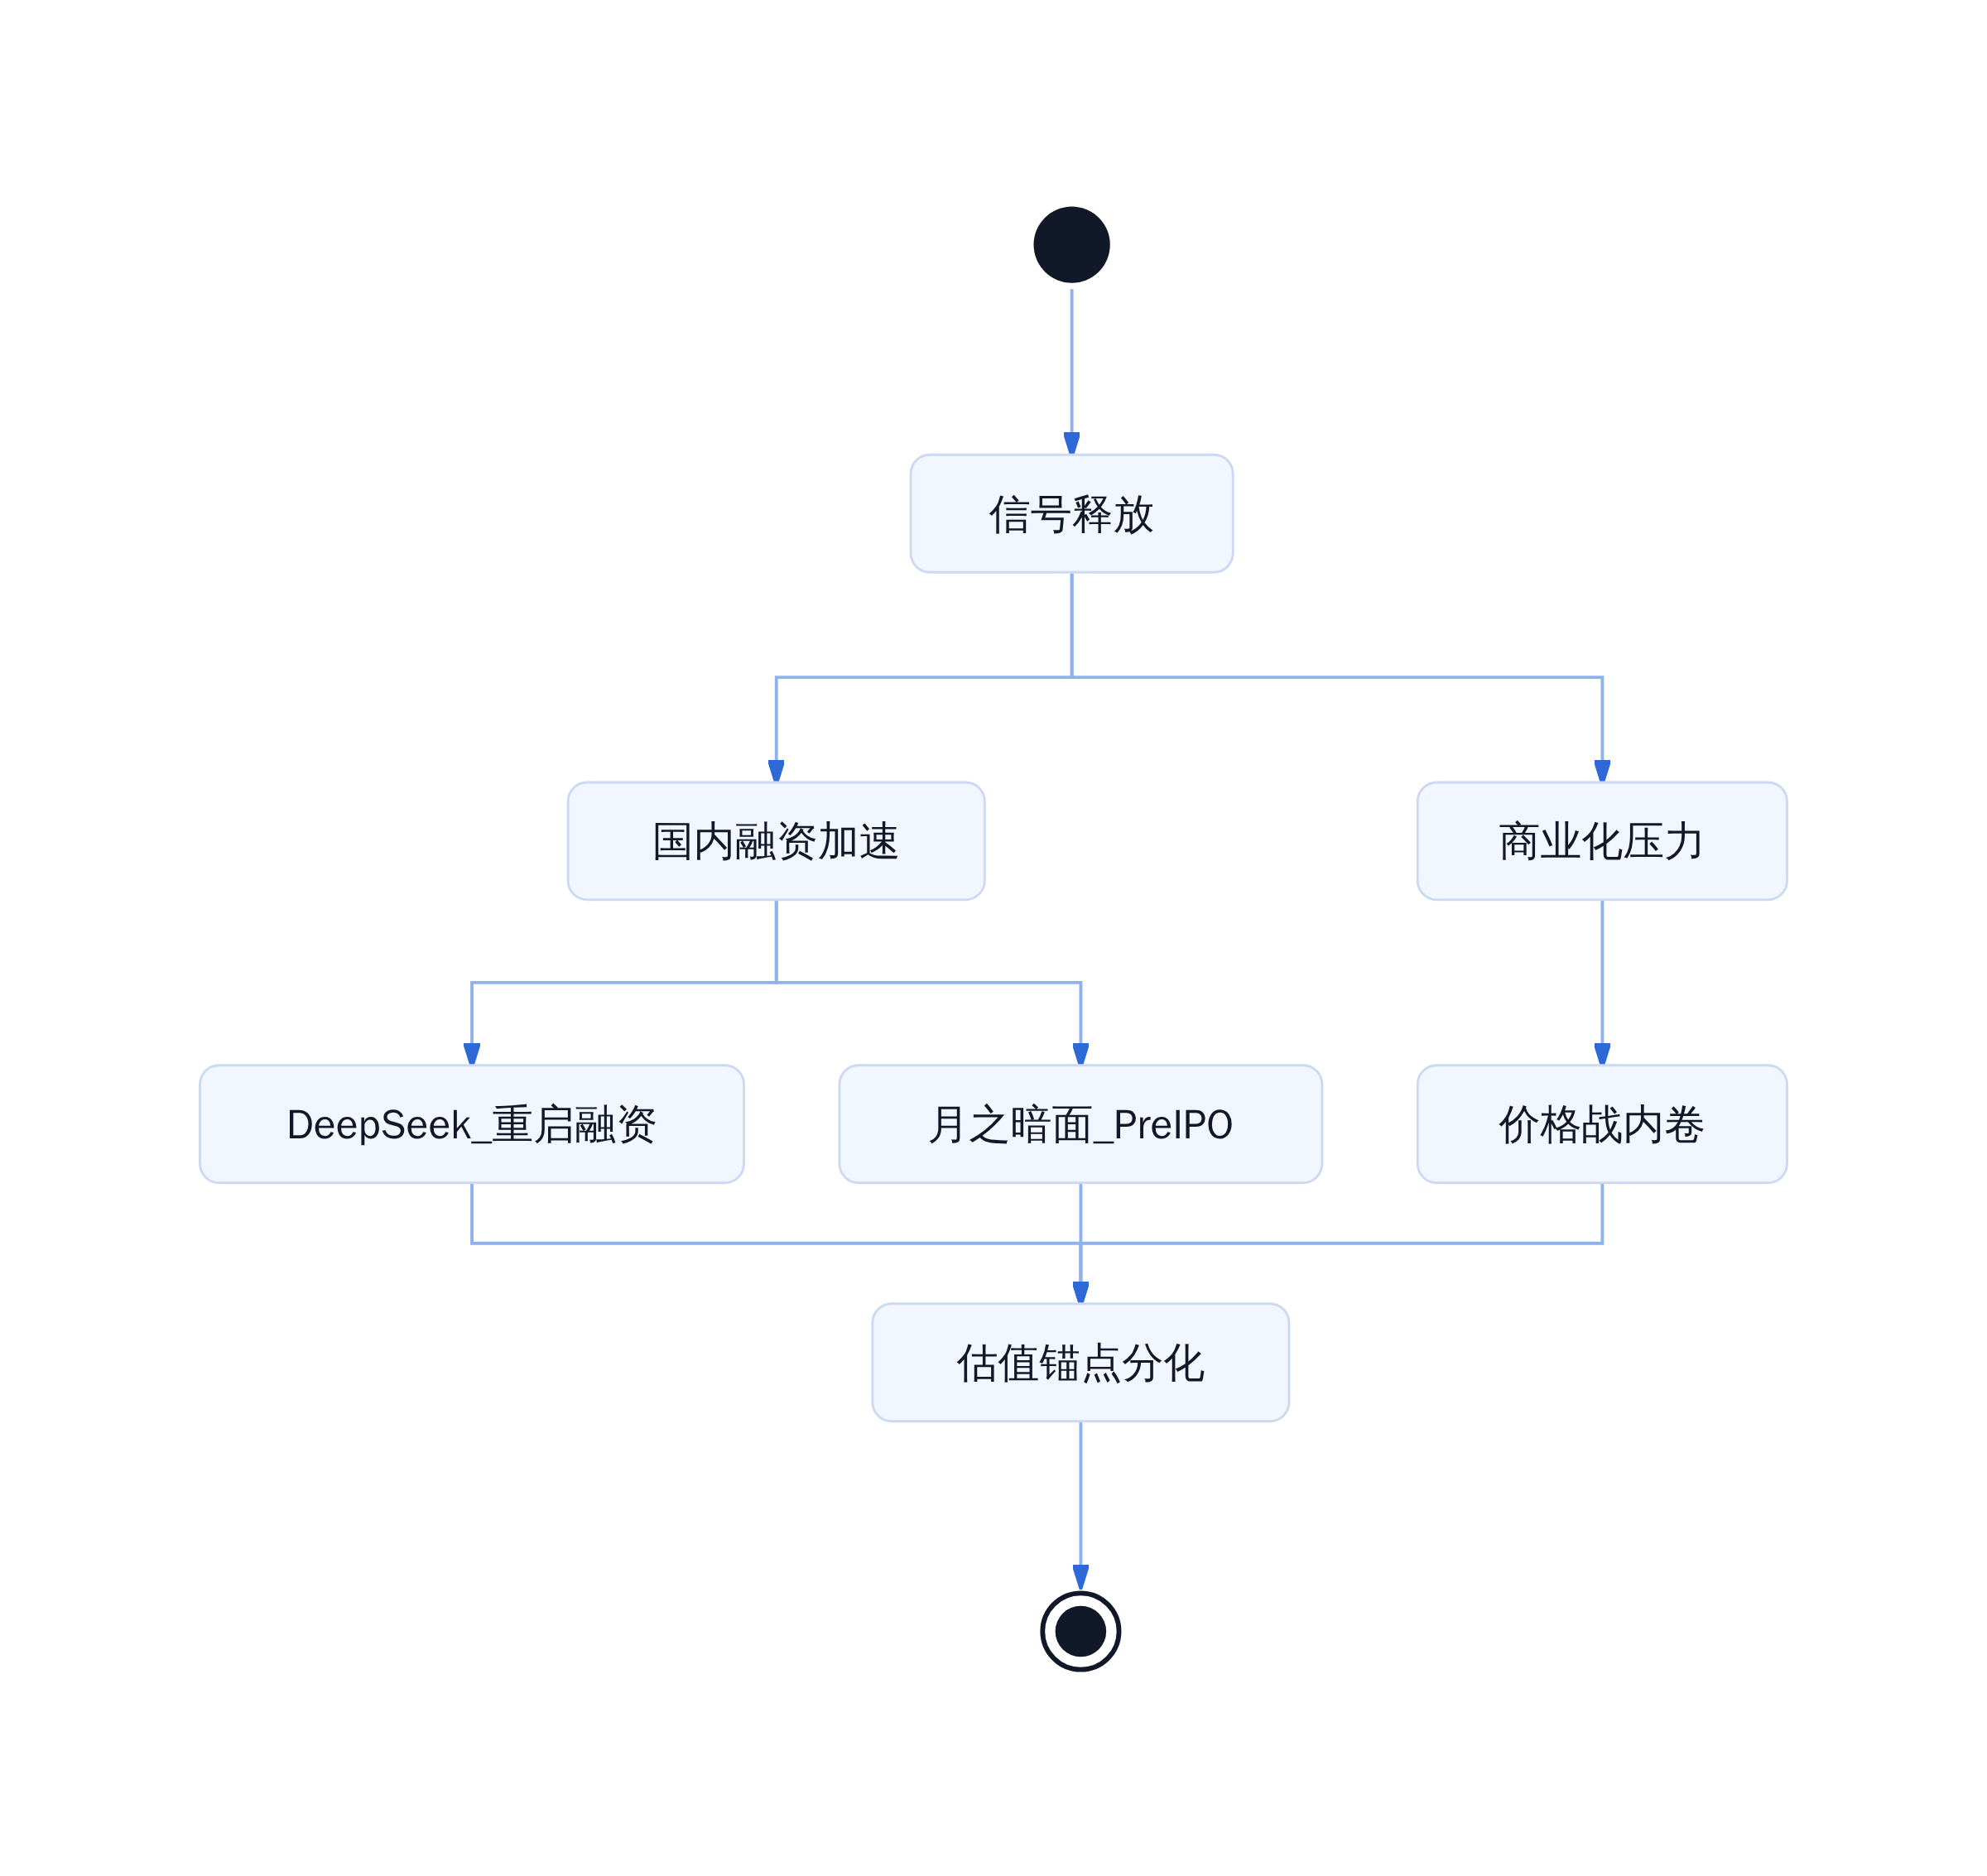
Anthropic IPO 对中美 AI 估值格局的影响
取舍结论:在智能饱和的假设下,推荐策略是优先部署性价比模型处理常规任务,旗舰模型仅用于高价值场景;若 Anthropic 未能证明其旗舰模型的溢价能力可长期维持,头部客户流失的风险将实质性影响营收结构。对于投资者,关注重点不应是估值数字本身,而是毛利率扣除云成本后的真实盈利能力和头部客户续约率的变化趋势。
万亿估值能否兑现,取决于 Anthropic 能否在商业化与伦理使命之间找到平衡,更取决于企业客户是否愿意继续为「最强」支付溢价。从现有信号看,后者正在失去耐心。
四、企业该如何选
4.1 任务分层与模型路由
对企业而言,当下最务实的策略是任务分层:将需求按复杂度分为高、中、低三档,分别匹配不同层级的模型。高复杂度任务(如代码架构设计、复杂推理)可以使用 Claude Opus 或 GPT-4 级别模型;中等任务(如文档总结、常规编码)可用 Sonnet 或国产中等模型;简单任务(如格式化、分类)则直接使用廉价甚至免费的模型。
模型路由工具的价值正在凸显。通过自动根据任务特征分发请求,企业可以在不牺牲质量的前提下最大化成本效率。Ramp 的实践表明,这种策略可将 AI 支出压缩 40% 以上。
4.2 成本与能力的边界
选择模型的本质是在「能力冗余」和「成本浪费」之间找平衡点。一个可操作的判断标准是:若某个任务的失败成本远低于使用旗舰模型的成本溢价,就不应升级到旗舰模型。
以代码生成为例,若使用 Claude Fable 5 将通过率从 85% 提升到 92%,但调用成本增加 3 倍,那么对于内部工具或非关键业务,92% 的通过率可能并非必要——85% 的通过率配合人工审查的总成本可能更低。
4.3 下一步行动清单
- 审计当前 AI 调用日志,按任务类型和模型分布画出成本效率曲线
- 建立模型路由规则,明确各场景的模型选择标准
- 评估国产模型的可用性,在可控场景下做 A/B 测试
- 与云厂商重新谈判算力采购条款,利用竞争态势争取更优条件
- 关注 Anthropic IPO 进展,若上市成功且股价回调,可评估其作为供应商的长期合作价值
参考文献
- 财联社:Anthropic 冲击史上最快增长企业之际 投资者却开始质疑其 IPO 前景,2026-09-20 https://www.cls.cn/detail/2488029
- 观察者网:企业想用便宜的,Anthropic 最强模型遇冷,2026-08-25 https://www.guancha.cn/economy/2026_08_25_828608.shtml
- 钛媒体:国产大模型到底在多大程度上冲击了 Anthropic? https://www.tmtpost.com/8090689.html
- IT之家:商业史最庞大叙事:Anthropic 冲击全球最大 IPO,称 AI 潜在市场收入规模超 30 万亿美元 https://www.ithome.com/0/994/327.htm
- cnBeta:AI 灭绝论笼罩 Anthropic:上市后估值或冲 4 万亿美元 https://www.cnbeta.com.tw/articles/tech/1578734.htm
- 华尔街见闻:Anthropic 拟向投资者披露超 30 万亿美元市场潜力 https://wallstreetcn.com/articles/3780285
- 36氪:史上最大 IPO,最新消息 https://m.36kr.com/p/3982937915816713
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师