最近一次代码评审,评审人反复追问的一个问题:这段论证里哪个变量是我真正验证过的,哪些只是读起来像那么回事。我愣了三秒才意识到,整段结论是上周用 Claude 生成的草稿直接贴进去的,我当时只做了语法层面的扫尾。
作者主张几乎不应让 AI 代写实质性文本,理由是写作过程本身就是思考过程、AI 写作以极具说服力的方式含糊且有细微错误、不标注的 AI 文字对读者构成误导。
写作本身就是思考过程
很多人把写作当成「把脑子里的想法倒出来」的动作,但心理学和认知科学的数据指向一个相反的结论:写作不是思考的出口,而是思考本身。
Eric Schwitzgebel 在论证里直接给出这个判断。当你用笔或键盘组织一个论点时,大脑被迫完成三件事:压缩混沌、暴露逻辑缺口、建立因果链。前两项只有在写下来的瞬间才会发生——你想不到的细节,写到一半会自己跳出来。
AI 代写的后果是,你跳过这个过程直接拿到成品。拿到的是「看起来像你想说的话」,但那个「像」字后面,是你没有经历过的论证路径。更准确地说,你得到的是模型的共识路径,不是你的思考路径。
写作本身就是思考过程
AI 的说服力陷阱:含糊而可信
为什么 AI 写出来的东西读起来没问题,甚至很流畅?因为大模型的训练目标决定了它天然倾向「安全表述」——既不会过于激进,也不会逻辑断裂。
Joe Stech 用信息论术语做过一个可验证的预测:如果用 KL 散度测量模型输出与某语料库之间的分布距离,模型的输出分布会更接近企业通信的中心,而不是文学或高变异性的表达。这不是审美偏好,是数学约束。
Erich Grunewald 用自己的实验佐证这一点。他让 Claude 写一篇关于「AI 芯片走私」的段落,逐句检查后发现至少三处实质性错误:一个不存在的政策文件编号、一个被张冠李戴的执法行动名称、一个逻辑上不可能的时间线组合。这些信息在提示词里完全没有出现,是模型基于概率分布生成的「plausible」细节。
更危险的是,这些错误和正确信息混合在一起,形成一种不可靠的模糊性——读者没有专业能力逐句核实,于是整体可信度被错误细节稀释。
六大技术缺陷
幻觉的系统性而非偶发性
很多人把 AI 幻觉当作偶发 bug,可以靠提示词规避。这是误判。
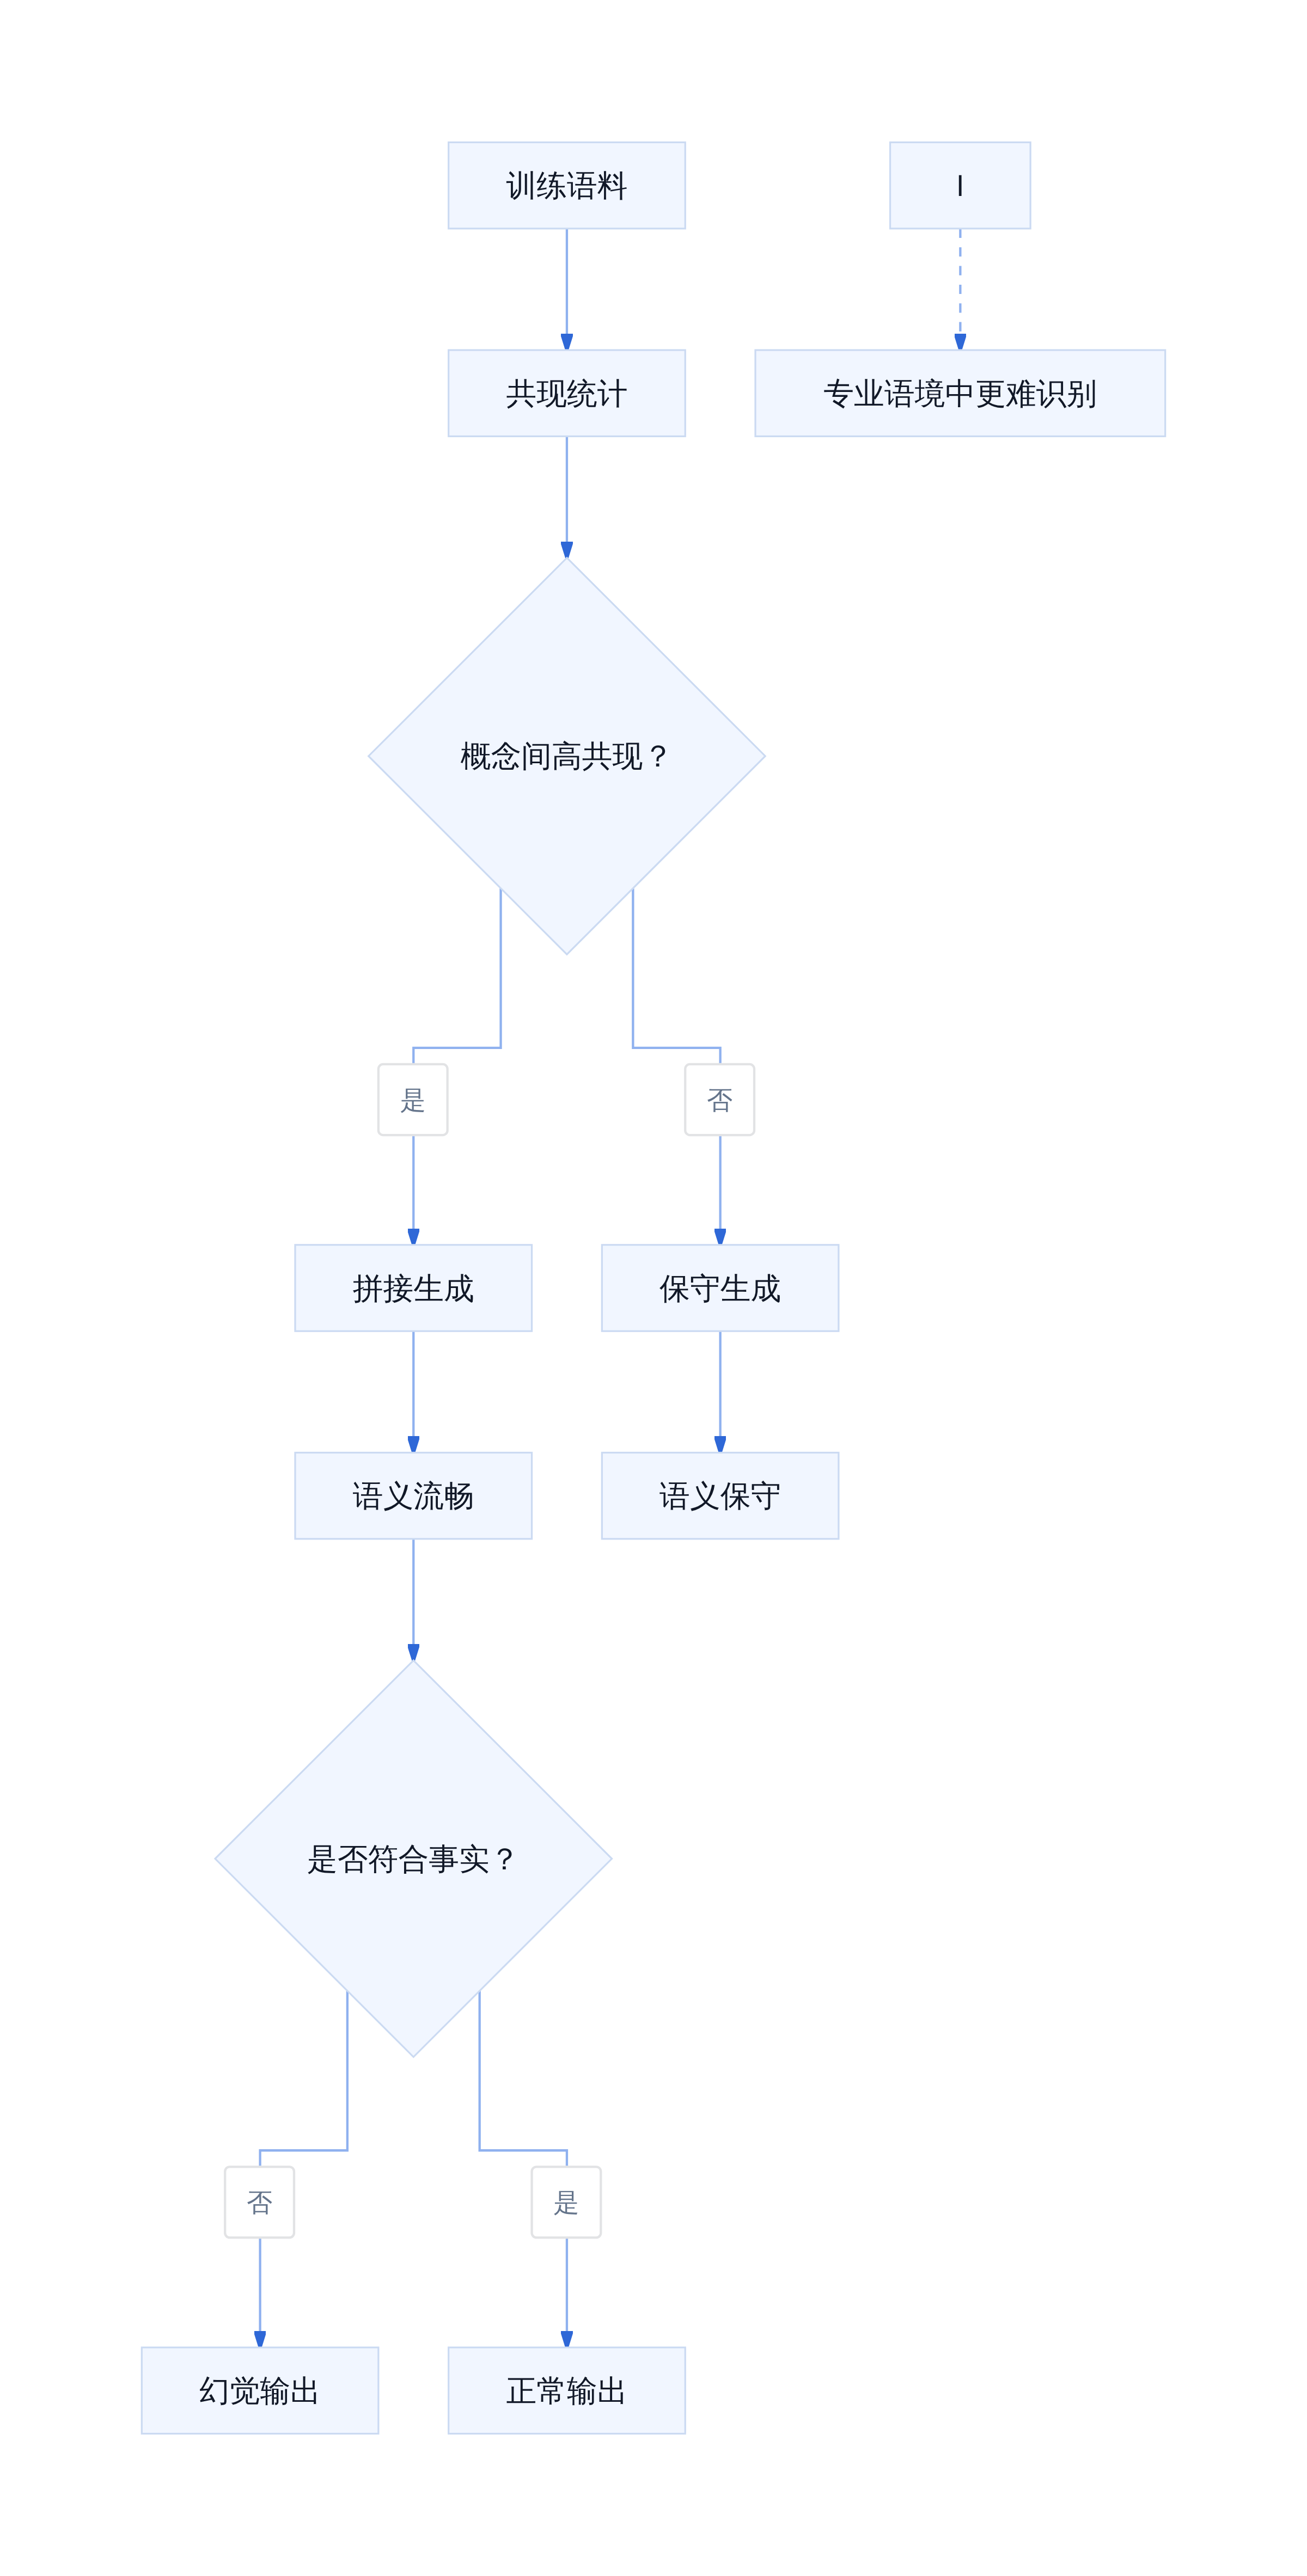
幻觉是下一词预测机制的必然副产品。模型的目标函数是最大化连续文本的似然,不是最小化事实错误。当两个概念在语料中高度共现,模型会倾向于把它们拼接在一起,哪怕这种拼接在事实层是错的。
某团队在 2025 年底的内部复盘里提到:"ChatGPT 给出的参考文献里有三篇是真实存在的,另外五篇的标题看起来合理,但数据库里根本查不到。"
更危险的是,幻觉在「看起来专业」的语境下更难被发现。学术写作、技术文档、合规报告——这些领域的语言风格恰好与模型的训练分布高度重叠。模型越像,越难挑。
幻觉产生的机制
私有上下文的缺失
任何实质性写作都依赖私有上下文:你知道团队过去的决策、你了解项目的真实约束、你清楚哪些假设已经验证过、哪些还没。
AI 不知道这些。你告诉它,它也不会「记住」——每次对话都是新的概率计算。它只能通过你输入的文字来重建上下文,而重建永远不等于原始经验。
结果是什么?AI 写的方案会覆盖所有「看起来合理」的情况,但漏掉所有「只有你知道」的约束。这不是能力问题,是架构问题。
六大技术缺陷
语义平滑与逻辑空洞
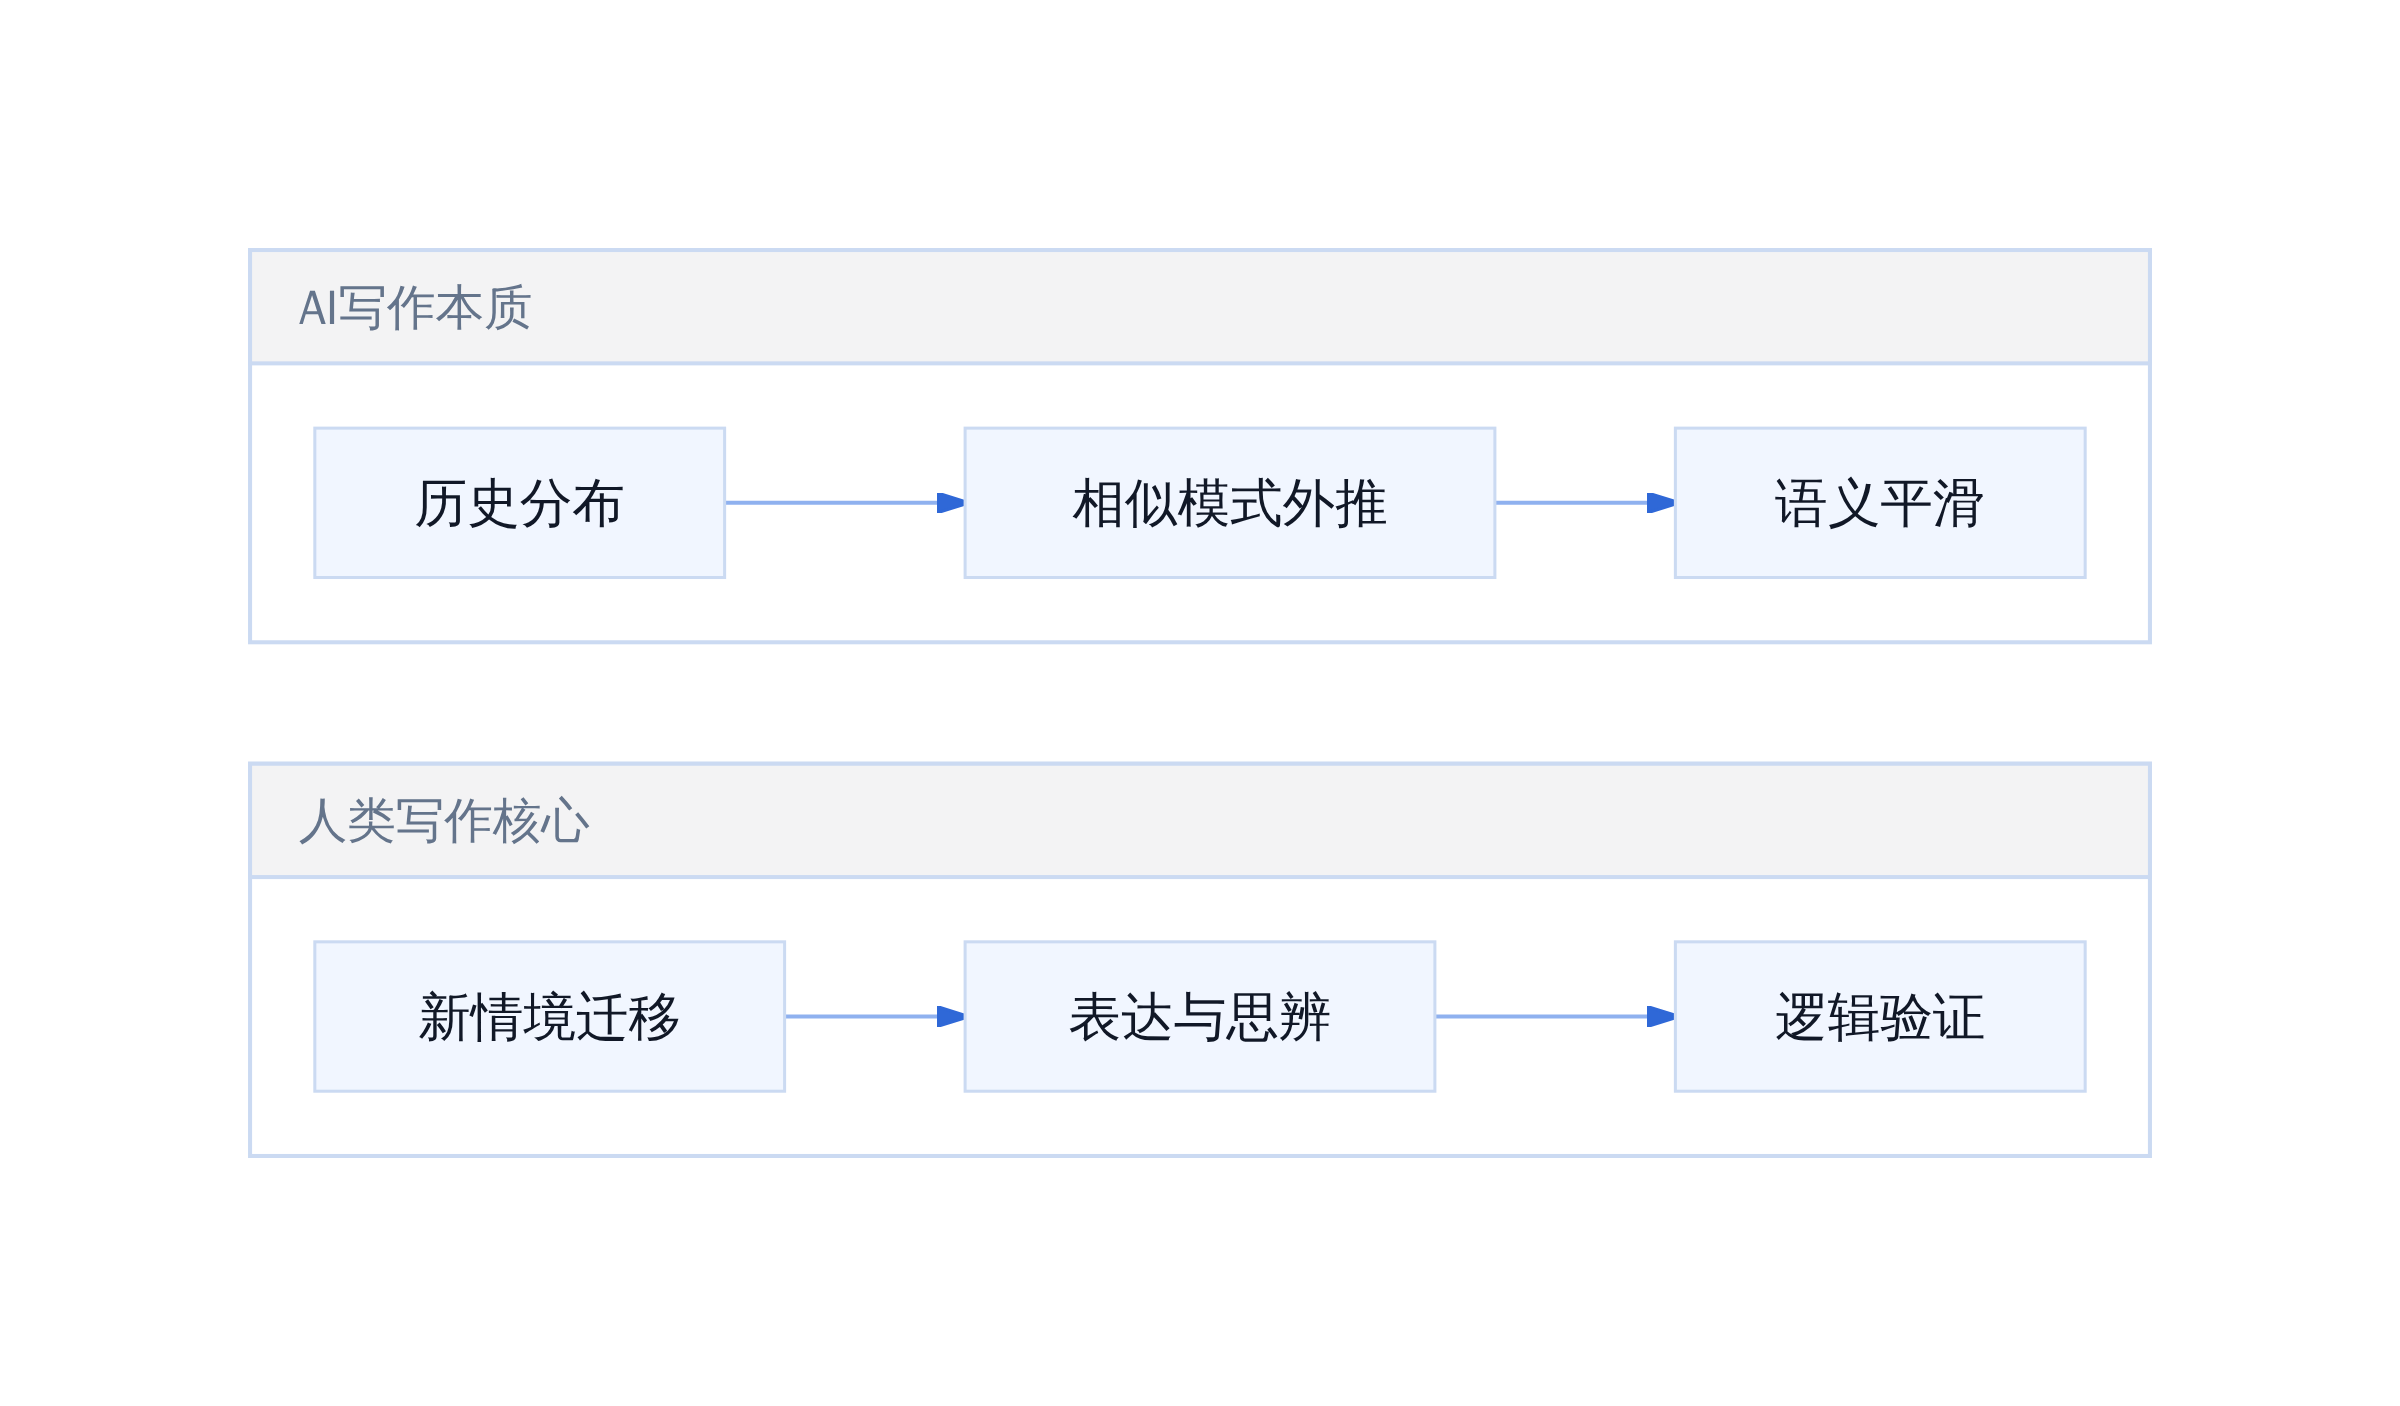
AI 写作的另一个隐蔽缺陷:它擅长把句子写顺,但不擅长确保论证成立。
「语义平滑」意味着每个相邻的概念过渡都有统计上的合理性,但整段论证可能建立在未经验证的假设上。读者读起来顺滑,是因为语言层没有问题;问题出在逻辑层。
举个例子,某 2026 年论文里出现的典型问题:"AI 系统在金融风险评估中的准确率已达 95%,因此全面替代人工审核是可接受的方案。"第一句可能需要核实数据来源,第二句的推理跳跃更大——准确率和可接受性之间没有必然逻辑链。
模型不会主动告诉你这个跳跃存在。它会继续写下去,因为下一个词的概率分布支持这种平滑过渡。
对齐优化的分布压缩
Pangram 的一篇技术文章提出一个可验证的假说:如果你测量模型对齐输出与某语料库之间的 KL 散度,模型的分布将更接近企业通信的中心,而非文学创作或独特观点的中心。
这意味着什么?模型被训练成输出「安全、广受认可」的风格。这种优化会惩罚高风险、高变异性的表达。
结果就是千篇一律。你可以在提示词里要求「用海明威的风格写」,模型会调整均值,但方差结构依然被对齐机制压缩。你得到的是「像海明威的企业通讯」,而不是海明威。
AI押题本质 VS 人类写作核心
无法承担作者责任
学术出版界的核心共识:AI 不能成为作者,因为它无法承担责任。
COPE、IEEE、Elsevier、ACS、AIP 等机构在 2025-2026 年的政策中一致强调:"AI 系统不能成为作者,因为它们无法承担责任或回应查询。"
这意味着什么?当你发表一篇论文,审稿人有权质疑你的方法、要求你补充实验、追问你的推理链条。AI 无法回答这些问题。它没有「理解」,只有「生成」。
如果你用 AI 写了实质性内容却不披露,审稿人发现后第一反应不是「这篇文章有问题」,而是「作者不可信」。信任一旦崩塌,修复成本远高于重写。
边界与可行路径
未标注即误导:信任维度的崩塌
学术出版界的政策演进已经给出明确信号。
COPE(出版伦理委员会)、IEEE、Elsevier、ACS 等机构在 2025 年后的共识是:AI 不能作为作者,因为它无法承担责任或回应查询。一旦 AI 介入文本生成的实质性环节,必须在方法或贡献声明中披露。未披露的 AI 生成内容可能被认定为学术不当,严重情况下会导致撤稿。
为什么「未披露」后果这么严重?因为它涉及读者信任的基础假设。
读者默认你为他写的内容承担全部准确性责任。当你用 AI 代写却不自知,读者读到的是「一个他们认为由你独立验证的观点」,实际这个观点里可能夹杂了模型幻觉、过时数据和逻辑跳跃。这种不对称会直接摧毁你作为作者的信用。
求是网的一篇文章记录了一个真实案例:一位记者将 AI 对「AI 与文学」的回答直接引用到自己的文章中,文章刊发时斜体标注消失,AI 的声音和作者的声音混为一体,不少读者毫不犹豫地将 AI 的看法当作作者本人的看法表达赞许。
这不是小概率事故。当「无懈可击的表达」成为读者默认的审美预期,AI 生成的平滑文本反而成了最容易被当成真话的内容。
边界与可行路径
这不意味着 AI 在写作流程里没有任何位置。
Erich Grunewald 和多位实践者的共识是:AI 可以用于转录、数据分析、头脑风暴和语言润色,但不应该用于替代核心论证的生成。
具体来说,以下几个边界需要明确:
- 转录和语音转文字:不涉及观点生成,属于纯工具性操作。
- 头脑风暴:作为思路催化剂,但最终论点和结构必须由人完成。
- 语言润色:在不改变语义结构和论证重心前提下的措辞优化。注意区分「润色」与「改写」——后者往往会改变论证顺序或重点。
- 摘要草稿:可以作为初稿参考,但必须人工核实每一项陈述和引用的准确性。
问题在于,「语言润色」和「实质性改写」之间并不存在稳定、可测量的分界点。看似「润色」的操作可能已改变句法结构、论证顺序甚至论述重心;而「改写」也可能并未引入任何新的实质性观点。将高度连续的写作行为强行切割为「合规」与「违规」,本身在技术上难以成立。
这就是为什么「披露」比「禁止」更现实,也更必要。
可执行的判断
如果你必须使用 AI 辅助写作,以下三步是最小化的安全路径:
第一步,明确标注 AI 介入的环节。在文档开头或脚注中说明哪些部分由 AI 生成、哪些经过修改、哪些完全独立。学术场景需要遵循期刊的具体格式要求,商业场景可以在文末附上「AI 使用声明」。
第二步,逐句核实关键事实。模型生成的数据、引用、时间线、政策名称,必须回到原始来源验证。不要相信模型给出的参考文献链接——它们很可能是伪造的。
第三步,保留写作过程的痕迹。保存初稿、对话记录、修改历史。这不仅是合规要求,也是你在需要解释内容来源时的证据。
坦率讲,如果一段文字你无法逐句验证它的准确性,就不应该把它放进最终版本。写作这件事最核心的价值,恰恰是那个「验证」的过程本身。
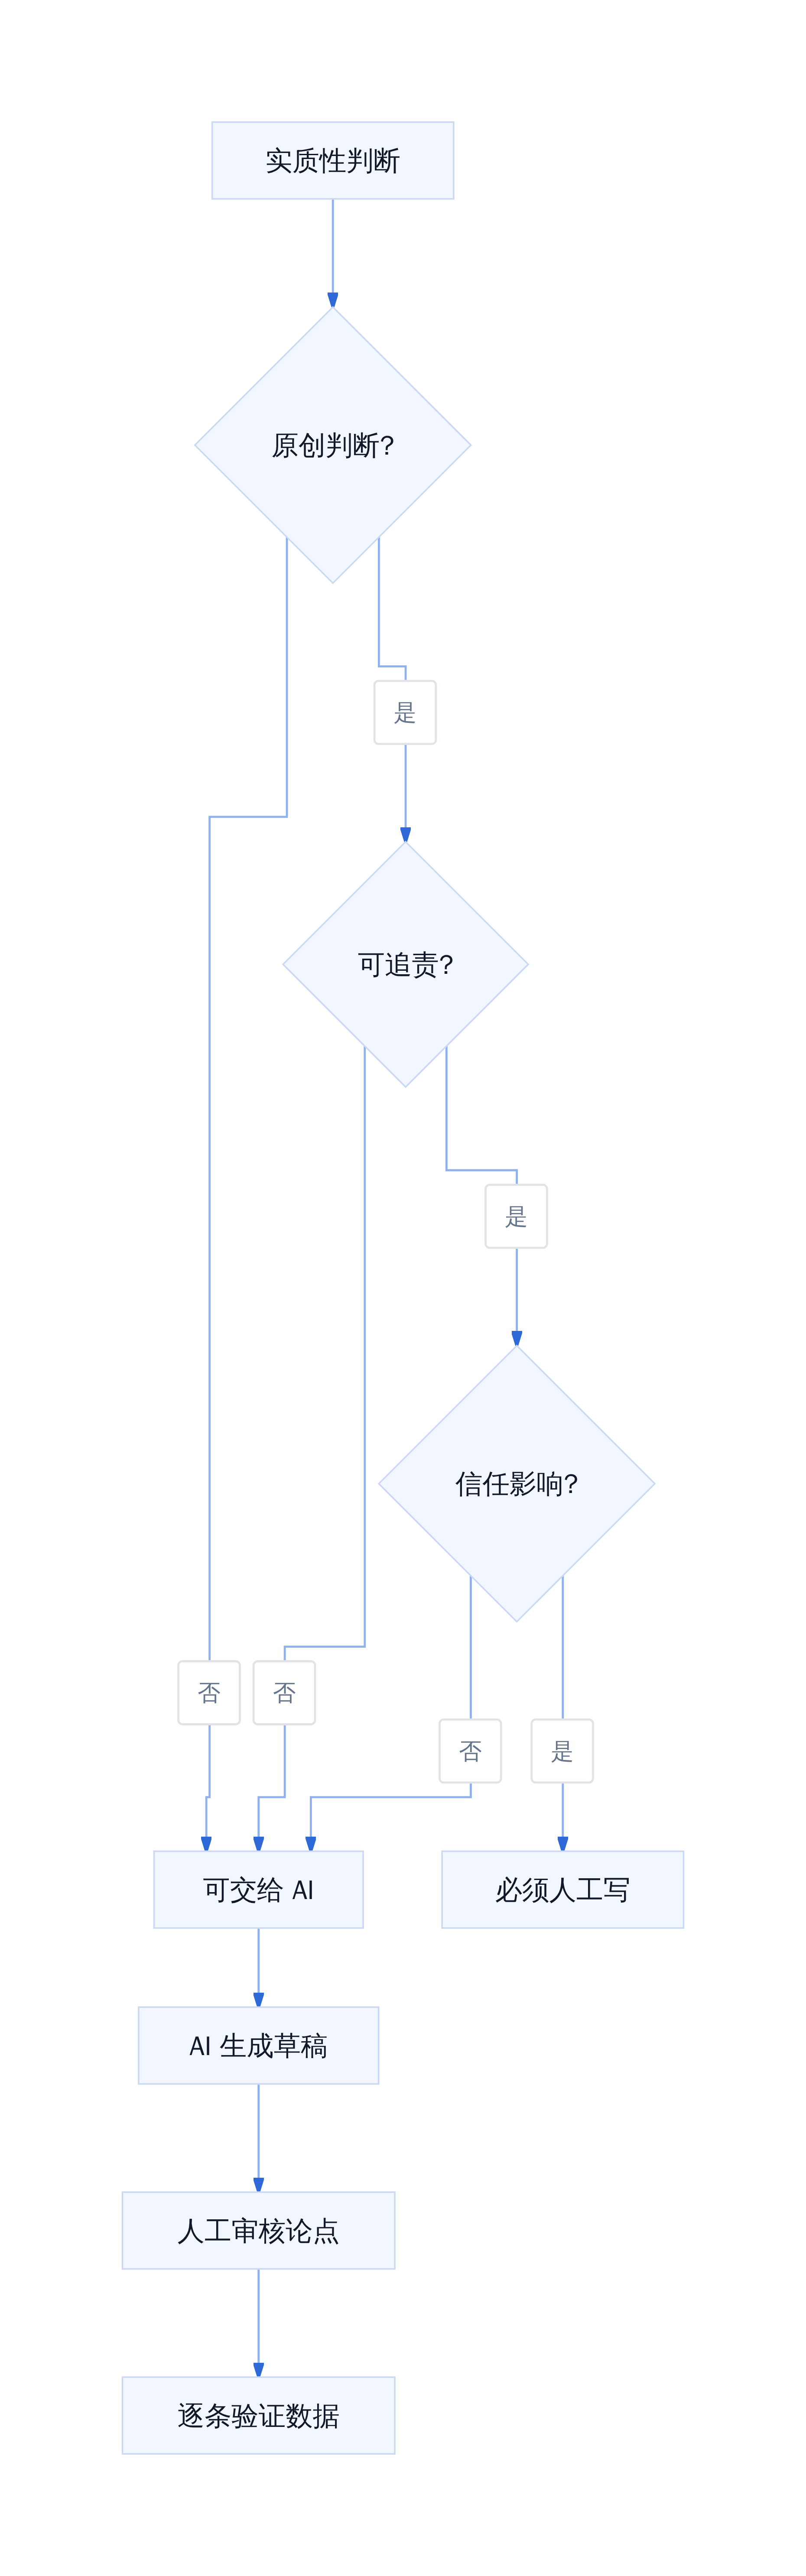
AI 辅助写作门禁流程
参考文献
- Erich Grunewald, Why You Should Almost Never Use AI to Write Anything Substantive, 2026: https://erichgrunewald.substack.com/p/why-you-should-almost-never-use-ai
- COPE 出版伦理委员会 AI 使用指引: https://publicationethics.org/
- ACS Nano Blog, 用上AI我们能写出更好的文章吗?: https://axial.acs.org/multidisciplinary/acs-nano-%E7%94%A8%E4%B8%8AAI%E6%88%91%E4%BB%AC%E8%83%BD%E5%86%99%E5%87%BA%E6%9B%B4%E5%A5%BD%E7%9A%84%E6%96%87%E7%AB%A0%E5%90%97
- Pangram, 人工智能写作之所以糟糕背后的信息理论: https://www.pangram.com/zh/blog/joe-stech-information-theory-why-ai-writing-sucks
- NYCU 阳明交大图书馆, 用AI写论文会被退稿吗?: https://news.lib.nycu.edu.tw/researches/%E7%94%A8ai%E5%AF%AB%E8%AB%96%E6%96%87%E6%9C%83%E8%A2%AB%E9%80%80%E7%A8%BF%E5%7D%8E-%E6%8D%9E%E6%87%82%E3%80%8Cai-%E8%B2%A2%E7%8D%BB%E8%81%B2%E6%98%8E%E3%80%8D%EF%BC%8C%E5%88%A5%E8%B8%A9%E5%AD%B8
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师