2026年9月,一份原本保密的诉讼文件被公开,里面有一行来自微软高管的私人判断:“这是人类历史上规模最大的劳动盗窃”。就在同一天,OpenAI CEO在法庭上依然坚称这是合理使用。两份证词,两个世界。
微软高管的“盗窃”论与OpenAI的“威胁”说
这份文件来自《纽约时报》2023年12月对OpenAI和微软提起的版权诉讼。案件进入证据开示阶段后,部分内部备忘录和技术文档被法院解除保密令。
微软应用科学总监布伦特·赫希特(Brent Hecht)在2023年1月的内部备忘录中写道:“人工智能模型训练是‘人类历史上最大规模的劳动盗窃’。”他将此形容为“规模空前、令人震惊的盗窃行为”。
有意思的是,赫希特并非边缘人物。他是微软负责AI与人类活动研究的高级科学家,其团队的研究涉及计算社会学、人机协作和数据伦理。他的判断,代表的是微软内部技术判断层的声音。
OpenAI这边,情况同样刺眼。OpenAI旗下ChatGPT产品负责人尼克·特利(Nick Turley)在内部材料中写道:“我们的产品在很大程度上就是替代品,无需多言。”他还预测,新闻机构正面临来自使用新闻内容训练的商业化产品的“生存威胁”,并认为“随着性能的提升,替代性将越来越强”。
更早些时候,OpenAI总裁格雷格·布罗克曼(Greg Brockman)在2020年的一封信件中曾写道,AI“似乎特别擅长预测新闻文章的文本”,并举例称“每当我让它接续《纽约时报》文章中的半句话时,它似乎都能准确无误地完成句子”。
内部措辞和公开立场之间的落差,构成了这起诉讼最引人注目的张力。公众面前,OpenAI强调合理使用原则“惠及所有人”,并将《纽约时报》描述为试图以牺牲进步为代价谋取额外利益的机构。法庭之外,内部邮件显示的判断则要直白得多。
数据规模:9万+篇作品被无偿使用
和解密文件同样披露的数据规模,远比普通读者的想象更为庞大。
根据诉讼文件,OpenAI的中期训练数据集(mid-training datasets)中,包含来自《纽约时报》《每日新闻》和调查报道中心发布的91,692篇作品副本。这些是被明确识别出来的数量,且仅针对这三家媒体机构的数据。
更宽泛地说,一个基于Common Crawl推导的数据集中,仅nytimes.com域名的文档就超过200万份。
这意味着什么?《纽约时报》是一家拥有超过150年历史的新闻机构,其内容生产依赖记者、编辑、事实核查员、摄影记者、排版人员构成的完整链条。每一篇文章的背后,是数小时甚至数周的专业劳动。
把这些内容整体爬取、存入训练集、用于训练大语言模型——整个过程没有向《纽约时报》支付授权费,没有在输出中归因,也没有建立任何分成机制。
这不是某个小作坊的行为。这是OpenAI和微软这样的科技巨头,建立在合法商业架构上的系统性操作。
为什么这份文件如此关键
这份文件的价值,不在于它揭示了什么新的事实。事实上,《纽约时报》的诉讼从一开始就公开指控OpenAI和微软未经授权爬取其内容用于训练。
文件的真正价值在于三点。
第一,它来自被告方内部。微软高管的“盗窃”表述、OpenAI管理层的“生存威胁”判断,不是第三方批评,而是当事人自己的书面记录。在法庭上,这类证据的权重远高于外部评论。
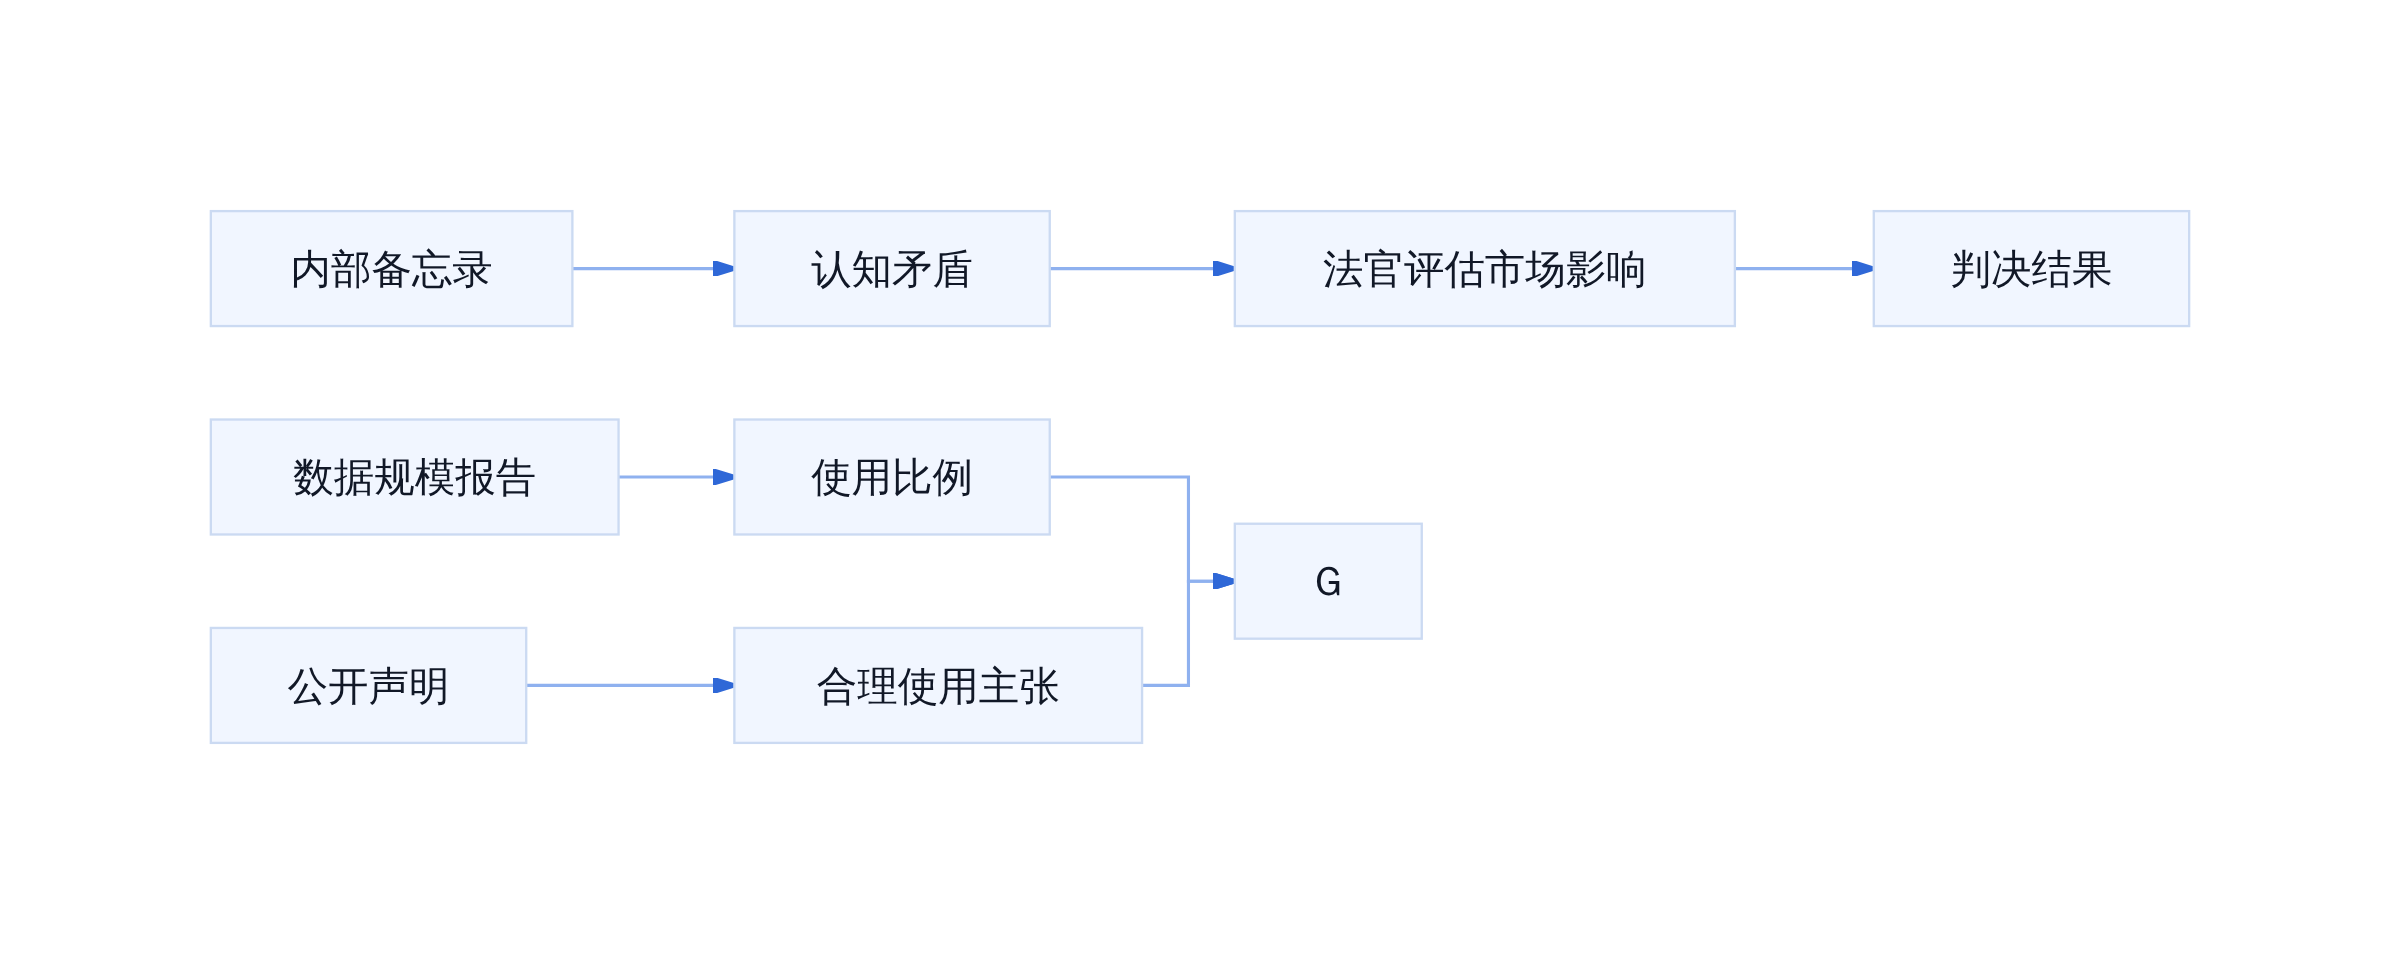
第二,它揭示了认知层面的矛盾。OpenAI在公开声明中反复强调合理使用原则的正当性,称其为“为所有人带来利益”的制度。但内部材料显示,公司管理层清楚知道其产品对新闻业构成了实质性替代威胁。认知与声明之间的断裂,是诉讼中最具法律意义的部分。
第三,它为后续判决提供了参照系。法官在判断“合理使用”是否成立时,需要评估被告使用作品的方式、使用的比例、对原作品市场的影响等因素。内部备忘录中对公司行为后果的直接描述,将成为评估“市场影响”这一要素的关键证据。
诉讼关键证据链
二、内部备忘录 vs 公开立场
微软和OpenAI在法庭上的声明是同一件事的两个版本,但翻到它们自己的内部文档,版本就变了。
微软:私下承认 vs 公开否认
微软应用科学总监布伦特·赫希特(Brent Hecht)在2023年1月的内部备忘录中写道:「规模空前的、令人震惊的劳动盗窃。」同年早些时候的一份材料里,他直接用了「人类历史上规模最大的劳动盗窃」这个措辞。
而到了法庭上,微软的立场变成了:OpenAI未经授权使用纽时内容侵权,微软只是提供基础设施。这份诉状把自己从被告席挪到了证人席,姿态聪明,但备忘录里的用词不会配合演出。
更准确地说,赫希特的两份内部文件时间跨度约三个月,措辞从「惊人」升级到「史上最大」——这说明在微软内部,这个判断是在不断被强化的,而不是被压下去的。
OpenAI:「合理使用」辩护的内在矛盾
OpenAI的辩护逻辑很清晰:训练过程中使用受版权保护的内容属于「转换性使用」,属于合理使用。这套说辞在技术社区里流传很广,因为它的逻辑链条看起来自洽:输入文字→模型学习语言模式→输出不是复制而是生成,所以不侵权。
问题在于,OpenAI自己的内部文件在另一套语言里描述同样的事。
OpenAI产品负责人尼克·特利(Nick Turley)在内部评估中写道:「我们的产品在很大程度上就是替代品,无需多言。」他还预测,随着ChatGPT性能提升,「替代性将越来越强」,新闻机构面临「生存性威胁」。
Greg Brockman在2020年的一封内部信中同样提到:AI「特别擅长预测新闻文章的文本」,让他接续《纽约时报》文章的半句话,模型「似乎都能准确无误地完成」。
坦白讲,当一家公司的内部判断是「我们产品在替代他们的业务」,而对外法律论证是「我们只是在学习语言模式」,这两套叙事之间不是措辞差异,是逻辑断裂。
谁在说真话,谁在演剧本
微软和OpenAI内部备忘录的共同点是:当事人在最不需要表演的时候,说了最不需要掩饰的话。
法庭上有律师把关,有对抗制检验,每一句话都是经过计算的。备忘录不一样,它写给内部同事看,写给未来的自己看,写给可能被调取的文件归档。赫希特写「史上最大规模的劳动盗窃」时,不需要考虑陪审团的感受。
这也解释了为什么这份文件如此关键。它不是竞争对手的指控,不是记者的推断,是被告方自己的人在私密场景下写下并留档的判断。在法律证据规则里,这叫「against interest statement」,效力高于法庭上的正式表态。
更直白一点说:当被告自己在内部文件里承认了原告的核心指控,原告的案子就已经赢了一半。剩下的一半,交给法官判断法律适用。
OpenAI和微软目前的策略是把这场诉讼重新框架化为「技术进步 vs 传统版权」的二元对立,试图把具体案件抽象成原则之争。但内部备忘录的出现让这个框架裂了一条缝——你很难同时主张「我们只是在正常学习」和「我们的产品本质上在替代他们的业务」。
这两句话不能同时为真。法庭要判断的,就是哪一句代表这家公司的真实立场。

真相正在从备忘录里浮出来
2026年9月,一份原本保密的诉讼文件被公开,里面有一行来自微软高管的私人判断:"这是人类历史上规模最大的劳动盗窃"。就在同一天,OpenAI CEO在法庭上依然坚称这是合理使用。两份证词,两个世界。
真相锁定:两句话,两种立场
三、AI训练数据的灰色地带
抓取与使用的法律边界在哪里
这个问题的法律底色比大多数工程师理解的更薄。
抓取(scraping)本身,在绝大多数司法辖区里,并不直接构成违法。网页是公开的,robots.txt只是建议,不是法律。访问公开数据,这是互联网的基本运行规则。但问题的关键从来不是"能不能抓",而是"抓来之后做什么"。
当抓取的内容被用作训练数据来构建商业化模型时,法律性质就变了。
美国版权法里有"合理使用"(fair use)原则,核心判断标准有四条:使用的目的和性质、作品的性质、使用的数量和重要性、以及对原作品潜在市场的影响。OpenAI的辩护逻辑主要建立在第一条——AI训练是"转换性使用"(transformative use),目的是学习语言模式而非复制内容。
但出版业的核心反驳点也在第四条:如果AI模型可以替代你对《纽约时报》文章的付费订阅,那这种"转换"就是在摧毁原作的市场价值。
这里有一个关键的法律缝隙:合理使用原则诞生于20世纪,当时立法者想象的是评论、 parody、学术研究等场景。没有人预见到会有AI模型以万亿Token级别的规模、系统性且商业性地消费受版权保护的作品库。

法律跟不上技术速度的经典现场
判例的不确定性是这场诉讼最核心的战场。截至目前,没有任何联邦上诉法院对"大规模商业性抓取受版权保护内容用于AI训练是否构成合理使用"做出最终裁定。地区法院的初步裁决倾向于支持被告,但上诉前景不明。
这造成了一种奇怪的生态:法律没有明确禁止,但法律也没有明确许可。中间地带就是所有AI公司今天的运营空间——我知道这可能有问题,但我赌你告不赢我。
为什么出版机构选择"硬刚"
出版业的选择不是情绪化的反叛,而是算过账的被迫反击。
《纽约时报》的付费订阅模式建立在内容的稀缺性和独占性上。如果ChatGPT可以无缝生成等同于《纽约时报》调查报道水准的文字,用户为什么要付每月15美元?这就是OpenAI高管尼克·特利(Nick Turley)在内部备忘录里写"我们的产品在很大程度上就是替代品"时真正想表达的意思。
替代性威胁是出版业无法忽视的结构性风险,不是个案可以解释的。
当你的核心产品变成别人的训练数据
诉讼的真正目的并非一次性赔偿金额,而是建立判例。一旦法院认定AI训练属于合理使用,所有出版业、内容创作行业的版权护城河都会被瞬间削平。这不是《纽约时报》一家的战斗,是所有内容生产者的共同防御战。
这也是为什么索尼和华纳在2026年8月联合起诉Anthropic,指控其未经授权使用数万部受版权保护的音乐作品歌词训练Claude模型。音乐产业经历过Napster和Spotify两次范式冲击,这一次他们不再等。先起诉的是策略,不是冲动。
行业内的其他案例:音乐、新闻、代码
这场诉讼不是孤例,它是一个更广泛版权冲突的前哨战。
音乐领域的对抗最为激烈。索尼音乐出版和华纳查佩尔联合起诉Anthropic,索赔规模预估超过10亿美元。理由是Claude模型能够"精确复现"受版权保护的歌词段落。这个指控和《纽约时报》对ChatGPT的指控在逻辑上完全同构——AI输出中出现了与训练数据高度相似的内容。
新闻领域除了《纽约时报》,美联社(Associated Press)也在2024年对OpenAI提起了类似的版权诉讼,指控ChatGPT未经许可使用其新闻内容训练模型。
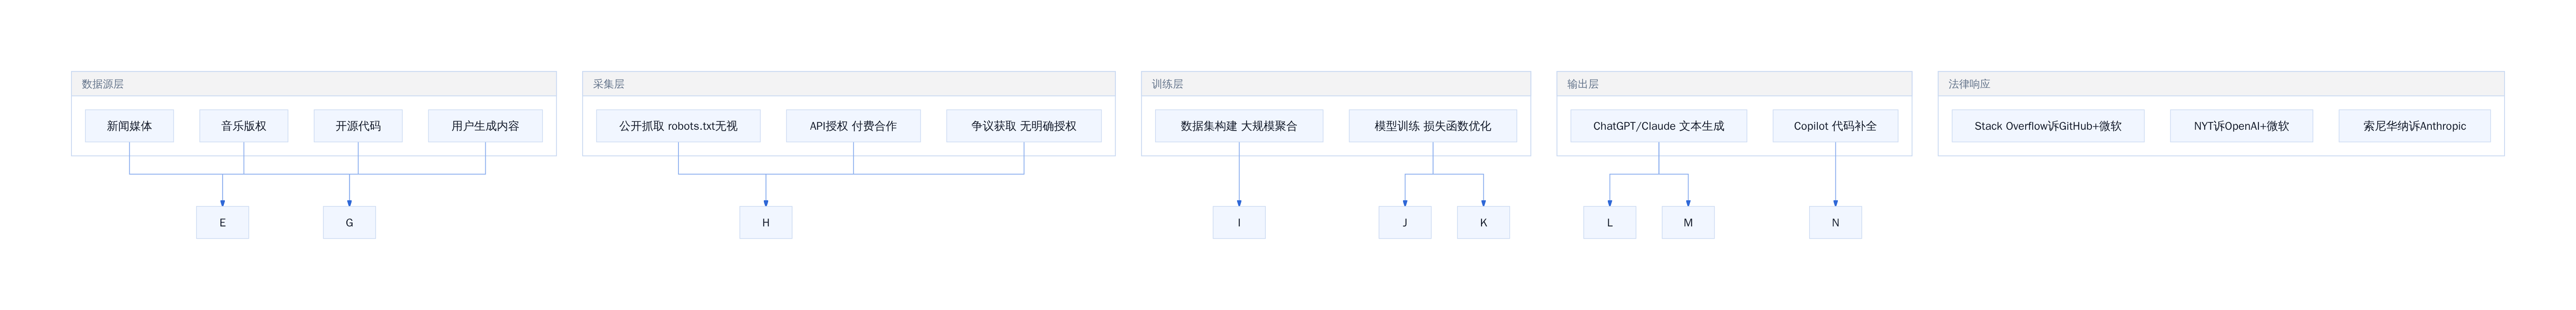
代码领域的情况更为复杂。GitHub上的开源代码是否构成"受版权保护的作品"存在争议,但AI公司直接抓取GitHub训练代码模型的做法,已经引起了开发社区的强烈反弹。Stack Overflow在2023年起诉GitHub和微软,理由正是GitHub Copilot使用了其社区内容训练模型。

多方博弈下的数据飞轮架构
AI训练数据流与版权冲突映射
这四条诉讼线的共同点是:原告都是内容生产者,被告都是AI基础设施公司,争议焦点都是"训练数据使用的合法性边界"。判例结果将直接影响整个生成式AI行业的成本结构。
一个有趣的对比是音乐产业的路径。RIAA(美国唱片业协会)在上世纪90年代面对Napster时的应对策略是"起诉+谈判+合作"三步走。结果是Spotify等合法平台崛起,版权方获得了持续的版税收入。而当前的AI数据抓取没有类似Spotify的合法授权渠道——至少在没有诉讼之前没有。这正是出版业和音乐产业选择硬刚的根本原因:他们在等一个能建立授权机制的判决,而不是在寻求一次性和解。
一、一份文件,撕裂了两家公司的体面

当内部备忘录遇上公开法庭
这份文件来自《纽约时报》于2023年12月提起的版权诉讼。三年里,这场官司一直没停过。直到这次解封,外界才第一次看到当事方在私密语境下的真实判断。
文件披露的数据规模相当直观:OpenAI的中期训练数据集里,包含了超过91,692篇来自《纽约时报》《每日新闻》和调查报道中心的受版权保护作品。仅Common Crawl衍生数据集里,就收录了超过200万篇nytimes.com的文档。
9万篇是什么概念?假设一名记者每天写两篇深度报道,这相当于一个人连续写125年。更准确地说,是几千名记者几年甚至十几年的劳动成果,被打包进了一个无需付费的模型训练池。
这份文件之所以关键,是因为它提供了两个层面的证据:一是企业内部人员对自身行为的定性;二是训练数据集的具体构成。前者动摇的是「我们没有恶意」这一叙事,后者提供的是可量化的损害评估基础。
四、这件事对AI行业的冲击

当免费午餐结束了,工程师们得学会算账
训练数据成本或将上升
如果法院最终判定AI训练需要使用受版权保护的内容需获得授权,那么训练数据的获取方式将发生根本性变化。
目前,主流的做法是通过Common Crawl等公开数据集进行抓取,成本接近于零。一旦这条路被堵死,替代方案有两条:支付授权费,或者从头构建自有数据集。
授权费的影响是直接的。一个中等规模的模型训练数据集可能需要数十亿tokens的文本,如果每千 tokens 需要支付几美分,这个数字会迅速膨胀。根据行业估算,高质量授权文本的成本可能占模型训练总成本的10%到30%。
更准确地说,这不是一个「全有或全无」的问题,而是一个「分层授权」的问题。高价值内容(如《纽约时报》的深度报道)的授权费会远高于公共领域内容。模型公司需要在成本和质量之间做取舍。
开源模型的版权风险
开源模型面临的压力更大。闭源模型可以依靠授权文本自建训练集,但开源模型的训练数据通常来自公开可用的资源。
如果「公开可得」不再等于「可使用」,那么开源模型的合法性将受到根本挑战。这可能导致两种结果:一是开源项目转向使用明确授权的数据集;二是开源社区探索「清洗后」的数据集,即剔除已知受版权保护内容后的剩余部分。
无论哪种路径,都会增加开源模型的开发成本和法律风险。
未来的合规路径是什么
从目前的情况看,行业可能走向三条路径:
路径一:授权模式普及化。模型公司按使用量向内容提供者付费,类似于音乐流媒体向唱片公司付费的模式。这条路已经被Spotify验证过,只是金额争议一直存在。
路径二:数据集过滤标准化。建立行业认可的内容过滤标准,区分「可安全使用」和「需授权」的内容。这条路需要行业协同,且技术实现有挑战。
路径三:公共领域优先。模型训练更多依赖明确无版权限制的文本,如政府文件、学术论文、古籍等。这条路的局限是内容质量参差,难以支撑顶级模型的性能。
现实中最可能的结果,是三条路径的组合:核心模型用授权数据,开源模型用过滤后数据,辅助系统用公共领域数据。
从经验看,这个过程的代价会由整个行业分担,不只是AI公司。内容创作者如果赢了诉讼,短期内可能获得授权收入;但如果授权模式过于昂贵,也可能导致AI应用创新受阻。
这是一次关于「知识产权边界」的重新定义。它的结果将影响未来十年AI基础设施的底层逻辑。
参考文献
- Mike Isaac, "Microsoft and OpenAI Workers Worry About 'Largest Theft of Labor' from News Publishers," The New York Times, Sept. 17, 2026. https://www.nytimes.com/2026/09/17/technology/microsoft-openai-publishing-industry.html
- "Microsoft exec called AI scraping 'the largest theft of labor in human history,' new filings reveal," TechCrunch, Sept. 17, 2026. https://techcrunch.com/2026/09/17/microsoft-exec-called-ai-scraping-the-largest-theft-of-labor-in-human-history-new-unredacted-filings-reveal
- "关于《纽约时报》诉讼的事实声明," OpenAI. https://openai.com/zh-Hans-CN/new-york-times
- "法庭文件:微软高管承认AI可能破坏新闻业,是'规模空前的劳动盗窃'," 搜狐. https://www.sohu.com/a/1077703018_260616
如果浏览器无法直接唤起微信,可在微信内打开公众号主页:计算机魔术师