Perplexity 的 CEO 在 X 上宣布了一条消息:我们用两个月、两个工程师,加上几百个 AI Agent,写了一个能替代 DynamoDB 的数据库。更狠的是,每年能省下一个亿。

高调放话
这个消息的冲击力不在于「省了一亿美元」本身,而在于它揭示了一个正在被忽视的行业真相:当业务量达到一定规模,云数据库的便利就会变成成本陷阱。Perplexity 用两个月验证了一个道理:不是所有场景都需要通用数据库。
一场「不划算」的重写,为什么值得做
一年一亿美元,是什么量级?
要理解这个数字的分量,需要先拆解 DynamoDB 的计费逻辑。DynamoDB 按读写容量单位(RCU/WCU)计费,RCU 代表每秒可读操作的次数,每单位支持 4KB 读取。对于高频读写的场景,这个模型看起来合理,但问题在于:它没有考虑数据访问的模式差异。
Perplexity 的搜索后端有一个典型的负载特征:每天产生大量的预处理结果,这些结果需要被反复批量读取,而不是单条点查。根据 cryptobriefing 的报道,CobbleDB 将批量读取延迟降低了 82%。这意味着同样的硬件资源可以支撑更多的查询,而不是像 DynamoDB 那样按操作次数堆积成本。
在 LinkedIn 上,Philip Oliver 提到这笔节省来自「远离预制云解决方案」。具体来说,DynamoDB 在处理 Perplexity 这种场景时,存在明显的成本放大效应:每次 chunking 方法、embedding 模型或记录格式的变更,都会触发大量单条更新,而 DynamoDB 不会因为你是在批量更新就给你优惠。
两个月 + 两人,怎么做到的?
这是文章中最具话题性的部分。两个工程师、两个月,听起来像是「vibe coding」的极端案例。但如果你看 Perplexity 自己发布的研究博客,会发现这套方案并非凭空而来。
氛围编程?不,是有迹可循
关键在「几百个 AI Agent」这个表述。Perplexity 的 CEO Aravind Srinivas 在 X 上原话是:「Two engineers and a team of hundreds of proactive, always-on AI agents built the core infrastructure in two months。」这里的 AI Agent 不是噱头,而是实际参与代码生成、测试编写和文档整理的工程组件。这本质上是一种分工策略:人类工程师负责架构决策和关键路径,Agent 负责重复性劳动。
但这引出一个更深层的问题:两个月建成的东西,能扛住生产流量吗?Perplexity 明确表示,系统将在「数十万 QPS」规模下验证后再开源。这相当于承认:原型和稳定生产系统之间仍有距离,两个月的成果是起点而非终点。
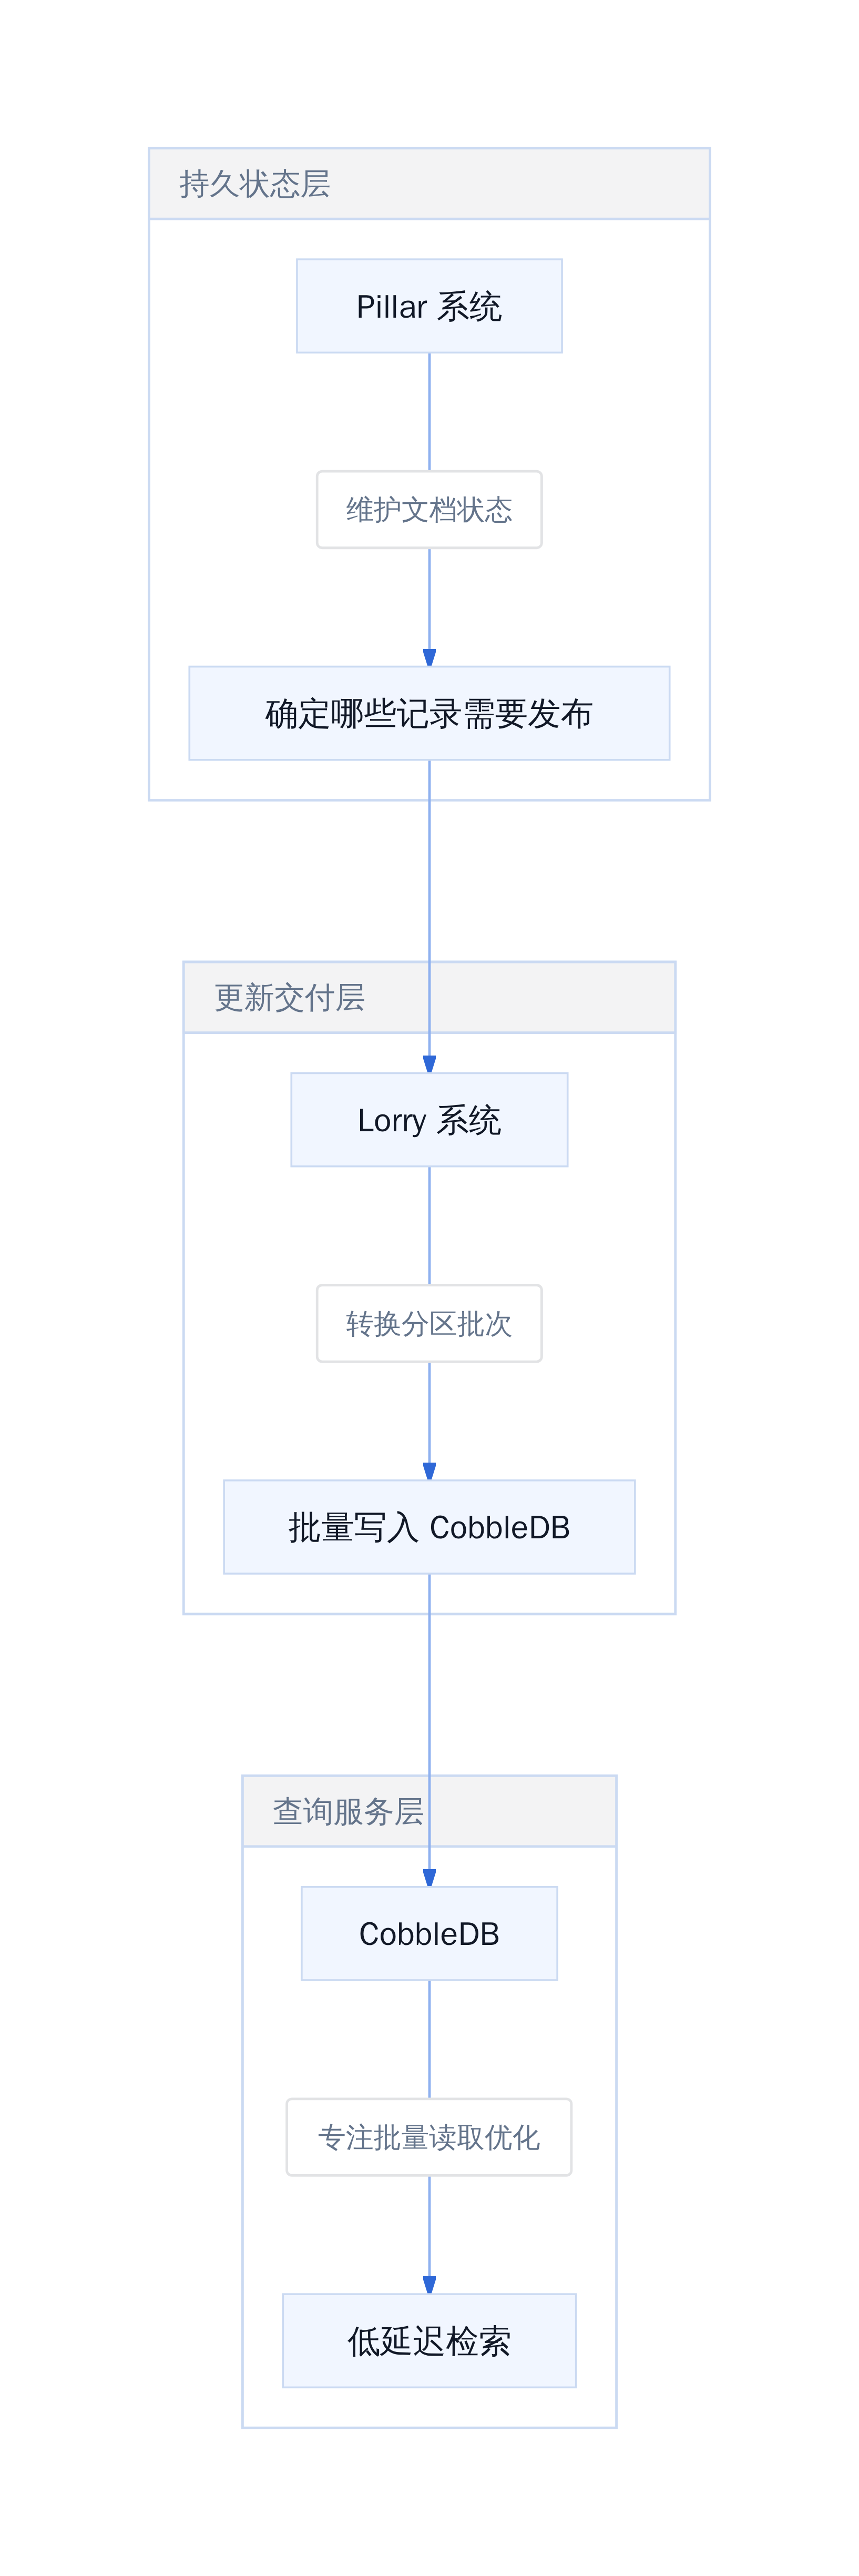
真正的工程价值不在速度,而在设计选择。CobbleDB 的核心思路是把持久状态、更新交付和查询服务三层职责解耦。此前 Perplexity 的处理管道直接把准备好的页面写入 DynamoDB,所有变更都通过同一接口冲击在线查询路径。解耦之后,持久化由 Pillar 系统负责,更新由 Lorry 系统转换为分区批次交付,查询则由 CobbleDB 专门服务。这三层可以独立优化,不需要一个数据库接口同时讨好所有需求。
CobbleDB 三层职责解耦架构
这种设计的代价是复杂度上升。你需要维护三个系统之间的边界和同步逻辑,而不是靠一个数据库的事务机制来兜底。但 Perplexity 的结论是:当规模足够大时,这种复杂度是有回报的。DynamoDB 的便利在日请求量突破千万级别后,会变成财务上的无底洞。

系统设计不是摆样子

AI 团队搬砖现场
CobbleDB 的架构设计逻辑
Pillar、Lorry、CobbleDB:三层职责分离
Perplexity 的处理流水线原来是一个整体:准备好的网页内容直接写入 DynamoDB,同时承载查询请求。问题在于,一旦 chunking 策略、embedding 模型或记录格式发生变化,就要对同一张表发起海量单条更新。
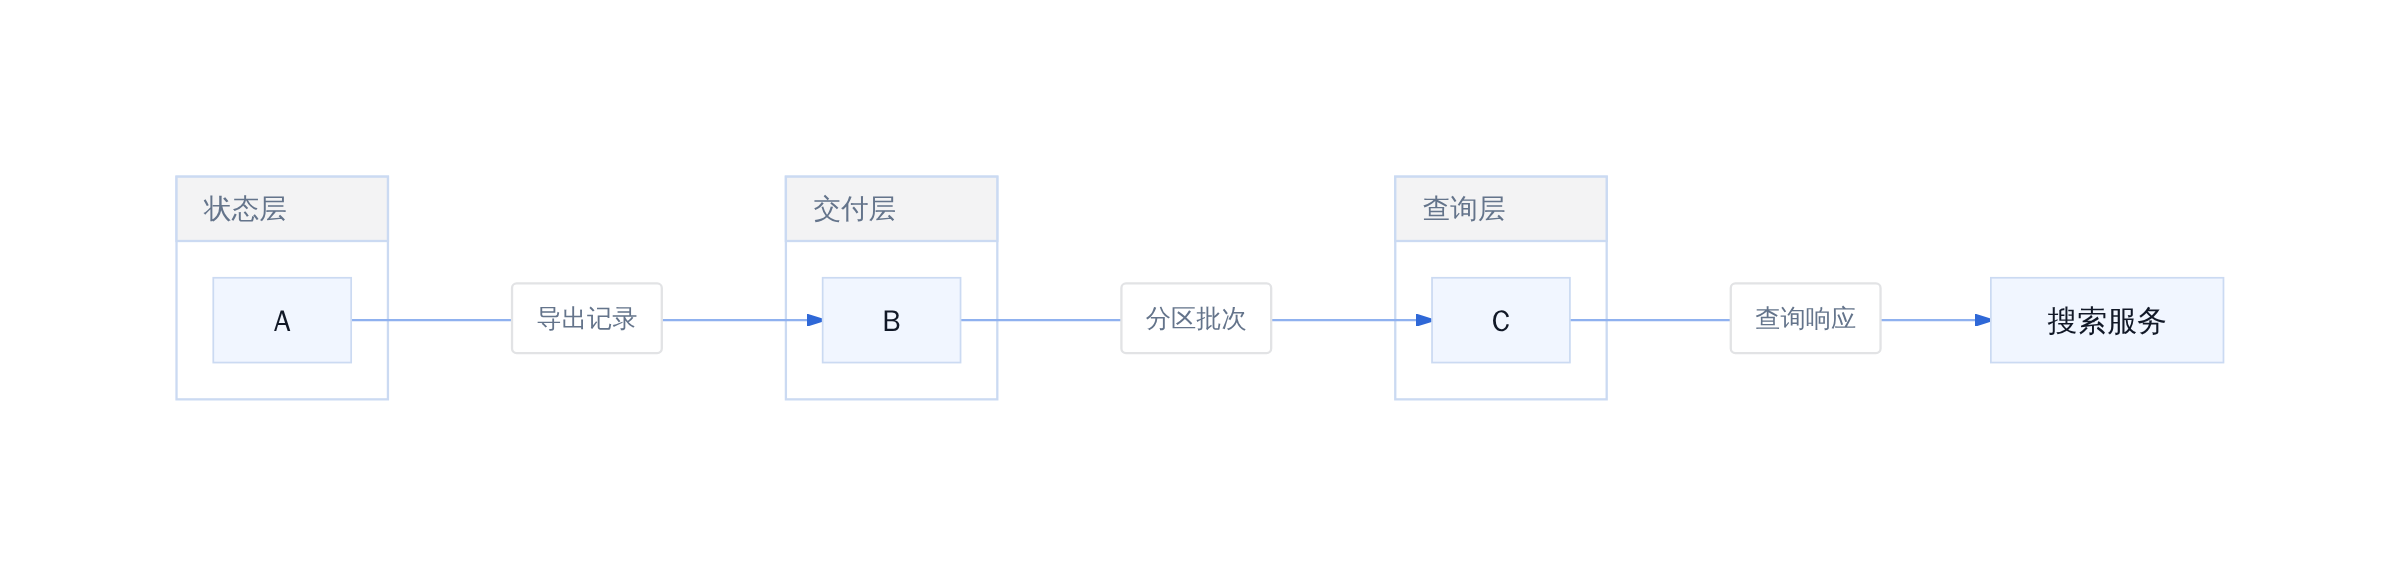
CobbleDB 的解法是把这三件事拆开。Pillar 负责维护持久化的文档状态,决定哪些记录应该被发布。Lorry 把这些导出转换为分区批次,喂给 CobbleDB。CobbleDB 本身只做一件事:用低延迟承接高频批量读取。

架构拆分进行时
CobbleDB 三层架构分工
这种拆分的核心价值不在于每个模块有多复杂,而在于每个模块可以被独立优化。Pillar 不关心查询延迟,Lorry 不关心存储成本,CobbleDB 不关心写入一致性。三者之间通过明确的接口契约协作,而非共享同一套 API 妥协。
为什么 DynamoDB 在 AI 搜索场景下不够用?
DynamoDB 的优势是托管服务带来的低运维成本和弹性扩展能力。但这些优势在特定场景下会变成负担。
Perplexity 的搜索场景有一个特征:写操作的模式高度不均匀。一次模型升级或分块策略调整,会在短时间内产生数百万条针对同一表的更新请求。DynamoDB 的计费模式按读写容量单位计算,这些突刺式的更新会迅速消耗 provisioned capacity,或者触发 on-demand 模式的昂贵单价。
更关键的是查询模式。搜索服务需要在毫秒级返回批量结果,这意味着查询路径上不能有任何额外的串行开销。DynamoDB 的全表扫描、GSI 投影、以及跨分区的一致性读取,在这些场景下都会引入不可接受的成本。
容量规划加班现场
这不是 DynamoDB 本身的问题,而是通用数据库与特定负载之间的错位。DynamoDB 适合读写模式相对均衡、访问路径清晰的场景。当写入呈现脉冲式爆发、查询呈现批量模式时,它的成本模型就开始失控。
针对性优化的三个关键决策
第一个决策是存储格式的专项定制。CobbleDB 针对 Perplexity 的文档记录格式设计了专门的编码方案,去掉了通用数据库为兼容性保留的元数据和类型系统开销。这不是什么新技术,本质上是把「为所有场景优化」换成「为这一个场景做到极致」。
第二个决策是批处理的写入路径。Lorry 层把分散的更新请求聚合成分区批次,再通过顺序写入的方式灌入 CobbleDB。这种方式避免了 DynamoDB 常见的随机写放大问题,同时也让容量预估变得可控。
第三个决策是查询路径的完全解耦。CobbleDB 不包含写入一致性协议、不维护多副本同步逻辑、不处理跨分区事务。它就是一个为批量读取优化的键值存储。代价是架构复杂度增加,收益是查询延迟和成本的可预测性大幅提升。
架构评审通过
这三个决策的共同点是放弃了通用性。每一层都只做一件事,并且把这个事情做到比通用方案更好。这正是自建数据库的典型逻辑:用工程复杂度换取成本结构的可控性。
Perplexity 在官方 blog 中指出,迁移后中位数延迟和尾部延迟都有显著改善,批量读取延迟降低了 82%。这个数字背后的逻辑并不复杂——当一个系统不再需要为不相关的负载保留容量时,它的性能表现自然会向最优方向收敛。

评审时反复追问
需要注意的是,这种方案并非没有代价。CobbleDB 目前仅在 Perplexity 内部使用,且计划在生产环境验证达到每秒数十万次请求的量级后开源。这意味着它首先解决的是规模问题,而非通用问题。对于访问量未达到这个量级的团队来说,强行套用同样的架构,可能会发现运维成本超过节省的基础设施支出。
Perplexity 的实践揭示了一个更普遍的趋势:当业务量达到一定规模,云数据库的便利就会变成成本陷阱。他们选择用两个月的时间和两个工程师,验证了一个可行的替代路径。这个路径是否适用于其他场景,取决于你能否清晰回答一个问题——你的负载特征,是否已经超出了通用数据库的经济边界?
成本与性能的真实账本
一亿美元这个数字,拆开看大约是每月 830 万。Perplexity 官方没有披露 DynamoDB 原有的月度账单,但这个量级本身就说明了一件事:其搜索基础设施的读写吞吐量已经突破了 AWS 托管方案的定价曲线拐点。根据已知信息,DynamoDB 在持续性高流量、全表扫描和多 GSI 等场景下成本增长是非线性的——请求量越大、数据越热,每单位读写的边际成本就越突出。
延迟下降 82% 是怎么算出来的?
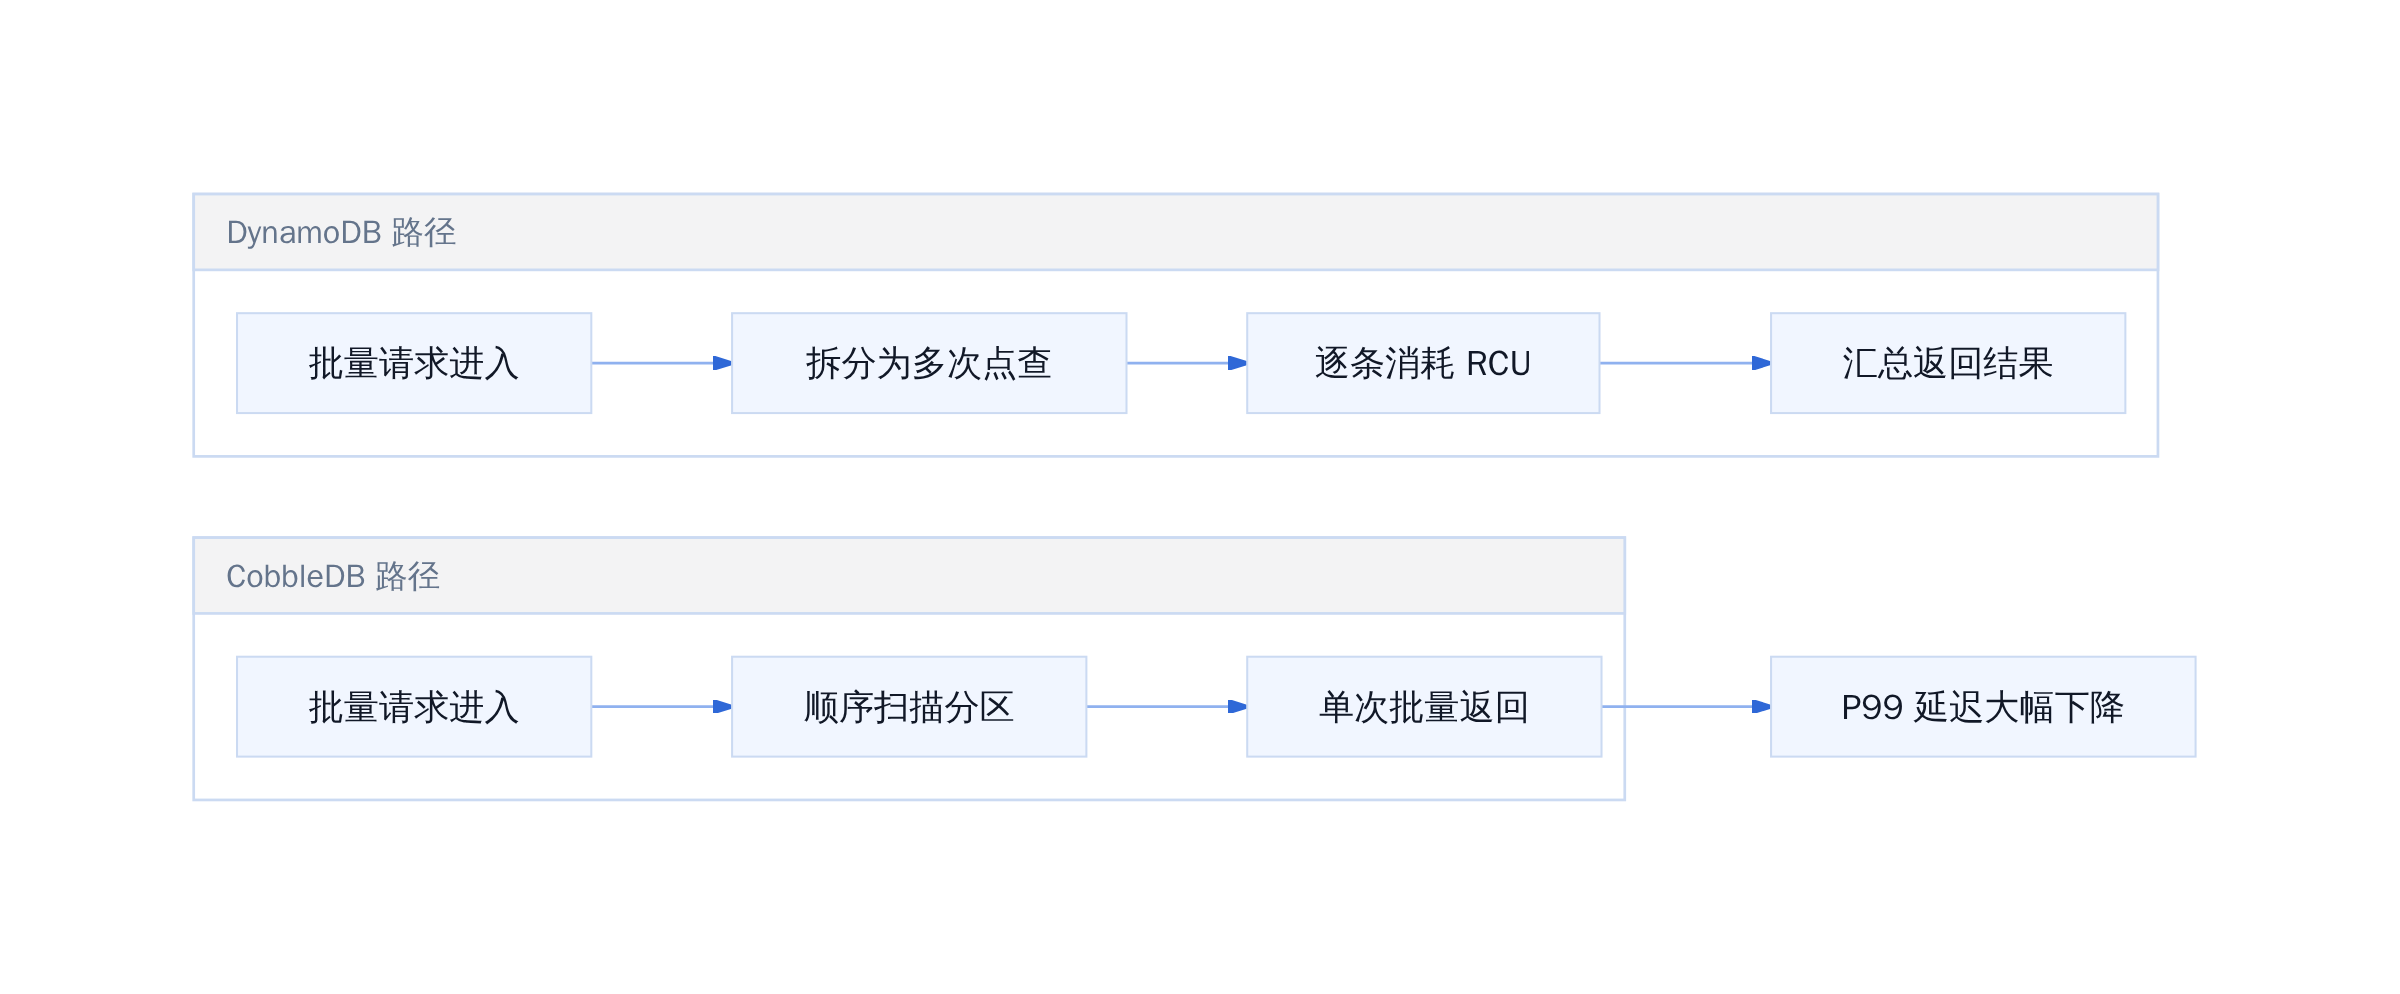
Perplexity 官方博客中提到的 82% 延迟下降,对应的是批量读取(batch read)场景下的 P99 延迟改善。这个数值得放在具体查询模式里理解。
DynamoDB 的设计哲学是点查优化:给定精确的主键,毫秒级返回单条记录。但对于 AI 搜索的召回管线来说,典型的工作负载是「一次性拉取成千上万条已准备好的网页片段」——这是一种顺序扫描类操作,在 DynamoDB 里只能通过多次点查或代价高昂的全表扫描来完成。每多一次读操作,RCU(Read Capacity Unit)就在烧钱,延迟也在累积。
CobbleDB 把这部分场景专门化:它不关心单点低延迟,只关心批量顺序读取的效率。两个层级的延迟基数不同,直接对比 82% 的数字意义有限——更准确的说法是,在同一工作负载下,原来每秒要付大量 RCU 换来的 P99 延迟,现在只需要更少的底层读操作就能完成同等的数据交付。
底层优化才是真功夫
DynamoDB 批量读取 vs CobbleDB 批量读取路径对比
自建 vs 托管:何时该切换?
82% 的延迟改善和一亿美元的年节省,听起来很诱人。但自建数据库从来不是一道简单的数学题,它牵涉到稳定性、可维护性和团队能力的综合评估。
Perplexity 选择自建的前提条件有几条是明确可观察的:第一,工作负载高度特征化——主要是批量读取预渲染的页面片段,写入频率低且集中在异步流水线中;第二,业务规模已经突破了 DynamoDB 的定价拐点,月支出达到百万美元级别;第三,团队有能力用短期投入换取长期成本结构的优化。
反过来看,如果你的业务仍然处于早期增长阶段,或者数据访问模式不够稳定,托管方案依然是更合理的选择。DynamoDB 的价值在于「不用管它」——自动扩缩容、多可用区冗余、分钟级建表。这些便利在月支出低于几十万美元时,节省下来的工程时间远比账单上的差价更有价值。
架构取舍从来不是单选题
判断是否应该从托管切换到自建,可以对照三个维度:月度账单是否持续增长且增速超过业务增速;工作负载是否足够特征化,能用一个专用组件覆盖;团队是否有至少一到两名工程师能在半年内完成核心模块的开发和稳定运行。
Perplexity 的这次迁移给了行业一个明确的信号:当业务量达到一定规模,云数据库的便利就会变成成本陷阱。但他们也没有说——这是所有 AI 公司都应该复制的路径。Perplexity 用两个月验证了一个道理:不是所有场景都需要通用数据库。
这条消息在 2026 年 9 月中旬刷屏了技术圈。原因不在「省下一亿美元」这个夸张的数字,而在于背后的执行路径:两人 + 数百个 AI Agent、两个月、针对一个具体负载(高频批量读取 prepared page records)的自研数据库。Perplexity 把数据库从「通用服务」拉回了「特定问题的工程实现」,给 AI 公司算了一笔清晰的基础设施账。
AI 公司的基础设施自主化趋势
最近两年,AI 创业公司在基础设施上的选择越来越两极分化。一端是全面拥抱云托管服务(如 Perplexity 早期完全依赖 AWS),另一端是逐步将关键路径自建。Perplexity 自身就处于这个切换过程中:一方面在 2026 年初与微软签署了价值 7.5 亿美元的 Azure 云合作协议,同时接受英伟达数十亿美元的投资,但在数据库层却选择了自建 CobbleDB 替代 DynamoDB【7】【12】。这种「多云 + 核心栈自建」的组合,反映了一个现实:AI 公司的基础设施策略正在从「什么方便用什么」转向「什么最能控制成本和质量用什么」。
基础设施自主化的驱动力主要来自成本压力和性能控制权。当业务量达到一定规模,云数据库的便利就会变成成本陷阱。Perplexity 内部复盘显示,DynamoDB 在持续高并发、可预测的 24/7 流量下,费用会随读写单位线性上升,且缺乏对查询模式的深度优化空间【5】。自建 CobbleDB 后,他们能够针对 AI 搜索的批量读取特征进行存储结构和缓存策略的专门设计,从而在延迟和成本上同时获益。
这种趋势并非孤例。随着 AI 应用从实验阶段进入规模化生产,许多团队开始重新评估「全托管」方案的长期代价。尤其是当负载模式高度特定(如向量检索、批量文档读取、实时流处理)时,通用数据库往往需要为「未来可能的需求」预留容量,而自建方案可以用更精确的适配换来更低的边际成本。
通用数据库的适用边界在哪?
DynamoDB 这类托管 NoSQL 数据库的优势在于开箱即用、弹性扩缩容和低运维负担。但在某些场景下,它们并不是最经济的选择。Perplexity 的实践正好划出了一道清晰的边界:当业务负载具有高度可预测性、访问模式固定、且数据规模足够大时,自建数据库的收益会超过运维复杂度。
具体而言,以下几类情况更适合考虑自建或专用数据库【5】【6】:
- 持续高吞吐量:每日请求量稳定超过 1000 万次,且流量可预测。托管数据库的按量计费模型在这种情况下会产生高昂的月度账单。
- 固定模式的全表扫描:通用数据库为灵活查询付出性能代价,但如果业务本质上只需要顺序读取或批量拉取,专用存储可以大幅减少 I/O 开销。
- 多全局二级索引(GSI)负担重:每个 GSI 都会增加写入和读取成本,当查询模式相对固定时,将这些结构内化到自定义设计中更划算。
- 对延迟尾部敏感:托管服务需要平衡多租户环境的资源分配,而自建方案可以针对自己的负载特征调整缓存、分区和调度策略。
这并不意味着通用数据库没有价值。在业务早期、负载不确定或团队规模有限时,DynamoDB 或类似的托管服务仍然是合理选择。Perplexity 并没有否定云数据库的一般用途,而是指出:当成本曲线变得陡峭,且业务模式已经稳定,重新评估架构投资是值得的。
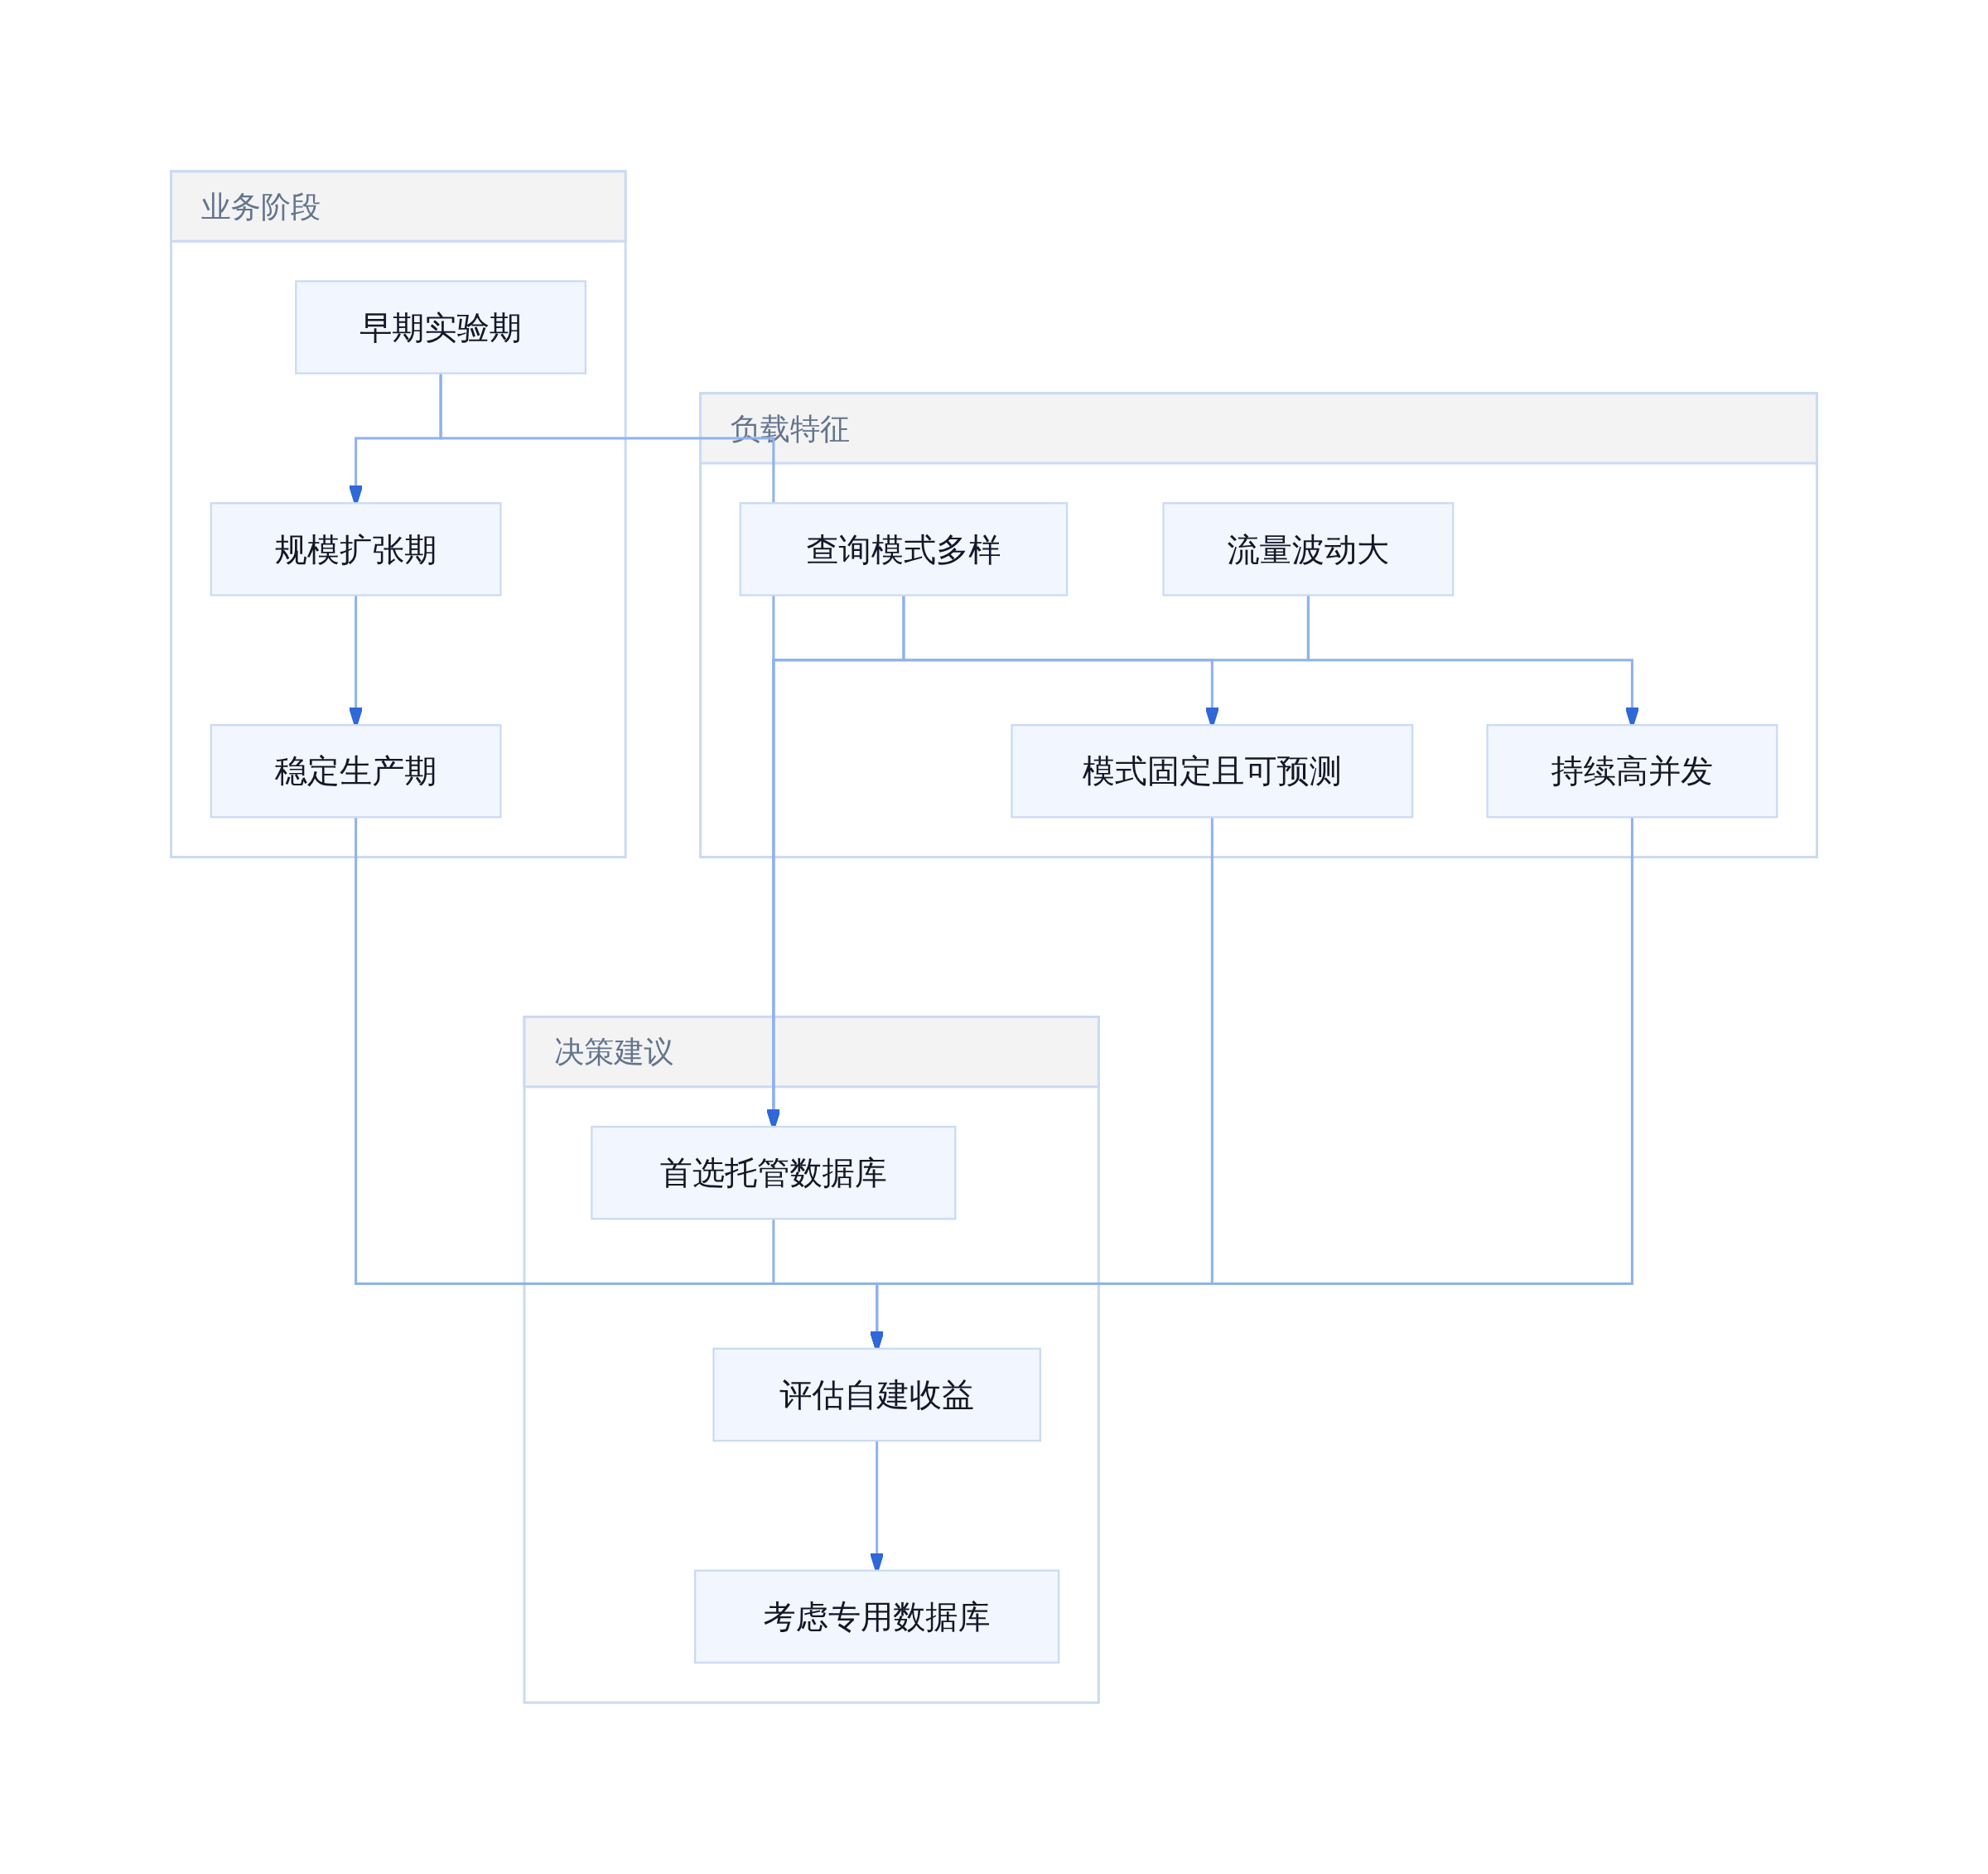
通用数据库适用边界决策
Perplexity 计划开源,会改变什么?
Perplexity 已经宣布,在 CobbleDB 通过大规模生产验证(每秒数十万次请求)后,将进行开源【1】【8】。这一举动有几个潜在影响。
首先,它为 AI 搜索场景下的存储层提供了一个公开的实现参考。目前大多数 AI 公司仍在依赖通用数据库或向量数据库,缺乏针对批量读取优化的开源方案。CobbleDB 的代码和架构设计可能被其他团队借鉴,加速同类场景的解决方案成熟。
其次,开源可能会降低后来者的尝试门槛。自建数据库的阻力往往来自「从零开始」的不确定性,而一个经过生产验证的开源项目可以成为新的起点。当然,这也意味着 Perplexity 需要在「保护竞争优势」和「建立行业标准」之间做出权衡。从目前的信息看,他们选择将代码开源,可能是相信核心壁垒不在存储层本身,而在于上层的数据管道和模型服务。
最后,开源 CobbleDB 也可能推动行业对「专用数据库」价值的讨论。当一家头部 AI 公司公开分享其自研数据库的动机和设计,更多团队会开始认真评估自己是否也在「错误地」使用通用数据库。
Perplexity 的 CobbleDB 案例说明,数据库的选择从来不是非黑即白。在业务量小的时候,托管数据库的便利性无可替代;但当规模、成本和性能压力同时显现时,回到具体问题、重新设计存储层,往往能打开新的成本空间。开源 CobbleDB 是一个信号:AI 公司正在学会更精细地管理自己的基础设施账本,而不是被动接受云厂商的定价模型。
参考文献
- Perplexity builds CobbleDB in two months, cutting batch-read latency by 82%. Cryptobriefing. https://cryptobriefing.com/perplexity-cobbledb-batch-read-latency
- CobbleDB: Lower-Latency, Lower-Cost AI Search Storage. Perplexity Blog. https://www.perplexity.ai/hub/blog/cobbledb
- DynamoDB Alternatives in 2026: Which One Fits Your Stack?. Knowi Blog. https://www.knowi.com/blog/amazon-dynamodb-complete-guide-2025-architecture-pricing-use-cases-alternatives
- Perplexity 與微軟簽署 7.5 億美元 AI 雲端合作協議. 鉅亨網. https://hk.finance.yahoo.com/news/perplexity%E8%88%87%E5%BE%AE%E8%BB%9F%E7%B0%A2%E7%BE%8A-7-5%E7%BE%8E%E5%85%83-ai%E9%9B%B2%E7%AB%AF%E5%90%88%E4%BD%9C%E5%8D%94%E8%AD%B0-025003264.html
- Perplexity on X. https://x.com/perplexity_ai/status/2099955628194316346
- Philip Oliver. Perplexity saved itself $100M annually by moving away from the canned cloud solution. LinkedIn. https://www.linkedin.com/posts/olivercomputing_perplexity-saved-itself-100m-annually-by-activity-7505811138987839488-erWS